vLLM مقابل SGLang مقابل TensorRT-LLM: قياس serving
, 8 دقائق قراءة, By Jaber Jaber
هندسةالنقاط الرئيسية
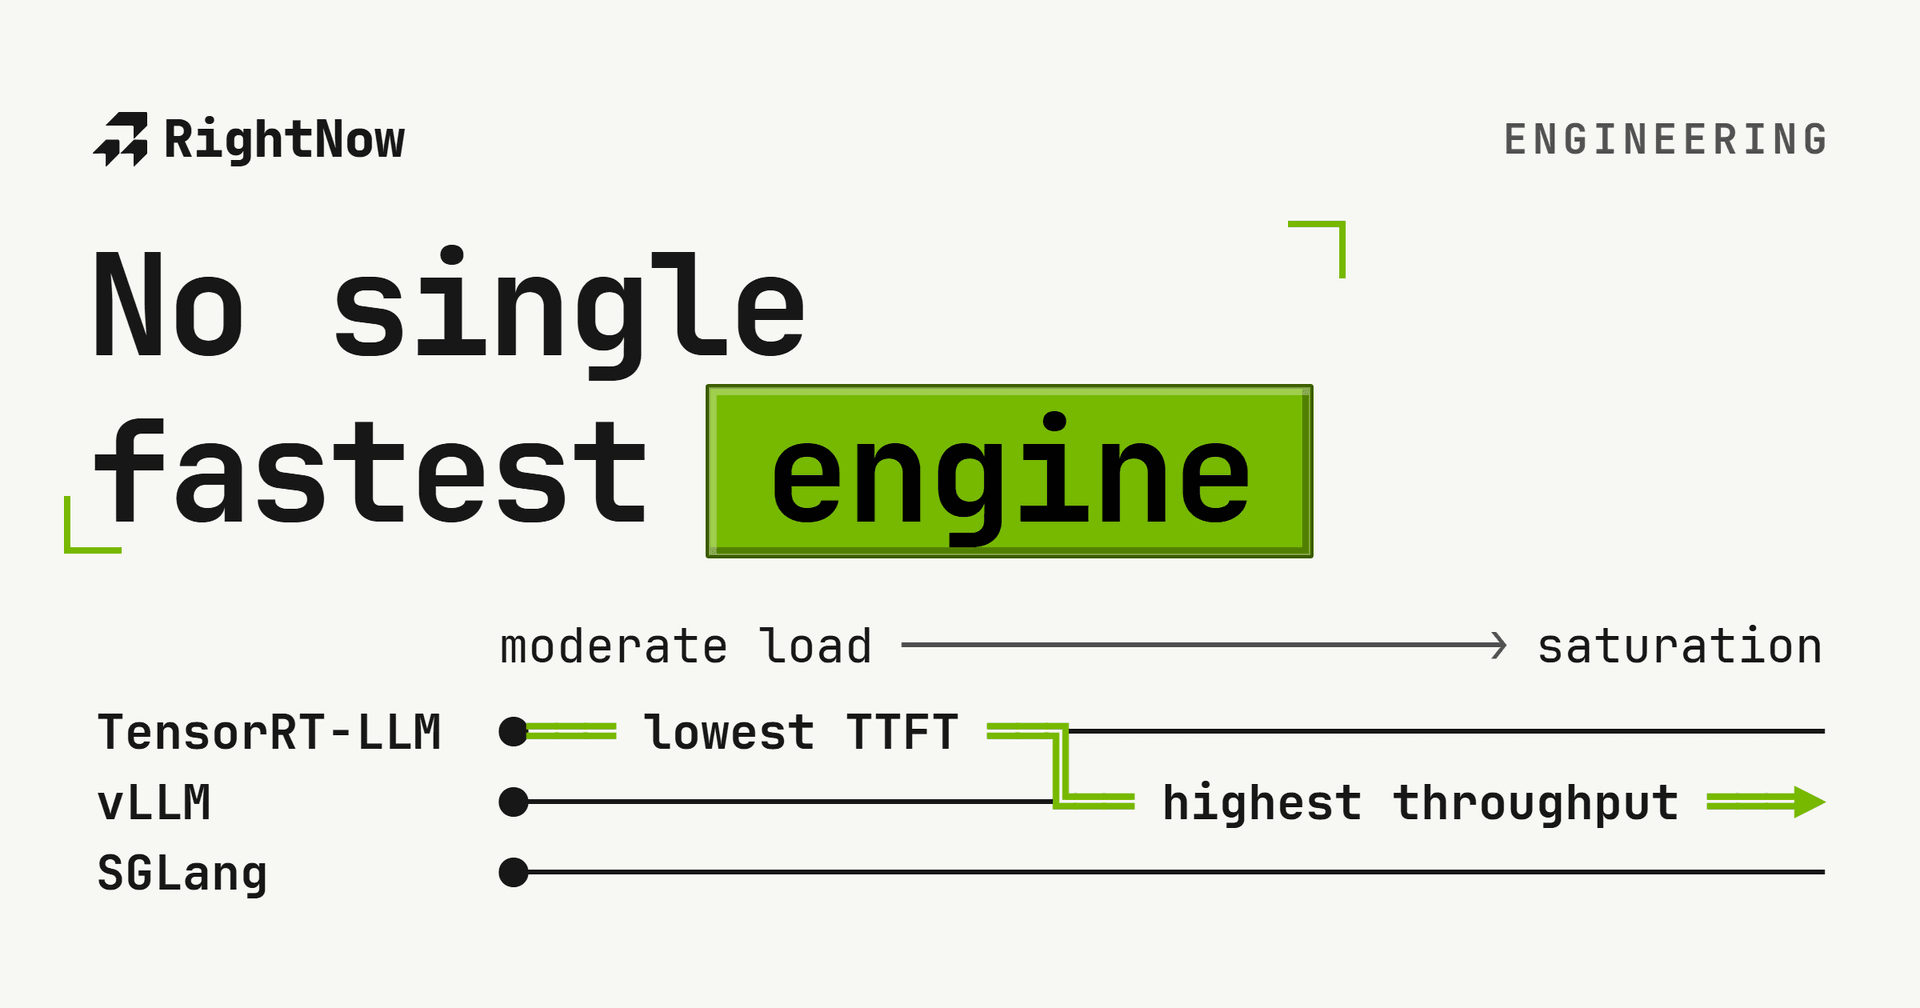
لا يوجد محرك واحد أسرع من كل سواه. يتبدل الفائز بتغير نقطة التشغيل.
حقق TensorRT-LLM أدنى زمن للرمز الأول عند حمل متوسط (235 ms مقابل 514 ms ل vLLM عند تزامن 32).
بلغ vLLM أعلى إنتاجية عند التشبع (5,333 tok/s على H100 واحدة) وأقل تكلفة.
أدنى تكلفة GPU مشتقة منشورة هي vLLM ب fp8 على H100، بقيمة $0.158 لكل مليون رمز ناتج.
تضع صفوف تكلفة bf16 المنشورة L40S عند نحو ضعف تكلفة H100 لكل رمز ناتج.
كل ما يلي محدود بما اختبرناه: Llama-3.1-8B-Instruct، و H100 80GB واحدة و L40S 48GB واحدة، ب bf16 و fp8. لا نعمم بعد ذلك. الإصدارات، حتى 20 يونيو 2026: vLLM 0.23.0، و SGLang 0.5.13، و TensorRT-LLM 1.2.1. هذه نتائج ذاتية التقدير؛ والمنصة والبيانات الخام غير متاحة للعموم. تغطي صفوف الإنتاجية وزمن الاستجابة المنشورة بالمطالبات الفريدة H100 ب bf16. ولا يظهر FP8 و L40S إلا في نتائج التكلفة المشتقة.
الخلاصة القصيرة
لا يوجد محرك واحد أسرع من كل سواه. يتبدل الفائز حسب كيفية تحميله.
| إذا كنت تهتم ب | استخدم | على هذا القياس |
|---|---|---|
| أدنى زمن للرمز الأول عند حمل متوسط | TensorRT-LLM | 235 ms TTFT عند c32 مقابل 514 ms ل vLLM |
| أعلى إنتاجية عند التشبع | vLLM | 5,333 tok/s على H100 واحدة |
| أدنى تكلفة لكل رمز | vLLM ب fp8 | $0.158 لكل مليون رمز |
| تخزين البادئات المشتركة | مكسب كبير لكليهما | الإنتاجية عند نسبة إصابة 90%، بالتخزين مفعلا مقابل معطلا: 3.13x ل vLLM (2,855 مقابل 910 tok/s)، و 2.84x ل SGLang (2,488 مقابل 875 tok/s) |
القاعدة لهذه التهيئات: TensorRT-LLM لحالات serving المقيدة بزمن الاستجابة دون سقف إنتاجيته، و vLLM لأعلى إنتاجية وأقل تكلفة. تقدم vLLM على SGLang عند كل تزامن: ب 1.8 إلى 9.0 في المئة على الإنتاجية، وكان زمن SGLang حتى رمزه الأول أعلى ب 6.2 إلى 26.2 في المئة.
أمران نصرح بهما بوضوح
أزال TensorRT-LLM 1.2 خلفية TensorRT؛ و PyTorch هي الخلفية التنفيذية الوحيدة في إصدار 1.2.1 المختبر. اختبار البادئة الواحدة عندنا ليس حالة البادئات المتعددة المتباينة التي صمم RadixAttention من SGLang لأجلها، فشغلنا تلك أيضا بشكل منفصل. تنطبق هذه النتائج على التهيئات المختبرة فقط.
شغلنا كل محرك على الأوزان نفسها وال GPU نفسها وتدفق الطلبات نفسه. المنصة والبيانات الخام غير متاحة للعموم، فلا يمكن حاليا استنساخ هذه النتائج استنساخا مستقلا من هذه المقالة. في صفوف تكلفة bf16 المنشورة، تكلف L40S نحو ضعف ما تكلفه H100 لكل رمز ناتج.
لماذا شغلنا هذا
وضعت Hugging Face محرك TGI في وضع الصيانة في ديسمبر 2025 وأرشفت المستودع في 21 مارس 2026، فكثير من الفرق تعيد الآن اختيار محرك serving. المقارنات التي تجدها لقطات لحظية على حمل شخص آخر. فشغلناها بأنفسنا. تسجل هذه المقالة نتائجنا وشروطها المعلنة؛ ولا توفر منصة استنساخ عامة.
كيف قسنا
عميل واحد يقود المحركات الثلاثة بتدفقات طلبات متطابقة، فتكون تعريفات التوقيت واحدة في كل مكان. TTFT هو الزمن حتى أول رمز متدفق. الإنتاجية هي رموز الناتج في الثانية. نسخّن أولا، ثم نوقّت ثلاث تكرارات لكل نقطة تشغيل ونرسم الوسط. التكرارات الخام وفترات الثقة غير متاحة للعموم. تخزين البادئات معطل في مسحات المطالبات الفريدة كي لا يحصل أحد على إصابة تخزين مجانية.
الإنتاجية مقابل التزامن
مسحنا التزامن من 1 إلى 256 عند 1,024 رمز مدخل و 256 رمز ناتج. عند الدفعة 1 تقع المحركات الثلاثة داخل أربعة في المئة من بعضها. ومع ارتفاع الحمل، يبقى TensorRT-LLM تنافسيا أو الأفضل حتى التزامن 64 ثم يستوي. ويواصل vLLM التوسع ويبلغ أعلى قمة: 5,333 tok/s.
| concurrency | vLLM | SGLang | TensorRT-LLM |
|---|---|---|---|
| 1 | 158 | 153 | 152 |
| 8 | 1096 | 1005 | 1027 |
| 32 | 2921 | 2730 | 2978 |
| 64 | 4040 | 3898 | 4029 |
| 128 | 4943 | 4816 | 4774 |
| 256 | 5333 | 5235 | 4813 |
حد الإنتاجية مقابل زمن الاستجابة
يخفي جدول الإنتاجية الصورة الأنفع. ارسم زمن الرمز الأول مقابل الإنتاجية فيتضح التراضي. يحافظ TensorRT-LLM على أدنى TTFT عبر المدى المتوسط كله ويحتفظ بتلك الأولوية حتى نحو 4,000 tok/s، ثم يبلغ سقفه فيصعد TTFT بحدّة. ويمتلك vLLM طرف الإنتاجية العالية: يبلغ 5,333 tok/s عند TTFT أدنى مما تقترب المحركان الآخران منه عند تلك النسبة.
| engine | output tok/s | TTFT p50 (ms) |
|---|---|---|
| vLLM | 158 | 35 |
| vLLM | 1096 | 177 |
| vLLM | 2921 | 514 |
| vLLM | 4040 | 790 |
| vLLM | 4943 | 1658 |
| vLLM | 5333 | 2221 |
| SGLang | 153 | 41 |
| SGLang | 1005 | 221 |
| SGLang | 2730 | 597 |
| SGLang | 3898 | 997 |
| SGLang | 4816 | 1761 |
| SGLang | 5235 | 2543 |
| TensorRT-LLM | 152 | 32 |
| TensorRT-LLM | 1027 | 56 |
| TensorRT-LLM | 2978 | 235 |
| TensorRT-LLM | 4029 | 504 |
| TensorRT-LLM | 4774 | 1691 |
| TensorRT-LLM | 4813 | 2848 |
فللحد مالكان. TensorRT-LLM لحالات serving الحساسة لزمن الاستجابة دون سقفه، و vLLM لأقصى إنتاجية. هذه هي الفكرة كلها: المحرك الصحيح دالة لنقطة تشغيلك، لا ثابت.
TensorRT-LLM: الخلفية في الإصدار 1.2.1
اقرأ هذا قبل أن تزن أرقام الإنتاجية. شغلنا TensorRT-LLM على خلفية PyTorch، التي تحمل checkpoint من Hugging Face وتخدمه بلا بناء محرك مسبق. PyTorch هي الخلفية التنفيذية الوحيدة اعتبارا من TensorRT-LLM 1.2.
توثق ملاحظات إصدار TensorRT-LLM 1.2 من NVIDIA إزالة خلفية TensorRT وواجهة بناء المحرك التابعة لها. نتيجة 4,813 tok/s هي أعلى إنتاجية أبلغنا عنها ل TensorRT-LLM 1.2.1 في هذه المسحة. ولا تثبت سقفا لأحمال أو تهيئات أخرى. حقق TensorRT-LLM أدنى زمن للرمز الأول بين الثلاثة عبر المدى المتوسط؛ وبين التهيئات التي شغلناها، بلغ vLLM أعلى إنتاجية.
التكلفة لكل رمز
نحول الإنتاجية إلى دولارات بصيغة واحدة: التكلفة لكل مليون رمز تساوي سعر ساعة GPU مقسوما على الرموز المستمرة في الساعة. H100 بسعر $3.95 في الساعة و L40S بسعر $1.95 في الساعة، مستأجرتان، بقياس 20 يونيو 2026.
| engine | bf16 / H100 | fp8 / H100 | bf16 / L40S |
|---|---|---|---|
| vLLM | 0.206 | 0.158 | 0.425 |
| SGLang | 0.21 | 0.17 | 0.438 |
| TensorRT-LLM | 0.228 | not measured | not measured |
على H100، التكلفة المشتقة المبلغة ل vLLM هي $0.158 لكل مليون رمز ناتج ب fp8، مقابل $0.206 ب bf16. لا توفر نتائج fp8 المنشورة صفوف إنتاجية أو زمن استجابة. ولا تثبت أي تسريع.
صفوف تكلفة vLLM bf16 المنشورة هي $0.425 لكل مليون رمز ناتج على L40S و $0.206 على H100. تكلفة L40S أعلى بنحو الضعف عند النسب المسجلة ونقاط التشبع. لا تنشر أي صفوف إنتاجية أو زمن استجابة ل L40S، فلا تدعم هذه النتائج أي مقارنة سرعة.
أحمال البادئات المشتركة
تعيد حركة RAG والوكلاء استخدام مطالبة نظام طويلة عبر الطلبات، فمفترض أن يساعد مخزن البادئات. شغلنا هذا بطريقتين، لأن شكل إعادة الاستخدام يهم.
بادئة مشتركة واحدة
أولا الحالة البسيطة: بادئة واحدة من 2,048 رمز ترسل إلى جزء من الطلبات، مع تغيير ذلك الجزء من 0 إلى 90 في المئة، بالتخزين مفعل ومعطل. عند صفر إصابة، يتجاوز التخزين المفعل المعطل أصلا: 999 مقابل 910 tok/s ل vLLM (9.7%) و 937 مقابل 879 ل SGLang (6.5%). هذه الفجوة غير مفسرة بالبيانات المنشورة وليست دليلا على إعادة استخدام تخزين. العتاد والدقة لهذه المسحة غير منشورين. نسب دليل القرار تقارن التخزين المفعل بالمعطل عند نسبة إصابة 90%، للمحرك نفسه.
| prefix-cache hit rate (%) | vLLM (cache on) | vLLM (cache off) | SGLang (cache on) | SGLang (cache off) |
|---|---|---|---|---|
| 0 | 999 | 910 | 937 | 879 |
| 50 | 1559 | 912 | 1528 | 873 |
| 90 | 2855 | 910 | 2488 | 875 |
بالتخزين مفعل، تقدم vLLM على SGLang عند كل نسبة إصابة: ب 6.6 في المئة عند صفر إصابة، و 2.0 في المئة عند 50 في المئة، و 14.7 في المئة عند 90 في المئة. لا نقرأ فائزا في تلك الفجوة. البادئة المشتركة الواحدة هي الحالة السهلة التي يتعامل معها أي مخزن بمستوى الكتل جيدا. وليست الحمل الذي بني RadixAttention لأجله.
بادئات متعددة، حالة RadixAttention
صمم RadixAttention للبادئات المتعددة المحفوظة في شجرة في آن واحد، وهو الشكل الذي تنجم عنه المحادثات المتفرعة ومجموعة مطالبات نظام. فشغلنا ذلك: 256 طلبا موزعة على عدد متزايد من بادئات مميزة طول كل منها 2,048 رمز، 8 ثم 32 ثم 128 منها، وكلا المحركين بالتخزين مفعل.
| number of distinct prefixes | vLLM | SGLang |
|---|---|---|
| 8 | 2677 | 2493 |
| 32 | 2277 | 2086 |
| 128 | 1467 | 1376 |
نجح RadixAttention. تظهر سجلات SGLang أن البادئات خدمت من مخزن الشجرة مباشرة. لكن مخزن بادئات vLLM حافظ على تقدمه في الإنتاجية ب 6.6 إلى 9.1 في المئة عند كل عدد بادئات، مع TTFT أدنى. فعلى Llama-3.1-8B على H100 واحدة لم نستنسخ فوز RadixAttention في الإنتاجية، حتى على الحمل الذي يستهدفه. يخزن المحركان البادئات المشتركة جيدا؛ وكان vLLM أسرع ب 6.6 إلى 9.1 في المئة، بما يوافق تفوقه العام على هذا العتاد. قد يتقدم RadixAttention ببادئات أطول أو أشجار أعمق أو ضغط إخلاء أثقل مما اختبرنا. لم يفعل في اختبارنا، ولن ندعي غير ذلك.
توافر الأدلة
المنصة وملفات CSV الخام وفترات الثقة غير متاحة للعموم. تحفظ الجداول قياساتنا الذاتية التقدير وشروطها المعلنة، لكنها ليست حزمة استنساخ كاملة. تحديث 20 سبتمبر 2026: سحبت ادعاءات المصدر المفتوح والاستنساخ السابقة.
تحديث 2026-11-13: الجمل التي تلخص الجداول تذكر الآن الأرقام التي تعطيها الجداول، والعتاد موصوف بأنه مستأجر من دون تسمية المزود. لم يتغير أي صف مقاس ولا تكلفة مشتقة ولا تاريخ ولا شرط.
الأسئلة الشائعة
vLLM أم SGLang؟ على حركة المطالبات الفريدة العادية تقدم vLLM عند كل تزامن في اختباراتنا: ب 1.8 إلى 9.0 في المئة على الإنتاجية، مع زمن SGLang حتى رمزه الأول أعلى ب 6.2 إلى 26.2 في المئة. كانت تكلفة vLLM المشتقة أدنى أيضا في كل تهيئة منشورة. استخدم vLLM افتراضيا؛ والجأ إلى SGLang حين يناسب واجهته القابلة للبرمجة حملك.
هل يستحق TensorRT-LLM؟ لحالات serving الحساسة لزمن الاستجابة دون سقفه الإنتاجي، نعم. حافظ على أدنى زمن حتى الرمز الأول عبر المدى المتوسط، 235 ms عند تزامن 32 مقابل 514 ms ل vLLM. شغلنا خلفية PyTorch، الخلفية التنفيذية الوحيدة في TensorRT-LLM 1.2.1.
أي GPU أستخدم؟ للتكلفة المشتقة المبلغة على Llama-3.1-8B، H100 أدنى في صفوف bf16 المنشورة. مع vLLM، الأرقام هي $0.206 لكل مليون رمز ناتج على H100 و $0.425 على L40S. لا تنشر أي صفوف إنتاجية أو زمن استجابة ل L40S، فلا تدعم هذه النتائج أي مقارنة سرعة.
ملاحظات منهجية وتحفظات
H100 80GB واحدة و L40S 48GB واحدة، مستأجرتان، GPU واحد، حجم توازي tensor يساوي 1.
أوزان Llama-3.1-8B-Instruct نفسها وتدفق الطلبات نفسه عبر المحركات. ثلاث تكرارات موقوتة. التكرارات الخام وفترات الثقة غير متاحة للعموم.
زمن الاستجابة هنا هو TTFT والمئينات لكل طلب، لا goodput عند SLO ثابت. مسألة قبول 514 ms للرمز الأول عند حمل عالٍ تتوقف على حالتك؛ ومسحة goodput عند SLO عمل مستقبلي.
الأرقام ذاتية التقدير على منصتنا وليست معايرة تقاطعيا مع مجموعة خارجية مثل MLPerf. المنصة والبيانات الخام غير متاحة للعموم، فلا تدعم هذه المقالة استنساخا مستقلا.
شغل TensorRT-LLM 1.2.1 خلفية PyTorch، خلفيته التنفيذية الوحيدة. توثق ملاحظات إصدار TensorRT-LLM 1.2 من NVIDIA إزالة خلفية TensorRT وواجهة بناء المحرك.
توقفت مسحة L40S عند تزامن 128 (تشبعها)، و H100 عند 256.
المحركات تتغير أسبوعيا. هذه الأرقام vLLM 0.23.0 و SGLang 0.5.13 و TensorRT-LLM 1.2.1، حتى 20 يونيو 2026.