
vLLM vs SGLang vs TensorRT-LLM: サービングベンチマーク
, 8分で読めます, By Jaber Jaber
エンジニアリング主要な要点
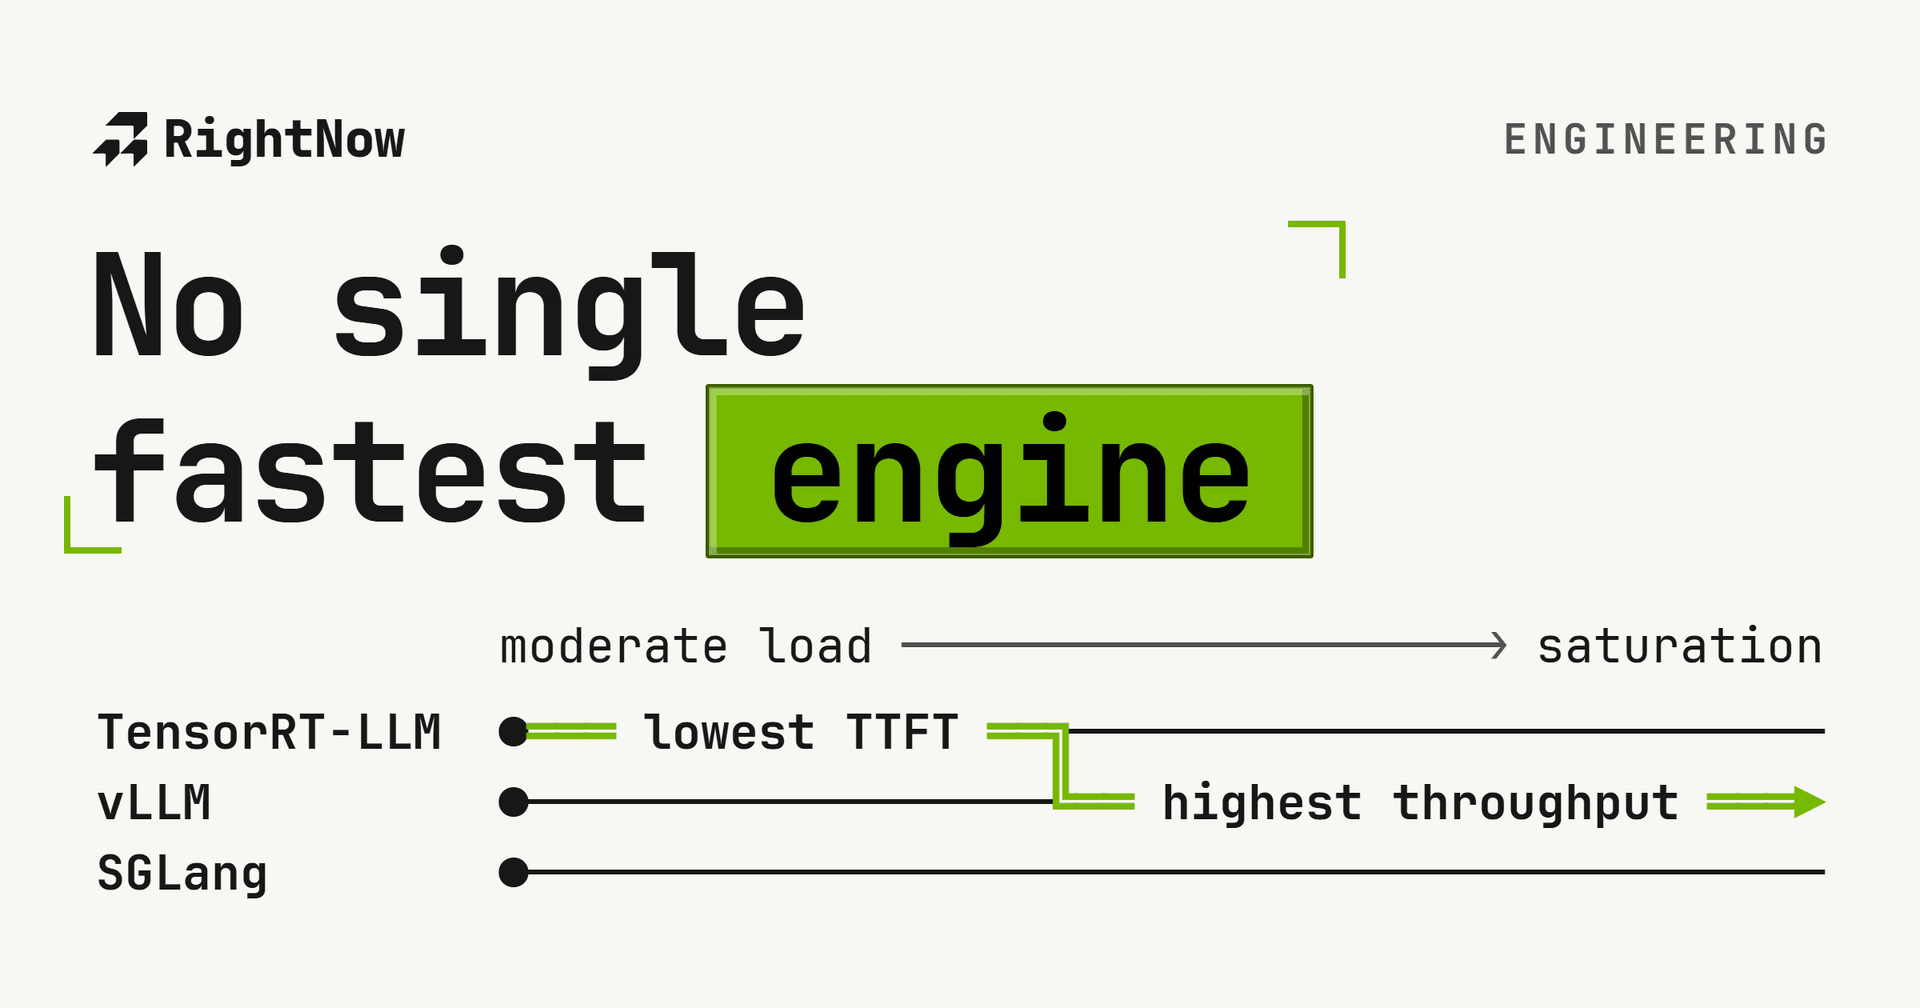
単一の最速エンジンは存在しません。勝者は動作点によって変わります。
中程度の負荷では TensorRT-LLM が最も低い最初のトークンのレイテンシを記録しました (同時実行数 32 で vLLM の 514 ms に対し 235 ms)。
vLLM は飽和時の最高スループット (H100 1 枚で 5,333 tok/s) と最も低いコストに達しました。
公表されている導出 GPU コストの最安値は、H100 の fp8 での vLLM の 100 万出力トークンあたり 0.158 ドルです。
公表された bf16 のコスト行では、L40S は出力トークンあたり H100 の約 2 倍の費用になります。
以下のすべては、私たちがテストした範囲に限られます: Llama-3.1-8B-Instruct、H100 80GB 1 枚と L40S 48GB 1 枚、bf16 と fp8。この先には一般化しません。バージョンは 2026 年 6 月 20 日時点で vLLM 0.23.0、SGLang 0.5.13、TensorRT-LLM 1.2.1。これらは自己申告の結果であり、ハーネスと生データは公開されていません。公表されたユニークプロンプトのスループットとレイテンシの行は H100 bf16 を対象とします。FP8 と L40S は導出コストの結果にのみ現れます。
短い要約
単一の最速エンジンは存在しません。勝者は負荷のかけ方によって変わります。
| 重視するもの | 使うもの | このベンチマークでの結果 |
|---|---|---|
| 中程度の負荷での最も低い最初のトークンレイテンシ | TensorRT-LLM | c32 で TTFT 235 ms、vLLM は 514 ms |
| 飽和時の最高スループット | vLLM | H100 1 枚で 5,333 tok/s |
| トークンあたりの最安コスト | fp8 の vLLM | 100 万トークンあたり 0.158 ドル |
| 共有プレフィックスのキャッシング | 両方に大きな利点 | ヒット率 90% でのスループット、キャッシュ オン対オフ: vLLM で 3.13 倍 (2,855 対 910 tok/s)、SGLang で 2.84 倍 (2,488 対 875 tok/s) |
これらの構成での規則はこうです。スループット天井より下のレイテンシ重視のサービングには TensorRT-LLM、最高スループットと最安コストには vLLM。vLLM はすべての同時実行数で SGLang を上回りました。スループットで 1.8 から 9.0 パーセント、SGLang の最初のトークンまでの時間は 6.2 から 26.2 パーセント高かったです。
明示しておく 2 つのこと
TensorRT-LLM 1.2 は TensorRT バックエンドを削除しました。テストした 1.2.1 リリースでは PyTorch が唯一の実行バックエンドです。私たちの単一プレフィックスのキャッシュテストは、SGLang の RadixAttention が対象とする多数の異なるプレフィックスのケースではないため、それも別途実行しました。これらの結果はテストした構成にのみ当てはまります。
すべてのエンジンを同じウェイト、同じ GPU、同じリクエストストリームで実行しました。ハーネスと生データは公開されていないため、これらの結果は現時点でこの出版物から独立して再現できません。公表された bf16 のコスト行では、L40S は出力トークンあたり H100 の約 2 倍の費用になります。
なぜ実行したのか
Hugging Face は 2025 年 12 月に TGI をメンテナンスモードにし、2026 年 3 月 21 日にリポジトリをアーカイブしたため、多くのチームが今まさにサービングエンジンを選び直しています。手に入る比較は、他人のワークロード上の一時点のスナップショットです。だから自分たちで実行しました。この記事は私たちの結果と開示された条件を記録するものであり、公開の再現ハーネスは提供しません。
どう測定したか
1 つのクライアントが 3 つのエンジンすべてを同一のリクエストストリームで駆動するため、計時の定義はどこでも同じです。TTFT は最初のストリームトークンまでの時間です。スループットは 1 秒あたりの出力トークンです。ウォームアップの後、動作点ごとに 3 回の反復を計時し、平均をチャートにします。生の反復と信頼区間は公開されていません。ユニークプロンプトのスイープではプレフィックスキャッシングをオフにし、どのエンジンも無償のキャッシュヒットを得ないようにしました。
スループット対同時実行数
入力 1,024 トークン、出力 256 トークンで、同時実行数を 1 から 256 までスイープしました。バッチ 1 では 3 エンジンは 4 パーセント以内に収まります。負荷が上がると、TensorRT-LLM は同時実行数 64 まで競争力があるか最良で、その後頭打ちになります。vLLM はスケールを続け、最高ピークの 5,333 tok/s に達します。
| 同時実行数 | vLLM | SGLang | TensorRT-LLM |
|---|---|---|---|
| 1 | 158 | 153 | 152 |
| 8 | 1096 | 1005 | 1027 |
| 32 | 2921 | 2730 | 2978 |
| 64 | 4040 | 3898 | 4029 |
| 128 | 4943 | 4816 | 4774 |
| 256 | 5333 | 5235 | 4813 |
レイテンシとスループットのフロンティア
スループットの表は、より有用な全体像を隠しています。最初のトークンのレイテンシをスループットに対してプロットすると、トレードオフは明確です。TensorRT-LLM は中域全体で最も低い TTFT を保ち、その優位は約 4,000 tok/s まで続いた後、天井に達して TTFT が急上昇します。vLLM は高スループット域を独占します。他の 2 つがその速度に近づくときより低い TTFT で 5,333 tok/s に達します。
| エンジン | 出力 tok/s | TTFT p50 (ms) |
|---|---|---|
| vLLM | 158 | 35 |
| vLLM | 1096 | 177 |
| vLLM | 2921 | 514 |
| vLLM | 4040 | 790 |
| vLLM | 4943 | 1658 |
| vLLM | 5333 | 2221 |
| SGLang | 153 | 41 |
| SGLang | 1005 | 221 |
| SGLang | 2730 | 597 |
| SGLang | 3898 | 997 |
| SGLang | 4816 | 1761 |
| SGLang | 5235 | 2543 |
| TensorRT-LLM | 152 | 32 |
| TensorRT-LLM | 1027 | 56 |
| TensorRT-LLM | 2978 | 235 |
| TensorRT-LLM | 4029 | 504 |
| TensorRT-LLM | 4774 | 1691 |
| TensorRT-LLM | 4813 | 2848 |
つまりフロンティアには 2 つの持ち主がいます。天井より下のレイテンシ敏感なサービングには TensorRT-LLM、最大スループットには vLLM。要点はそれです。正しいエンジンは定数ではなく、あなたの動作点の関数です。
TensorRT-LLM: バージョン 1.2.1 のバックエンド
スループットの数値を評価する前に、これをお読みください。私たちは TensorRT-LLM を PyTorch バックエンドで実行しました。これは Hugging Face のチェックポイントをロードし、事前のエンジンビルドなしでサーブします。TensorRT-LLM 1.2 の時点で、PyTorch が唯一の実行バックエンドです。
NVIDIA の TensorRT-LLM 1.2 のリリースノートは、TensorRT バックエンドとそのエンジンビルド CLI の削除を文書しています。4,813 tok/s の結果は、このスイープで TensorRT-LLM 1.2.1 について報告した最も高いスループットです。他のワークロードや構成の天井を示すものではありません。TensorRT-LLM は 3 つの中で中域全体の最も低い最初のトークンレイテンシを持ち、私たちが実行した構成の中では vLLM が最高スループットに達しました。
トークンあたりのコスト
スループットをドルに変える式は 1 つです。100 万トークンあたりのコストは、GPU の時間料金を 1 時間あたりの持続トークン数で割ったものです。H100 は 1 時間 3.95 ドル、L40S は 1 時間 1.95 ドルで、レンタル、2026 年 6 月 20 日時点の観測です。
| エンジン | bf16 / H100 | fp8 / H100 | bf16 / L40S |
|---|---|---|---|
| vLLM | 0.206 | 0.158 | 0.425 |
| SGLang | 0.21 | 0.17 | 0.438 |
| TensorRT-LLM | 0.228 | not measured | not measured |
H100 では、vLLM の報告された導出コストは fp8 で 100 万出力トークンあたり 0.158 ドル、bf16 では 0.206 ドルです。公表された fp8 の結果にはスループットやレイテンシの行がありません。スピードアップを示すものではありません。
公表された vLLM の bf16 コスト行は、L40S で 100 万出力トークンあたり 0.425 ドル、H100 で 0.206 ドルです。L40S のコストは、記録されたレートと飽和点でおおよそ 2 倍です。L40S のスループットやレイテンシの行は公表されていないため、これらの結果は速度の比較を裏付けません。
共有プレフィックスのワークロード
RAG とエージェントのトラフィックは、リクエストをまたいで長いシステムプロンプトを再利用するため、プレフィックスキャッシュが効くはずです。再利用の形が問題になるので、2 通りの方法で実行しました。
1 つの共有プレフィックス
まず単純なケースです。2,048 トークンのプレフィックス 1 つをリクエストの一部に送り、その割合を 0 から 90 パーセントまで変え、キャッシングの オンと オフで測ります。ヒットゼロでも、キャッシュ オンはすでに オフを上回ります: vLLM で 910 対 999 tok/s (9.7%)、SGLang で 879 対 937 (6.5%)。この差は公表データでは説明されておらず、キャッシュ再利用の証拠ではありません。このスイープのハードウェアと精度は公表されていません。選択のガイドの比率は、同じエンジンについて、ヒット率 90% でのキャッシュ オンと オフを比較します。
| プレフィックスキャッシュのヒット率 (%) | vLLM (キャッシュ オン) | vLLM (キャッシュ オフ) | SGLang (キャッシュ オン) | SGLang (キャッシュ オフ) |
|---|---|---|---|---|
| 0 | 999 | 910 | 937 | 879 |
| 50 | 1559 | 912 | 1528 | 873 |
| 90 | 2855 | 910 | 2488 | 875 |
キャッシュ オンでは、vLLM はすべてのヒット率で SGLang を上回りました。ヒットゼロで 6.6 パーセント、50 パーセントで 2.0 パーセント、90 パーセントで 14.7 パーセントです。この差から勝者を読み取ることはしません。単一の共有プレフィックスは、どんなブロックレベルのキャッシュでもうまく扱える簡単なケースです。それは SGLang の RadixAttention が対象とするワークロードではありません。
多数の異なるプレフィックス、RadixAttention のケース
RadixAttention は、多数の異なるプレフィックスを一度にツリーに保持するよう設計されています。分岐する会話とシステムプロンプトのプールから得られる形です。そこでそれを実行しました。256 リクエストを、増えていく数の異なる 2,048 トークンのプレフィックス (8、32、128) に分散し、両エンジンともキャッシュ オンで実行します。
| 異なるプレフィックスの数 | vLLM | SGLang |
|---|---|---|
| 8 | 2677 | 2493 |
| 32 | 2277 | 2086 |
| 128 | 1467 | 1376 |
RadixAttention は機能しました。SGLang のログは、プレフィックスがツリーキャッシュから直接供給されたことを示しています。しかし vLLM のプレフィックスキャッシュは、どのプレフィックス数でも 6.6 から 9.1 パーセント、TTFT も低く、スループットで先行し続けました。つまり H100 1 枚の Llama-3.1-8B では、RadixAttention が対象とするワークロードでも、RadixAttention のスループットの勝利は再現しませんでした。両エンジンとも共有プレフィックスをうまくキャッシュし、vLLM は 6.6 から 9.1 パーセント速く、このハードウェアでの全体的な優位と一致していました。RadixAttention は、私たちがテストしたより長いプレフィックス、深いツリー、重い退去圧力で先行するかもしれません。私たちのテストではそうなりませんでしたし、そう主張するつもりもありません。
エビデンスの入手可能性
ハーネス、生の CSV、信頼区間は公開されていません。表は私たちの自己申告の測定と開示された条件を保存しますが、完全な再現パッケージではありません。2026 年 9 月 20 日更新: 以前のオープンソースと再現の主張は撤回されました。
2026-11-13 更新: 表を要約する文は、表が示す数値を述べるようになり、ハードウェアはプロバイダー名なしのレンタルと記述されます。変更された測定行、導出コスト、日付、条件はありません。
FAQ
vLLM か SGLang か? 通常のユニークプロンプトのトラフィックでは、vLLM がテストしたすべての同時実行数で先行しました。スループットで 1.8 から 9.0 パーセント、SGLang の最初のトークンまでの時間は 6.2 から 26.2 パーセント高かったです。vLLM の導出コストは、公表されたすべての構成で低かったです。デフォルトには vLLM を使います。SGLang は、そのプログラマブルなフロントエンドがワークロードに合うときに選びます。
TensorRT-LLM は価値がありますか? スループット天井より下のレイテンシ敏感なサービングなら、はい。中域全体で最も低い最初のトークンまでの時間を保持し、同時実行数 32 では 235 ms、vLLM は 514 ms でした。TensorRT-LLM 1.2.1 の唯一の実行バックエンドである PyTorch バックエンドで実行しました。
どの GPU を使うべきですか? Llama-3.1-8B の報告された導出 GPU コストでは、公表された bf16 の行で H100 の方が低いです。vLLM では、100 万出力トークンあたり H100 で 0.206 ドル、L40S で 0.425 ドルです。L40S のスループットやレイテンシの行は公表されていないため、これらの結果は速度の比較を裏付けません。
方法の注記と注意事項
H100 80GB 1 枚と L40S 48GB 1 枚、レンタル、シングル GPU、テンソル並列サイズ 1。
同じ Llama-3.1-8B-Instruct のウェイトと同じリクエストストリームを全エンジンで。計時は 3 回の反復。生の反復と信頼区間は公開されていません。
ここでのレイテンシは TTFT とリクエストごとのパーセンタイルであり、固定 SLO でのグッドプットではありません。高負荷で 514 ms の最初のトークンが許容かどうかはユースケース次第です。SLO グッドプットのスイープは今後の課題です。
数値は私たちのハーネスでの自己申告であり、MLPerf のような外部スイートと相互較正されていません。ハーネスと生データは公開されていないため、この出版物は独立した再現を裏付けません。
TensorRT-LLM 1.2.1 は、唯一の実行バックエンドである PyTorch バックエンドを実行しました。NVIDIA の TensorRT-LLM 1.2 のリリースノートは、TensorRT バックエンドとエンジンビルド CLI の削除を文書しています。
L40S のスイープは同時実行数 128 (その飽和) で停止し、H100 は 256 です。
エンジンは週ごとに動きます。これらの数値は 2026 年 6 月 20 日時点の vLLM 0.23.0、SGLang 0.5.13、TensorRT-LLM 1.2.1 です。