
vLLM vs SGLang vs TensorRT-LLM: 서빙 벤치마크
, 8분 소요, By Jaber Jaber
엔지니어링핵심 요점
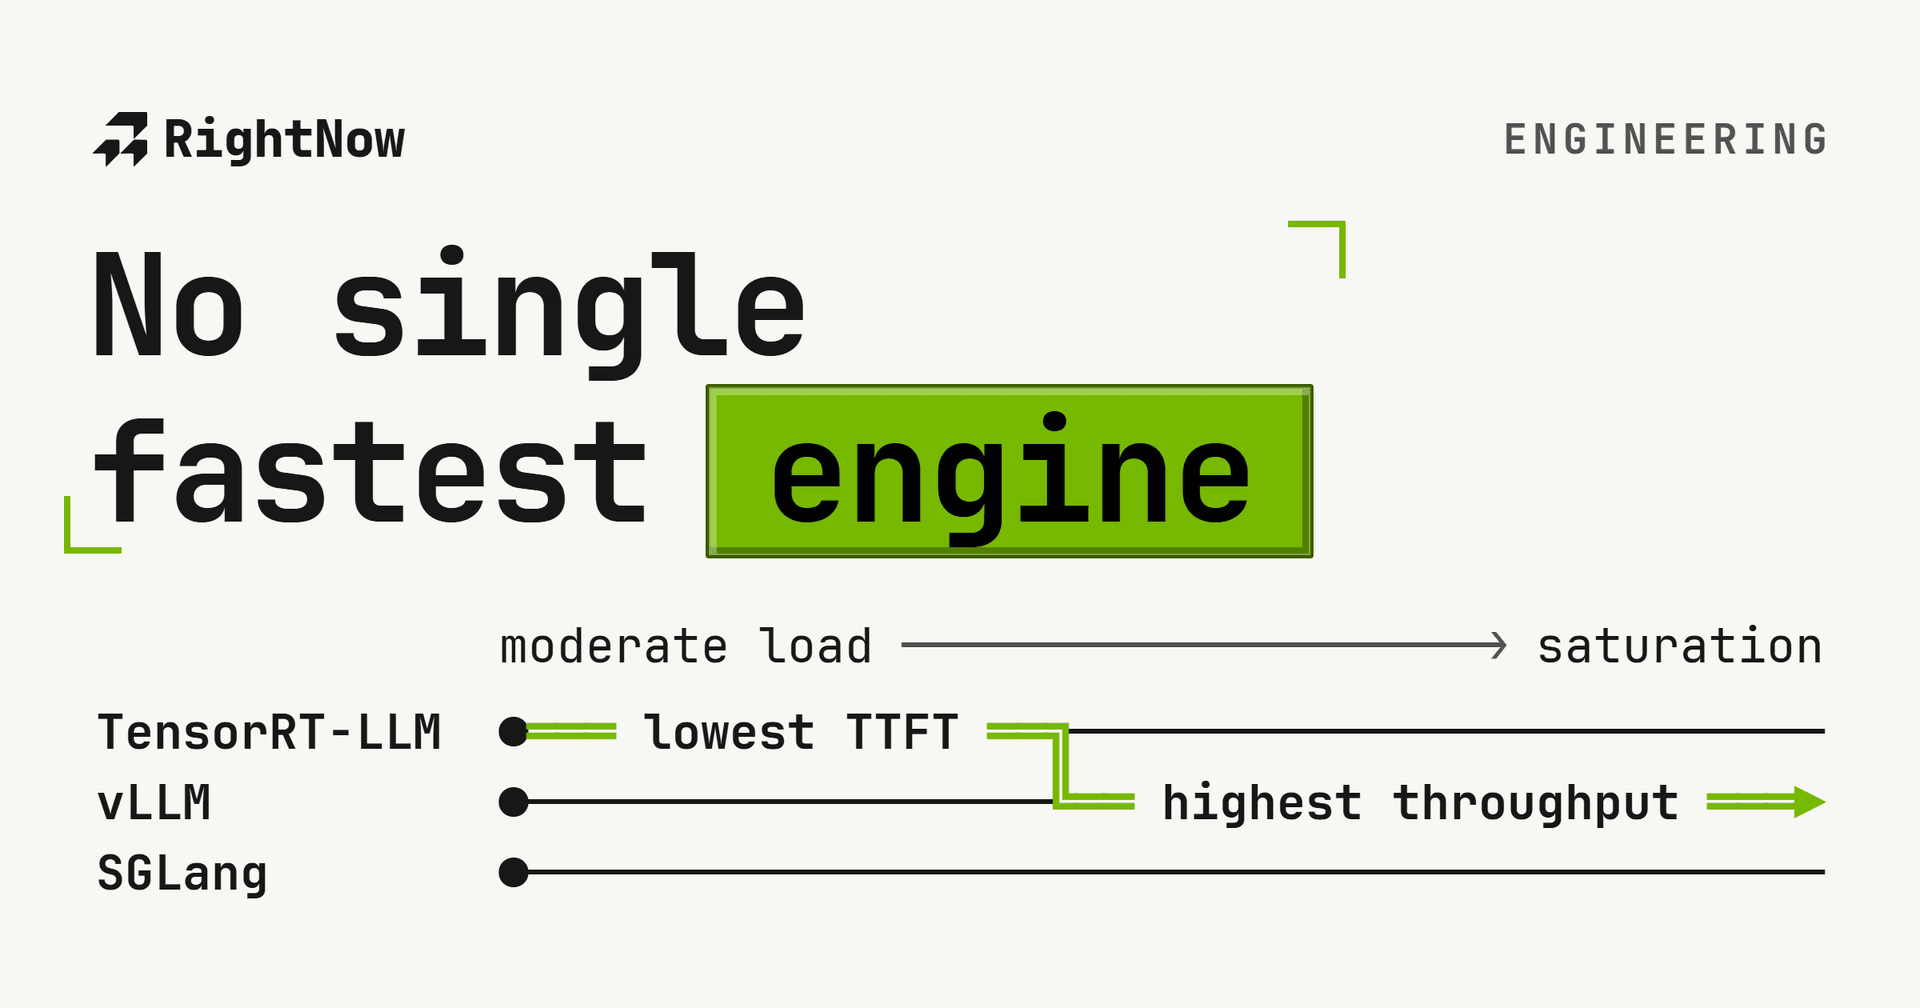
단 하나의 가장 빠른 엔진은 없습니다. 승자는 동작점에 따라 바뀝니다.
TensorRT-LLM이 보통 부하에서 가장 낮은 첫 토큰 지연 시간을 냈습니다(동시성 32에서 235 ms 대 vLLM 514 ms).
vLLM이 포화 상태에서 가장 높은 처리량(H100 하나에서 5,333 tok/s)과 가장 낮은 비용에 도달했습니다.
공개된 가장 낮은 유도 GPU 비용은 H100에서 fp8의 vLLM, 100만 출력 토큰당 $0.158입니다.
공개된 bf16 비용 행에서 L40S는 출력 토큰당 H100 비용의 약 두 배입니다.
아래의 모든 내용은 우리가 시험한 범위로 한정됩니다. Llama-3.1-8B-Instruct, H100 80GB 하나와 L40S 48GB 하나, bf16과 fp8입니다. 이보다 넓게 일반화하지 않습니다. 버전, 2026년 6월 20일 기준: vLLM 0.23.0, SGLang 0.5.13, TensorRT-LLM 1.2.1. 이들은 자체 보고 결과이고, 하니스와 원본 데이터는 공개되지 않았습니다. 공개된 고유 프롬프트 처리량과 지연 행은 H100 bf16을 다룹니다. FP8과 L40S는 유도 비용 결과에만 나옵니다.
짧은 요약
단 하나의 가장 빠른 엔진은 없습니다. 승자는 어떻게 부하를 주는가에 따라 바뀝니다.
| 관심사 | 사용 | 이 벤치마크에서 |
|---|---|---|
| 보통 부하에서 가장 낮은 첫 토큰 지연 | TensorRT-LLM | c32에서 TTFT 235 ms 대 vLLM 514 ms |
| 포화 상태에서 가장 높은 처리량 | vLLM | H100 하나에서 5,333 tok/s |
| 토큰당 가장 낮은 비용 | fp8의 vLLM | 100만 토큰당 $0.158 |
| 공유 접두사 캐싱 | 둘 모두에 큰 이득 | 적중률 90%에서 캐시 켜짐 대 꺼짐 처리량: vLLM 3.13배(2,855 대 910 tok/s), SGLang 2.84배(2,488 대 875 tok/s) |
이 구성들의 규칙: 자신의 처리량 한계 아래 지연에 민감한 서빙에는 TensorRT-LLM, 가장 높은 처리량과 가장 낮은 비용에는 vLLM. vLLM이 모든 동시성에서 SGLang에 앞섰습니다. 처리량에서 1.8~9.0퍼센트, 그리고 SGLang의 첫 토큰까지의 시간은 6.2~26.2퍼센트 더 높었습니다.
우리가 명시하는 두 가지
TensorRT-LLM 1.2는 TensorRT 백엔드를 제거했습니다. 시험한 1.2.1 릴리스에서 PyTorch가 유일한 실행 백엔드입니다. 우리의 단일 접두사 캐시 시험은 SGLang의 RadixAttention이 설계된, 서로 다른 접두사가 많은 경우가 아니므로 그것도 따로 실행했습니다. 이 결과는 시험한 구성에만 적용됩니다.
세 엔진 모두 같은 가중치, 같은 GPU, 같은 요청 스트림으로 실행했습니다. 하니스와 원본 데이터는 공개되지 않았으므로 이 결과는 현재 이 글만으로는 독립적으로 재현될 수 없습니다. 공개된 bf16 비용 행에서 L40S는 출력 토큰당 H100의 약 두 배입니다.
왜 실행했는가
Hugging Face는 2025년 12월에 TGI를 유지 모드로 옮겼고 2026년 3월 21일에 저장소를 보관 처리했으므로, 지금 많은 팀이 서빙 엔진을 다시 고르고 있습니다. 찾을 수 있는 비교들은 누군가의 다른 워크로드 위의 한 시점 스냅샷입니다. 그래서 우리가 직접 실행했습니다. 이 글은 우리의 결과와 밝힌 조건을 기록합니다. 공개 재현 하니스는 제공하지 않습니다.
어떻게 측정했는가
한 클라이언트가 세 엔진 모두에 같은 요청 스트림을 보내므로 시간 정의도 모두 같습니다. TTFT는 첫 스트리밍 토큰까지의 시간입니다. 처리량은 초당 출력 토큰입니다. 워밍업 후 동작점마다 세 번 반복을 측정하고 평균을 그립니다. 원본 반복과 신뢰 구간은 공개되지 않았습니다. 고유 프롬프트 스윕에서는 접두사 캐싱을 꺼서 아무것도 공짜 캐시 적중을 얻지 못하게 했습니다.
동시성 대 처리량
입력 1,024 토큰, 출력 256 토큰으로 동시성을 1에서 256까지 훑었습니다. 배치 1에서 세 엔진은 서로 4퍼센트 안입니다. 부하가 오르면 TensorRT-LLM이 동시성 64까지 경쟁력 있거나 최고이고, 그다음 평탄해집니다. vLLM은 계속 확장되어 가장 높은 정점 5,333 tok/s에 도달합니다.
| 동시성 | vLLM | SGLang | TensorRT-LLM |
|---|---|---|---|
| 1 | 158 | 153 | 152 |
| 8 | 1096 | 1005 | 1027 |
| 32 | 2921 | 2730 | 2978 |
| 64 | 4040 | 3898 | 4029 |
| 128 | 4943 | 4816 | 4774 |
| 256 | 5333 | 5235 | 4813 |
지연 대 처리량 프론티어
처리량 표는 더 유용한 그림을 가립니다. 첫 토큰 지연을 처리량에 대해 그리면 트레이드오프가 분명해집니다. TensorRT-LLM은 중간 범위 전체에서 가장 낮은 TTFT를 유지하고 그 이점을 약 4,000 tok/s까지 지키다가 한계에 닿아 TTFT가 가파르게 오릅니다. vLLM은 높은 처리량 끝을 차지합니다. 다른 둘이 그 속도에 근접할 때보다 낮은 TTFT로 5,333 tok/s에 도달합니다.
| 엔진 | 출력 tok/s | TTFT p50 (ms) |
|---|---|---|
| vLLM | 158 | 35 |
| vLLM | 1096 | 177 |
| vLLM | 2921 | 514 |
| vLLM | 4040 | 790 |
| vLLM | 4943 | 1658 |
| vLLM | 5333 | 2221 |
| SGLang | 153 | 41 |
| SGLang | 1005 | 221 |
| SGLang | 2730 | 597 |
| SGLang | 3898 | 997 |
| SGLang | 4816 | 1761 |
| SGLang | 5235 | 2543 |
| TensorRT-LLM | 152 | 32 |
| TensorRT-LLM | 1027 | 56 |
| TensorRT-LLM | 2978 | 235 |
| TensorRT-LLM | 4029 | 504 |
| TensorRT-LLM | 4774 | 1691 |
| TensorRT-LLM | 4813 | 2848 |
그러므로 프론티어에는 두 주인이 있습니다. 자신의 한계 아래 지연에 민감한 서빙에는 TensorRT-LLM, 최대 처리량에는 vLLM입니다. 요점은 이것입니다. 올바른 엔진은 상수가 아니라 동작점의 함수입니다.
TensorRT-LLM: 버전 1.2.1의 백엔드
처리량 수치를 저울에 올리기 전에 이것을 읽으세요. 우리는 TensorRT-LLM을 PyTorch 백엔드에서 실행했습니다. Hugging Face 체크포인트를 불러와 사전 엔진 빌드 없이 서빙합니다. TensorRT-LLM 1.2 기준 PyTorch가 유일한 실행 백엔드입니다.
NVIDIA의 TensorRT-LLM 1.2 릴리스 노트는 TensorRT 백엔드와 엔진 빌드 CLI의 제거를 기록합니다. 4,813 tok/s 결과는 이 스윕에서 우리가 보고한 TensorRT-LLM 1.2.1의 가장 높은 처리량입니다. 다른 워크로드나 구성의 한계를 세우지 않습니다. TensorRT-LLM은 중간 범위에서 세 엔진 중 가장 낮은 첫 토큰 지연을 냈습니다. 우리가 실행한 구성들 중 vLLM이 가장 높은 처리량에 도달했습니다.
토큰당 비용
하나의 공식으로 처리량을 달러로 바꿉니다. 100만 토큰당 비용은 GPU 시간당 가격을 지속 시간당 토큰으로 나눈 것입니다. H100은 시간당 $3.95, L40S는 시간당 $1.95, 임대, 2026년 6월 20일 관찰입니다.
| 엔진 | bf16 / H100 | fp8 / H100 | bf16 / L40S |
|---|---|---|---|
| vLLM | 0.206 | 0.158 | 0.425 |
| SGLang | 0.21 | 0.17 | 0.438 |
| TensorRT-LLM | 0.228 | 측정 안 함 | 측정 안 함 |
H100에서 vLLM의 보고된 유도 비용은 fp8에서 100만 출력 토큰당 $0.158, bf16에서 $0.206입니다. 공개된 fp8 결과에는 처리량이나 지연 행이 없습니다. 가속을 세우지 않습니다.
공개된 vLLM bf16 비용 행은 L40S에서 100만 출력 토큰당 $0.425, H100에서 $0.206입니다. L40S 비용은 기록된 속도와 포화점에서 대략 두 배입니다. L40S의 처리량이나 지연 행은 공개되지 않았으므로 이 결과는 속도 비교를 뒷받침하지 않습니다.
공유 접두사 워크로드
RAG와 에이전트 트래픽은 요청들에 걸쳐 긴 시스템 프롬프트를 재사용하므로 접두사 캐시가 도움되어야 합니다. 재사용의 모양이 중요하므로 두 가지 방식으로 실행했습니다.
하나의 공유 접두사
먼저 간단한 경우입니다. 2,048 토큰 접두사 하나를 요청의 일부에 보내고, 그 비율을 0에서 90퍼센트까지 바꾸며, 캐싱을 켜고 껐습니다. 적중이 0일 때도 캐시 켜짐이 캐시 꺼짐을 이미 앞섭니다. vLLM은 999 대 910 tok/s(9.7%), SGLang은 937 대 879(6.5%). 이 차이는 공개된 데이터로 설명되지 않고 캐시 재사용의 증거가 아닙니다. 이 스윕의 하드웨어와 정밀도는 공개되지 않았습니다. 결정 가이드의 비율은 같은 엔진의 적중률 90%에서 캐시 켜짐과 꺼짐을 비교합니다.
| 접두사 캐시 적중률 (%) | vLLM (캐시 켜짐) | vLLM (캐시 꺼짐) | SGLang (캐시 켜짐) | SGLang (캐시 꺼짐) |
|---|---|---|---|---|
| 0 | 999 | 910 | 937 | 879 |
| 50 | 1559 | 912 | 1528 | 873 |
| 90 | 2855 | 910 | 2488 | 875 |
캐싱을 켜면 vLLM이 모든 적중률에서 SGLang에 앞섰습니다. 적중 0에서 6.6퍼센트, 50퍼센트에서 2.0퍼센트, 90퍼센트에서 14.7퍼센트. 우리는 이 차이에서 승자를 읽지 않습니다. 단일 공유 접두사는 블록 수준 캐시라면 누구나 잘 다루는 쉬운 경우입니다. SGLang의 RadixAttention이 만들어진 워크로드가 아닙니다.
서로 다른 접두사가 많은 경우, RadixAttention의 경우
RadixAttention은 한꺼번에 트리에 담긴 서로 다른 접두사가 많은 경우를 위해 설계되었습니다. 갈라지는 대화와 시스템 프롬프트 풀에서 나오는 모양입니다. 그래서 그것을 실행했습니다. 256개 요청을 점점 늘어나는 서로 다른 2,048 토큰 접두사들에 흩어놓았습니다. 8개, 32개, 128개이고, 두 엔진 모두 캐싱을 켰습니다.
| 서로 다른 접두사 수 | vLLM | SGLang |
|---|---|---|
| 8 | 2677 | 2493 |
| 32 | 2277 | 2086 |
| 128 | 1467 | 1376 |
RadixAttention은 작동했습니다. SGLang의 로그가 접두사들을 자신의 트리 캐시에서 곧바로 서빙함을 보여줍니다. 그러나 vLLM의 접두사 캐시는 모든 접두사 수에서 6.6~9.1퍼센트 처리량을 앞섰고 TTFT도 더 낮았습니다. H100 하나에서 Llama-3.1-8B로 우리는 RadixAttention의 처리량 승리를 재현하지 못했습니다. 그것이 겨냥하는 워크로드에서도 마찬가지입니다. 두 엔진 모두 공유 접두사를 잘 캐시하고, vLLM이 6.6~9.1퍼센트 더 빨랐으며 이 하드웨어에서의 일반적 우위와 일치합니다. RadixAttention은 우리가 시험한 것보다 긴 접두사, 깊은 트리, 더 무거운 제거 압박에서는 앞설 수 있습니다. 우리의 시험에서는 그렇지 않았고, 우리는 그렇다고 주장하지 않겠습니다.
증거 공개 범위
하니스, 원본 CSV, 신뢰 구간은 공개되지 않았습니다. 표들은 우리의 자체 보고 측정과 밝힌 조건을 보존하지만, 완전한 재현 꾸러미는 아닙니다. 2026년 9월 20일 업데이트: 이전의 오픈소스와 재현 주장은 철회되었습니다.
2026-11-13 업데이트: 표를 요약하는 문장들이 이제 표가 주는 수치를 말하고, 하드웨어는 제공자를 밝히지 않고 임대라고 설명됩니다. 바뀐 측정 행, 유도 비용, 날짜, 조건은 없습니다.
FAQ
vLLM 아니면 SGLang? 평범한 고유 프롬프트 트래픽에서 vLLM이 우리 시험의 모든 동시성에서 앞섰습니다. 처리량에서 1.8~9.0퍼센트, SGLang의 첫 토큰까지의 시간은 6.2~26.2퍼센트 더 높았습니다. vLLM의 유도 비용도 공개된 모든 구성에서 더 낮았습니다. 기본으로 vLLM을 쓰고, 프로그래밍 가능한 프론트엔드가 워크로드에 맞을 때 SGLang을 고르세요.
TensorRT-LLM은 쓸 만합니까? 자신의 처리량 한계 아래 지연에 민감한 서빙이라면 예. 중간 범위 전체에서 가장 낮은 첫 토큰까지의 시간을 지켰습니다. 동시성 32에서 235 ms 대 vLLM의 514 ms. 우리는 TensorRT-LLM 1.2.1의 유일한 실행 백엔드인 PyTorch 백엔드를 실행했습니다.
어떤 GPU를 써야 합니까? Llama-3.1-8B의 보고된 유도 GPU 비용에서 H100이 공개된 bf16 행에서 더 낮습니다. vLLM에서 수치는 H100에서 100만 출력 토큰당 $0.206, L40S에서 $0.425입니다. L40S의 처리량이나 지연 행은 공개되지 않았으므로 이 결과는 속도 비교를 뒷받침하지 않습니다.
방법 노트와 주의점
H100 80GB 하나와 L40S 48GB 하나, 임대, 단일 GPU, 텐서 병렬 크기 1.
엔진들에 걸쳐 같은 Llama-3.1-8B-Instruct 가중치와 같은 요청 스트림. 시간 측정 반복 세 번. 원본 반복과 신뢰 구간은 공개되지 않았습니다.
여기서 지연은 TTFT와 요청별 백분위수이지, 고정 SLO에서의 굿풋이 아닙니다. 높은 부하에서 첫 토큰 514 ms가 받아들일 수 있는지는 사용 사례에 달렸습니다. SLO 굿풋 스윕은 향후 과제입니다.
수치는 우리 하니스 위의 자체 보고이고 MLPerf 같은 외부 스위트와 교차 보정되지 않았습니다. 하니스와 원본 데이터가 공개되지 않았으므로 이 글은 독립적 재현을 뒷받침하지 않습니다.
TensorRT-LLM 1.2.1은 유일한 실행 백엔드인 PyTorch 백엔드를 실행했습니다. NVIDIA의 TensorRT-LLM 1.2 릴리스 노트는 TensorRT 백엔드와 엔진 빌드 CLI의 제거를 기록합니다.
L40S 스윕은 동시성 128(그 포화)에서, H100은 256에서 멈췄습니다.
엔진들은 매주 움직입니다. 이 수치는 2026년 6월 20일 기준 vLLM 0.23.0, SGLang 0.5.13, TensorRT-LLM 1.2.1입니다.