GPU 커널, CUDA, 스케일링. 연구실의 제품 노트.
NVIDIA B300에서 Thinking Machines의 Inkling 모델을 위한 공개 커널: 네이티브 NVFP4, 단계마다 1행이든 64행이든 동일한 로짓.
글: Jaber Jaber
RightNow는 우리의 첫 번째 결정 모델입니다.
글: RightNow AI
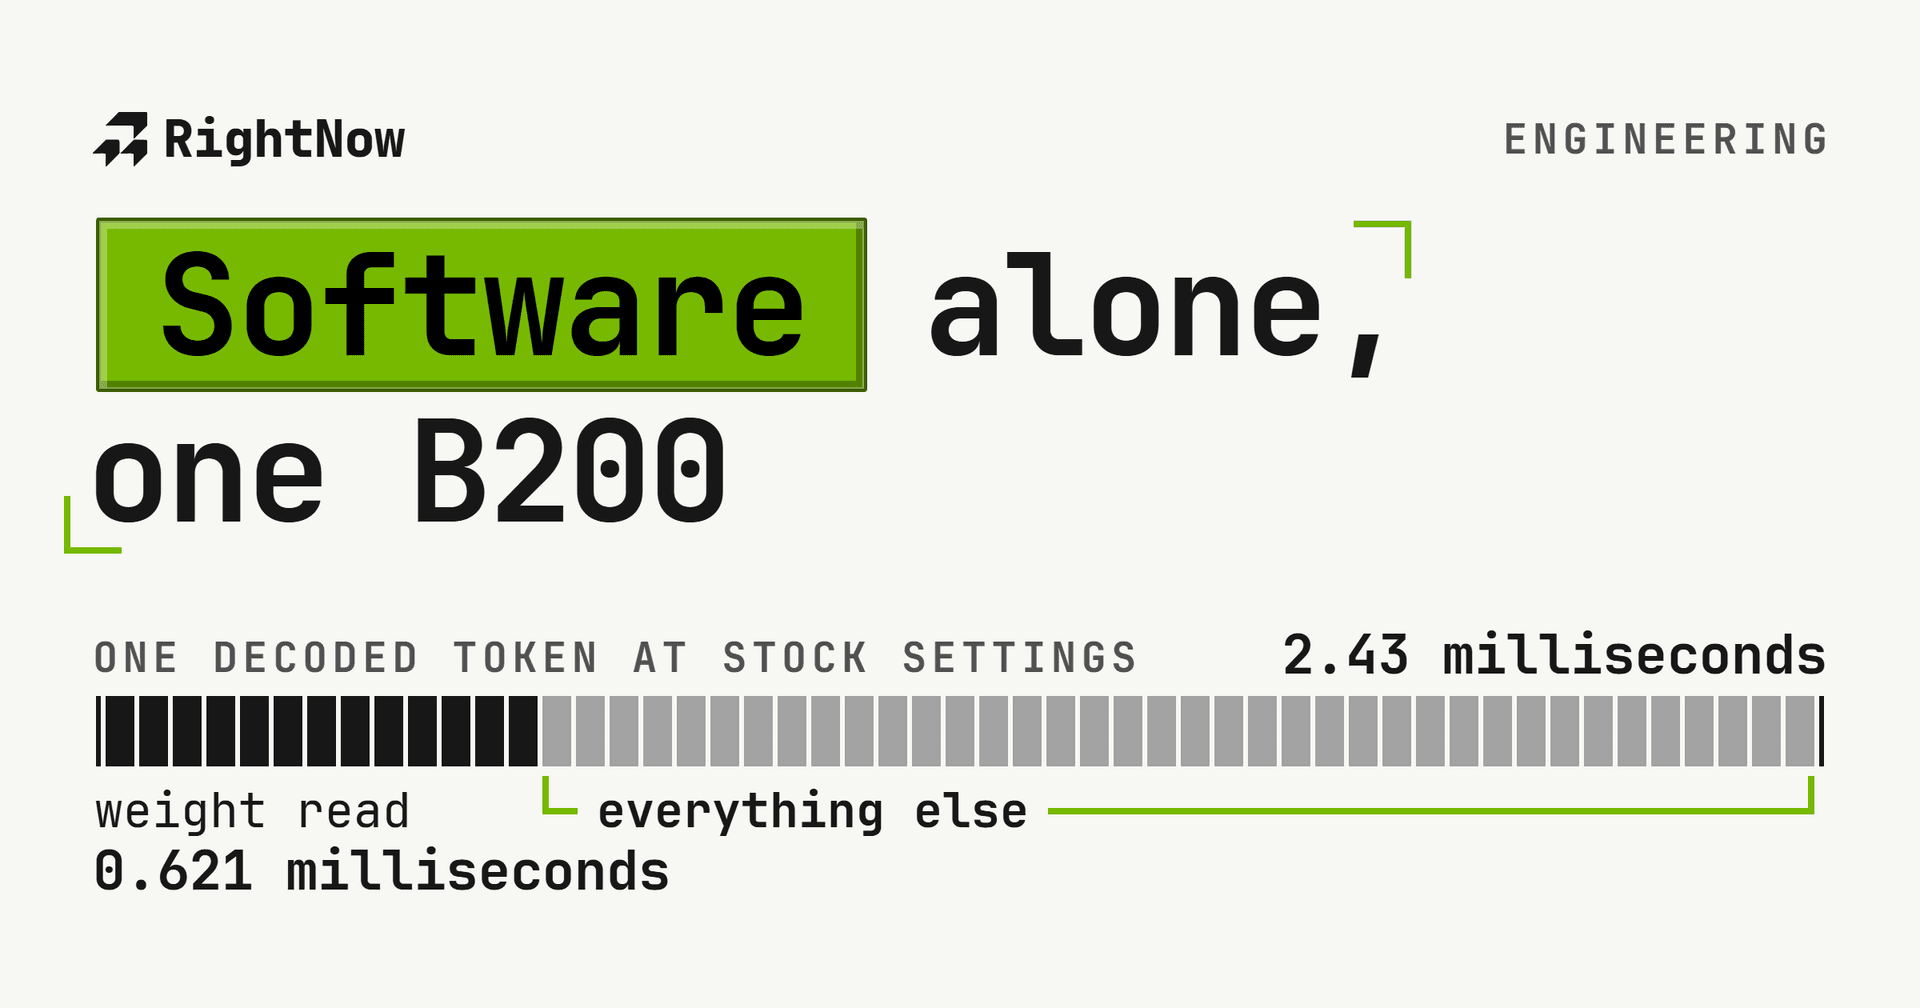
순정 SGLang이 대여한 B200 한 장에서 gpt-oss-120b를 초당 411 토큰으로 서빙했습니다. 네 가지 설정이 같은 카드와 같은 가중치를 1,366으로 끌어올렸고 단일 프롬프트는 2,215에 도달했습니다. 커널은 작성되지 않았고 재컴파일도 없습니다.
모델을 건드리지 않고 LLM 서빙을 빠르게 만드는 방법. 정확한 커널, 추측 디코딩, 무손실 압축, KV 재사용, 스케줄링, 그리고 그 수식과 로짓 패리티로 검증하는 방법.
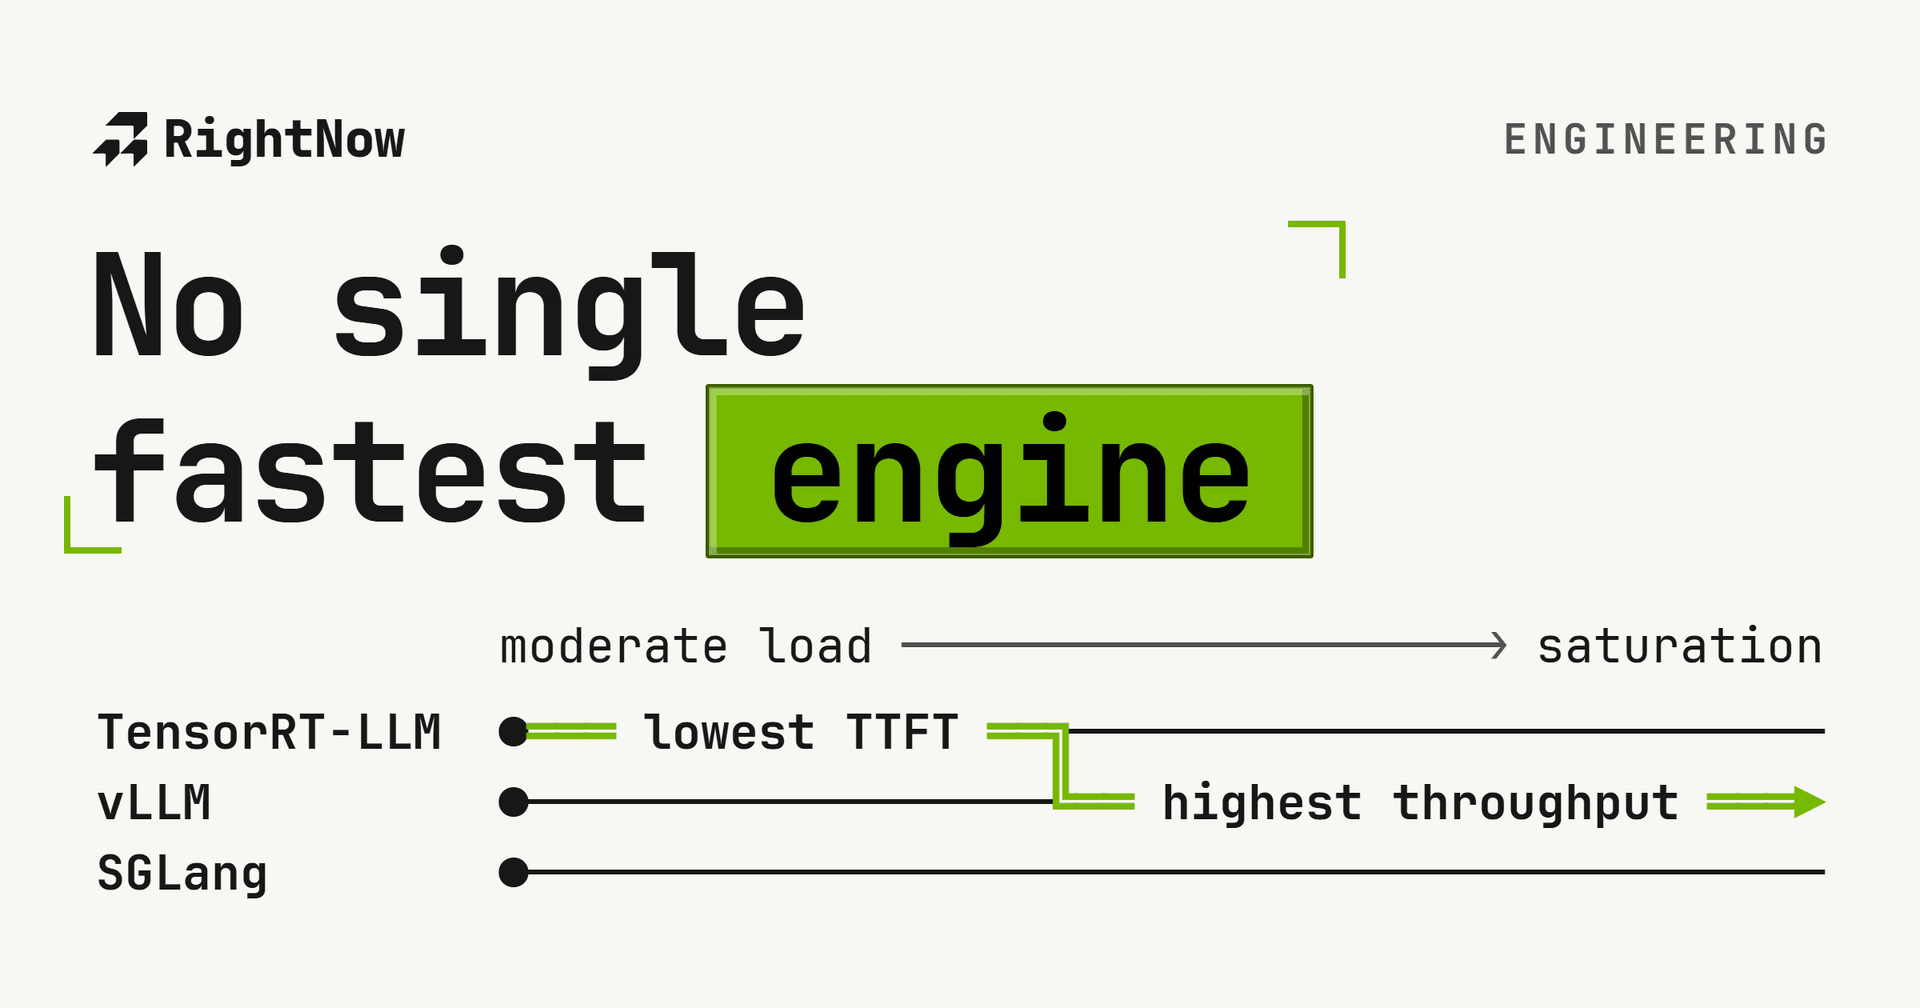
세 LLM 추론 엔진에 대한 Llama-3.1-8B의 자체 보고 결과입니다. 공개된 고유 프롬프트 처리량과 지연 시간 행은 H100 bf16을 다룹니다. FP8과 L40S는 파생된 비용 결과에만 나타납니다. 테스트 하네스와 원본 데이터는 공개되어 있지 않습니다.
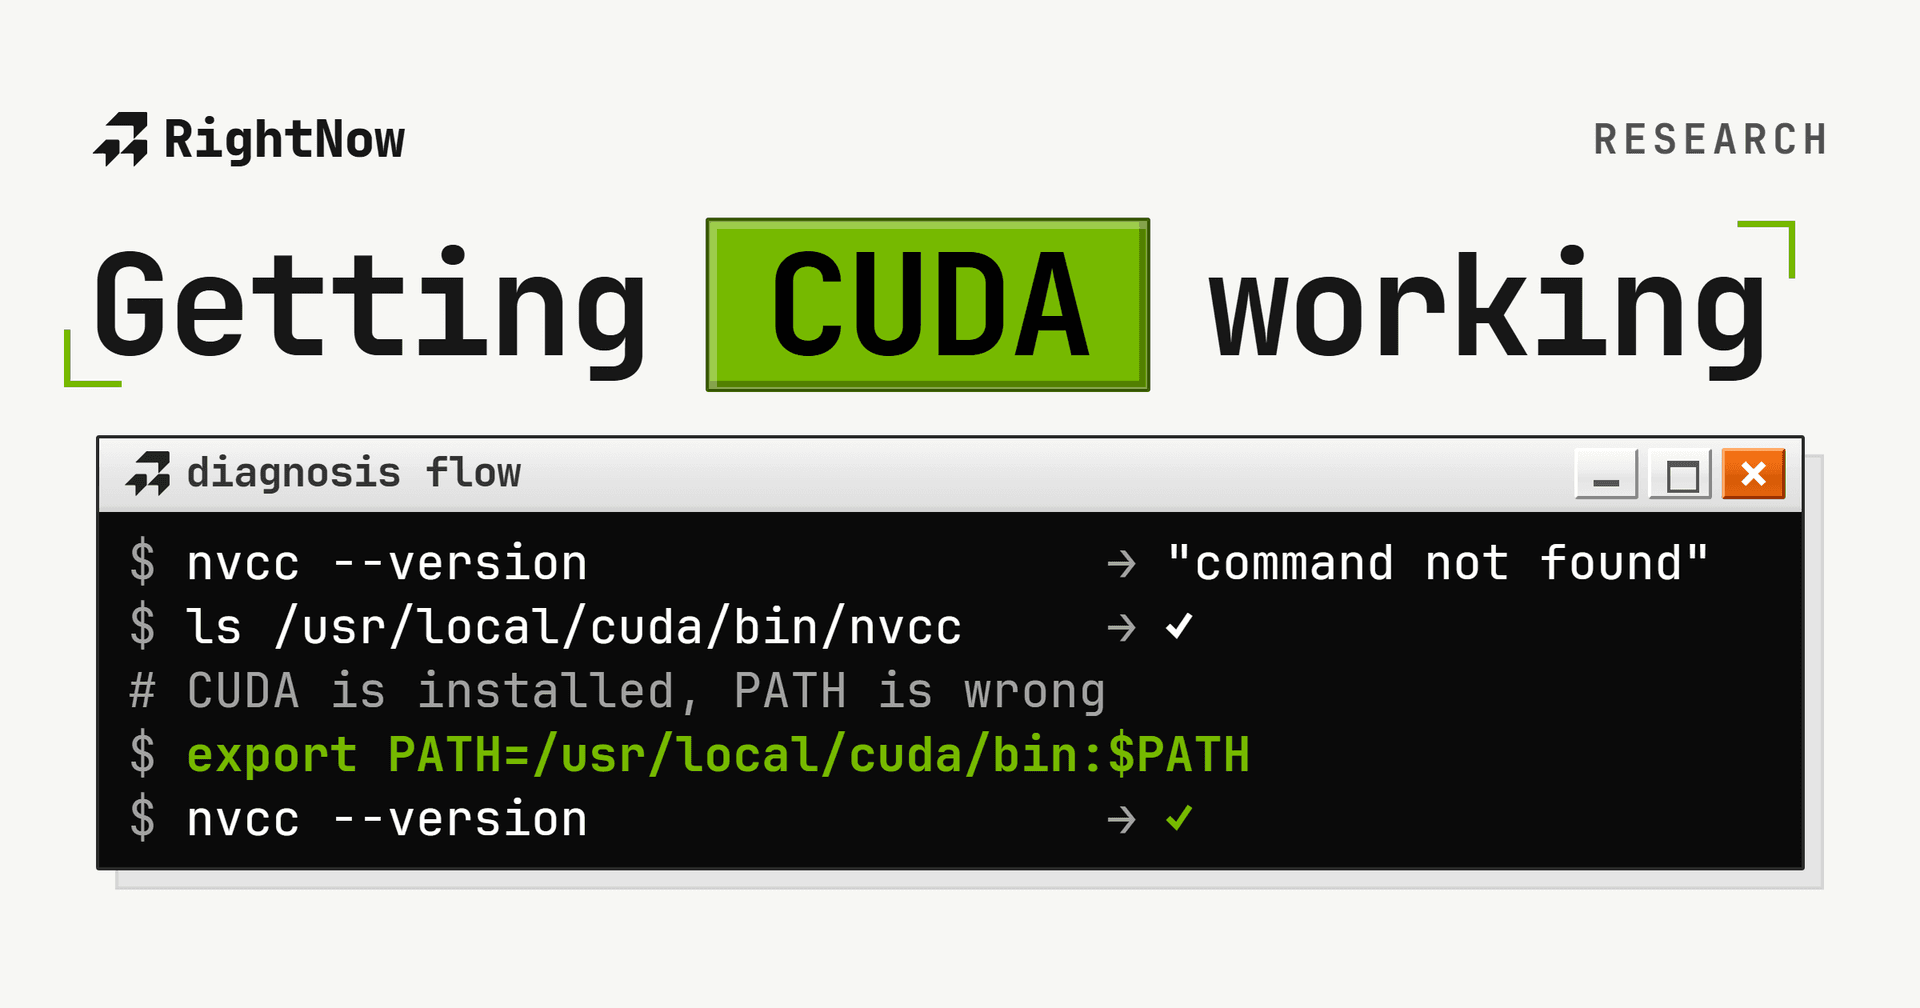
CUDA가 동작하기까지 며칠을 쓸 필요는 없습니다. 수백 건의 설치 실패를 분석한 뒤, PATH 오류, 드라이버 불일치, WSL2 문제 등에 필요한 모든 해결책을 정리했습니다. nvcc와 싸우는 대신 코딩을 시작하세요.
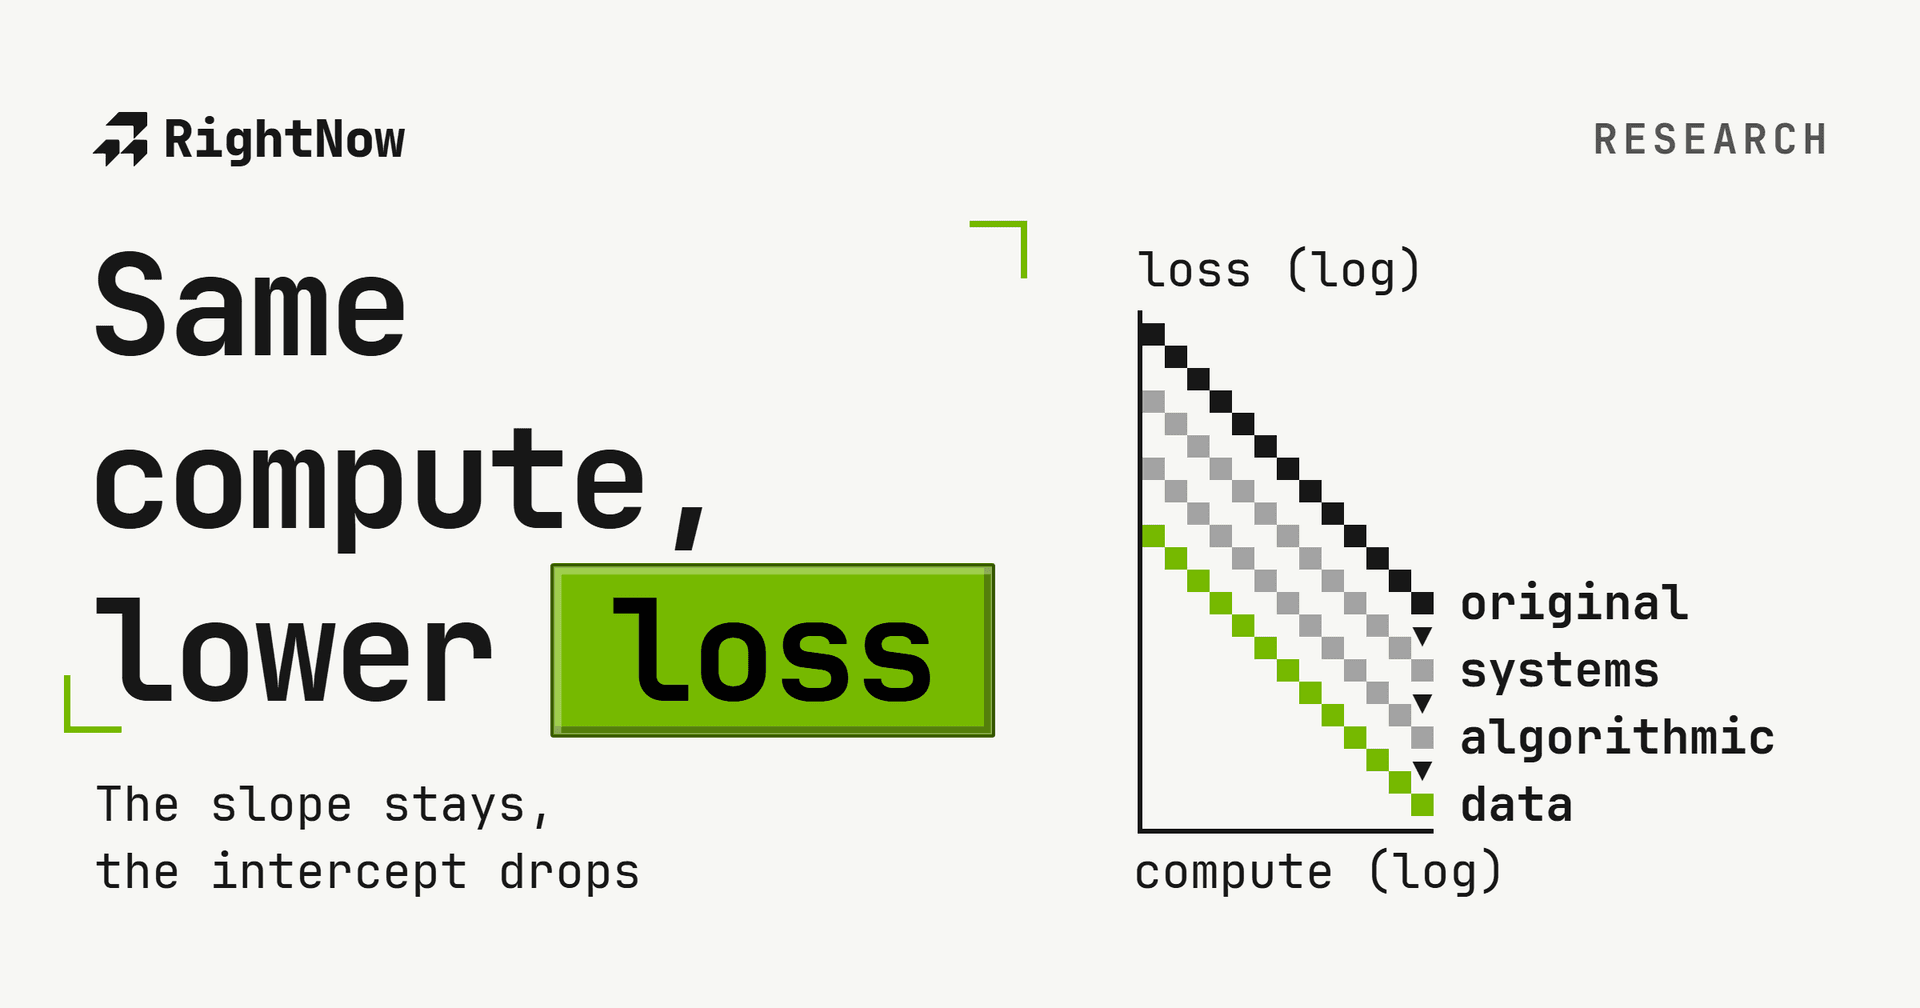
연구자들이 컴퓨팅량에 대한 모델의 교차 엔트로피 손실을 log-log 눈금에 그리면 결과는 거의 직선입니다. 컴퓨팅량, 모델 크기, 학습 토큰이 늘수록 손실은 예측 가능하게 떨어집니다. 이 경험적 규칙(스케일링 법칙)은 팀이 수익을 예측하게 해주지만 한계도 보여줍니다. GPU를 더 사도 한계 수익은 체감합니다.
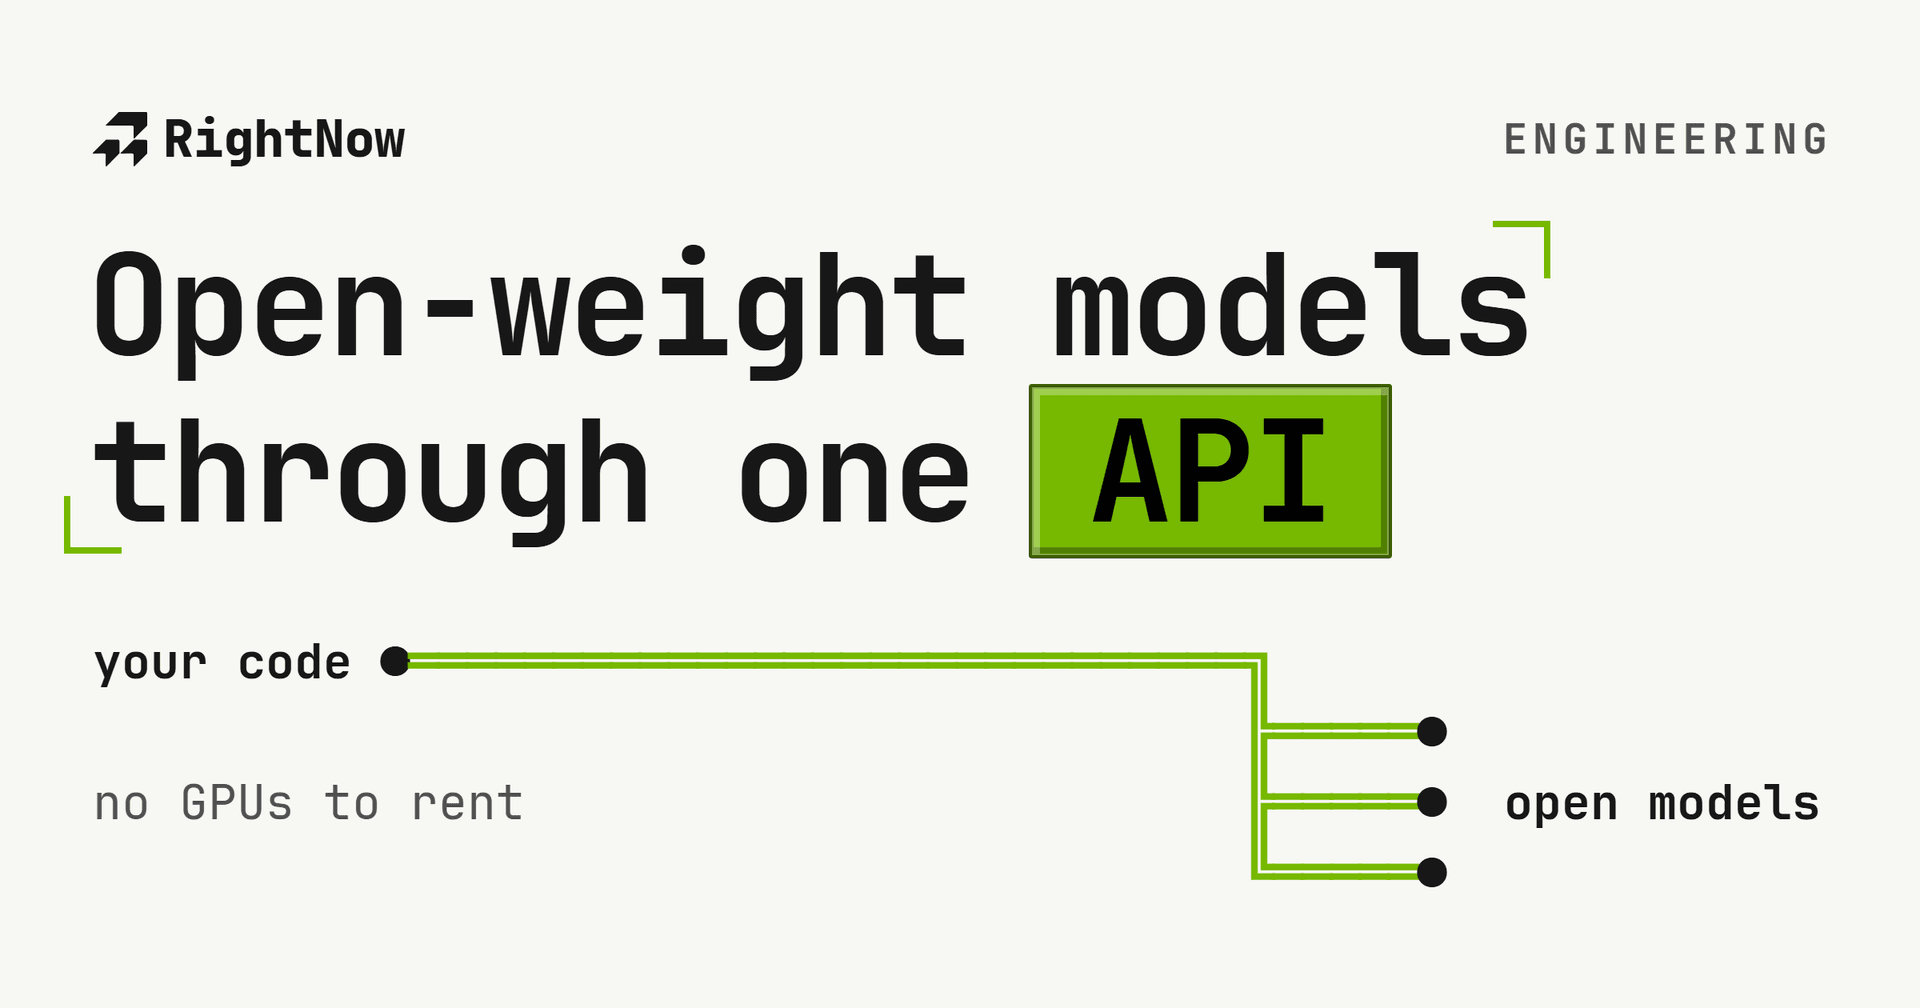
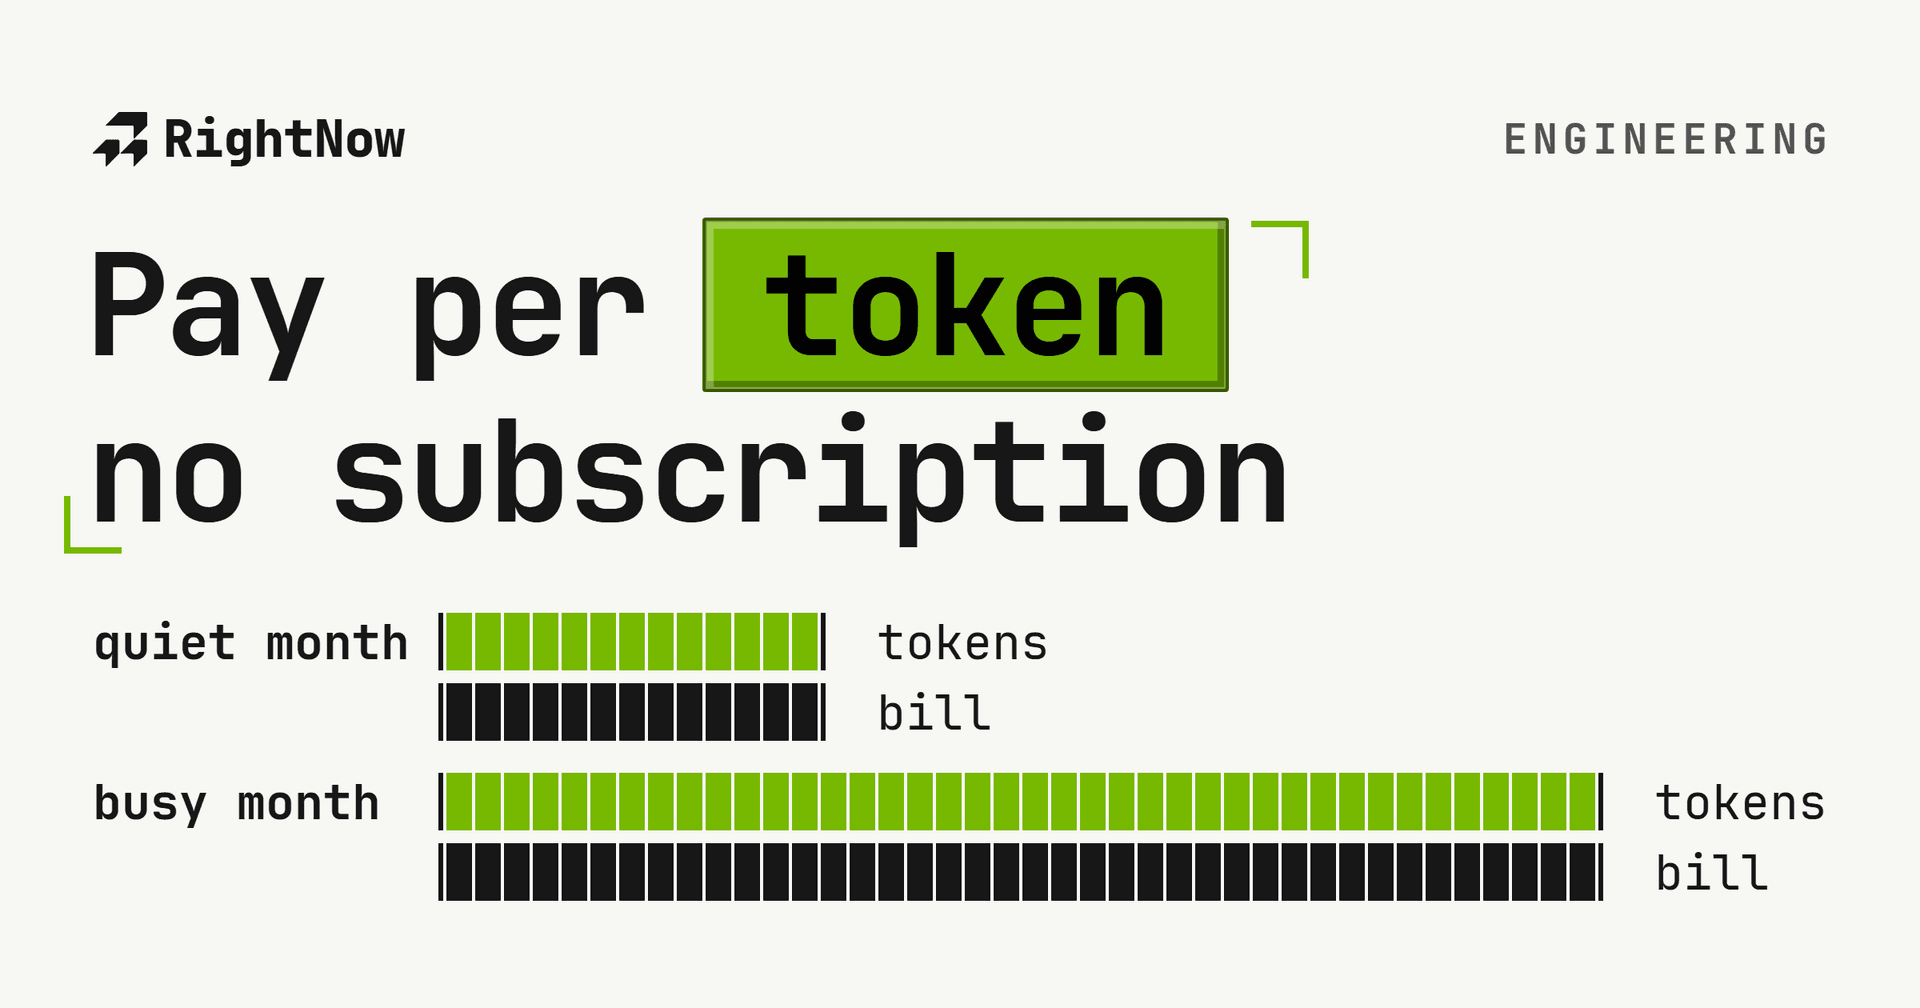
하나의 워크스페이스 키로 두 프로토콜을 통해 오픈 모델을 호출하고, 하나의 잔액에서 토큰 단위로 지불하세요. 구독은 없습니다.
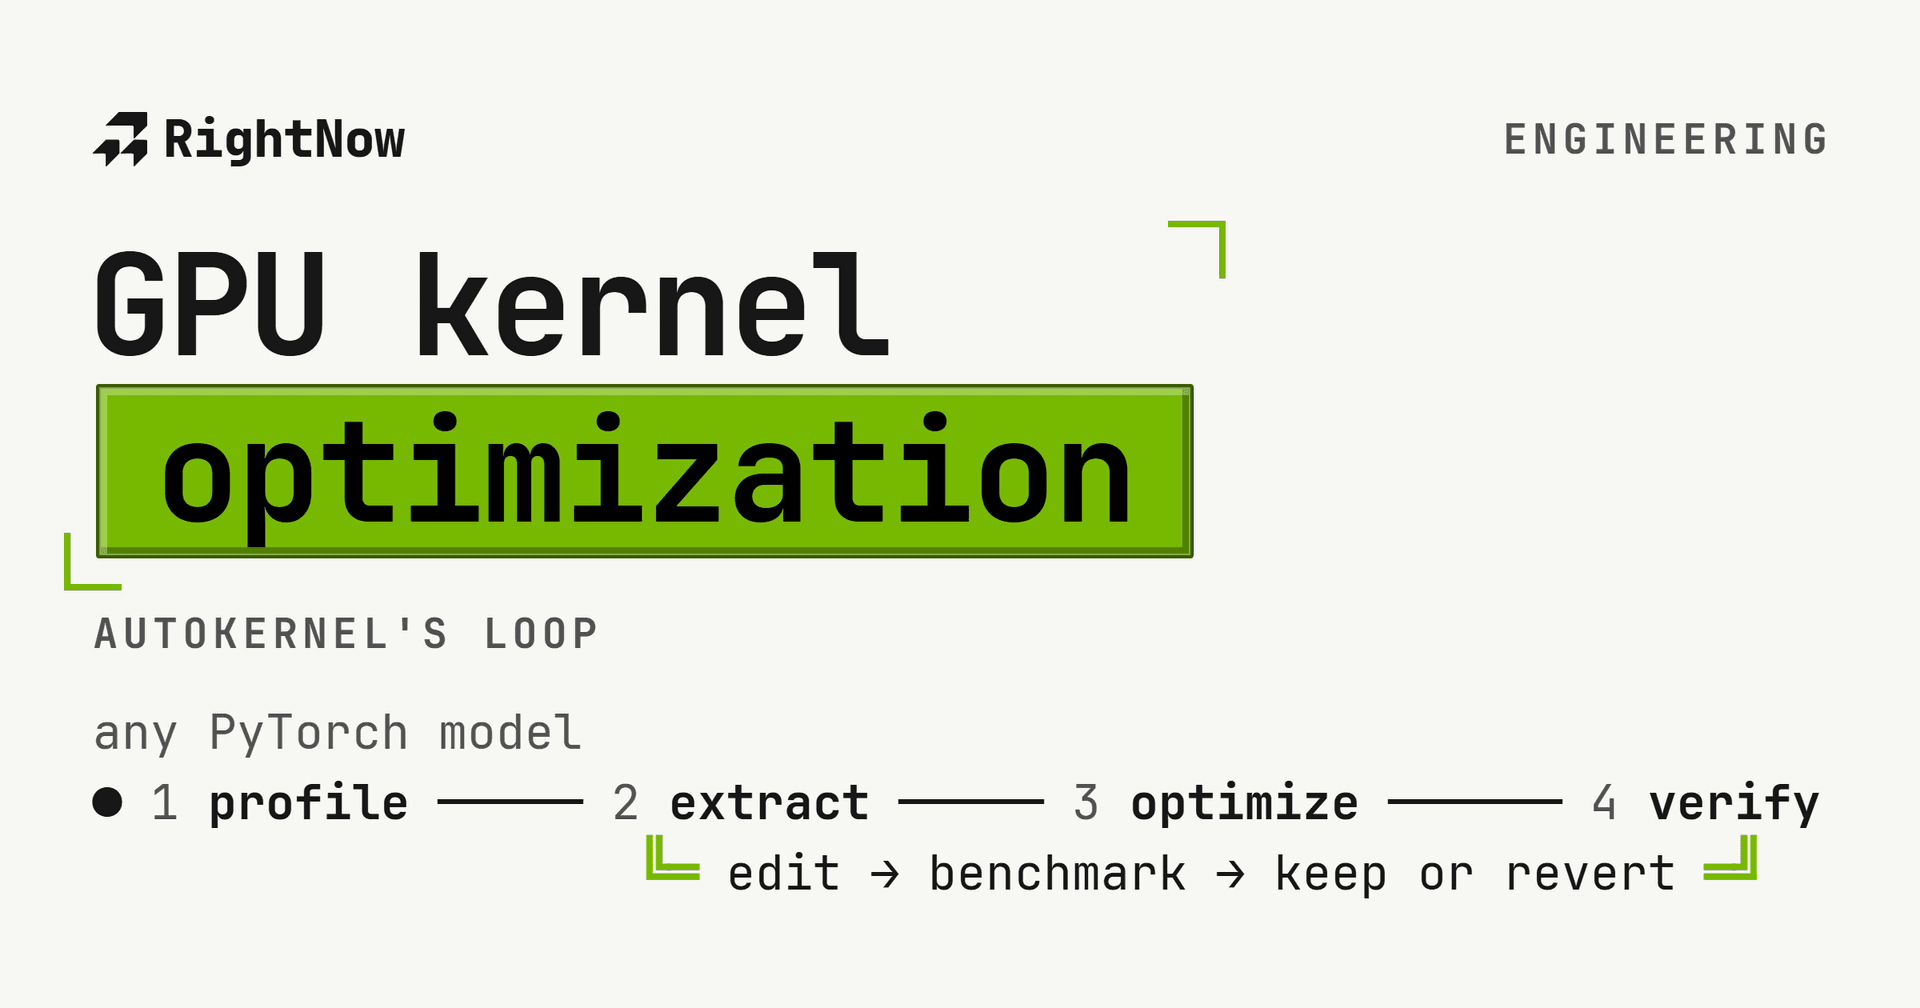
RightNow AI의 오픈소스 GPU 커널 최적화 도구 AutoKernel은 PyTorch 모델을 프로파일링하고, Triton 변형을 테스트하며, 측정된 병목을 따라갑니다.
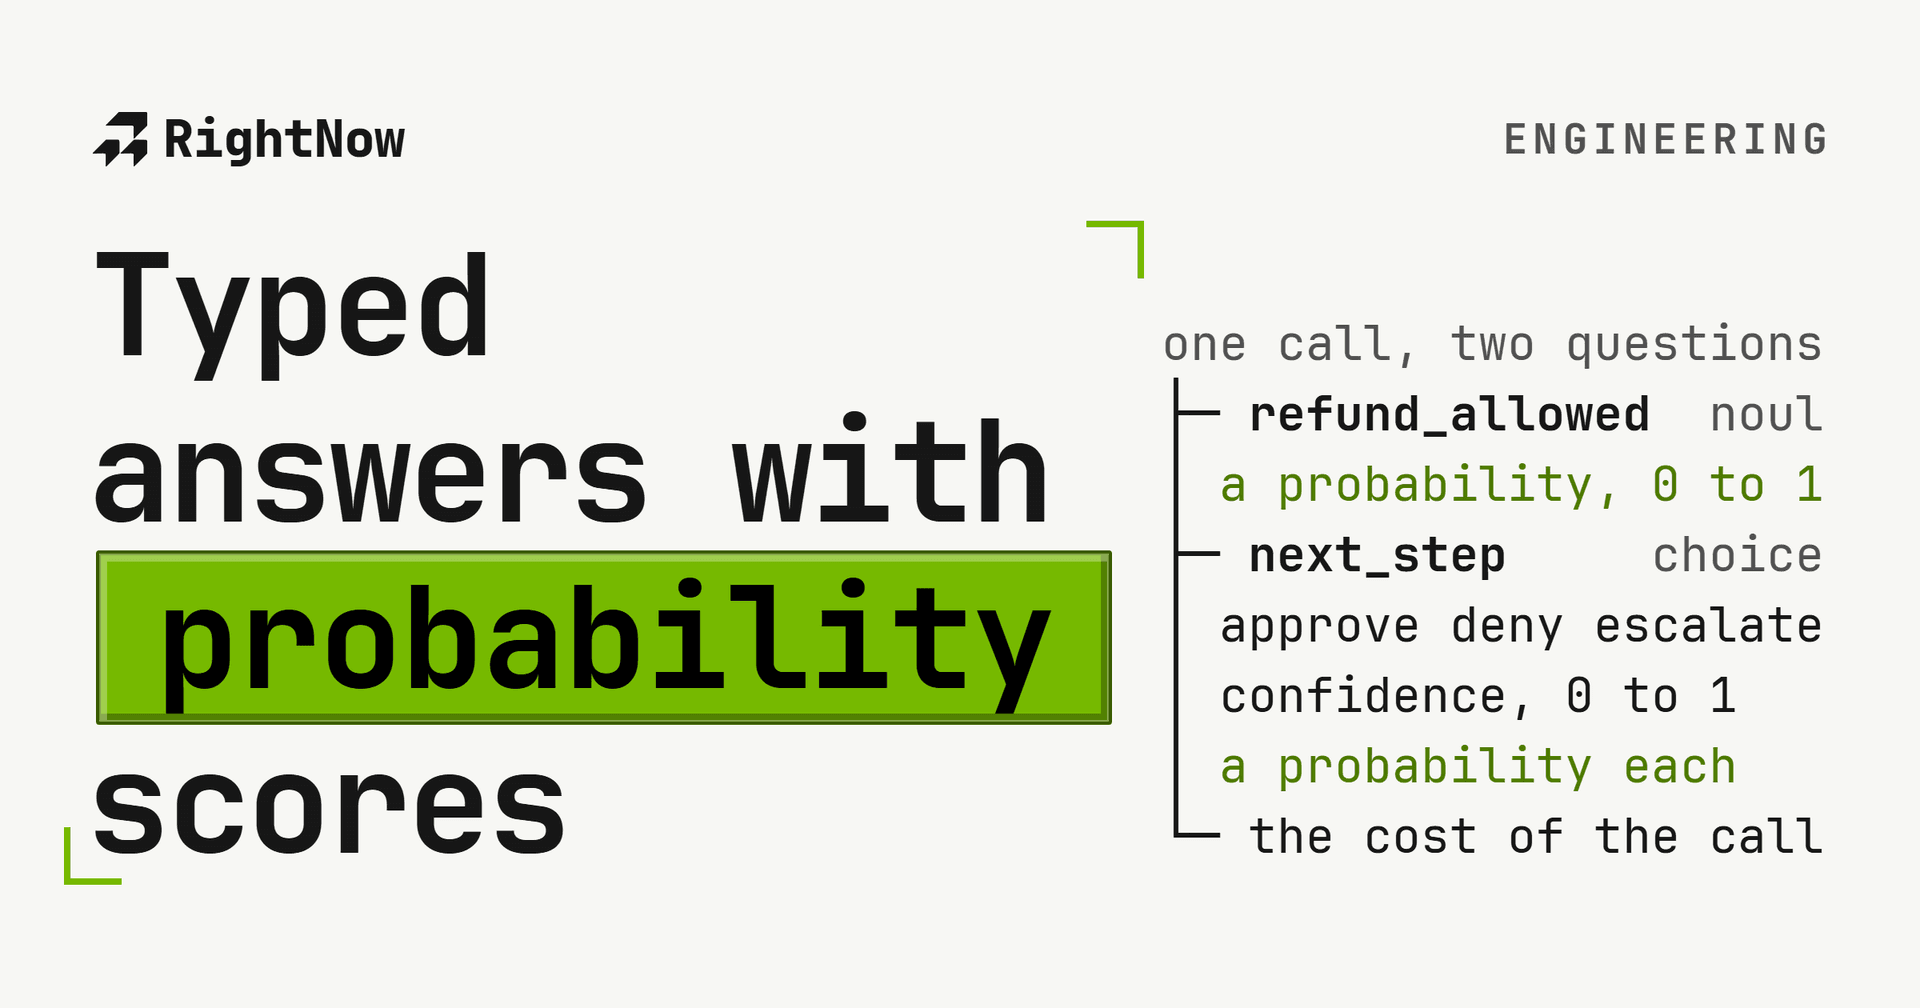
RightNow decision model은 구조화된 결정을 내립니다. 상태와 이름이 붙은 질문을 보내고, 확률, 신뢰도, 타입이 지정된 답변을 읽으세요.
RightNow의 오픈 모델 API는 정가로 토큰 단위 과금하며 구독도 사용자당 요금도 없고, Batch는 정가의 절반으로 동작합니다.