
스케일링 벽을 어떻게 깰 것인가
, 3분 소요, By Jaber Jaber
Research연구자들이 모델의 크로스 엔트로피 손실을 로그-로그 스케일의 컴퓨트에 대해 그리면 결과는 거의 직선입니다. 컴퓨트, 모델 크기, 학습 토큰이 늘수록 손실은 예측 가능하게 떨어집니다. 이 경험적 규칙성(스케일링 법칙)은 팀이 수익을 예측하게 하지만, 한계도 보여줍니다. GPU를 더 사는 것은 한계 수익이 줄어듭니다.
DeepMind의 컴퓨트 최적 연구는 이후, 고정된 컴퓨트 예산에서 올바른 모델 크기로 더 많은 토큰을 학습하는 것이 단순히 파라미터 수를 늘리는 것보다 나을 수 있음을 보였습니다. 그래서 토큰과 데이터 위생이 모델 규모 자체만큼 중요합니다.
이 두 사실이 우리가 관심을 두는 문제를 정합니다. 엔지니어링 질문은 스케일링 법칙이 존재하는지가 아닙니다. 질문은 같은 FLOPs가 더 낮은 손실을 사도록 그 로그-로그 직선의 절편을 어떻게 옮기는가입니다.
아래에서 절편을 확실하게 옮기는 메커니즘을 개요로 짚고, 어떤 스택에서도 실행할 수 있는 1주 플레이북을 드립니다.
실제로 절편을 옮기는 것
1) 모든 토큰을 더 유익하게: 데이터 위생과 타깃팅. 중복과 낮은 가치의 텍스트를 제거하세요. 높은 신호의 예시를 점수 매기고 가중치를 주세요. 무작위 합성 텍스트를 학습에 쏟아붓는 대신, 실제 실패 모드를 겨냥한 작고 목적이 분명한 합성 데이터를 만드세요. 이 단계들은 표본 효율을 높이고 각 학습 단계의 실효 가치를 끌어올립니다.
2) 선형 FLOPs 없이 실효 용량을 올리기: 알고리즘 기법. 조건부 컴퓨트(희소성, MoE)는 토큰마다 필요한 파라미터만 활성화합니다. 저계수 어댑터(LoRA)는 훨씬 적은 학습 가능 파라미터로 능력을 파인튜닝하게 합니다. 실용적인 양자화(예: 4비트 워크플로)는 정확도를 지키면서 메모리와 대역폭 비용을 줄입니다.
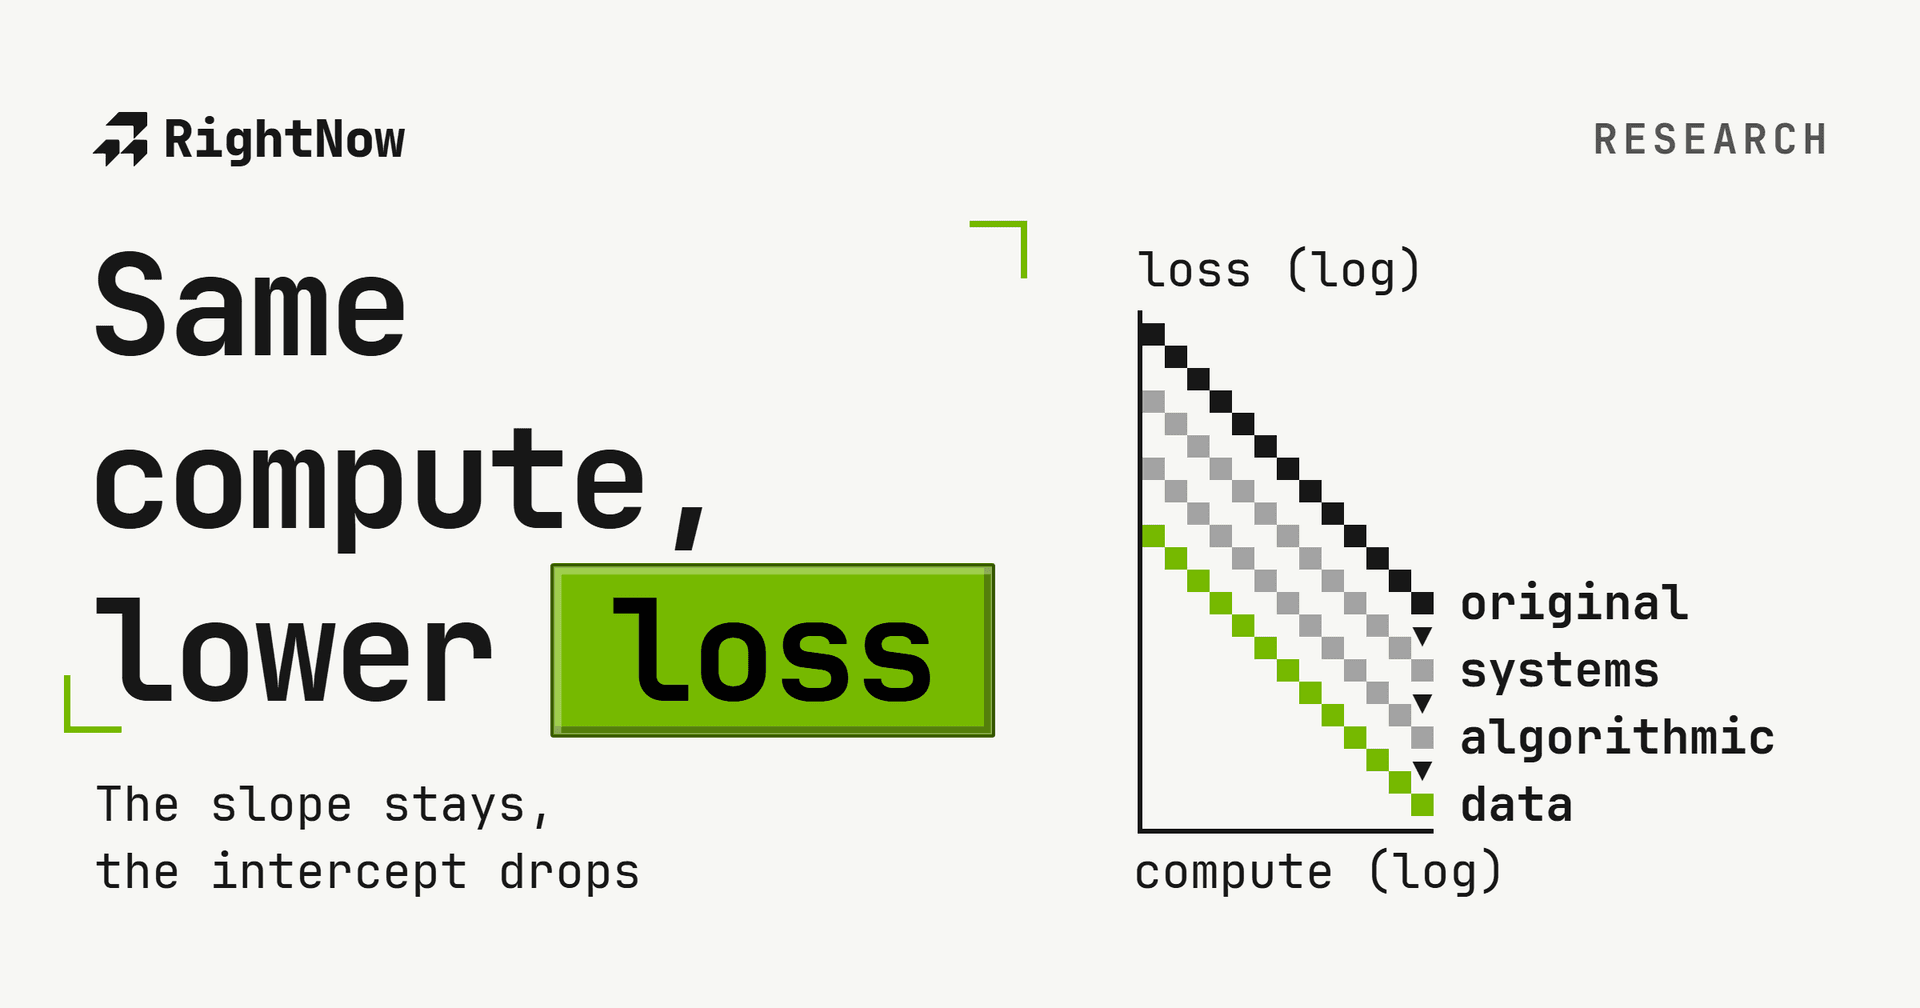
이 기법들은 스케일링 법칙의 상수를 바꿉니다. 기울기는 그대로이고 절편은 내려갑니다.
3) 하드웨어를 짜내기: 지불한 사이클을 유용한 진전으로 바꾸는 시스템 엔지니어링. 실제 실행을 프로파일링하고 핫 패스를 고치세요. IO가 많은 어텐션을 IO를 아는 커널(FlashAttention)로 바꾸고, 커널을 융합해 불필요한 복사를 없애고, 메모리 레이아웃을 최적화하고, 파이프라인/텐서/데이터 병렬의 조합을 조율하세요. 메모리 샤딩(ZeRO)은 GPU별 메모리 압박과 통신 지연을 줄입니다.
이 수정들은 유휴 사이클이나 막힌 사이클을 실제로 손실을 줄이는 FLOPs로 바꿉니다.
이 세 무리를 쌓으면 같은 FLOP 예산으로 손실이 낮아집니다. 로그-로그 그림에서 직선 전체를 아래로 내리는 효과입니다.
스케일링 시각화
Loss (log)
  │
  │\
  │ \\
  │  \\\    original scaling (Kaplan-style power law)
  │   \\\
  │    \\\     ← after systems optim (FlashAttention, ZeRO)
  │     \\\
  │      \\\   ← after algorithmic optim (MoE, LoRA, quant)
  │       \\\  ← after data optim (dedupe, targeted synth)
  └──────────────────────────────────── Compute (log)
     C0     C1     C2     C3
해석: 기울기(스케일링 지수)는 남습니다. 데이터, 알고리즘, 시스템 개입은 절편을 낮춥니다. 같은 컴퓨트에 더 낮은 손실입니다.
지불한 컴퓨트가 흔히 새는 곳 (먼저 측정)
Typical waste breakdown (illustrative)
┌─────────────────────────────────────┐
│ Duplicates / low-value tokens : 30% │
│ Kernel inefficiencies         : 25% │
│ Communication / imbalance     : 20% │
│ Checkpoint / IO overhead      : 15% │
│ Suboptimal hyperconfig        : 10% │
└─────────────────────────────────────┘
이 손실의 일부라도 되찾으면 훨씬 더 큰 클러스터에 맞먹는 실효 결과를 낼 수 있습니다.
1주 플레이북 (실용적: 지금 실행)
1일차: 전체 실행 프로파일링. 커널과 통신 트레이스를 잡으세요. 경과 시간 기준 상위 3개 핫스팟을 찾으세요.
2일차: 데이터 위생. 대표적인 부분에 중복 제거와 품질 점수 매기기를 돌리세요. 한 에포크를 재학습하고 검증 손실을 비교하세요.
3일차: 값싼 파인튜닝. 전체 재학습 대신 타깃 실패 모드에 LoRA/QLoRA를 쓰고 GPU시간당 이득을 측정하세요.
4일차: 커널 수정. 핵심 연산자를 IO를 아는 구현(예: FlashAttention)으로 바꾸거나, 커널을 융합하거나, 텐서 레이아웃을 바꾸세요. 경과 시간 변화를 측정하세요.
5일차: 분산 튜닝. 필요한 곳에 샤딩/ZeRO를 적용하세요. 다시 프로파일링하고 불균형을 없애세요.
6일차: 작은 조건부 컴퓨트 시험. 부분 집합에서 아주 작은 MoE나 조건부 블록의 원형을 만들어 용량 이득을 검증하세요.
7일차: 합성과 반복. 남은 오류를 겨냥한 합성 예시를 만들고, 적응시키고, 측정하세요.
개선은 항상 달러나 실험 수로 환산하세요. 절약된 초 → 절약된 GPU시간 → 매월 얻는 실험 수입니다.
빠른 과학적 근거
스케일링 법칙: 컴퓨트, 토큰, 모델 크기에 걸친 경험적 멱법칙 관계가 계획의 기울기를 줍니다. (Kaplan et al., 2020)
컴퓨트 최적 트레이드오프: Chinchilla는 토큰이 중요함을 보입니다. 컴퓨트 최적점에서의 학습은 흔히 올바른 모델 크기에서 더 많은 토큰 쪽으로 기웁니다. (Hoffmann et al., 2022)
시스템 승리: IO를 아는 어텐션과 융합 커널은 어텐션이 많은 실행에서 경과 시간을 극적으로 줄입니다. (FlashAttention)
알고리즘 효율: LoRA와 저계수 어댑터는 값싼 파인튜닝을 가능하게 하고, MoE/조건부 컴퓨트는 더 낮은 활성 FLOPs로 큰 실효 모델을 줍니다.
메모리 샤딩: ZeRO와 관련 샤딩 기법은 선형적인 메모리 폭증 없이 노드들을 걸쳐 모델을 확장하게 합니다.