
Cómo romper el muro de escalado
, 3 min de lectura, By Jaber Jaber
ResearchCuando los investigadores grafican la pérdida de entropía cruzada del modelo contra el cómputo en escala log-log, el resultado es una línea casi recta: la pérdida cae de forma predecible a medida que aumentan el cómputo, el tamaño del modelo o los tokens de entrenamiento. Esa regularidad empírica (la ley de escalado) permite a los equipos pronosticar rendimientos, pero también muestra el límite: comprar más GPUs da rendimientos marginales decrecientes.
El trabajo compute-optimal de DeepMind mostró después que, con un presupuesto fijo de cómputo, entrenar más tokens con el tamaño de modelo adecuado puede superar el simple aumento del número de parámetros. Por eso los tokens y la higiene de datos importan tanto como la escala bruta del modelo.
Esos dos hechos plantean el problema que nos importa. La pregunta de ingeniería no es si la ley de escalado existe. La pregunta es cómo desplazar la intersección de esa línea log-log para que los mismos FLOPs compren menos pérdida.
A continuación esbozo los mecanismos que mueven la intersección de forma confiable y doy un plan de una semana que puedes ejecutar en cualquier stack.
Lo que realmente mueve la intersección
1) Haz que cada token sea más informativo: higiene y enfoque de datos. Elimina duplicados y texto de bajo valor. Puntúa y pondera los ejemplos de alta señal. Genera conjuntos de datos sintéticos pequeños y dirigidos a modos de fallo reales en lugar de verter texto sintético aleatorio en el entrenamiento. Estos pasos aumentan la eficiencia de muestra y elevan el valor efectivo de cada paso de entrenamiento.
2) Aumenta la capacidad efectiva sin FLOPs lineales: trucos algorítmicos. El cómputo condicional (sparcidad, MoE) activa solo los parámetros que necesitas por token. Los adaptadores de bajo rango (LoRA) permiten ajustar capacidades con muchos menos parámetros entrenables. La cuantización práctica (por ejemplo, flujos de 4 bits) reduce los costos de memoria y ancho de banda conservando la precisión.
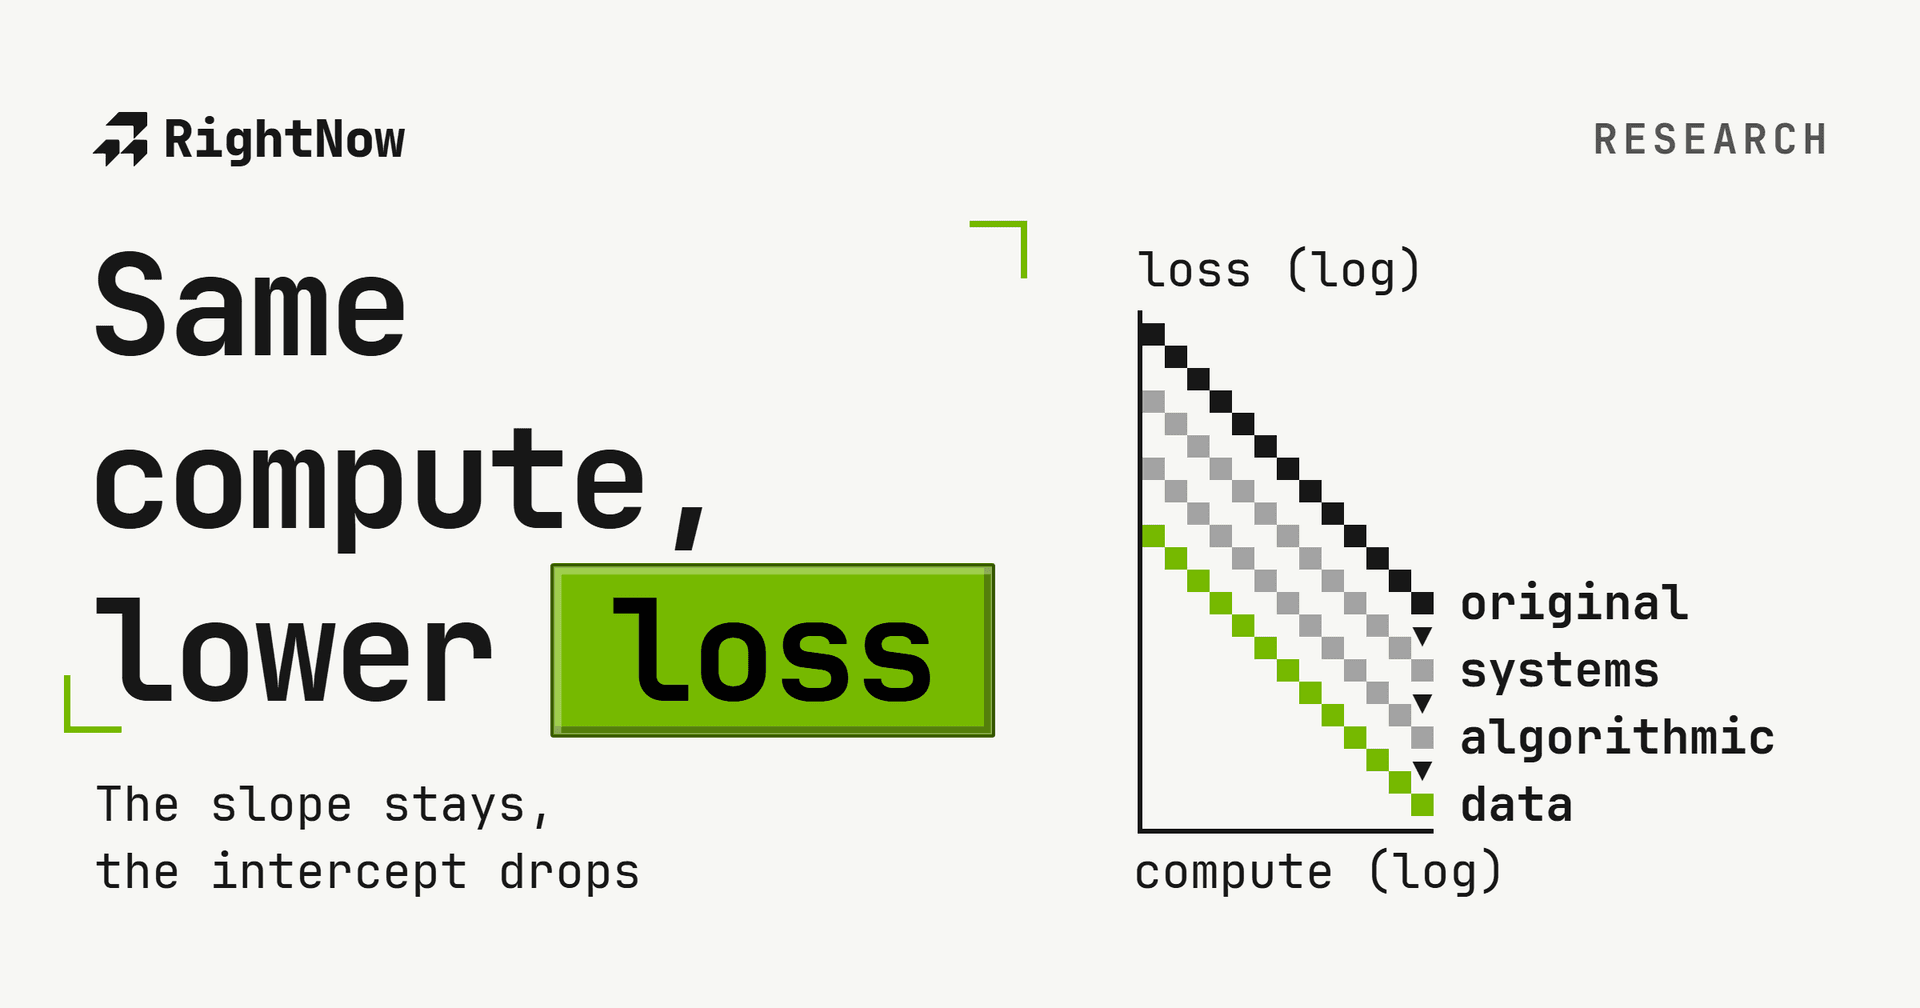
Estas técnicas cambian las constantes de la ley de escalado: la pendiente se queda, la intersección baja.
3) Exprime el hardware: ingeniería de sistemas que convierte ciclos pagados en progreso útil. Perfila ejecuciones reales y corrige las rutas calientes. Reemplaza la atención con mucha IO por kernels conscientes de la IO (FlashAttention), fusiona kernels para eliminar copias extra, optimiza las distribuciones de memoria y ajusta tu mezcla de paralelismo de pipeline/tensor/datos. El sharding de memoria (ZeRO) reduce la presión de memoria por GPU y las detenciones por comunicación.
Estas correcciones convierten ciclos inactivos o bloqueados en FLOPs que de verdad reducen la pérdida.
Apila esos tres grupos y obtienes menos pérdida con el mismo presupuesto de FLOPs: en efecto, desplazas toda la línea hacia abajo en la gráfica log-log.
Visualización del escalado
Loss (log)
  │
  │\
  │ \\
  │  \\\    original scaling (Kaplan-style power law)
  │   \\\
  │    \\\     ← after systems optim (FlashAttention, ZeRO)
  │     \\\
  │      \\\   ← after algorithmic optim (MoE, LoRA, quant)
  │       \\\  ← after data optim (dedupe, targeted synth)
  └──────────────────────────────────── Compute (log)
     C0     C1     C2     C3
Interpretación: La pendiente (el exponente de escalado) permanece. Las intervenciones de datos, algoritmo y sistema bajan la intersección: mismo cómputo, menor pérdida.
Dónde se pierde comúnmente el cómputo pagado (mide primero)
Typical waste breakdown (illustrative)
┌─────────────────────────────────────┐
│ Duplicates / low-value tokens : 30% │
│ Kernel inefficiencies         : 25% │
│ Communication / imbalance     : 20% │
│ Checkpoint / IO overhead      : 15% │
│ Suboptimal hyperconfig        : 10% │
└─────────────────────────────────────┘
Recuperar aunque sea una parte de estas pérdidas puede producir el resultado efectivo de un clúster mucho más grande.
Un plan de una semana (práctico: ejecútalo ahora)
Día 1: Perfila una ejecución completa. Captura trazas de kernels y comunicación; encuentra los 3 puntos calientes por tiempo de reloj.
Día 2: Higiene de datos. Ejecuta deduplicación y puntaje de calidad en una porción representativa. Reentrena una época y compara la pérdida de validación.
Día 3: Ajuste barato. Reemplaza un reentrenamiento completo con LoRA/QLoRA sobre modos de fallo específicos y mide la ganancia por hora de GPU.
Día 4: Correcciones de kernels. Cambia un operador crítico a una implementación consciente de la IO (por ejemplo, FlashAttention), fusiona kernels o cambia la distribución del tensor. Mide el cambio en tiempo de reloj.
Día 5: Ajuste distribuido. Aplica sharding/ZeRO donde corresponda; reperfila y elimina el desbalance.
Día 6: Sonda pequeña de cómputo condicional. Prototipa un MoE diminuto o un bloque condicional en un subconjunto para validar ganancias de capacidad.
Día 7: Sintetiza e itera. Genera ejemplos sintéticos dirigidos a los errores restantes, adapta y mide.
Convierte siempre las mejoras en dólares o en conteos de experimentos: segundos ahorrados → horas de GPU ahorradas → experimentos ganados por mes.
Justificaciones científicas rápidas
Leyes de escalado: la relación empírica de ley de potencia entre cómputo, tokens y tamaño del modelo da la pendiente para planificar. (Kaplan et al., 2020)
Compromiso compute-optimal: Chinchilla muestra que los tokens importan; entrenar en el punto compute-optimal suele favorecer más tokens con el tamaño de modelo adecuado. (Hoffmann et al., 2022)
Victorias de sistemas: la atención consciente de la IO y los kernels fusionados reducen drásticamente el tiempo de reloj en ejecuciones con mucha atención (FlashAttention).
Eficiencia algorítmica: LoRA y los adaptadores de bajo rango permiten ajustes baratos; MoE y el cómputo condicional producen modelos efectivamente grandes con menos FLOPs activos.
Sharding de memoria: ZeRO y técnicas relacionadas de sharding permiten escalar modelos entre nodos sin una explosión lineal de memoria.