
スケーリングの壁をどう破るか
, 3分で読めます, By Jaber Jaber
Research研究者がモデルの交差エントロピー損失を計算量に対して log-log スケールでプロットすると、結果はほぼ直線になります。計算量、モデルサイズ、学習トークンが増えるにつれ、損失は予測どおりに下がります。この経験的規則性 (スケーリング則) によりチームはリターンを予測できますが、限界も示します。GPU を買い足しても、限界収益は逓減していきます。
DeepMind の計算量最適の研究はその後、固定の計算予算では、パラメータ数を増やすよりも、適切なモデルサイズでより多くのトークンを学習する方が優りうることを示しました。だからこそ、トークンとデータの質の管理は、モデルの生の規模と同じくらい重要です。
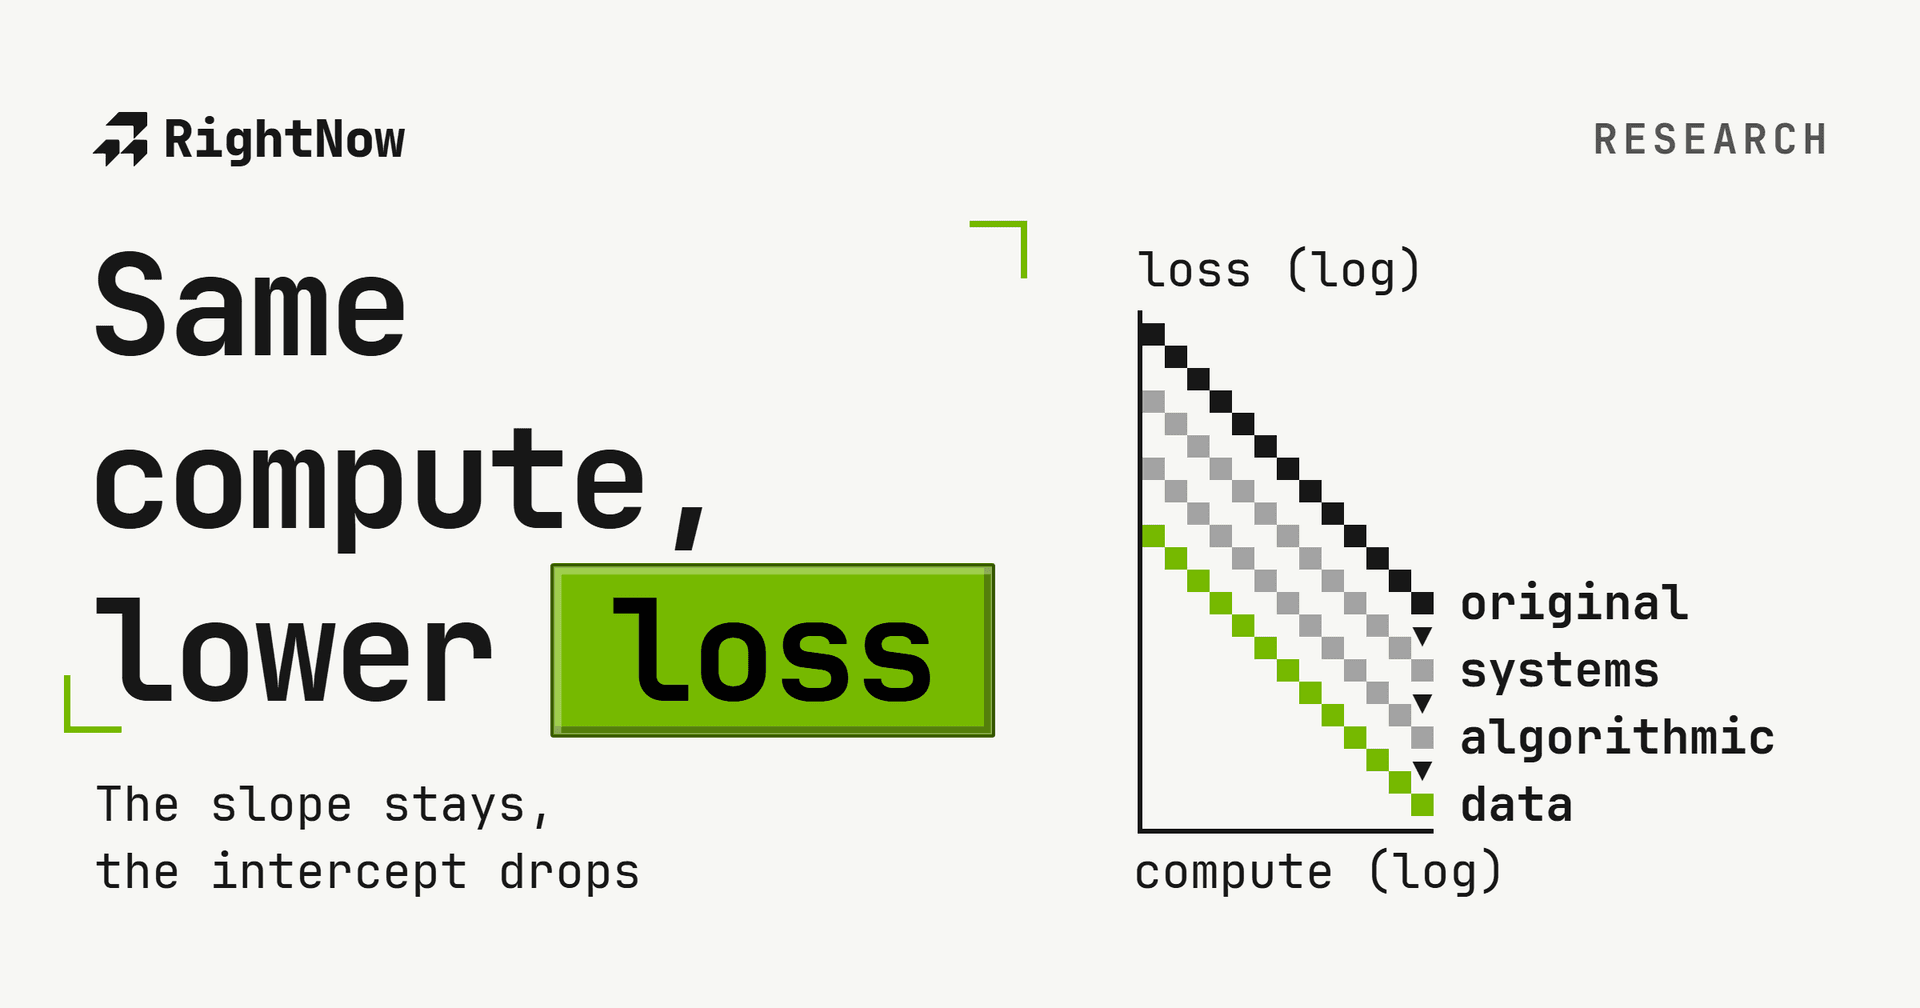
この 2 つの事実が、私たちが大切にしている問題を定めます。エンジニアリング上の問いは、スケーリング則が存在するかどうかではありません。同じ FLOPs でより低い損失を買うために、その log-log の直線の切片をどう動かすかです。
以下に、切片を確実に動かすメカニズムを概説し、どんなスタックでも動く 1 週間のプレイブックを示します。
実際に切片を動かすもの
1) すべてのトークンをより有益にする: データの質の管理と狙い。 重複と価値の低いテキストを除きます。シグナルの強い例をスコア化して重み付けます。ランダムな合成テキストを学習に流し込むのではなく、実際の失敗モードに狙いを定めた小さな合成データセットを生成します。これらのステップはサンプル効率を上げ、各学習ステップの実効価値を高めます。
2) 線形の FLOPs なしで実効容量を上げる: アルゴリズムの工夫。 条件付き計算 (スパース性、MoE) は、トークンごとに必要なパラメータだけを活性化します。低ランクアダプタ (LoRA) は、はるかに少ない学習可能パラメータで能力をファインチューニングできます。実用的な量子化 (たとえば 4 ビットのワークフロー) は、精度を保ちながらメモリと帯域のコストを下げます。
これらの手法はスケーリング則の定数を変えます。傾きはそのままに、切片が下がります。
3) ハードウェアを絞り切る: 支払ったサイクルを有用な進歩に変えるシステムエンジニアリング。 実際の実行をプロファイリングし、ホットパスを直します。IO 中心の attention を IO アウェアなカーネル (FlashAttention) に置き換え、余分なコピーをなくすためにカーネルを融合し、メモリレイアウトを最適化し、パイプライン/テンソル/データ並列の組み合わせを調整します。メモリのシャーディング (ZeRO) は GPU ごとのメモリ圧力と通信の停滞を減らします。
これらの修正は、アイドルやブロックのサイクルを、実際に損失を下げる FLOPs に変えます。
この 3 つのグループを積み重ねれば、同じ FLOP 予算で損失が下がります。実質的に、log-log プロットの直線全体を下へ動かすことになります。
スケーリングの可視化
Loss (log)
  │
  │\
  │ \\
  │  \\\    original scaling (Kaplan-style power law)
  │   \\\
  │    \\\     ← after systems optim (FlashAttention, ZeRO)
  │     \\\
  │      \\\   ← after algorithmic optim (MoE, LoRA, quant)
  │       \\\  ← after data optim (dedupe, targeted synth)
  └──────────────────────────────────── Compute (log)
     C0     C1     C2     C3
解釈: 傾き (スケーリング指数) は変わりません。データ、アルゴリズム、システムへの介入は切片を下げます。同じ計算量で、より低い損失です。
支払った計算量がよく失われる場所 (まず測る)
Typical waste breakdown (illustrative)
┌─────────────────────────────────────┐
│ Duplicates / low-value tokens : 30% │
│ Kernel inefficiencies         : 25% │
│ Communication / imbalance     : 20% │
│ Checkpoint / IO overhead      : 15% │
│ Suboptimal hyperconfig        : 10% │
└─────────────────────────────────────┘
これらの損失の一部を取り戻すだけでも、はるかに大きなクラスターに匹敵する成果が得られます。
1 週間のプレイブック (実用的: 今すぐ実行)
1 日目: 実行全体をプロファイリングする。 カーネルと通信のトレースを取り、実時間で上位 3 つのホットスポットを見つけます。
2 日目: データの質の管理。 代表的なスライスで重複除去と品質スコアリングを実行します。1 エポック再学習し、検証損失を比較します。
3 日目: 低コストのファインチューン。 全再学習を、狙った失敗モードへの LoRA/QLoRA に置き換え、GPU 時間あたりの利得を測ります。
4 日目: カーネル修正。 重要な演算子を IO アウェアな実装 (FlashAttention など) に交換し、カーネルを融合するか、テンソルレイアウトを変えます。実時間の変化を測ります。
5 日目: 分散の調整。 適切な場所にシャーディング/ZeRO を適用し、再プロファイリングして不均衡を除きます。
6 日目: 小さな条件付き計算の試行。 サブセットで小さな MoE か条件付きブロックの試作を作り、容量の利得を確認します。
7 日目: 合成して反復する。 残った誤りに狙いを定めた合成例を生成し、適応し、測定します。
改善は必ずドルか実験回数に換算してください。節約した秒数 → 節約した GPU 時間 → 月あたり増える実験数。
簡潔な科学的根拠
スケーリング則: 計算量、トークン、モデルサイズにわたる経験的べき乗の関係が、計画のための傾きを与えます。(Kaplan et al., 2020)
計算量最適のトレードオフ: Chinchilla はトークンが重要なことを示しました。計算量最適の点での学習は、多くの場合、適切なモデルサイズでより多くのトークンを選びます。(Hoffmann et al., 2022)
システムの勝利: IO アウェアな attention と融合カーネルは、attention が重い実行で実時間を劇的に減らします (FlashAttention)。
アルゴリズムの効率: LoRA と低ランクアダプタは低コストのファインチューニングを可能にし、MoE/条件付き計算はより低いアクティブ FLOPs で大きな実効モデルをもたらします。
メモリのシャーディング: ZeRO と関連するシャーディング技術は、メモリを線形に爆発させずにノードをまたいでモデルをスケールさせます。