GPU カーネル、CUDA、スケーリング。ラボからの製品ノート。
NVIDIA B300 上の Thinking Machines の Inkling モデル向けオープンカーネル: ネイティブ NVFP4、ステップあたり 1 行でも 64 行でも同一のロジット。
執筆: Jaber Jaber
RightNow は私たち初のディシジョンモデルです。
執筆: RightNow AI
標準の SGLang が、レンタルした 1 枚の B200 で gpt-oss-120b を毎秒 411 トークンで提供しました。4 つの設定で同じカードと同じウェイトが 1,366 に、単一プロンプトは 2,215 に達しました。カーネルは書かれておらず、再コンパイルもありません。
モデルに手を加えずに LLM サービングを速くする方法。正確なカーネル、投機的デコーディング、ロスレス圧縮、KV 再利用、スケジューリング、そしてその数理とロジットパリティによる検証方法。
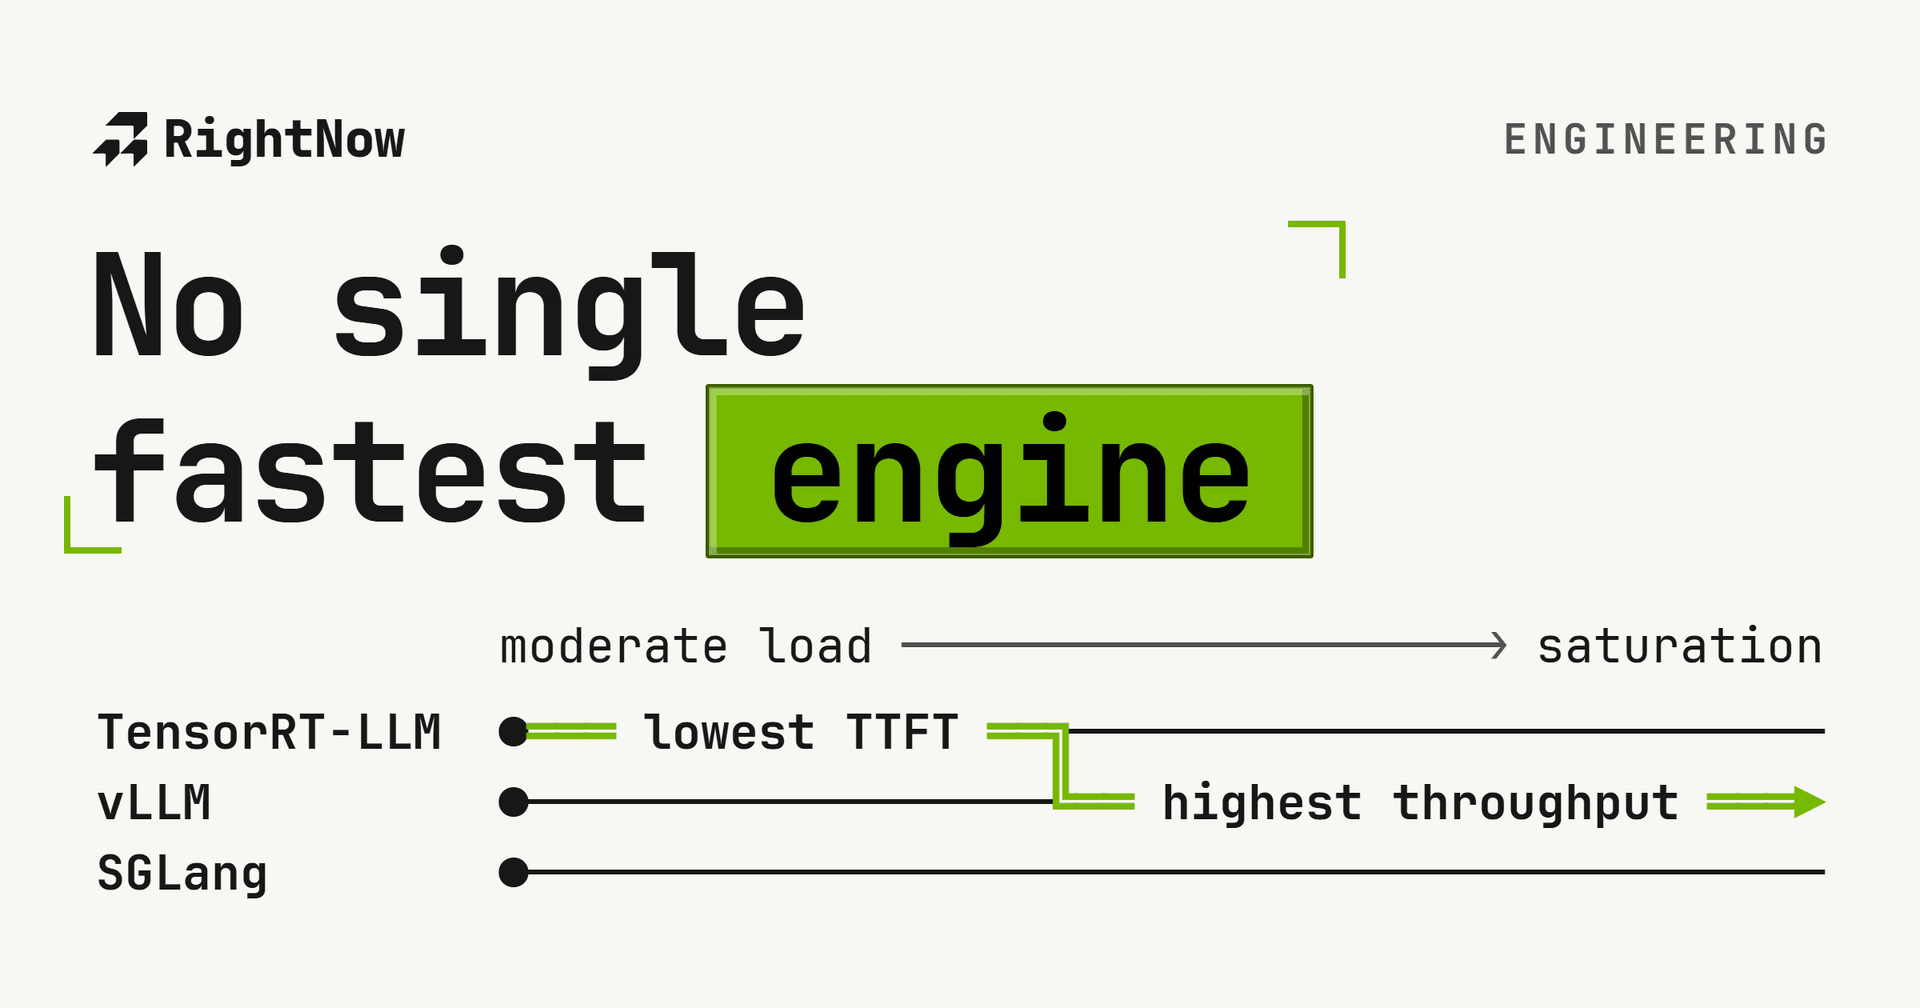
3 つの LLM 推論エンジンにおける Llama-3.1-8B の自己申告結果。公開されているユニークプロンプトのスループットとレイテンシの行は H100 bf16 を対象とします。FP8 と L40S は派生したコスト結果にのみ現れます。ハーネスと生データは公開されていません。
CUDA が動くまでに何日もかかるべきではありません。何百ものインストール失敗を分析し、PATH のエラー、ドライバーの不一致、WSL2 の問題などに必要なすべての修正をまとめました。nvcc と戦うのはやめて、コードを書きましょう。
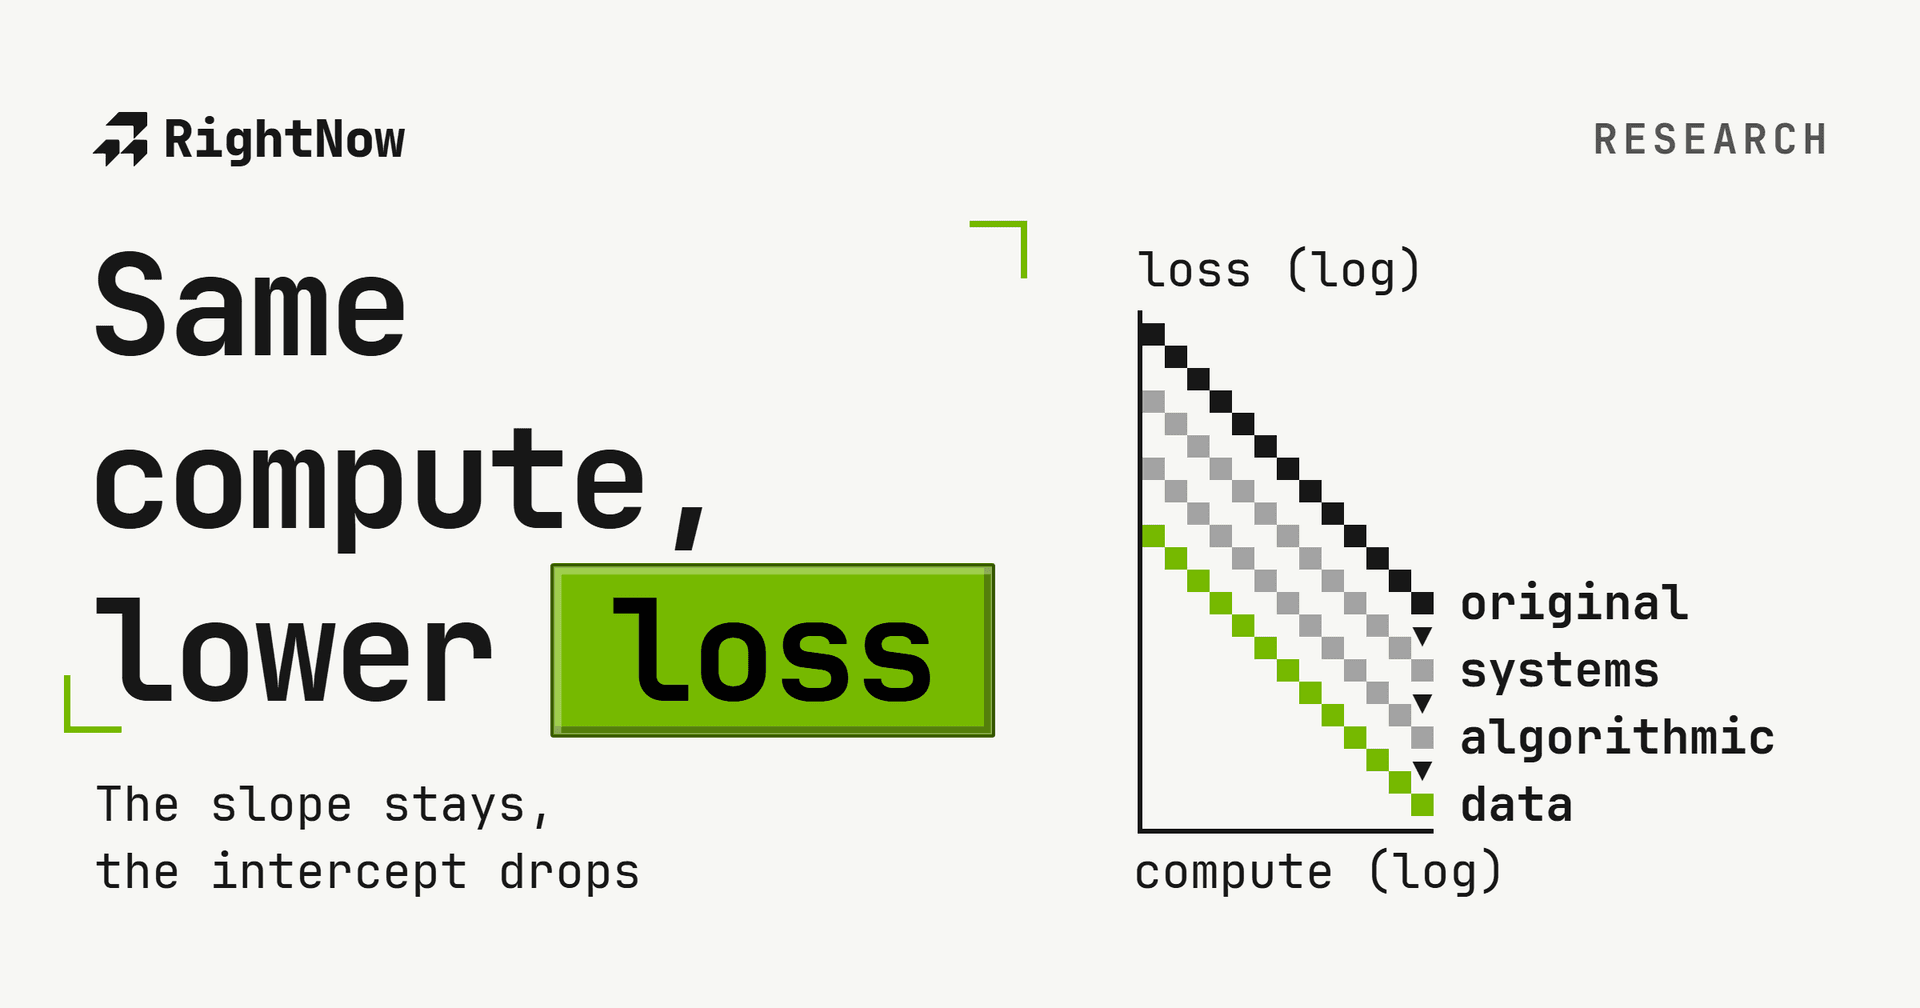
計算量に対するモデルの交差エントロピー損失を log-log スケールでプロットすると、結果はほぼ直線になります。計算量、モデルサイズ、学習トークンが増えるにつれ、損失は予測どおりに下がります。この経験的規則性(スケーリング則)によりチームはリターンを予測できますが、限界も示します。GPU を買い足しても限界収益は逓減していきます。
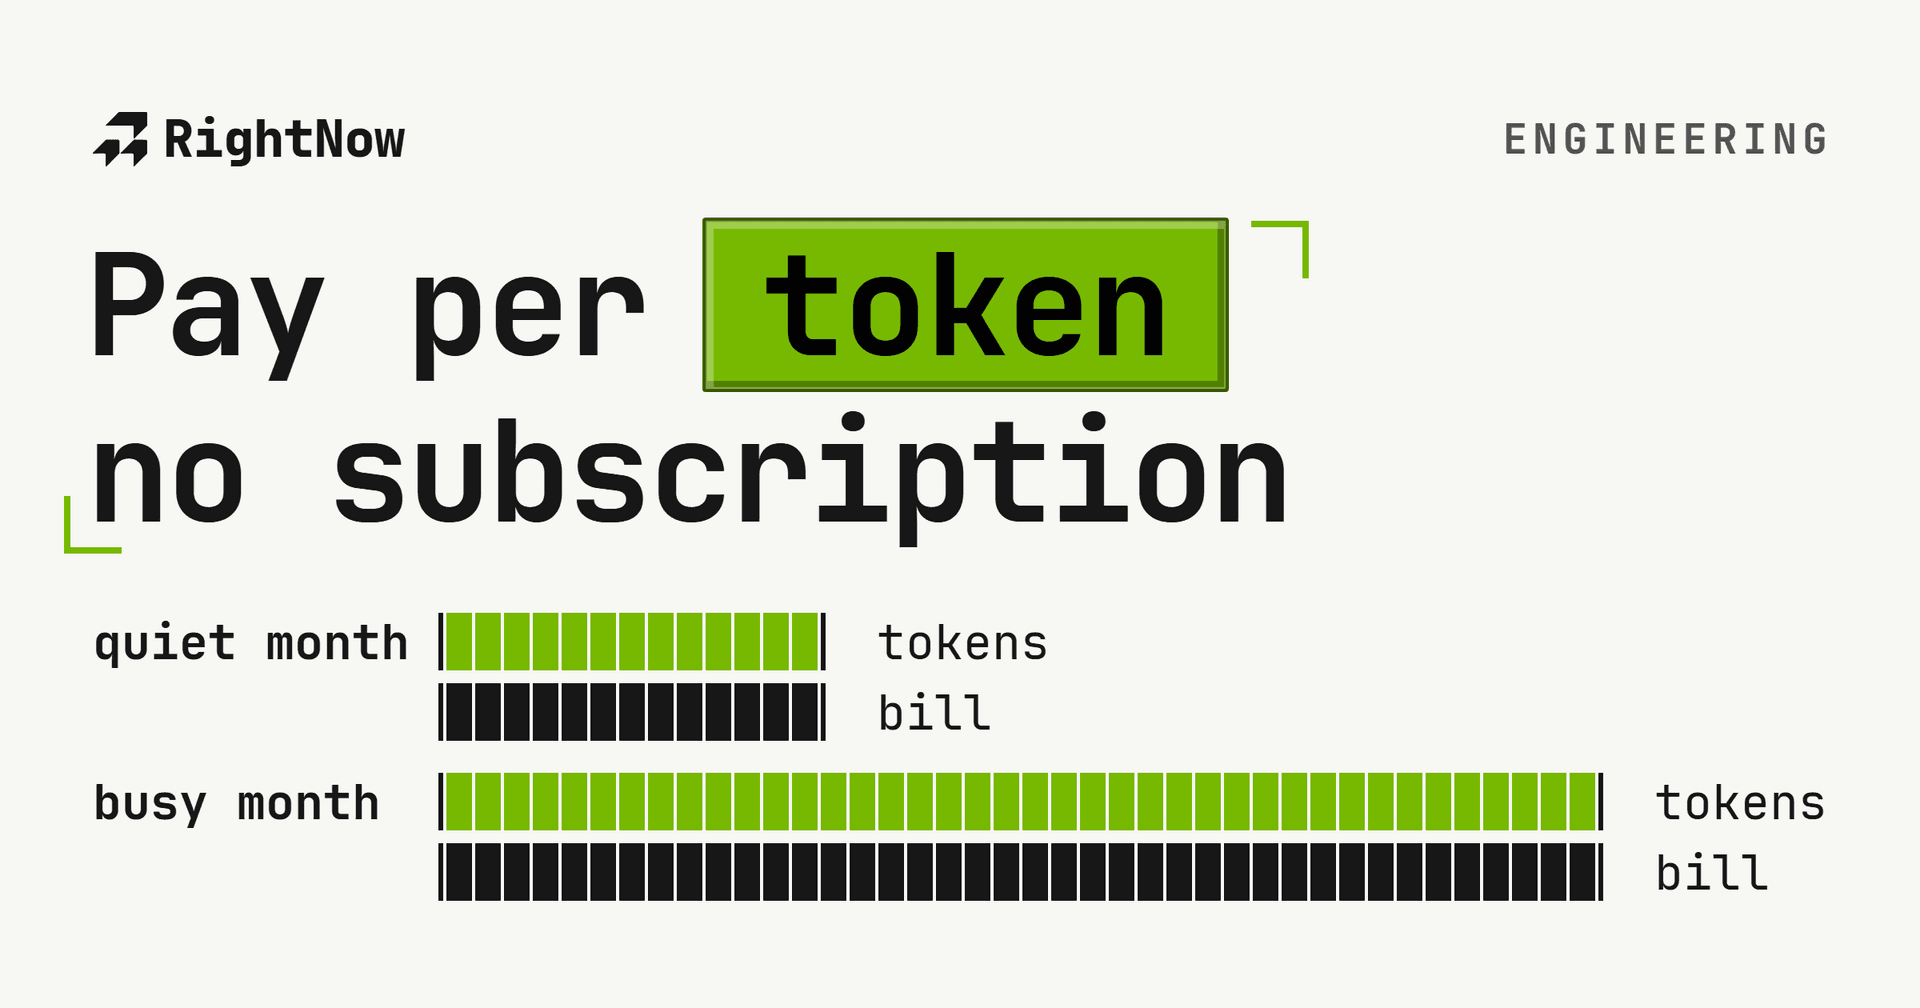
1 つのワークスペースキーで 2 つのプロトコル経由でオープンモデルを呼び出し、1 つの残高からトークン単位で支払います。サブスクリプションは不要です。
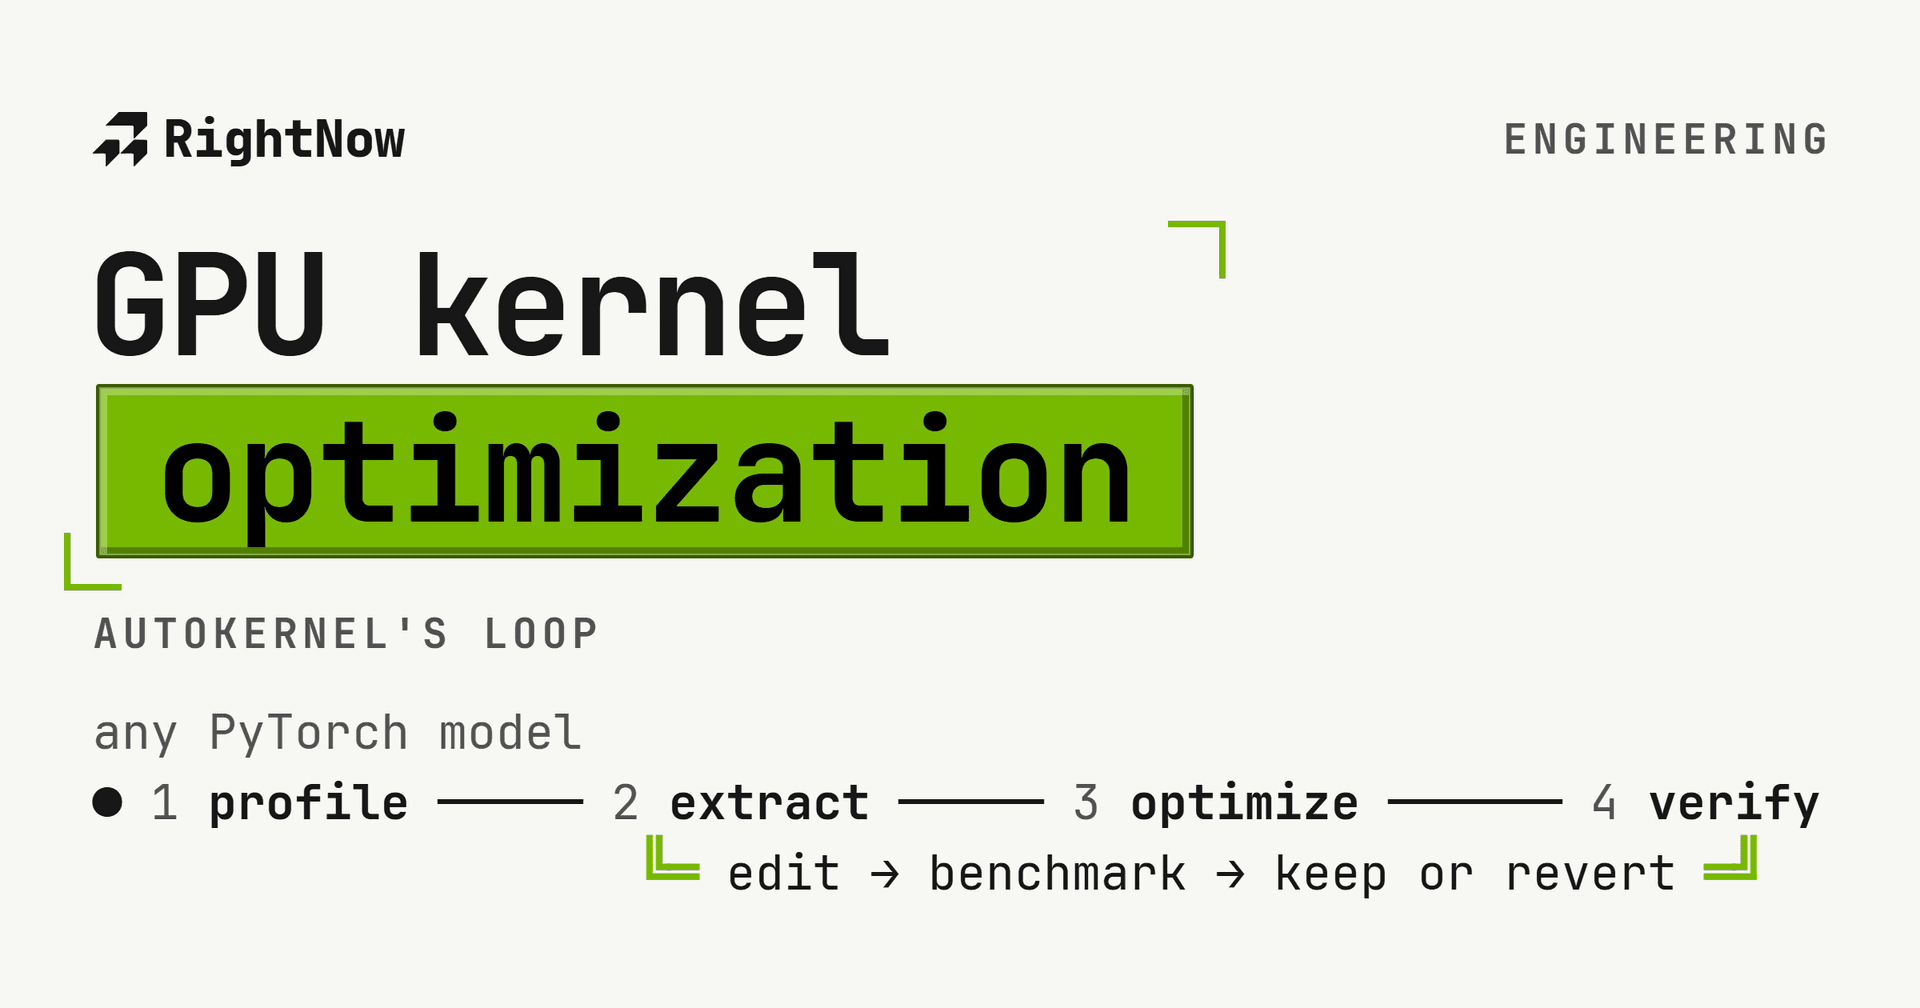
RightNow AI のオープンソース GPU カーネル最適化ツール AutoKernel は、PyTorch モデルをプロファイリングし、Triton のバリアントをテストし、測定されたボトルネックを追跡します。
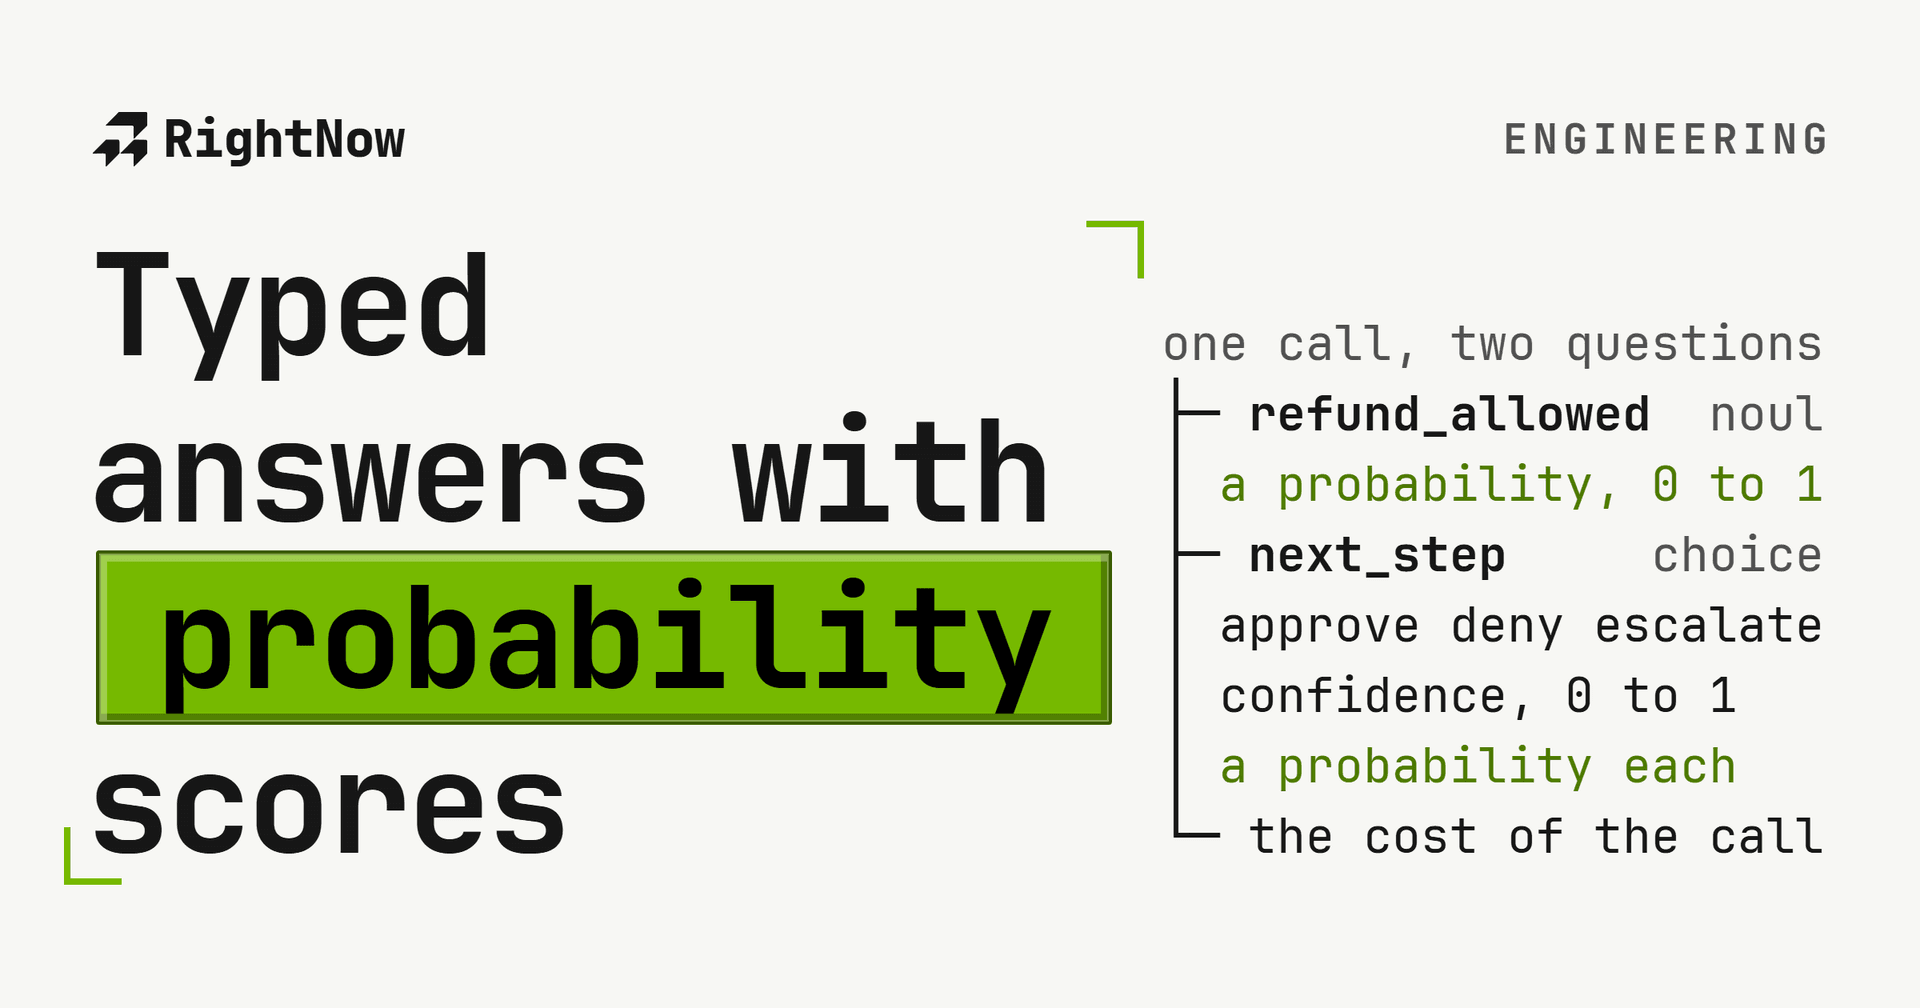
RightNow decision model は構造化された意思決定を行います。状態と名前付きの質問を送り、確率、信頼度、型付きの回答を読み取ります。
RightNow のオープンモデル API は定価でトークン単位の課金で、サブスクリプションもユーザー単位の料金もなく、Batch は定価の半分で動きます。