
CUDA 開発者のための GPU カーネル最適化: AutoKernel
, 3分で読めます, By Jaber Jaber
エンジニアリングAutoKernel は RightNow AI のオープンソースの GPU カーネル最適化ツールです。AutoKernel は PyTorch モデルをプロファイリングし、Triton のバリアントをテストし、測定されたボトルネックを追跡します。コーディングエージェントは一度に 1 つのカーネルを編集し、固定のベンチマークを実行し、各変更を維持するか元に戻します。
AutoKernel は何をしますか?
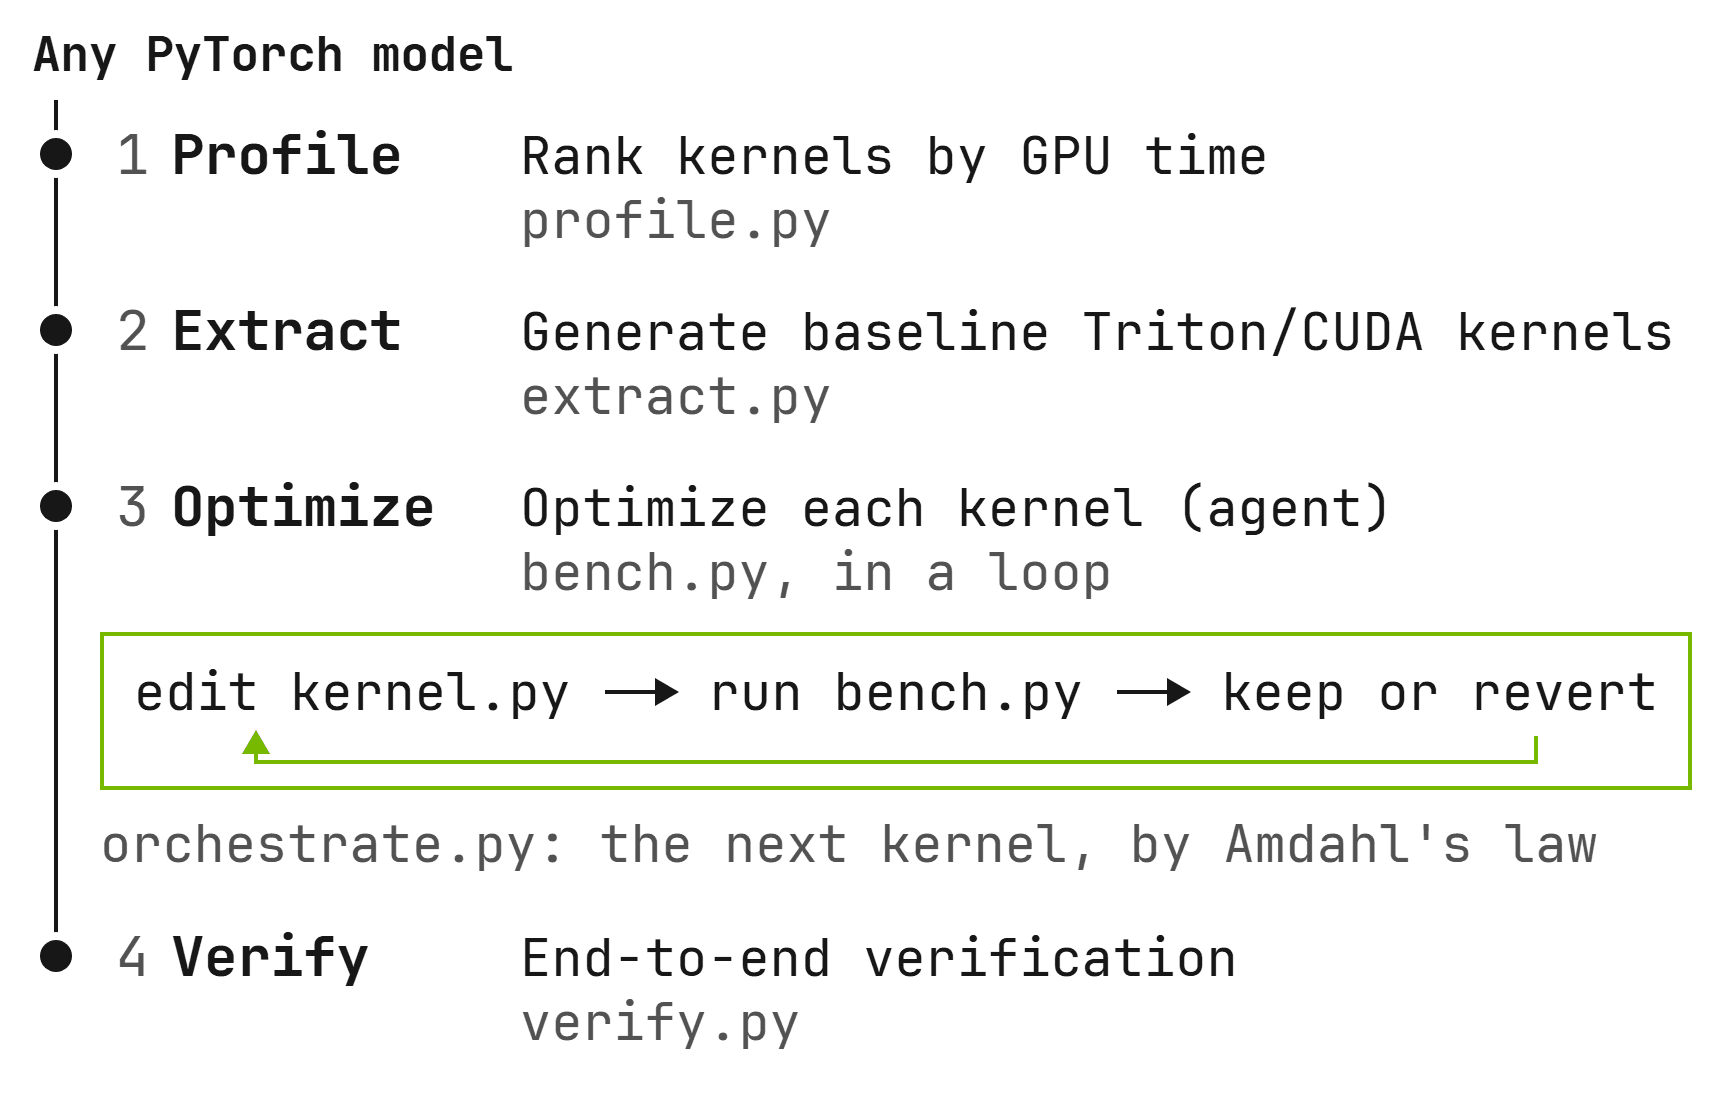
任意の PyTorch モデルを AutoKernel に渡してください。モデルをプロファイリングして、どの GPU カーネルがボトルネックかを見つけます。各ボトルネックをスタンドアロンの Triton または CUDA カーネルとして抽出します。各カーネルを自律的に最適化します: 編集、ベンチマーク、維持または元に戻し、それを繰り返します。end-to-end の正しさを検証し、合計のスピードアップを報告します。
ループはどう動きますか?
エージェントは program.md を読みます。そこには自律動作のための包括的な指示が含まれ、6 段階の最適化プレイブック、意思決定フレームワーク、クラッシュ処理、Amdahl の法則の推論が揃っています。
エージェントは kernel.py を一度に 1 カーネルずつ編集します。5 段階の正しさチェックとルーフライン分析を備えた固定ベンチマーク bench.py を実行し、変更を維持するか元に戻します。
オーケストレータは Amdahl の法則を使って次のカーネルへ移るタイミングを決めます。影響の大きいものを優先し、限界収益が出始めたら次へ進みます。エージェントが触るのは kernel.py だけなので、範囲は管理しやすく、差分はレビューしやすく、リバートはきれいです。
すべての実験はプレーンな results.tsv ファイルに記録されます。各行はカーネル、そのスループット、レイテンシ、合格したかどうか (PASS、FAIL、TIMEOUT、CRASH) を記録します。
カーネルの正しさはどう保たれますか?
ベンチマークは性能を測る前に、カーネル出力を PyTorch と照合します。速くても誤ったカーネルは直ちに元に戻されます。5 つの正しさの段階は、スモーク、形状スイープ、数値安定性、決定論性、エッジケースです。
各カーネル型は reference.py に PyTorch のリファレンスを持ちます。最後に verify.py が最適化されたカーネルをモデルに戻して組み込み、end-to-end の正しさを確認し、合計のスピードアップを報告します。
どう始めますか?
リポジトリをクローンして uv sync を実行します。テストデータとベースラインを整えるため、uv run prepare.py を一度だけ実行します。profile.py でモデルをプロファイリングし、extract.py で上位のボトルネックカーネルを抽出し、bench.py でベンチマークが動くことを確認します。
それからそのディレクトリでコーディングエージェントを起動し、program.md を読んでセットアップから始めるよう伝えます。エージェントは最適化計画を提示し、ブランチを作成し、優先度順に各ボトルネックカーネルを最適化します。program.md は、エージェントが 10 時間以上スタックせずに動けるように書かれています。
CUDA のセットアップが必要ですか?CUDA インストール問題修正の完全ガイドをご覧ください。
背後にある研究はどこにありますか?
RightNow AI は YC 支援の GPU 研究ラボです。論文は AutoKernel: Autonomous GPU Kernel Optimization via Iterative Agent-Driven Search、Jaber Jaber と Osama Jaber、2026 年。arXiv に 2603.21331 としてあり、コードは AutoKernel リポジトリです。
ラボの AutoMegaKernel 論文 A Statically-Checked Agent Harness for Self-Retargeting Megakernel Synthesis は、arXiv に 2606.09682 としてあります。すべての論文とオープンソースプロジェクトは RightNow Research Labをご覧ください。
短い回答
AutoKernel はオープンソースですか?
はい。ライセンスは MIT で、コードは github.com/RightNow-AI/autokernelにあります。
どのモデルをプロファイリングできますか?
任意の PyTorch モデルです。profile.py が torch.profiler でプロファイリングし、カーネルを GPU 時間でランク付けし、各々を計算バウンドかメモリバウンドかに分類します。自己完結したモデル定義が同梱されており、transformers ライブラリは不要です。
どのカーネルに対応していますか?
対応カーネルは matmul、softmax、layernorm、rmsnorm、flash_attention、fused_mlp、cross_entropy、rotary_embedding、reduce です。
Triton と CUDA のどちらを書きますか?
両方です。Triton は高速な反復用で、CUDA はテンソルコアへの直接アクセスを提供します。両バックエンドは同じ kernel_fn() インターフェースを共有します。
どの GPU が必要ですか?
NVIDIA 製 GPU、Python 3.10 以降、そして uv です。