
CUDA 개발자를 위한 GPU 커널 최적화: AutoKernel
, 3분 소요, By Jaber Jaber
엔지니어링AutoKernel은 RightNow AI의 GPU 커널 최적화 오픈소스 도구입니다. AutoKernel은 PyTorch 모델을 프로파일링하고, Triton 변형을 시험하고, 측정된 병목을 따라갑니다. 코딩 에이전트가 한 번에 커널 하나를 편집하고, 고정된 벤치마크를 실행하고, 각 변경을 유지하거나 되돌립니다.
AutoKernel은 무엇을 합니까?
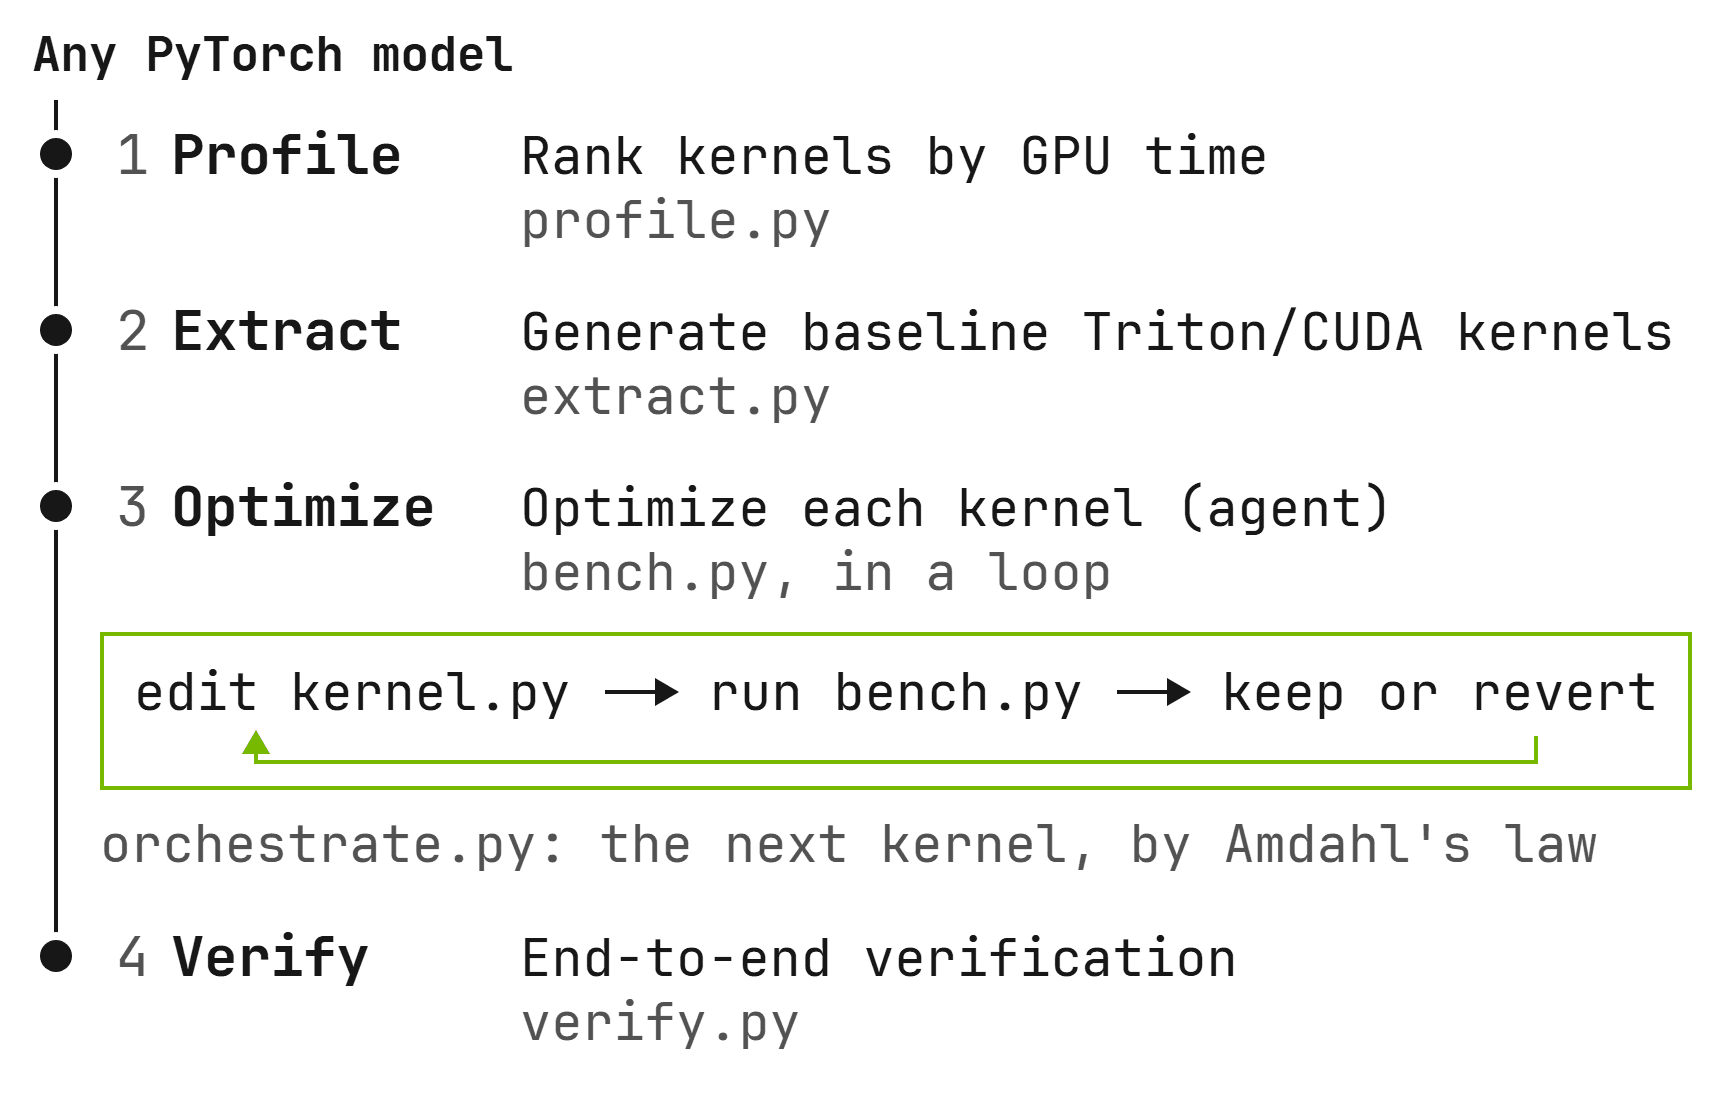
AutoKernel에 아무 PyTorch 모델이나 주세요. 모델을 프로파일링하여 어떤 GPU 커널이 병목인지 찾습니다. 각 병목을 독립적인 Triton 또는 CUDA 커널로 추출합니다. 각 커널을 자율적으로 최적화합니다. 편집, 벤치마크, 유지 또는 되돌리기, 그리고 반복입니다. 엔드투엔드 정확성을 검증하고 총 가속을 보고합니다.
루프는 어떻게 돌아갑니까?
에이전트는 자율 운영에 필요한 포괄적인 지침을 담은 program.md를 읽습니다. 여기에는 6단계 최적화 플레이북, 결정 프레임워크, 크래시 처리, Amdahl의 법칙 추론이 들어 있습니다.
에이전트는 한 번에 커널 하나씩 kernel.py를 편집합니다. 5단계 정확성 검사와 루프라인 분석이 든 고정 벤치마크인 bench.py를 실행하고, 변경을 유지하거나 되돌립니다.
오케스트레이터는 Amdahl의 법칙으로 다음 커널로 넘어갈 시점을 정합니다. 영향도로 우선순위를 매기고, 수익 체감이 시작되면 넘어갑니다. 에이전트는 kernel.py만 다루므로 범위가 관리 가능하고, diff는 검토 가능하며, 되돌리기는 깨끗합니다.
모든 실험은 평범한 results.tsv 파일에 기록됩니다. 각 행은 커널, 처리량, 지연 시간, 통과 여부를 기록합니다. PASS, FAIL, TIMEOUT 또는 CRASH입니다.
커널의 정확성은 어떻게 지켜집니까?
벤치마크는 성능을 측정하기 전에 커널 출력을 PyTorch와 비교합니다. 빠르지만 틀린 커널은 즉시 되돌려집니다. 다섯 정확성 단계는 스모크, 모양 스윕, 수치 안정성, 결정성, 엣지 케이스입니다.
각 커널 타입은 reference.py에 PyTorch 기준을 갖습니다. 마지막에 verify.py가 최적화된 커널을 모델에 다시 끼워 넣고, 엔드투엔드 정확성을 검사하고, 총 가속을 보고합니다.
어떻게 시작합니까?
저장소를 복제하고 uv sync를 실행하세요. 테스트 데이터와 기준선을 준비하려면 uv run prepare.py를 한 번 실행하세요. profile.py로 모델을 프로파일링하고, extract.py로 상위 병목 커널을 추출하고, bench.py로 벤치마크가 작동하는지 확인하세요.
그다음 그 디렉터리에서 코딩 에이전트를 시작하고, program.md를 읽고 설정부터 시작하라고 하세요. 에이전트는 최적화 계획을 보여주고, 브랜치를 만들고, 우선순위 순서로 각 병목 커널을 최적화합니다. program.md는 에이전트가 막힘 없이 10시간 이상 실행되도록 쓰였습니다.
CUDA 설정이 필요합니까? CUDA 설치 문제 해결의 완전한 가이드를 보세요.
그 뒤의 연구는 어디에 있습니까?
RightNow AI는 YC의 지원을 받는 GPU 연구소입니다. 논문은 AutoKernel: Autonomous GPU Kernel Optimization via Iterative Agent-Driven Search, Jaber Jaber와 Osama Jaber, 2026입니다. arXiv에 2603.21331로 실려 있고, 그 코드는 AutoKernel 저장소입니다.
연구소의 AutoMegaKernel 논문, A Statically-Checked Agent Harness for Self-Retargeting Megakernel Synthesis는 arXiv에 2606.09682로 실려 있습니다. 모든 논문과 오픈소스 프로젝트는 RightNow Research Lab에서 보세요.
짧은 답변
AutoKernel은 오픈소스입니까?
예. 라이선스는 MIT이고, 코드는 github.com/RightNow-AI/autokernel에 있습니다.
어떤 모델을 프로파일링할 수 있습니까?
모든 PyTorch 모델입니다. profile.py는 torch.profiler로 프로파일링하고, 커널을 GPU 시간으로 순위 매기고, 각 커널을 컴퓨트 바운드 또는 메모리 바운드로 분류합니다. transformers 라이브러리가 필요 없는 자립적인 모델 정의가 함께 제공됩니다.
어떤 커널을 다룹니까?
지원 커널에는 matmul, softmax, layernorm, rmsnorm, flash_attention, fused_mlp, cross_entropy, rotary_embedding, reduce가 있습니다.
Triton입니까, CUDA입니까?
둘 다입니다. Triton은 빠른 반복에, CUDA는 텐서 코어로의 직접 접근에 쓰입니다. 두 백엔드는 같은 kernel_fn() 인터페이스를 공유합니다.
어떤 GPU가 필요합니까?
NVIDIA GPU, 그리고 Python 3.10 이상과 uv입니다.