
Optimización de kernels de GPU para desarrolladores de CUDA: AutoKernel
, 3 min de lectura, By Jaber Jaber
IngenieríaAutoKernel es la herramienta de código abierto de RightNow AI para optimización de kernels de GPU. AutoKernel perfila modelos de PyTorch, prueba variantes de Triton y sigue los cuellos de botella medidos. Un agente de programación edita un kernel a la vez, ejecuta un benchmark fijo y conserva o revierte cada cambio.
¿Qué hace AutoKernel?
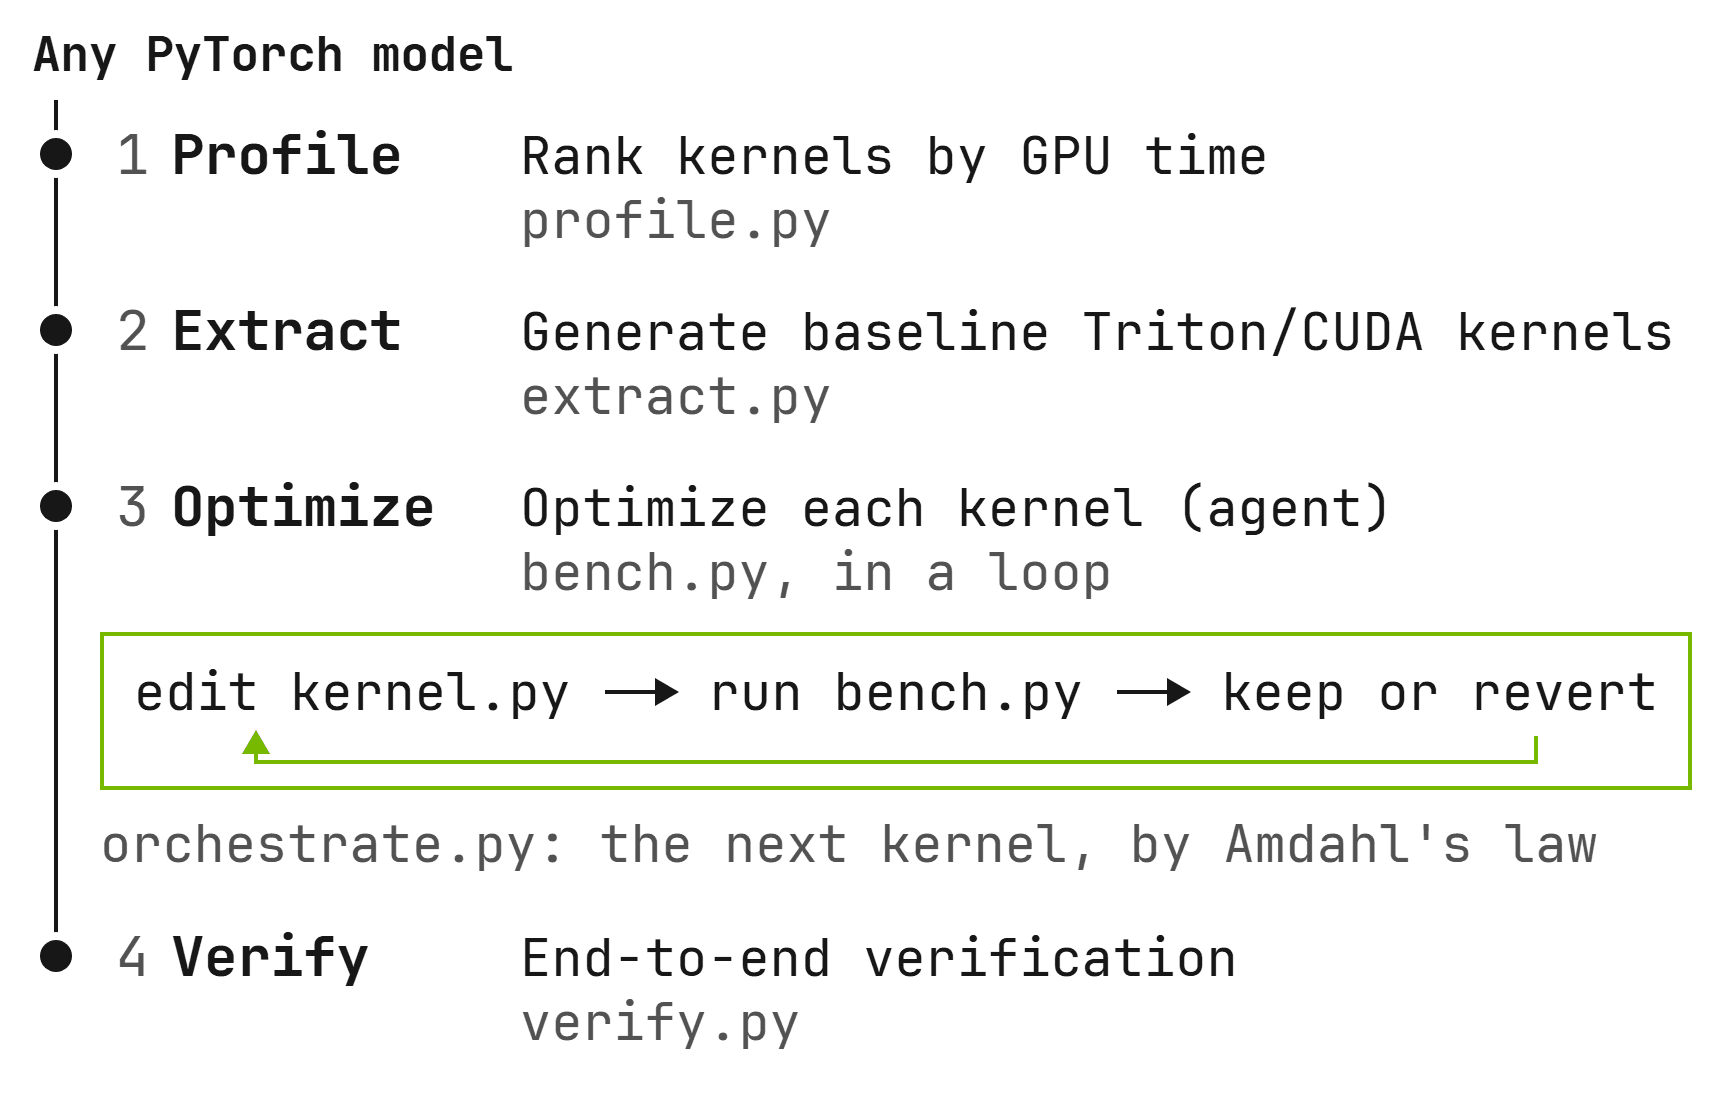
Dale a AutoKernel cualquier modelo de PyTorch. Perfila el modelo para encontrar qué kernels de GPU son cuellos de botella. Extrae cada cuello de botella como un kernel autónomo de Triton o CUDA. Optimiza cada kernel de forma autónoma: editar, medir, conservar o revertir, y repetir. Verifica la corrección de extremo a extremo e informa la aceleración total.
¿Cómo funciona el ciclo?
El agente lee program.md, que contiene instrucciones completas para la operación autónoma. Incluye un manual de optimización de 6 niveles, un marco de decisiones, manejo de fallos y razonamiento con la ley de Amdahl.
El agente edita kernel.py un kernel a la vez. Ejecuta bench.py, un benchmark fijo con verificaciones de corrección de 5 etapas y análisis roofline, y conserva o revierte el cambio.
El orquestador decide cuándo pasar al siguiente kernel usando la ley de Amdahl. Prioriza por impacto y avanza cuando aparecen los rendimientos decrecientes. El agente solo toca kernel.py, así que el alcance se mantiene manejable, los diffs revisables y las reversiones limpias.
Cada experimento se registra en un archivo results.tsv plano. Cada fila anota el kernel, su throughput, su latencia y si pasó: PASS, FAIL, TIMEOUT o CRASH.
¿Cómo mantiene un kernel correcto?
El benchmark compara la salida del kernel contra PyTorch antes de medir el rendimiento. Un kernel rápido pero incorrecto se revierte de inmediato. Las cinco etapas de corrección son humo, barrido de formas, estabilidad numérica, determinismo y casos límite.
Cada tipo de kernel tiene una referencia de PyTorch en reference.py. Al final, verify.py reintegra los kernels optimizados al modelo, verifica la corrección de extremo a extremo e informa la aceleración total.
¿Cómo se empieza?
Clona el repositorio y ejecuta uv sync. Ejecuta uv run prepare.py una vez para preparar los datos de prueba y las líneas base. Perfila un modelo con profile.py, extrae los kernels cuello de botella principales con extract.py, y comprueba que el benchmark funciona con bench.py.
Luego inicia un agente de programación en el directorio y pídele leer program.md y comenzar con la configuración. El agente presenta el plan de optimización, crea una rama y optimiza cada kernel cuello de botella en orden de prioridad. program.md está escrito para que el agente pueda ejecutarse 10 horas o más sin atascarse.
¿Necesitas configurar CUDA? Ver La guía completa para corregir problemas de instalación de CUDA.
¿Dónde está la investigación detrás?
RightNow AI es un laboratorio de investigación de GPU respaldado por YC. El paper es AutoKernel: Autonomous GPU Kernel Optimization via Iterative Agent-Driven Search, de Jaber Jaber y Osama Jaber, 2026. Está en arXiv como 2603.21331, y su código es el repositorio de AutoKernel.
El paper AutoMegaKernel del laboratorio, A Statically-Checked Agent Harness for Self-Retargeting Megakernel Synthesis, está en arXiv como 2606.09682. Ver RightNow Research Lab para todos los papers y proyectos de código abierto.
Respuestas rápidas
¿Es AutoKernel de código abierto?
Sí. Su licencia es MIT, y el código está en github.com/RightNow-AI/autokernel.
¿Qué modelos puede perfilar?
Cualquier modelo de PyTorch: profile.py lo perfila con torch.profiler, ordena los kernels por tiempo de GPU y clasifica cada uno como limitado por cómputo o por memoria. Incluye definiciones de modelos autónomas, sin necesidad de la librería transformers.
¿Qué kernels cubre?
Sus kernels admitidos incluyen matmul, softmax, layernorm, rmsnorm, flash_attention, fused_mlp, cross_entropy, rotary_embedding y reduce.
¿Escribe Triton o CUDA?
Ambos. Triton sirve para iterar rápido, y CUDA da acceso directo a los tensor cores. Ambos backends comparten la misma interfaz kernel_fn().
¿Qué GPU necesita?
Una GPU de NVIDIA, con Python 3.10 o posterior y uv.