
面向 CUDA 开发者的 GPU 内核优化: AutoKernel
, 阅读时间 3 分钟, By Jaber Jaber
工程AutoKernel 是 RightNow AI 的开源 GPU 内核优化工具。AutoKernel 剖析 PyTorch 模型,测试 Triton 变体,并跟踪测得的瓶颈。一个编程代理一次编辑一个内核,运行固定的基准测试,保留或回退每个改动。
AutoKernel 做什么?
把任意 PyTorch 模型交给 AutoKernel。它剖析模型,找出哪些 GPU 内核是瓶颈。它把每个瓶颈提取为独立的 Triton 或 CUDA 内核。它自主优化每个内核:编辑、基准测试、保留或回退,如此反复。它验证端到端正确性,并报告总加速比。
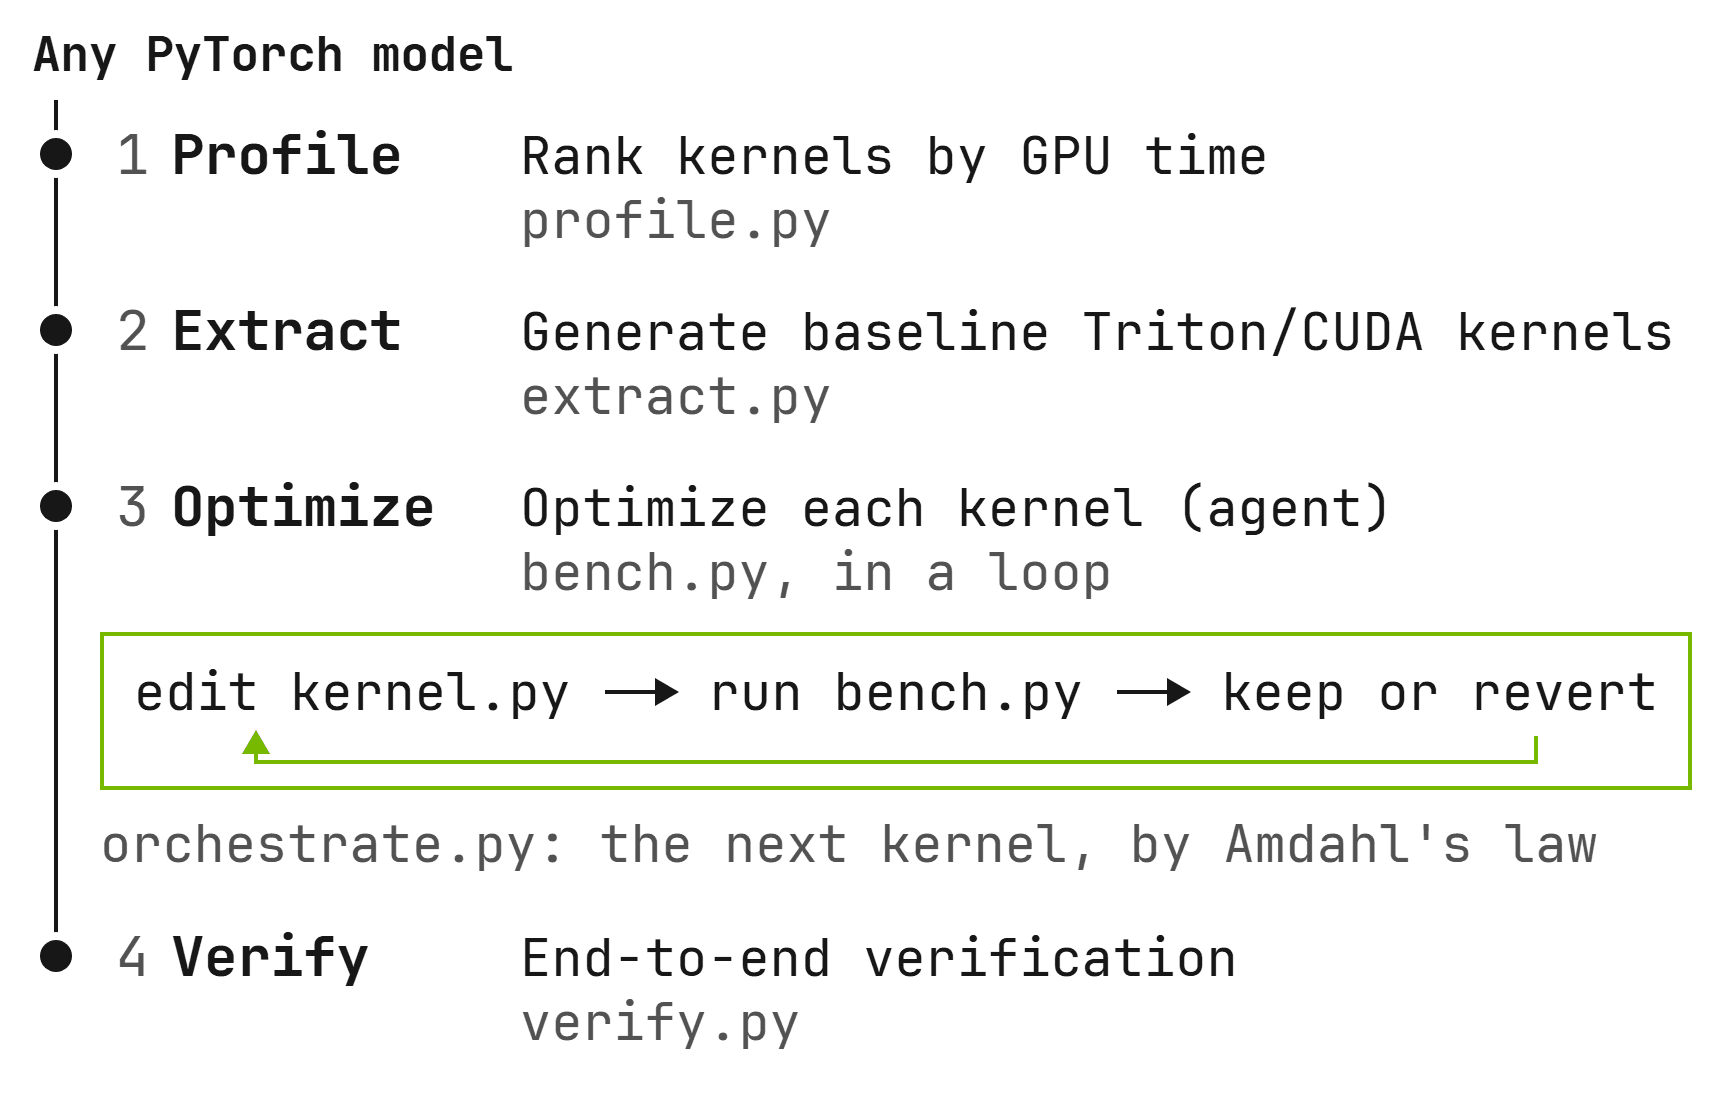
循环如何工作?
代理读取 program.md,其中有自主运行的完整指令。它包含 6 层优化手册、一个决策框架、崩溃处理和 Amdahl 定律推理。
代理一次编辑 kernel.py 里的一个内核。它运行 bench.py,一个带 5 阶段正确性检查和 roofline 分析的固定基准,然后保留或回退改动。
调度器用 Amdahl 定律决定何时移到下一个内核。它按影响排优先级,回报递减时就继续前进。代理只碰 kernel.py,所以范围可控、diff 可审、回退干净。
每个实验都记录到一个普通的 results.tsv 文件。每行记录内核、它的吞吐量、延迟和是否通过:PASS、FAIL、TIMEOUT 或 CRASH。
它如何保证内核正确?
基准在测量性能之前先把内核输出与 PyTorch 对照。快但错误的内核立即回退。五个正确性阶段是冒烟、形状扫描、数值稳定性、确定性和边界情况。
每个内核类型在 reference.py 里有一个 PyTorch 参考。结束时,verify.py 把优化后的内核装回模型,检查端到端正确性并报告总加速比。
怎么开始?
克隆仓库并运行 uv sync。运行一次 uv run prepare.py 以建立测试数据和基线。用 profile.py 剖析模型,用 extract.py 提取最优先的瓶颈内核,用 bench.py 确认基准可用。
然后在该目录里启动一个编程代理,让它读 program.md 并从设置开始。代理给出优化计划,创建分支,按优先级顺序优化每个瓶颈内核。program.md 的写法让代理能连续运行 10 小时以上而不卡住。
需要配置 CUDA?见 The Complete Guide to Fixing CUDA Installation Issues。
背后的研究在哪里?
RightNow AI 是一家获 YC 支持的 GPU 研究实验室。论文是 AutoKernel: Autonomous GPU Kernel Optimization via Iterative Agent-Driven Search,作者 Jaber Jaber 与 Osama Jaber,2026 年。它在 arXiv 上编号 2603.21331,其代码是 AutoKernel repository。
实验室的 AutoMegaKernel 论文,A Statically-Checked Agent Harness for Self-Retargeting Megakernel Synthesis,在 arXiv 上编号 2606.09682。每篇论文和开源项目见 RightNow Research Lab。
简短回答
AutoKernel 是开源的吗?
是。它的许可证是 MIT,代码在 github.com/RightNow-AI/autokernel。
它能剖析哪些模型?
任意 PyTorch 模型:profile.py 用 torch.profiler 剖析它,按 GPU 时间给内核排序,并把每个归类为计算受限或内存受限。它自带自足的模型定义,不需要 transformers 库。
它覆盖哪些内核?
它支持的内核包括 matmul、softmax、layernorm、rmsnorm、flash_attention、fused_mlp、cross_entropy、rotary_embedding 和 reduce。
它写 Triton 还是 CUDA?
两者都写。Triton 用于快速迭代,CUDA 直接访问张量核心。两个后端共用同一个 kernel_fn() 接口。
它需要哪种 GPU?
一块 NVIDIA GPU,加 Python 3.10 或更高版本和 uv。