GPU 内核、CUDA 与缩放。来自实验室的产品说明。
在 NVIDIA B300 上为 Thinking Machines 的 Inkling 模型开源的内核:原生 NVFP4,每步 1 行或 64 行时 logits 相同。
作者: Jaber Jaber
RightNow 是我们的第一个决策模型。
作者: RightNow AI
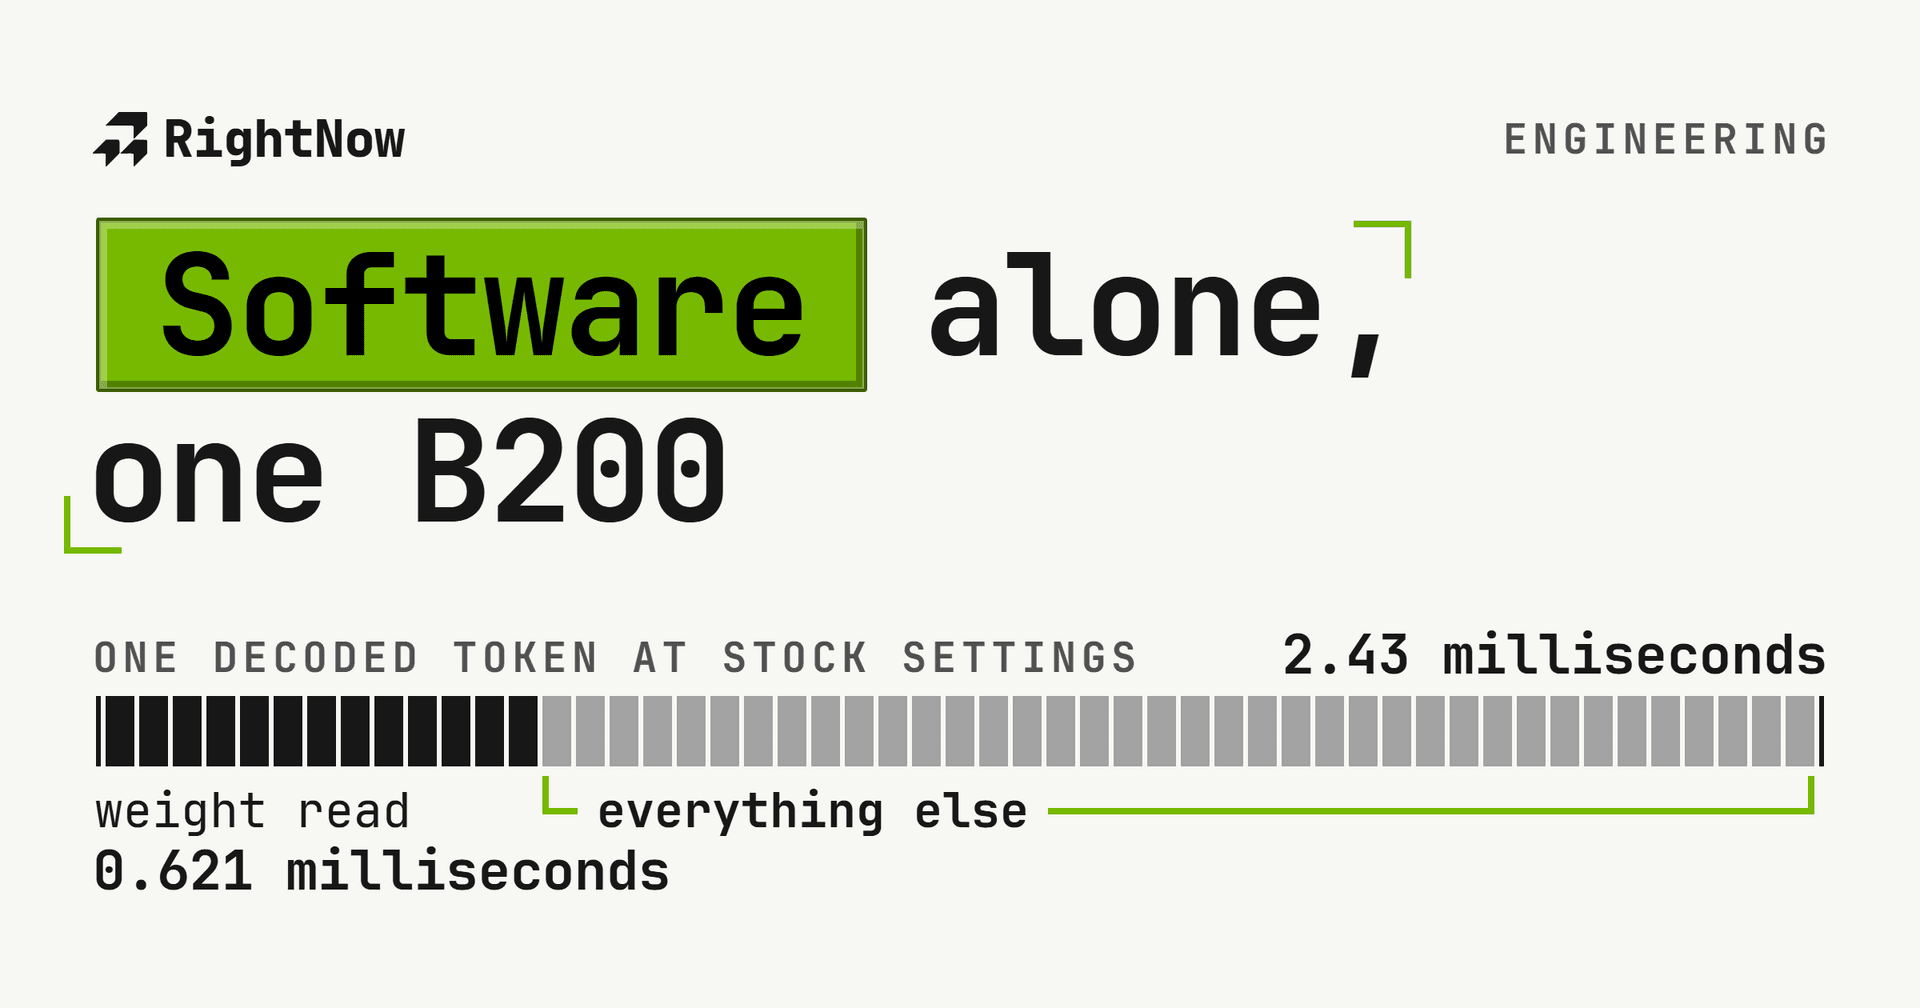
原版 SGLang 在一张租来的 B200 上以每秒 411 个 token 的速度服务 gpt-oss-120b。四项设置让同一张卡和同一份权重达到 1,366,单条提示达到 2,215。没有编写内核,没有重新编译。
如何在不改动模型的情况下加速 LLM 服务。精确内核、投机解码、无损压缩、KV 复用与调度,连同其中的数学原理以及如何用 logit 奇偶校验来验证。
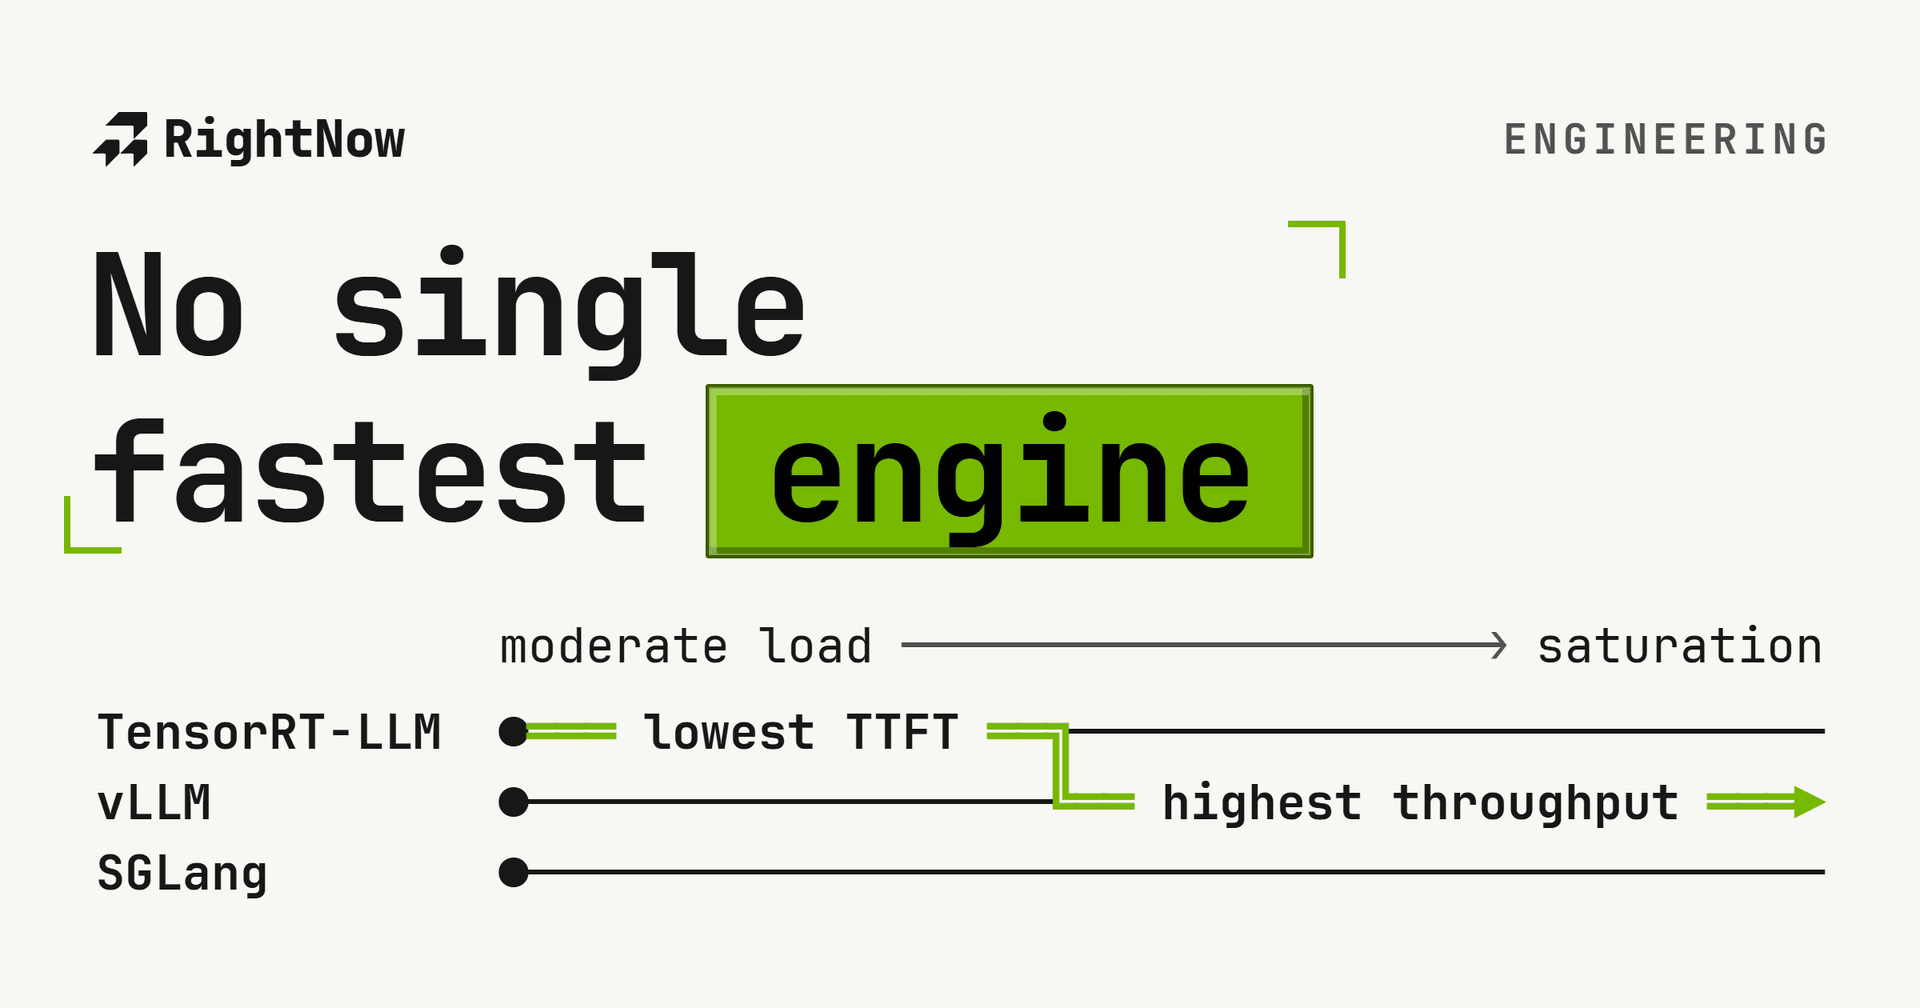
三个 LLM 推理引擎的 Llama-3.1-8B 自报结果。已发布的唯一提示吞吐量与延迟数据行覆盖 H100 bf16。FP8 与 L40S 仅出现在推导出的成本结果中。测试框架与原始数据未公开。
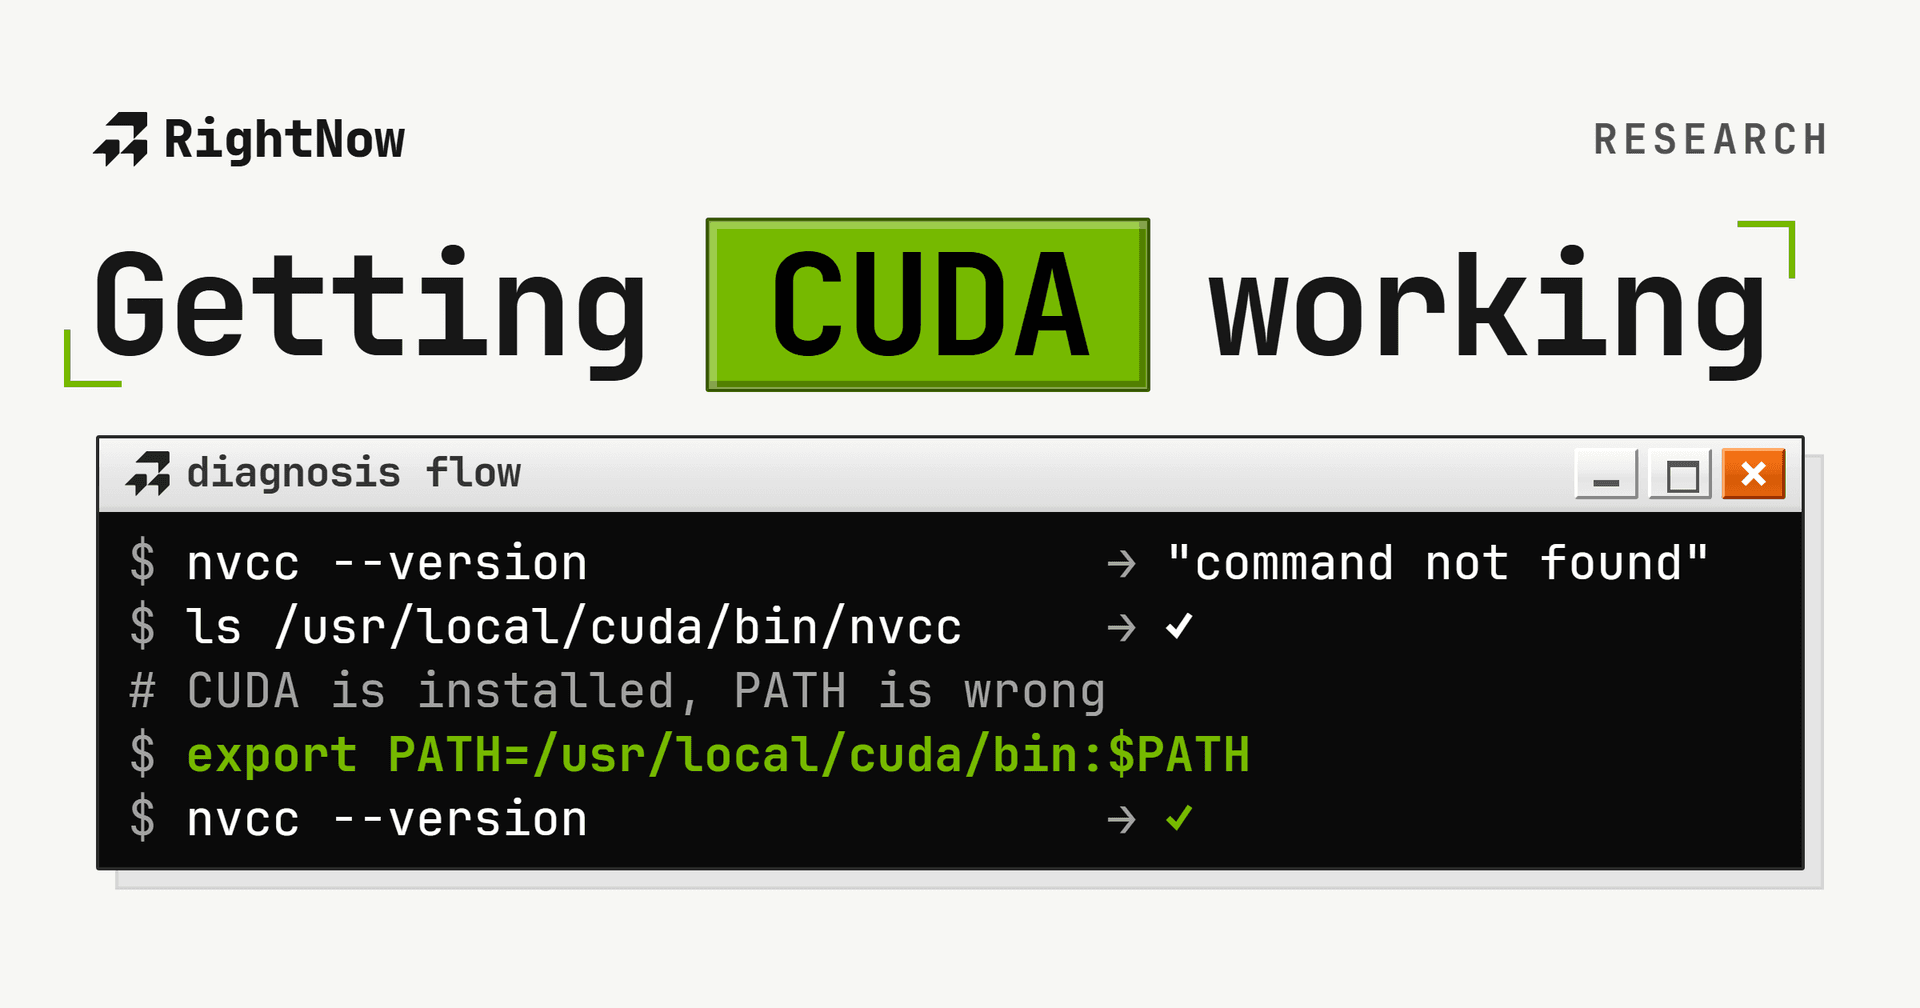
让 CUDA 跑起来不该花上好几天。在分析了数百次安装失败之后,我整理了 PATH 报错、驱动不匹配、WSL2 问题等所需的全部修复方法。别再和 nvcc 较劲,开始写代码吧。
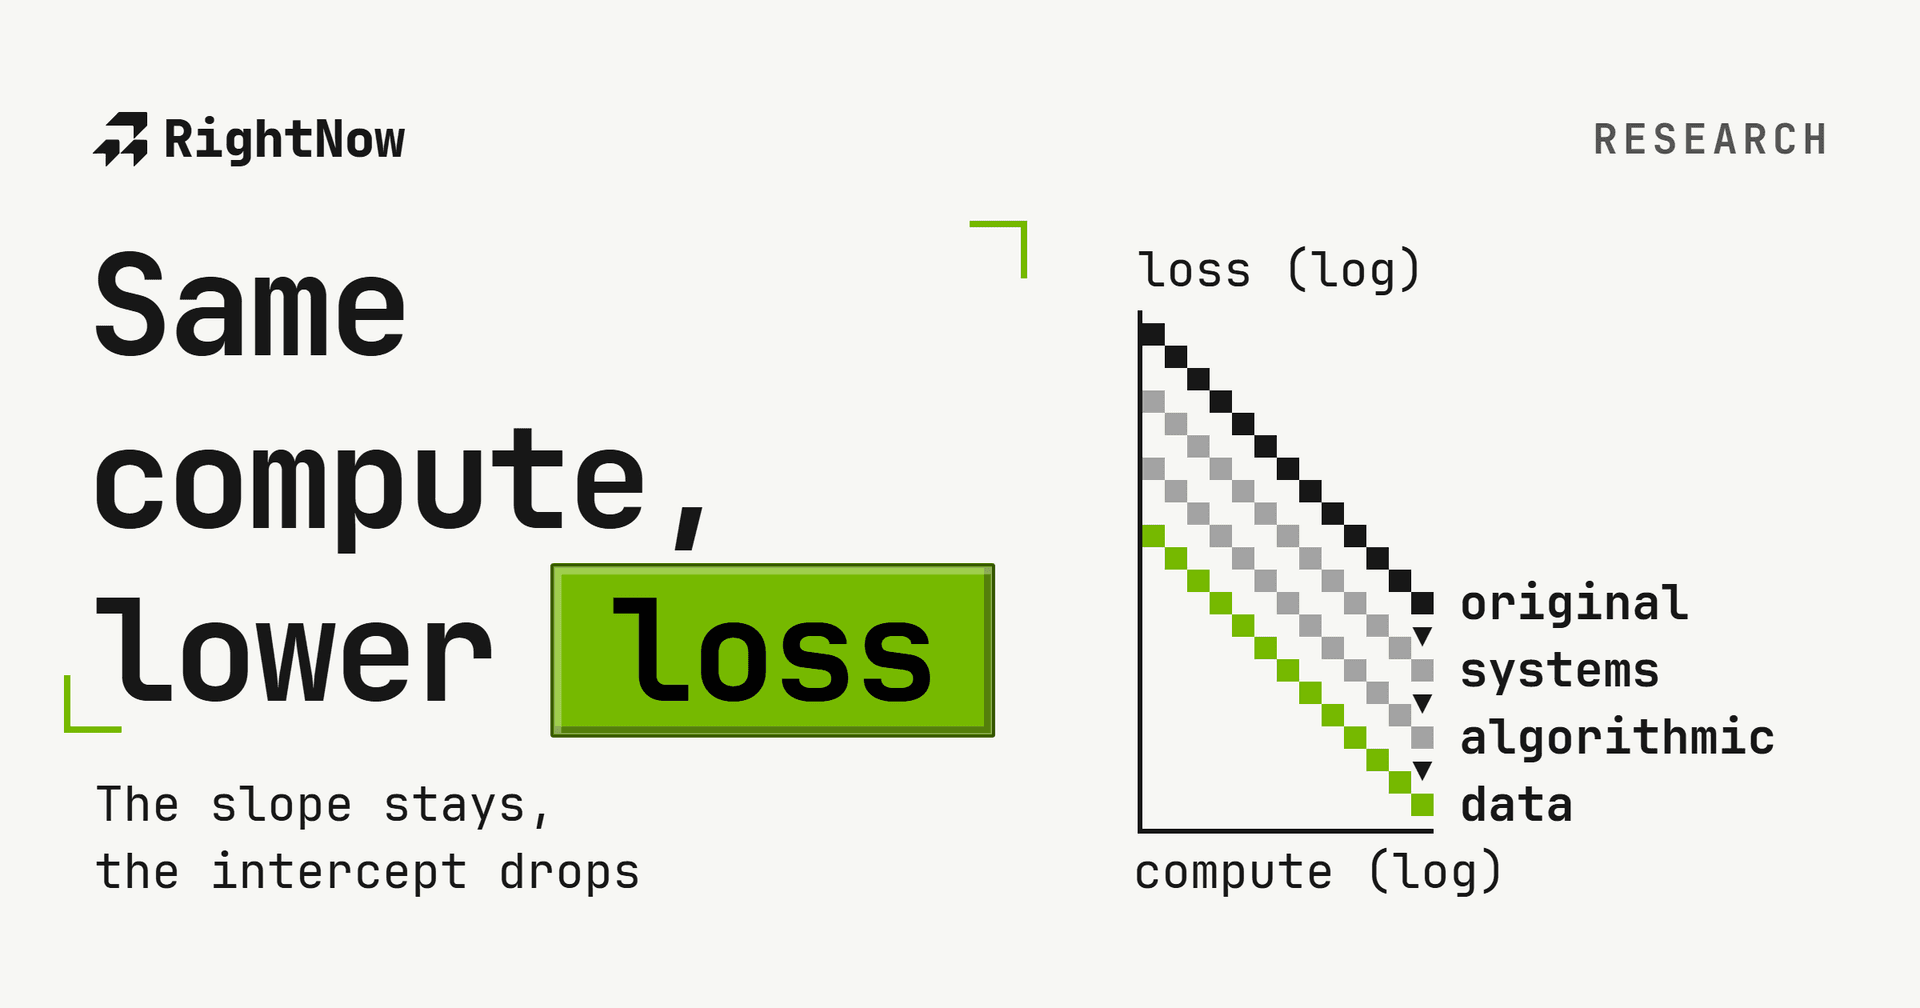
当研究者把模型的交叉熵损失与计算量在 log-log 坐标上作图时,结果接近一条直线: 随着计算量、模型规模或训练 token 的增加,损失可预测地下降。这一经验规律(缩放定律)让团队能够预测回报,但也揭示了极限: 购买更多 GPU 只会带来递减的边际回报。
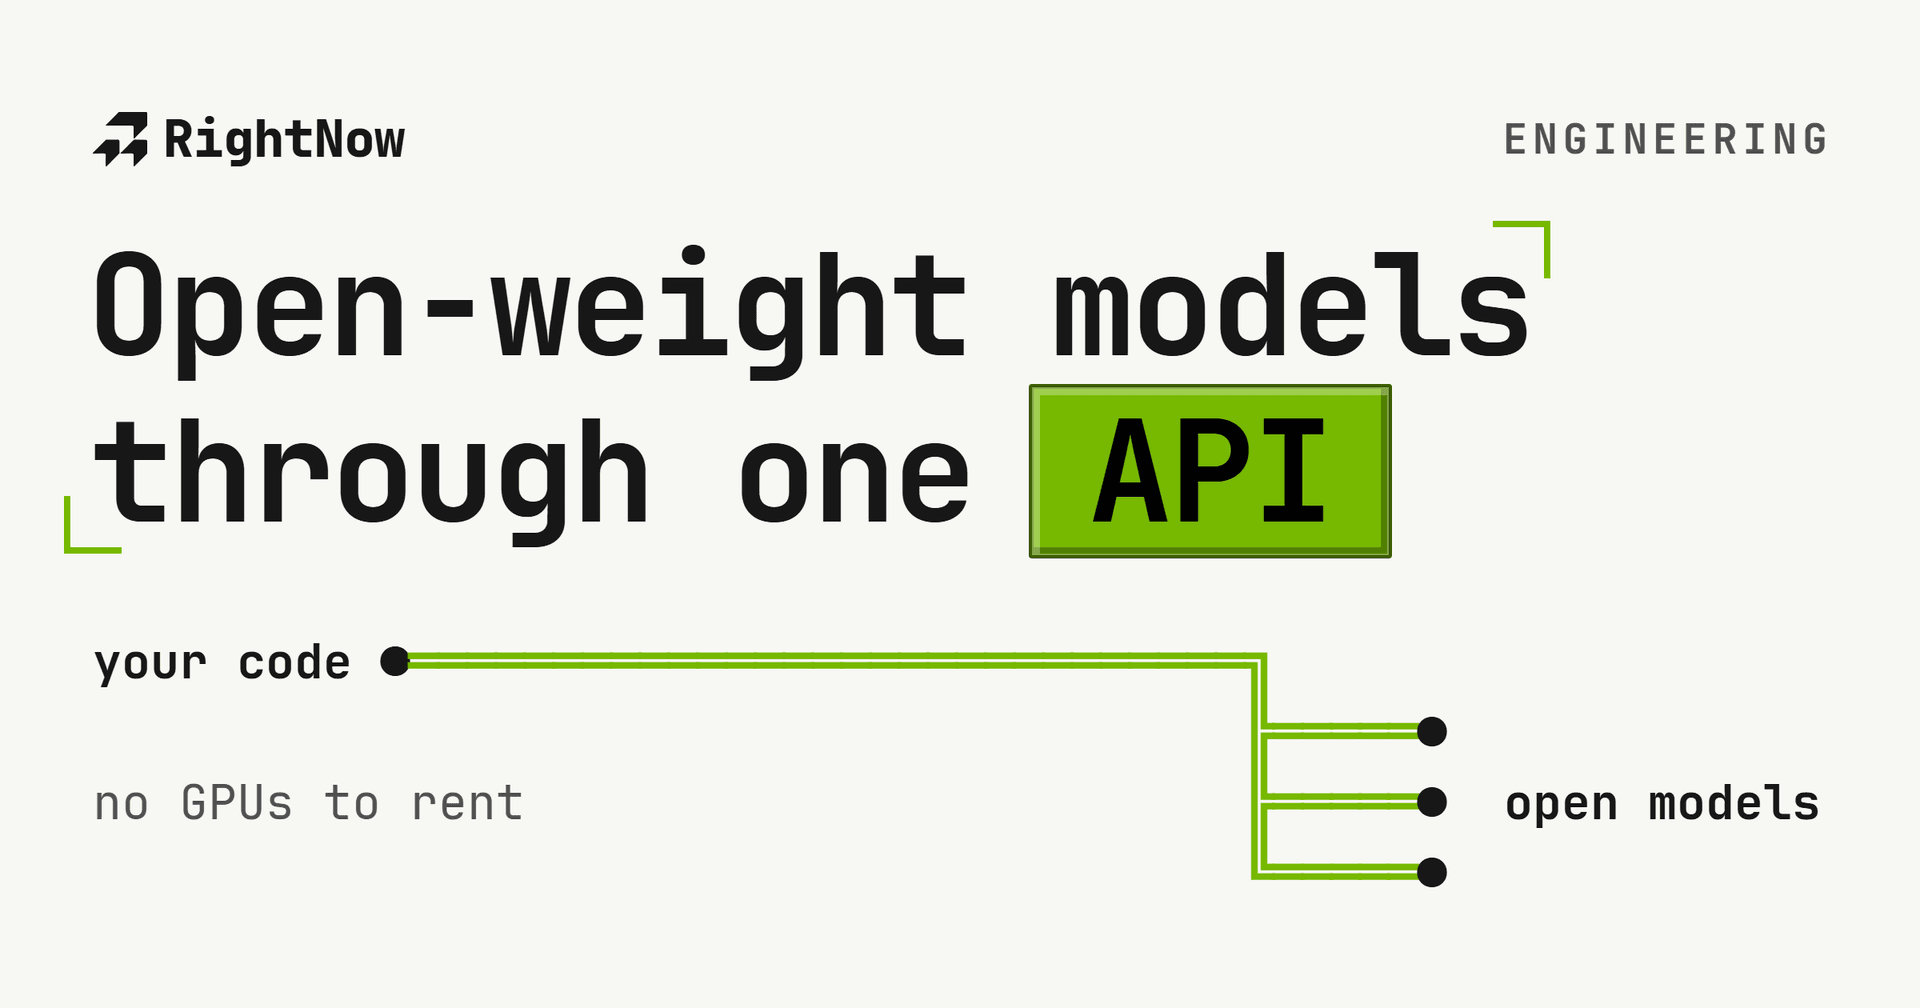
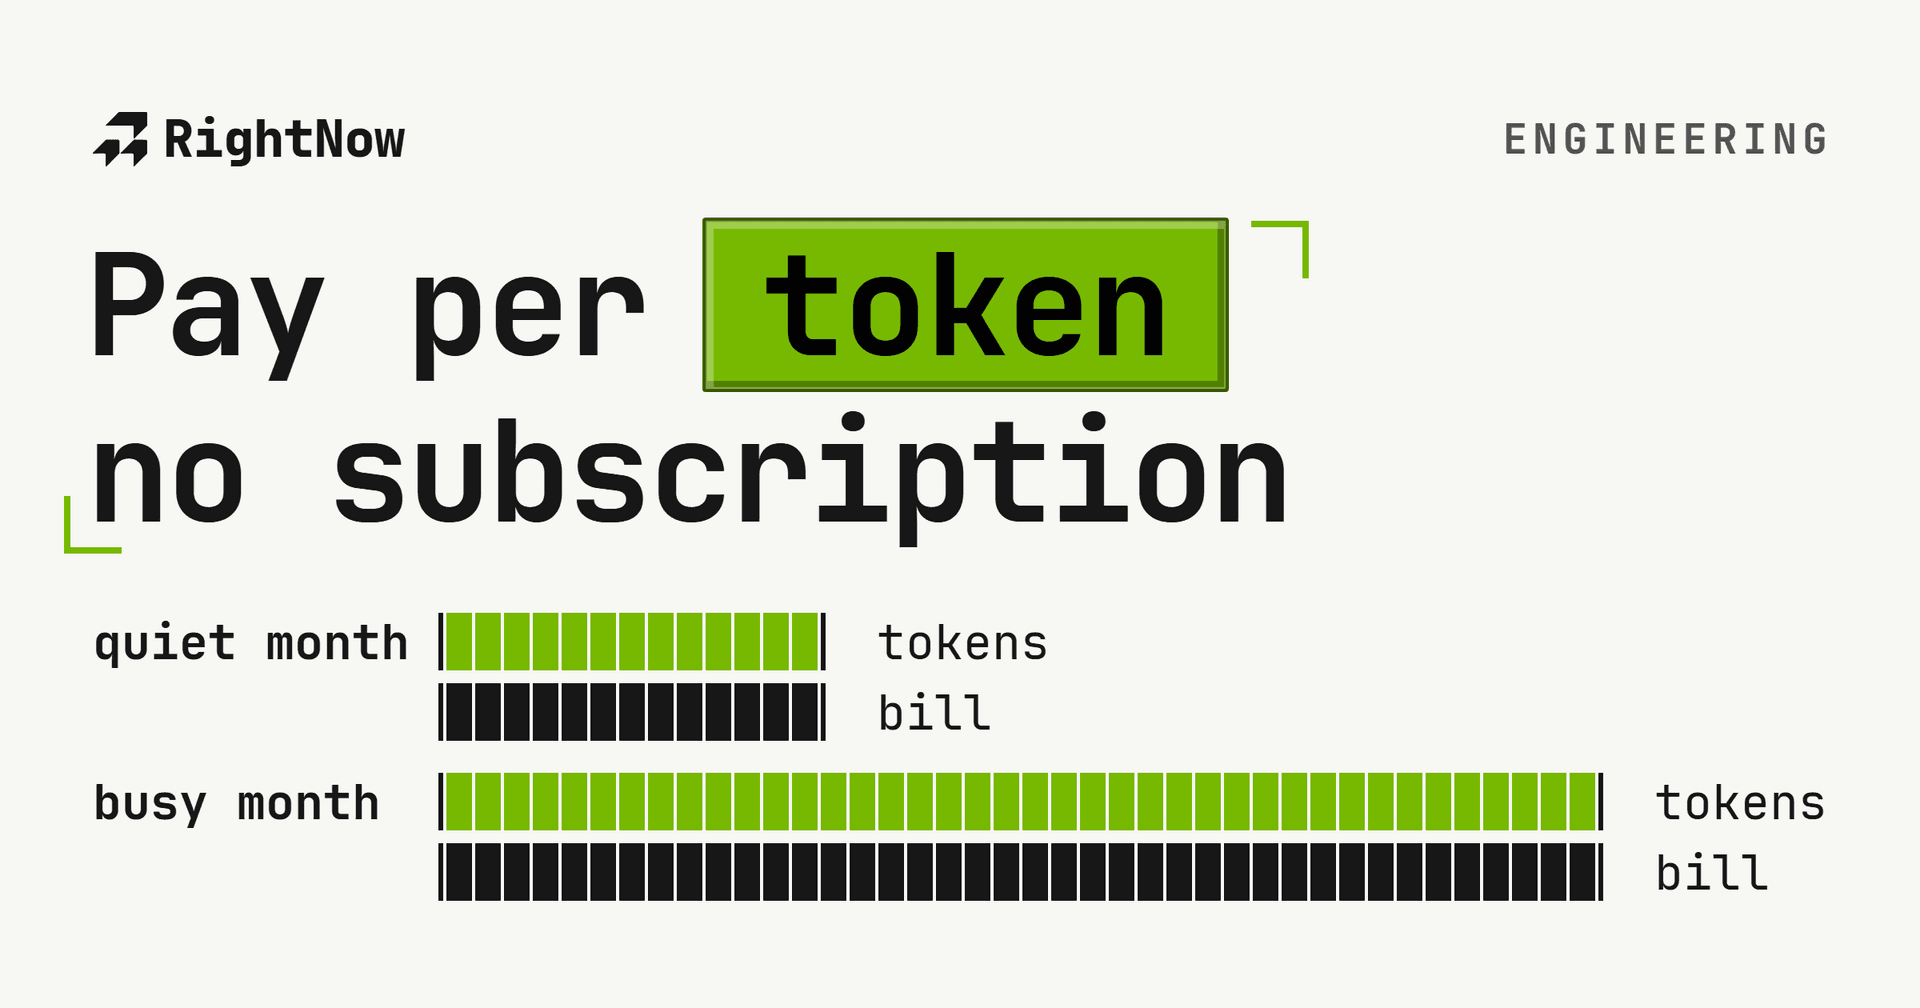
用一个工作区密钥通过两种协议调用开放模型,从一个余额按 token 付费,无需订阅。
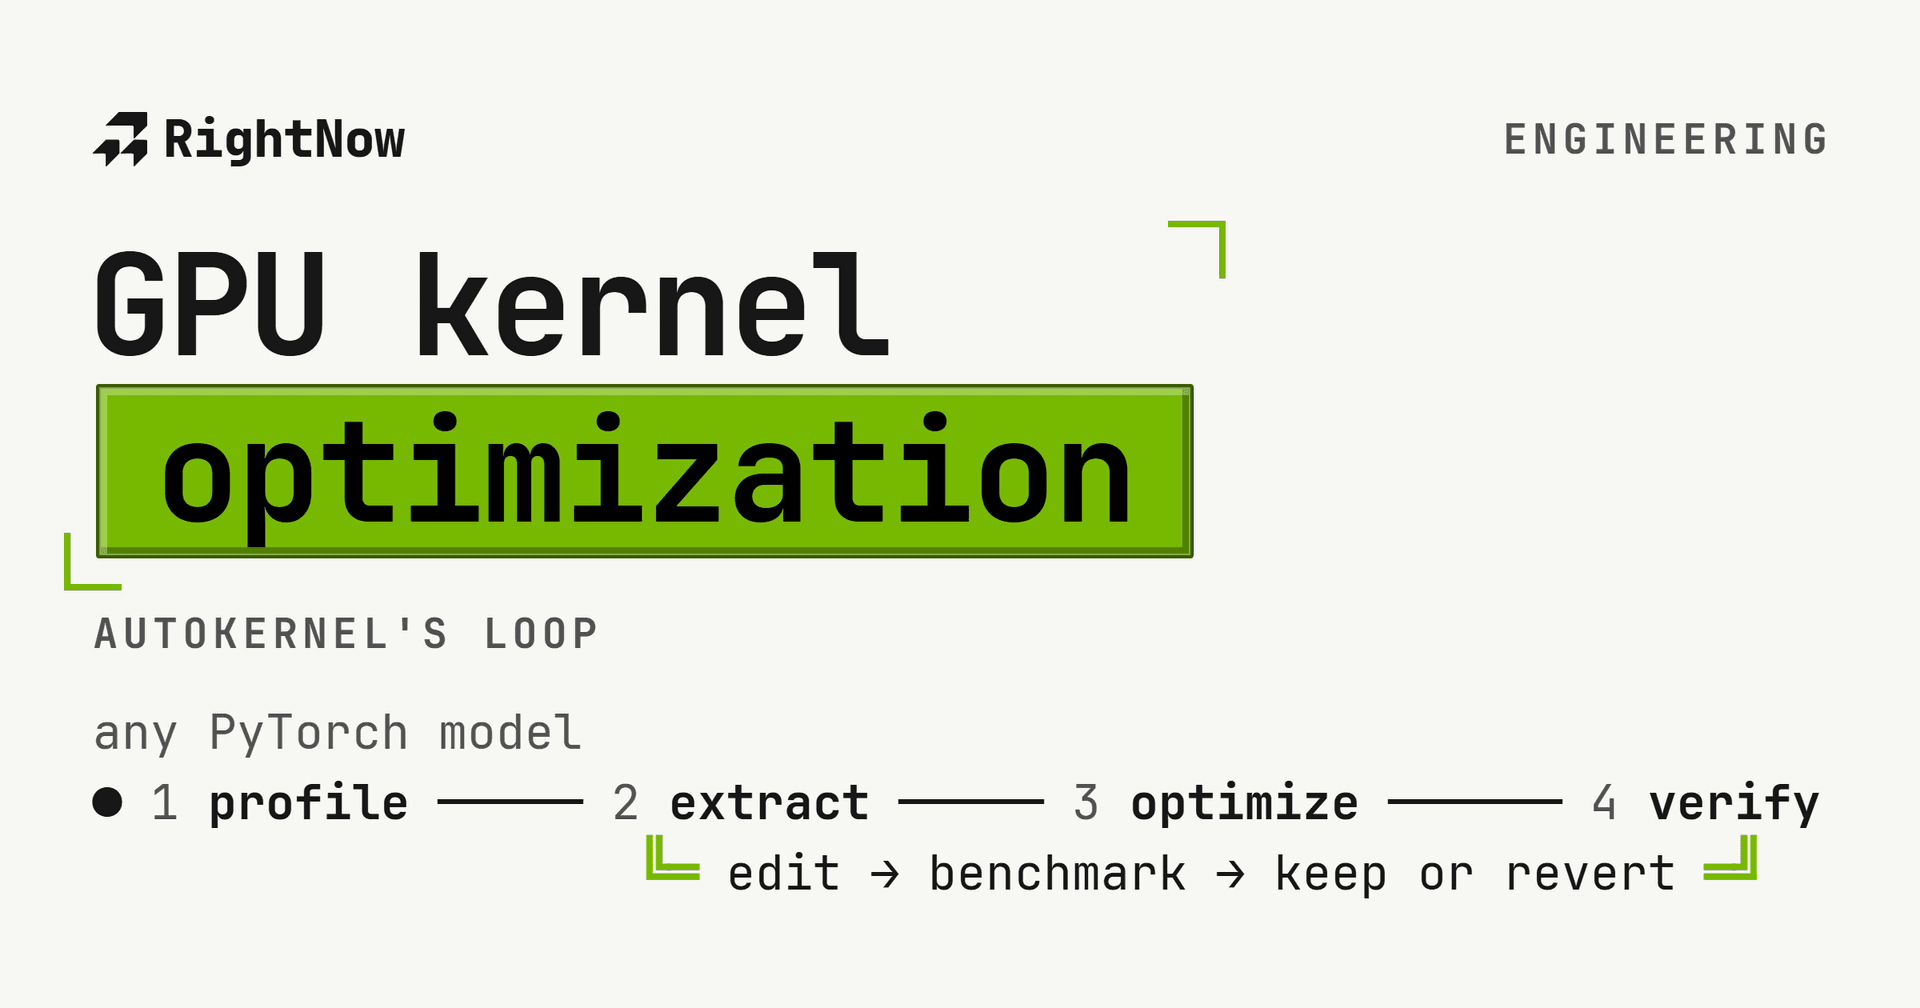
RightNow AI 的开源 GPU 内核优化工具 AutoKernel 为 PyTorch 模型做性能分析,测试 Triton 变体,并跟踪测得的瓶颈。
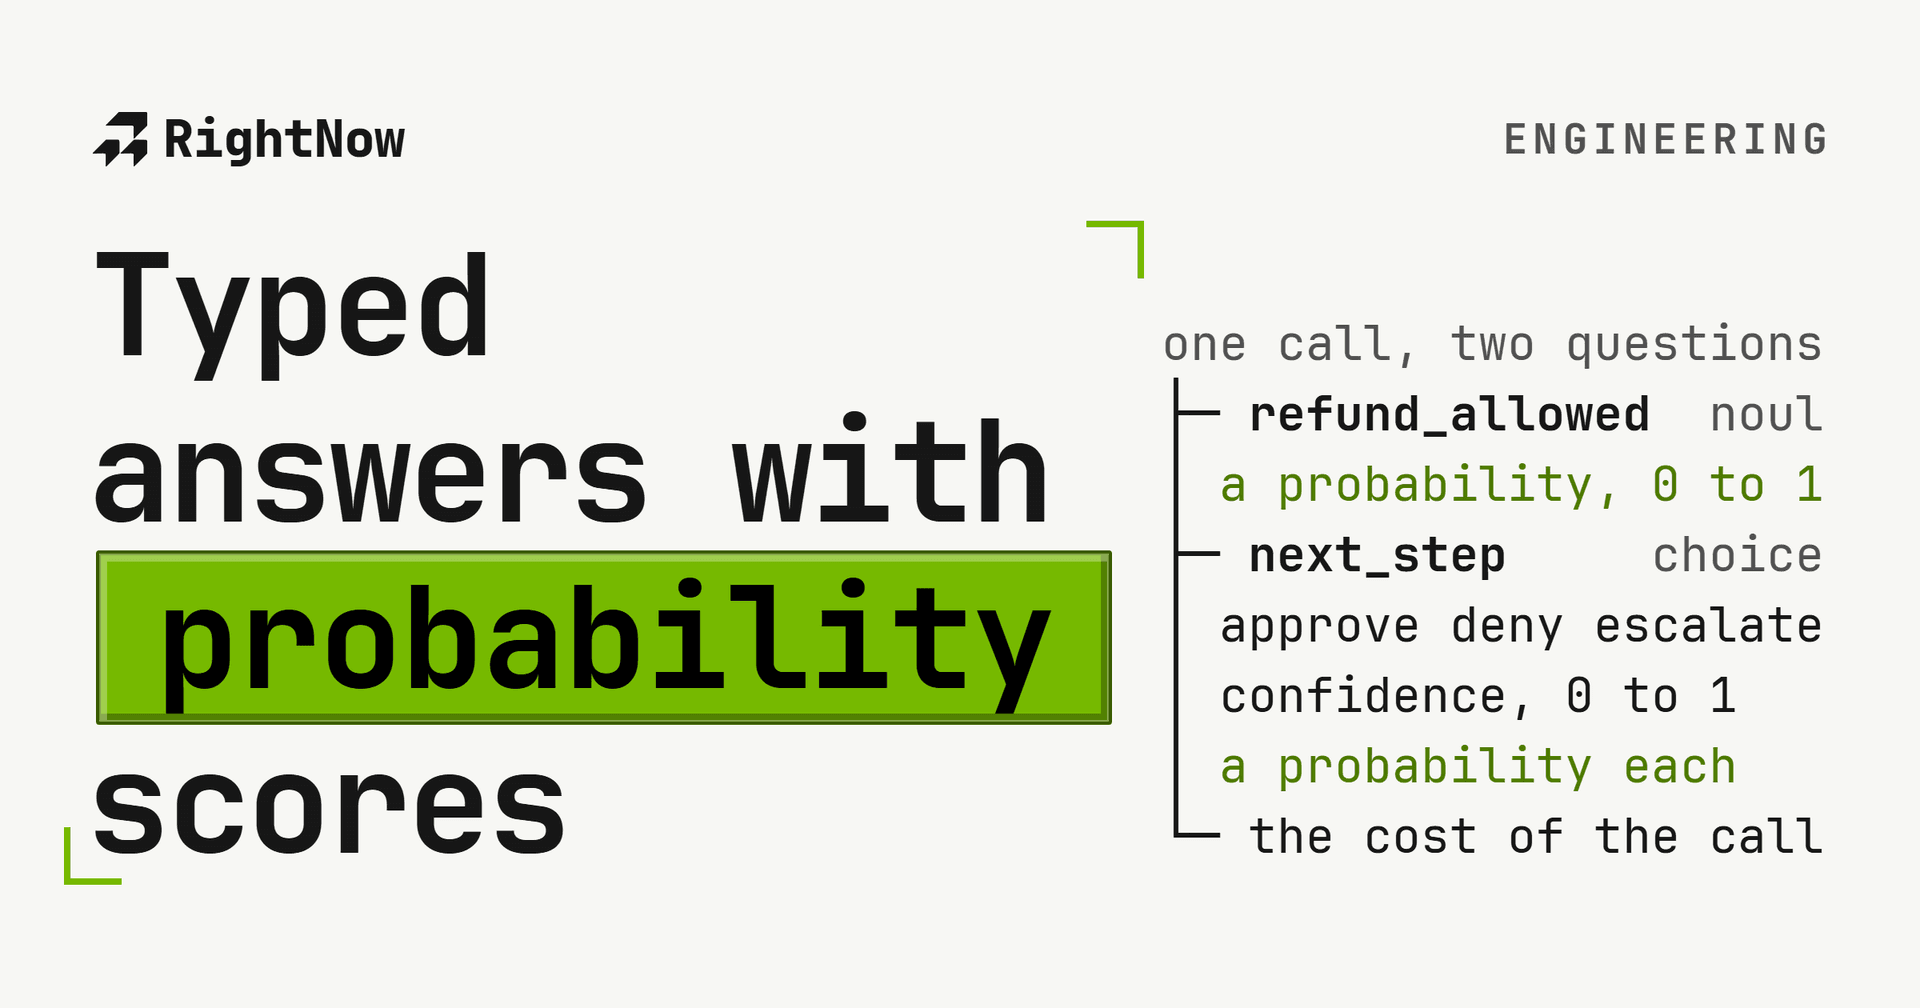
RightNow decision model 做出结构化决策: 发送状态与命名的问题,然后读取概率、置信度和带类型的答案。
RightNow 的开放模型 API 按目录价以 token 计费,没有订阅,也没有按席位收费,Batch 以目录价的一半运行。