
在 NVIDIA B300 上优化 Inkling 2 Small 的内核
, 阅读时间 11 分钟, By Jaber Jaber
研究RightNow AI 是一家获 YC 支持的 GPU 研究实验室。我们在 8 张 NVIDIA B300 GPU 上优化了 Inkling 2 Small(Thinking Machines 的 594B 参数混合专家模型)的内核。每个内核、测试、配置和结果都在 github.com/RightNow-AI/inkling-b300-kernels 开源。
Thinking Machines 以 NVFP4 对这个模型做了预训练、中期训练和后训练,他们的模型卡称其为“the native precision for the model”。我们按训练时的数值运行它:第 0 到 39 层的 NVFP4 专家跑在 Blackwell 的块缩放 FP4 张量核心上,第 40 到 47 层的 MXFP8 专家跑在它的块缩放 FP8 张量核心上。
| 在 B300 GPU 上实测,2026-11-21 | 结果 |
|---|---|
| 相同的 logits,每步 64 行对每步 1 行,8 张 GPU 上的完整模型 | 逐位对比,599 行中 0 行不同 |
| 与 vLLM 的下一 token 对数概率之差,同一模型和 GPU | 均值 0.025 nats,p95 处 0.13 |
| w13 专家 GEMM,单 GPU,单 token,重建版对比我们的第一个内核 | NVFP4 上快 5.1 倍,MXFP8 上快 7.5 倍,逐位相同 |
| 单张 B300 上的内核测试套件,模拟 8 个 rank | 10/10 通过 |
这里的每个内核都由我们的 AI 内核引擎写成:编程代理写 CUDA,运行我们的测试框架,并保留或回退每个改动。一个内核只有通过它的各项检查后才被保留。
为什么这需要 CUDA
NVFP4 存储 4 位 E2M1 数值,每 16 个一组的块配一个 E4M3 缩放。Blackwell 的张量核心直接读取这些缩放:一条 tcgen05.mma 指令,kind::mxf4nvf4.block_scale.block16,乘的就是模型自己的字节。
AMD 的 MI350X 和 MI355X 做不到。用 AMD 自己的话说,他们的 FP4 计算支持仅限 MXFP4,其块宽为 32、缩放为 2 的幂,所以 NVFP4 检查点必须先转换成 MXFP4 才能使用那条路径。在 Blackwell 上,模型就跑在它训练时的精度里。
1 行或 64 行,逐位相同
大多数推理引擎只是接近,并不精确。一个 token 的结果取决于同一步里还有什么,因为批会改变求和的拆分方式,而浮点加法不满足结合律。
Thinking Machines 把这个修复命名为批不变:一行的结果完全不依赖批。我们让它在 NVFP4 和 MXFP8 块缩放张量核心、拆分到 8 张 GPU 的专家以及它们之间的每一次交换中都成立。
每一个归约都有固定的形状。 求和以固定分块和平衡树运行,跨 GPU 的求和按 rank 顺序以 FP32 折叠,构建时关闭自动收缩,所以每一个融合乘加都是我们有意写下的。
每一个性质都有一个被破坏的孪生。 每个位一致性质都配有一个故意破坏的变体,它必须被抓到。当某个破坏动不了位时,比如重排本来精确的求和,日志会写明这一点,而不是把它计入。
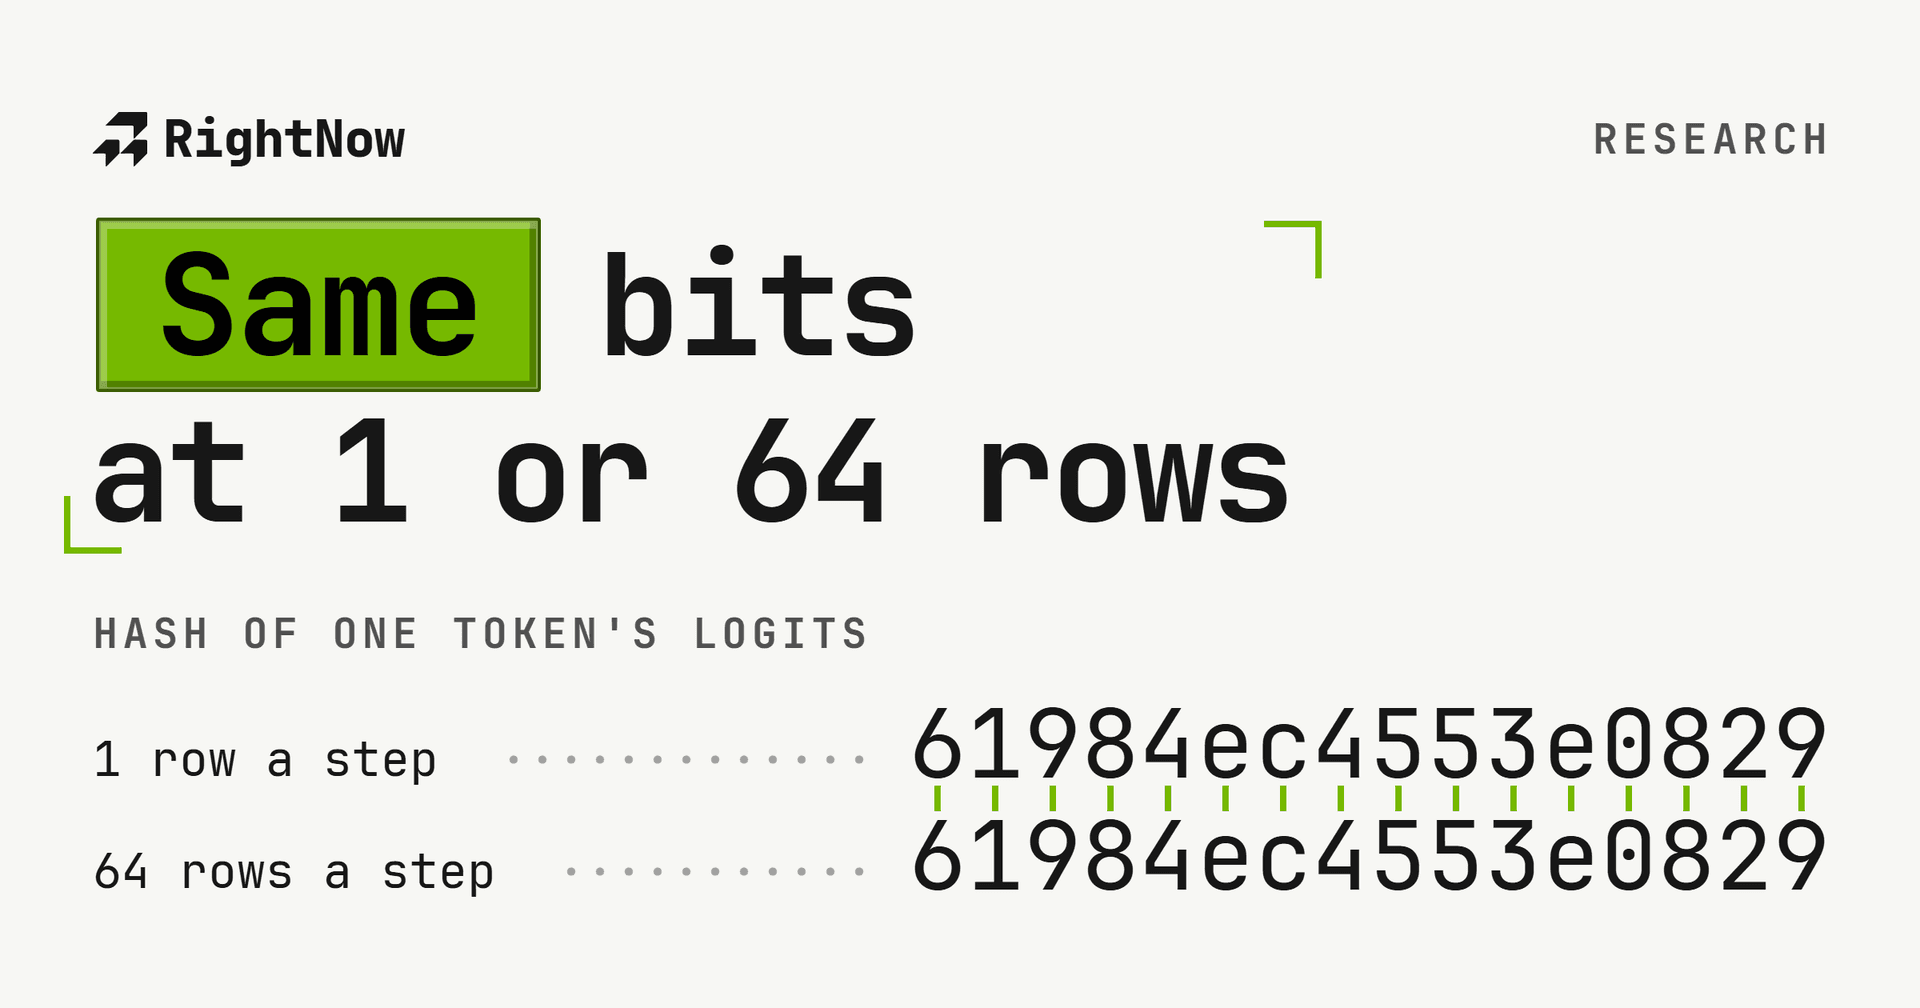
证明跑在真实模型上。 把每个提示分别以每步 64 个位置和每步 1 个位置喂给模型,在我们比较的全部 599 行上得到相同的 logits。下面每个格子就是一行:悬停或用 Tab 切换,可以看到两个哈希。
Logit hash per row, 64 rows against 1 row per step
599 of 599same bits
essay143 of 143 same
code152 of 152 same
math157 of 157 same
explain147 of 147 same
essay, row 0same bits
- 64 rows a step
- 61984ec4553e0829
- 1 row a step
- 61984ec4553e0829
我们专家 GEMM 里的每一个分块求和都以这个平衡树收尾;每个加法都是一个显式的就近舍入加法,编译器绝不会把它融合成乘加,而顶部的交换就是被破坏的孪生,我们的测试必须抓到它。
内核 1:NVFP4 专家跨 GPU 精确拆分
NVFP4 专家的激活在运行时量化,每个 token 一个 FP32 缩放,由整行的最大值算出。SGLang 针对这个模型的配方说 NVFP4 专家不能按张量并行切分,“because their activation scales must cover each expert's full input width”,所以引擎用专家并行运行它们,每个 GPU 拿整个专家。
我们还是做了切分:每个 GPU 拿每个专家列数的八分之一,再交换一次行最大值。最大值与取最大值的顺序无关,所以这个交换是精确的,量化器与参考实现的 four over six 规则逐位一致。
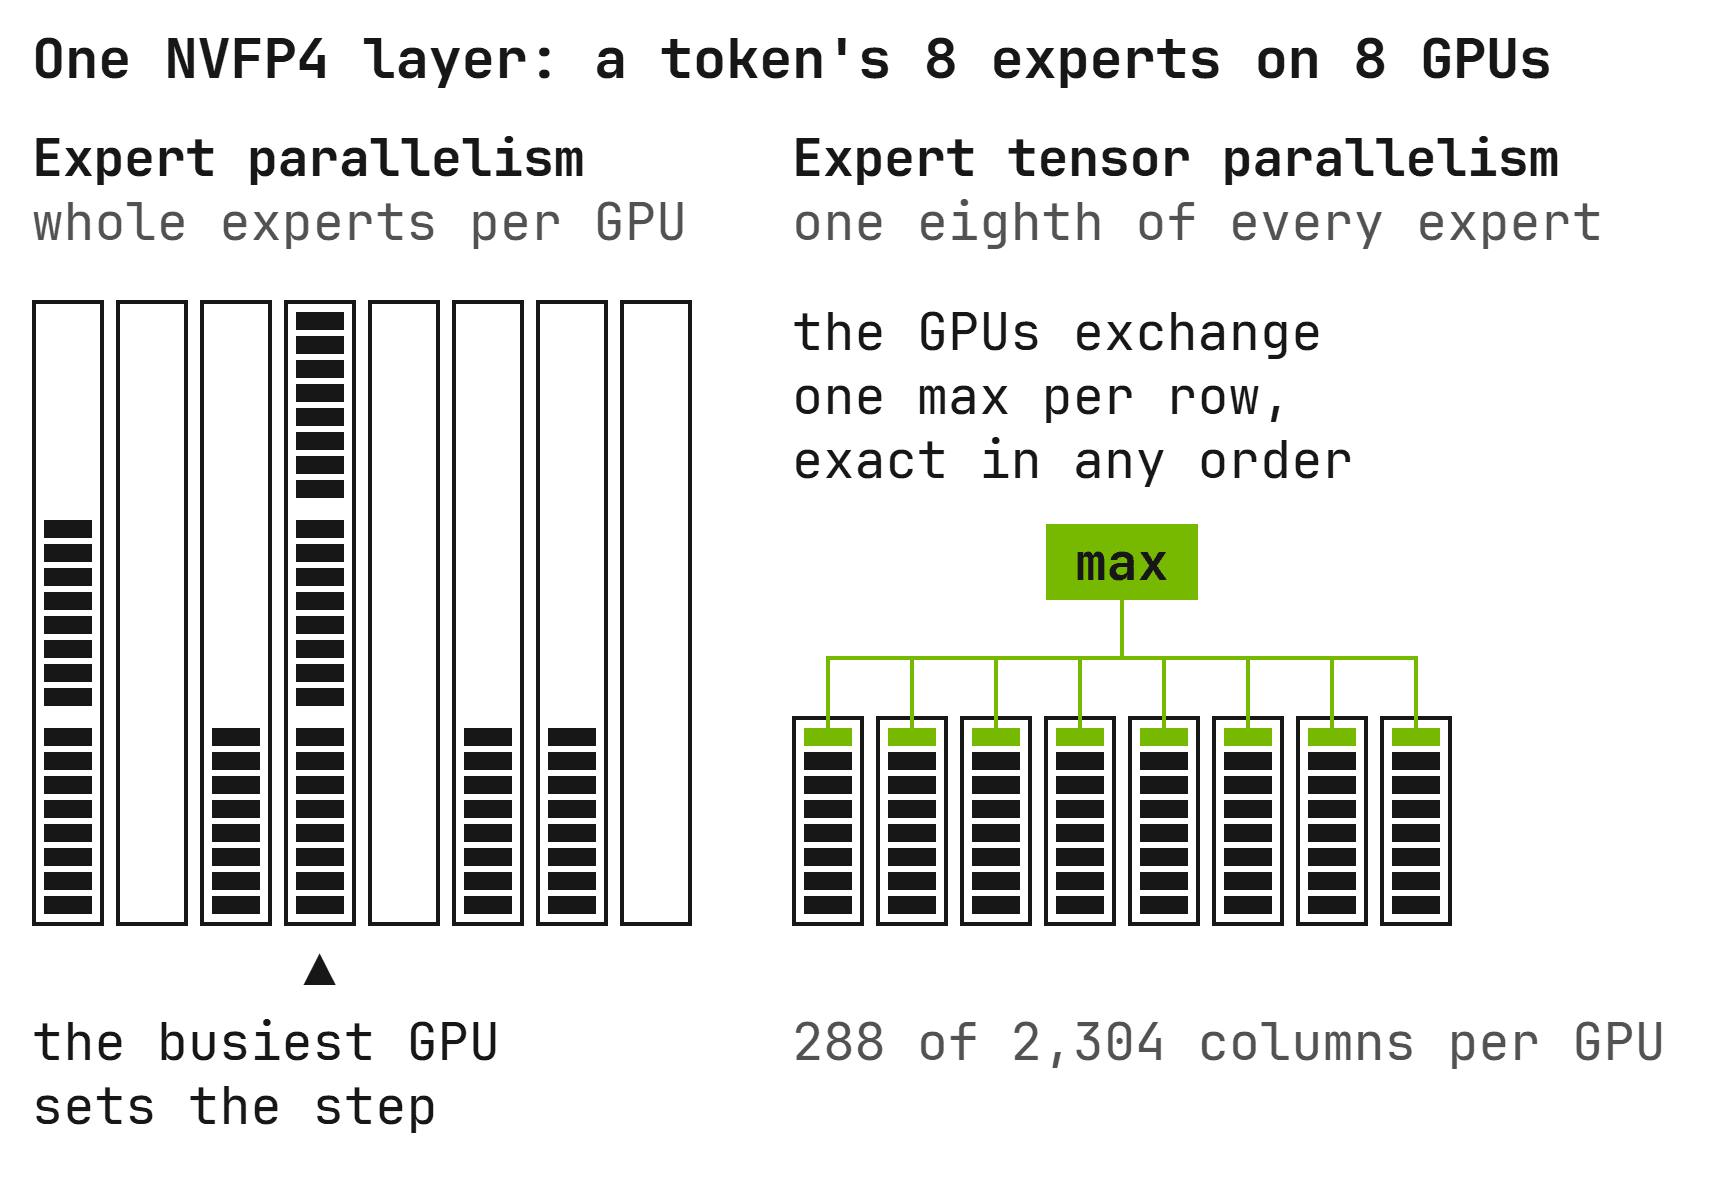
每个 GPU 在该行自己那 288 列里找出绝对值最大的元素,然后每个 GPU 用 fmaxf 把收到的 8 个最大值折叠起来,无论什么顺序都给出相同的位;fma 那行是顺序相关的孪生,我们的排列测试必须抓到它。
这个交换在我们测试的全部 8 个 rank 顺序下都给出相同的位,8 个 rank 在单张 B300 上模拟,顺序相关的合并会被抓到。
每个 GPU 读取每个活跃专家的相等切片,所以没有 GPU 比别的 GPU 读更多专家字节。代价是每个 FP4 层多一次交换。
第二种形式交换激活本身而不是它的最大值,并把 w2 按输出行而不是按 K 切分。
于是每个 GPU 各自量化整行,收尾的 FP32 部分和 all-reduce 变成 BF16 切片的 all-gather,每个 GPU 每个 FP4 层发送的字节数降到原来的 3.2 分之一:单行时 40 KB 对 129 KB,8 行验证步时 0.32 MB 对 1.03 MB。
它在 SGLang 舍入的地方舍入,每个专家的输出在求和前先转 BF16,并且在我们测试的那个 FP4 层上,与这些舍入点的 FP64 模型相比误差为零。
内核 2:为单 token 重建的块缩放 GEMM
两个内核都以权重为 M、每个 tile 128 行运行 tcgen05.mma,token 换到 N,配 FP32 累加器,块缩放放在张量内存里。
在重建的内核里,一个线程喂张量核心:在每个 K 步,它用 tcgen05.cp 把权重和 token 的块缩放复制进 TMEM,然后发出一条块缩放的 tcgen05.mma,其累加谓词在该分块第一个 K 步上为关,所以每个分块都从一个清零的 FP32 累加器开始。
单个 token 时,每个 GPU 上的 w13 GEMM 每层要流过 11.9 MB 的 FP4 权重和缩放。我们的第一个内核给每个专家 tile 一个 CTA,分阶段走过 K 却从不重叠:148 个 SM 上 40 个 CTA,114 GB/s。
重建的内核把固定的 K 分块拆给多个 CTA,并让每个阶段的加载流水化到 MMA 之下。每个分块仍是从清零累加器出发、按相同 K 顺序的同一串块缩放 MMA,最后到达的 CTA 用同一个固定树合并各分块,所以每个输出都保住自己的位。
每个 CTA 写下自己分块的 FP32 部分和,插入栅栏并取一个票号;最后到达的那个为下一次 CUDA graph 回放重置计数器,按分块顺序经 L2 读出每个分块,并用同一个固定树求和。
Microseconds per launch
- w13 · NVFP45.1xFirst kernel 104.4 microseconds, rebuilt 20.5.
- w13 · MXFP87.5xFirst kernel 184.3 microseconds, rebuilt 24.6.
- w2, first form · NVFP41.0xFirst kernel 14.3 microseconds, rebuilt 14.3.
- w2, first form · MXFP81.3xFirst kernel 20.5 microseconds, rebuilt 16.3.
- w2, second form · NVFP43.3xFirst kernel 55.8 microseconds, rebuilt 16.9.
- w2, second form · MXFP84.6xFirst kernel 88.0 microseconds, rebuilt 19.1.
w13, NVFP4, layer 0
- first kernel
- 104.4
- 114 GB/s
- rebuilt
- 20.5
- 583 GB/s
- weights
- 11.94 MB
- 8 experts
每步 8 个 token、每层 40 个不同专家时,重建的 w13 在 NVFP4 上读到 1.39 TB/s,在 MXFP8 上读到 1.84 TB/s,而我们测得单张 B300 的内存为 6.85 TB/s,所以这个内核还有余量。
与第一个内核相比,在第 0 层和第 40 层、1 到 64 行、三次 CUDA graph 回放上,每个中间值都逐位相等:512 行中 0 行不同。
内核 3:一轮完成的深度混合
Inkling 在每层注意力和每个专家块之前混合更早各层的输出:对最多九个更早的输出做一次 softmax,然后做一次归一化。直接做的话,每次混合需要在 GPU 间做两次归约。
我们保留更早输出的 Gram 矩阵,在每个块收尾时一次性算好,于是混合的范数来自这个矩阵加上一列新值:一次归约代替两次,每层 2 轮代替 4 轮,这都数过了。
在我们的测试里,这个范数与直接算出的范数相对误差在 1.6e-7 以内,用一个补偿求和,并在任何抵消可能超过门限的行上回退到直接的第二轮。
把专家路由折叠进同一个归约,在第 0 层和第 40 层的真实路由器上改变了 1.1% 和 1.6% 的 token 的前 8 名专家,所以它被排除在外:一个会改变路由的改动不是无损的。
与 vLLM 的差距
完整模型在 8 张 GPU 上,在 vLLM 自己的 4 个提示的续写上做教师强制,对照 vLLM 在 595 个位置上的对数概率。vLLM 跑两次与自身完全一致,所以下面的每个差异都来自两个引擎的算术,而不是噪声。
Distance from vLLM, nats
- mean
- 0.0249
- median
- 0.0016
- p95
- 0.1285
- max
- 0.7269
- vLLM run twice
- 0.0000
如今每一步的时间花在哪里
我们的引擎仍然以 CUDA graph 下的多个独立启动运行一个解码步:在 8 张 B300 GPU 上,单行、不带草稿时每步约 16 ms。最大的开销来自我们第一个内核的专家 GEMM,重建的内核在隔离测试中能把它加快约五倍,但还没有进引擎。
Kernel time per step, one GPU, ms
16.76 in all
- Expert GEMMs5.94
- Exchanges and waits4.93
- Depth mix and conv2.45
- Attention1.39
- Router and work list0.88
- Dense BF16 GEMMs0.63
- Quantize and combine0.48
- Embed and sample0.03
Expert GEMMs35.4%
- 4.03w13 GEMM, NVFP4expert_gemm_tc05_kernel<0,1,4,0>
- 1.42w13 GEMM, MXFP8expert_gemm_tc05_kernel<1,1,4,0>
- 0.36w2 GEMM, NVFP4expert_gemm_tc05_kernel<0,1,1,1>
- 0.12w2 GEMM, MXFP8expert_gemm_tc05_kernel<1,1,1,1>
接下来是每个 GPU 一个常驻解码程序:所有层放进一个常驻内核,交换就在它内部。
我们为单个验证步做的字节和延迟预算是:每个 GPU 约 7.8 GB,共 154 次交换,按 Inkling 自己的投机草稿每步 3.35 个 token、每层假定 45 个不同专家计算,这些我们还没有实测。
在这个预算下,该程序的目标是每用户每秒约 1,900 个 token,一个约在 1,630 到 2,160 之间的推算。作为参照,带同一草稿的 vLLM 在我们自己的 8 卡 B300 节点上把这个模型跑到每用户每秒 666 个 token。下一篇帖子报告我们实测的数字,逐位对比。
配置
完整源码、测试套件和产出每个结果的云端运行器都在 github.com/RightNow-AI/inkling-b300-kernels,许可证为 Apache 2.0。
每个内核都针对 B300 的架构专属目标构建,并关闭收缩:
完整模型在 8 张 GPU 上,教师强制,分别在每步 64 行和每步 1 行,以及测速用的那条命令:
参考:
条件
我们的引擎和 vLLM 参考跑在一个云节点上,8 张 NVIDIA B300 SXM6 GPU,驱动 620.70.06,8 张 GPU 之间都有点对点访问;内核套件和 GEMM 计时跑在其中一张 GPU 上。
检查点 thinkingmachines/Inkling-2-Small,版本 885d78bf。参考:vLLM nightly 镜像 sha256:c17e9d88。vLLM 带草稿的速度(2026-11-21)和 6.85 TB/s 的内存带宽(2026-11-20)在我们自己的 8 卡 B300 节点上测得;其余均在 2026-11-21 测得。