
Otimizando os kernels do Inkling 2 Small na NVIDIA B300
, 11 min de leitura, By Jaber Jaber
PesquisaRightNow AI é um laboratório de pesquisa em GPU apoiado pela YC. Otimizamos os kernels do Inkling 2 Small, a mistura de especialistas de 594B parâmetros da Thinking Machines, em 8 GPUs NVIDIA B300. Todo kernel, teste, config e resultado é código aberto em github.com/RightNow-AI/inkling-b300-kernels.
A Thinking Machines fez o pré-treinamento, o treinamento intermediário e o pós-treinamento deste modelo em NVFP4, e o seu model card chama isso de "a precisão nativa do modelo". Nós rodamos esses números como foram treinados: os especialistas NVFP4 das camadas 0 a 39 nos tensor cores FP4 com escala por bloco do Blackwell, os especialistas MXFP8 das camadas 40 a 47 nos tensor cores FP8 com escala por bloco.
| Medido em GPUs B300, 2026-11-21 | Resultado |
|---|---|
| Logits iguais, 64 linhas por passo contra 1 linha por passo, modelo completo em 8 GPUs | 0 de 599 linhas diferem, bit a bit |
| Diferença de log-probabilidade do próximo token em relação ao vLLM, mesmo modelo e GPUs | 0.025 nats em média, 0.13 no p95 |
| GEMM w13 de especialistas, uma GPU, um token, a versão reconstruída contra o nosso primeiro kernel | 5.1x mais rápida em NVFP4, 7.5x em MXFP8, mesmos bits |
| Suítes de testes de kernels numa B300, 8 ranks emulados | 10 de 10 passam |
Todo kernel aqui foi escrito pelo nosso motor de kernels de IA: agentes de código que escrevem CUDA, rodam o nosso harness de testes e mantêm ou revertem cada mudança. Um kernel era mantido somente depois de passar pelas suas validações.
Por que isto precisa de CUDA
O NVFP4 armazena valores E2M1 de 4 bits com uma escala E4M3 para cada bloco de 16. Os tensor cores do Blackwell leem essas escalas diretamente: uma instrução tcgen05.mma, kind::mxf4nvf4.block_scale.block16, multiplica os próprios bytes do modelo.
O MI350X e o MI355X da AMD não. Nas próprias palavras da AMD, o suporte de computação FP4 deles se limita ao MXFP4, cujos blocos têm largura 32 com escalas que são potências de dois, então um checkpoint NVFP4 precisa primeiro ser convertido para MXFP4 para usar esse caminho. No Blackwell o modelo roda nos números em que foi treinado.
Os mesmos bits com 1 ou 64 linhas
A maioria dos motores de inferência é próxima, não exata. O resultado de um token depende do que mais divide o mesmo passo, porque o lote muda como as somas são divididas e a adição em ponto flutuante não é associativa.
A Thinking Machines deu à correção o nome de invariância de lote: o resultado de uma linha não pode depender do lote de forma alguma. Nós a mantemos nos tensor cores NVFP4 e MXFP8 com escala por bloco, dos especialistas divididos entre 8 GPUs e de cada troca entre elas.
Toda redução tem uma forma fixa. As somas rodam em pedaços fixos e árvores balanceadas, as somas entre GPUs são combinadas em ordem de rank em FP32, e o build desliga a contração automática, então todo multiply-add fundido é um que escrevemos de propósito.
Toda propriedade tem um gêmeo quebrado. Cada propriedade de identidade de bits vem em par com uma variante deliberadamente quebrada que precisa ser detectada. Onde uma quebra não consegue mover os bits, como reordenar somas que são exatas, o log diz isso em vez de contá-la.
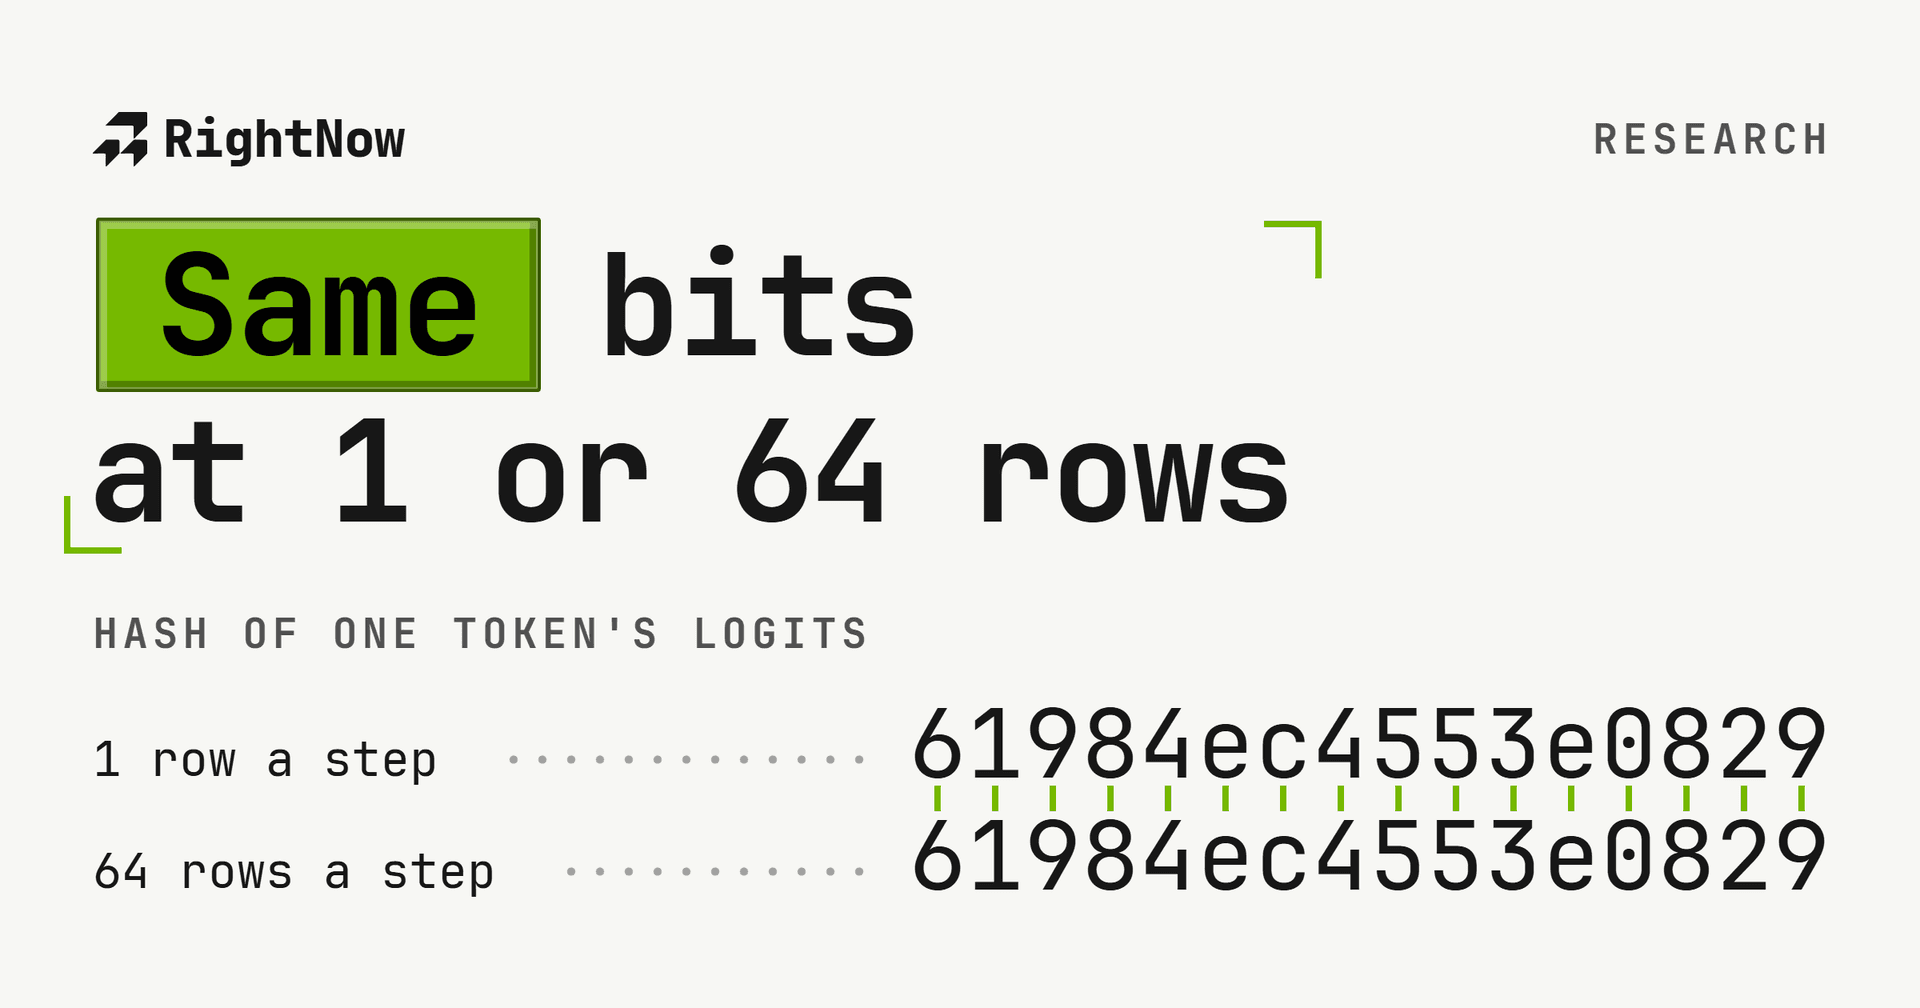
A prova roda no modelo real. Alimentar cada prompt com 64 posições por passo e com 1 posição por passo dá logits idênticos em todas as 599 linhas que comparamos. Cada célula abaixo é uma linha: passe o mouse ou navegue com Tab por ela para ver os dois hashes.
Logit hash per row, 64 rows against 1 row per step
599 of 599same bits
essay143 of 143 same
code152 of 152 same
math157 of 157 same
explain147 of 147 same
essay, row 0same bits
- 64 rows a step
- 61984ec4553e0829
- 1 row a step
- 61984ec4553e0829
Toda soma em pedaços nas nossas GEMMs de especialistas termina nesta árvore balanceada; cada adição é uma adição explícita com arredondamento ao mais próximo que o compilador nunca funde num multiply-add, e a troca no topo é o gêmeo quebrado que os nossos testes precisam pegar.
Kernel 1: especialistas NVFP4 divididos entre GPUs, exatamente
As ativações de um especialista NVFP4 são quantizadas em tempo de execução com uma escala FP32 por token, calculada a partir do máximo sobre a linha inteira. A receita do SGLang para este modelo diz que os especialistas NVFP4 não podem ser divididos por TP, "porque as escalas de ativação deles precisam cobrir toda a largura de entrada de cada especialista", então os motores os rodam com paralelismo de especialistas, especialistas inteiros por GPU.
Nós os dividimos mesmo assim: um oitavo das colunas de cada especialista por GPU, e uma troca do máximo da linha. Um máximo não depende da ordem em que é tomado, então a troca é exata e o quantizador bate bit a bit com a regra four over six da referência.
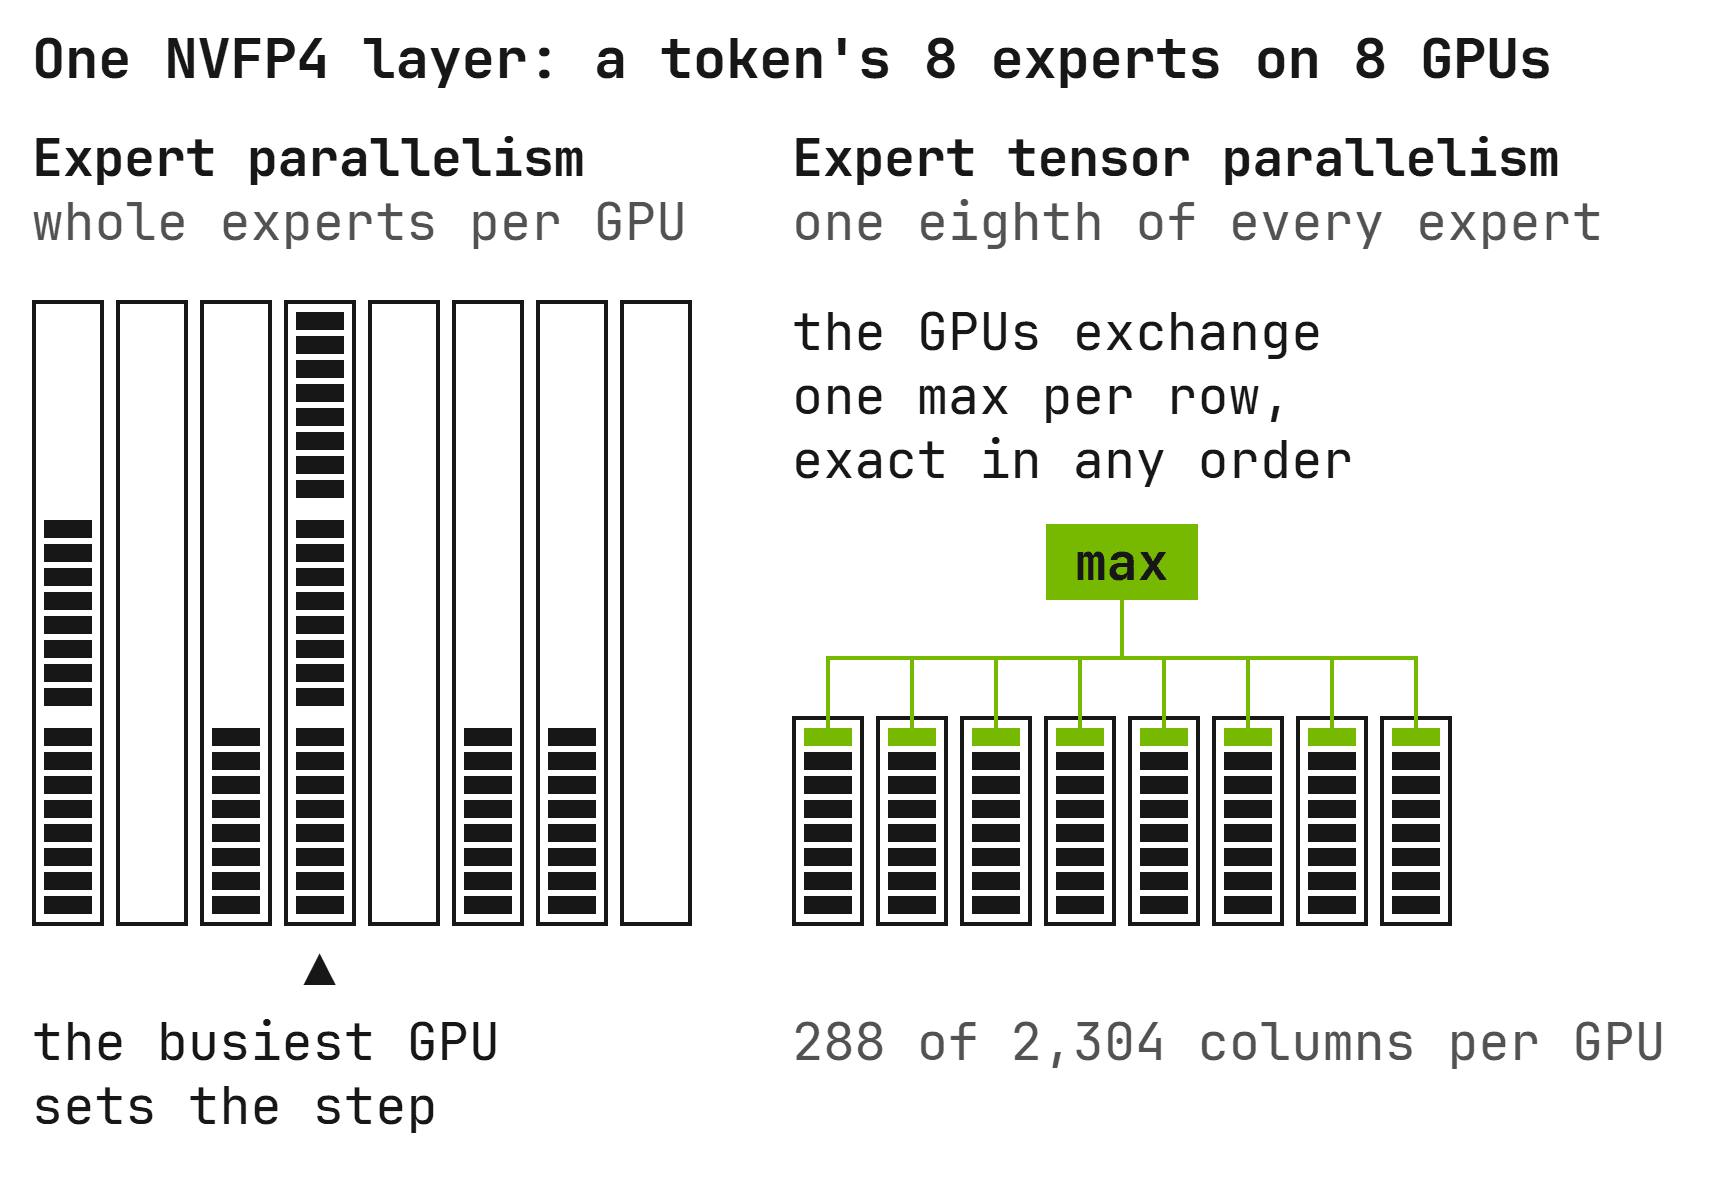
Cada GPU toma a maior magnitude nas suas próprias 288 colunas da linha, e cada GPU então combina os 8 máximos que recebe com fmaxf, o que dá os mesmos bits em qualquer ordem; a linha fma é o gêmeo dependente de ordem que o nosso teste de permutação precisa pegar.
A troca dá os mesmos bits nas 8 ordens de rank que testamos, com os 8 ranks emulados numa B300, e uma combinação dependente de ordem é pega.
Cada GPU lê uma fatia igual de cada especialista ativo, então nenhuma GPU lê mais bytes de especialistas que as outras. O preço é uma troca a mais por camada FP4.
Uma segunda forma troca a própria ativação em vez do seu máximo, e divide w2 por linhas de saída em vez de por K.
Cada GPU então quantiza a linha inteira por conta própria, o all-reduce final de parciais FP32 vira um all-gather de fatias BF16, e cada GPU envia 3.2 vezes menos bytes por camada FP4: 40 KB contra 129 KB a uma linha, 0.32 MB contra 1.03 MB num passo de verificação de 8 linhas.
Ela arredonda onde o SGLang arredonda, a saída de cada especialista para BF16 antes da soma, e mostra erro zero contra um modelo em FP64 desses pontos de arredondamento na camada FP4 que testamos.
Kernel 2: a GEMM com escala por bloco, reconstruída para um token
Ambos os kernels rodam tcgen05.mma com os pesos como M, 128 linhas por tile, e os tokens trocados para N, com acumuladores FP32 e as escalas de bloco na memória de tensores.
No kernel reconstruído uma única thread alimenta o tensor core: para cada passo de K ela copia as escalas de bloco do peso e do token para a TMEM com tcgen05.cp, depois emite um tcgen05.mma com escala por bloco cujo predicado de acumulação está desligado no primeiro passo de K do pedaço, então todo pedaço parte de um acumulador FP32 zerado.
Com um token, a GEMM w13 em cada GPU transfere em streaming 11.9 MB de pesos e escalas FP4 por camada. O nosso primeiro kernel dava a cada tile de especialista um CTA e percorria K em estágios que nunca sobrepunha: 40 CTAs em 148 SMs, a 114 GB/s.
O kernel reconstruído divide os pedaços fixos de K entre CTAs e sobrepõe as cargas de cada estágio às MMAs. Cada pedaço ainda é a mesma cadeia de MMAs com escala por bloco na mesma ordem de K a partir de um acumulador zerado, e o último CTA a chegar combina os pedaços na mesma árvore fixa, então toda saída mantém os seus bits.
Cada CTA escreve as parciais FP32 do seu pedaço, faz um fence e retira um tíquete; o último a chegar zera o contador para o próximo replay do CUDA graph, lê todo pedaço pela L2 em ordem de pedaço e os soma na mesma árvore fixa.
Microseconds per launch
- w13 · NVFP45.1xFirst kernel 104.4 microseconds, rebuilt 20.5.
- w13 · MXFP87.5xFirst kernel 184.3 microseconds, rebuilt 24.6.
- w2, first form · NVFP41.0xFirst kernel 14.3 microseconds, rebuilt 14.3.
- w2, first form · MXFP81.3xFirst kernel 20.5 microseconds, rebuilt 16.3.
- w2, second form · NVFP43.3xFirst kernel 55.8 microseconds, rebuilt 16.9.
- w2, second form · MXFP84.6xFirst kernel 88.0 microseconds, rebuilt 19.1.
w13, NVFP4, layer 0
- first kernel
- 104.4
- 114 GB/s
- rebuilt
- 20.5
- 583 GB/s
- weights
- 11.94 MB
- 8 experts
Com 8 tokens por passo e 40 especialistas distintos por camada, a w13 reconstruída lê 1.39 TB/s em NVFP4 e 1.84 TB/s em MXFP8, contra os 6.85 TB/s que medimos para a memória de uma B300, então este kernel ainda tem folga.
Contra o primeiro kernel, nas camadas 0 e 40 com 1 a 64 linhas e em três replays de CUDA graph, todo intermediário é igual bit a bit: 0 de 512 linhas diferem.
Kernel 3: uma mistura de profundidade numa rodada
O Inkling mistura as saídas de camadas anteriores antes de cada bloco de atenção e de cada bloco de especialistas: uma softmax sobre até nove saídas anteriores, depois uma normalização. Feita diretamente, cada mistura precisa de duas reduções entre as GPUs.
Nós mantemos a matriz de Gram das saídas anteriores, calculada uma vez quando cada bloco fecha, então a norma da mistura vem dessa matriz e de uma coluna nova: uma redução em vez de duas, 2 rodadas por camada em vez de 4, contadas.
A norma difere da direta por menos de 1.6e-7 relativo nos nossos testes, com uma soma compensada e um retorno à segunda rodada direta para qualquer linha onde o cancelamento pudesse exceder o limite.
Incorporar o roteador de especialistas na mesma redução mudou os 8 principais especialistas de 1.1% e 1.6% dos tokens nos roteadores reais das camadas 0 e 40, então ele fica de fora: uma mudança que move o roteamento não é sem perdas.
Quão perto do vLLM
O modelo completo em 8 GPUs, teacher-forced nas próprias continuações do vLLM para 4 prompts, contra as log-probabilidades do vLLM em 595 posições. O vLLM rodado duas vezes concorda consigo mesmo exatamente, então toda diferença abaixo é entre a aritmética dos dois motores, não ruído.
Distance from vLLM, nats
- mean
- 0.0249
- median
- 0.0016
- p95
- 0.1285
- max
- 0.7269
- vLLM run twice
- 0.0000
Para onde vai o passo hoje
O nosso motor ainda roda um passo de decodificação como lançamentos separados sob CUDA graphs: cerca de 16 ms por passo a uma linha sem o rascunho, em 8 GPUs B300. O maior custo é a GEMM de especialistas do nosso primeiro kernel, que o kernel reconstruído corta cerca de cinco vezes em isolamento mas que ainda não está no motor.
Kernel time per step, one GPU, ms
16.76 in all
- Expert GEMMs5.94
- Exchanges and waits4.93
- Depth mix and conv2.45
- Attention1.39
- Router and work list0.88
- Dense BF16 GEMMs0.63
- Quantize and combine0.48
- Embed and sample0.03
Expert GEMMs35.4%
- 4.03w13 GEMM, NVFP4expert_gemm_tc05_kernel<0,1,4,0>
- 1.42w13 GEMM, MXFP8expert_gemm_tc05_kernel<1,1,4,0>
- 0.36w2 GEMM, NVFP4expert_gemm_tc05_kernel<0,1,1,1>
- 0.12w2 GEMM, MXFP8expert_gemm_tc05_kernel<1,1,1,1>
A próxima peça é um programa de decodificação persistente por GPU: toda camada num kernel residente, com as trocas dentro dele.
O nosso orçamento de bytes e de latência para um passo de verificação consome cerca de 7.8 GB por GPU em 154 trocas, com o rascunho especulativo do próprio Inkling a 3.35 tokens por passo e 45 especialistas distintos por camada presumidos, que ainda não medimos.
Nesse orçamento o programa mira cerca de 1,900 tokens por segundo por usuário, uma projeção com uma faixa de cerca de 1,630 a 2,160. Para comparação, o vLLM com o mesmo rascunho roda este modelo a 666 tokens por segundo por usuário no nosso próprio nó de 8 B300. O próximo post traz o nosso número medido, bit a bit.
As configs
O código-fonte completo, as suítes de testes e o cloud runner que produziu cada resultado estão em github.com/RightNow-AI/inkling-b300-kernels, sob a licença Apache 2.0.
Todo kernel é construído para o alvo específico da arquitetura da B300, com contração desligada:
O modelo completo em 8 GPUs, teacher-forced a 64 linhas por passo e a 1, e a linha de velocidade:
A referência:
Condições
O nosso motor e a referência vLLM rodaram num nó de cloud de 8 GPUs NVIDIA B300 SXM6, driver 620.70.06, com acesso peer to peer entre as 8 GPUs; as suítes de kernels e as medições de GEMM rodaram numa das suas GPUs.
Checkpoint thinkingmachines/Inkling-2-Small na revisão 885d78bf. Referência: imagem nightly do vLLM sha256:c17e9d88. A velocidade do vLLM com o rascunho (2026-11-21) e a largura de banda de memória de 6.85 TB/s (2026-11-20) foram medidas no nosso próprio nó de 8 B300; todo o resto em 2026-11-21.