
NVIDIA B300에서 Inkling 2 Small 커널 최적화
, 11분 소요, By Jaber Jaber
연구RightNow AI는 YC의 지원을 받는 GPU 연구소입니다. 우리는 NVIDIA B300 GPU 8개에서 Thinking Machines의 594B 파라미터 믹스처 오브 엑스퍼트, Inkling 2 Small의 커널을 최적화했습니다. 모든 커널, 테스트, 구성, 결과는 github.com/RightNow-AI/inkling-b300-kernels에 오픈소스로 공개되어 있습니다.
Thinking Machines는 이 모델을 NVFP4로 사전 학습, 중간 학습, 사후 학습했고, 그들의 모델 카드는 이를 "the native precision for the model"이라고 부릅니다. 우리는 이 수치들을 학습된 그대로 구동합니다. 레이어 0부터 39까지의 NVFP4 엑스퍼트는 Blackwell의 블록 스케일 FP4 텐서 코어에서, 레이어 40부터 47까지의 MXFP8 엑스퍼트는 그 블록 스케일 FP8 텐서 코어에서 돌아갑니다.
| B300 GPU에서 측정, 2026-11-21 | 결과 |
|---|---|
| 같은 로짓, 단계당 64행 대 1행, 8 GPU에서 전체 모델 | 599행 중 0행이 다름, 비트 단위로 |
| vLLM과의 다음 토큰 로그 확률 차이, 같은 모델과 GPU | 평균 0.025 nats, p95에서 0.13 |
| w13 엑스퍼트 GEMM, GPU 1개, 토큰 1개, 첫 커널과 비교해 재구축 | NVFP4에서 5.1배, MXFP8에서 7.5배, 같은 비트 |
| 커널 테스트 스위트, B300 1개, 8개 랭크 에뮬레이션 | 10개 중 10개 통과 |
여기의 모든 커널은 우리의 AI 커널 엔진이 작성했습니다. CUDA를 쓰고, 우리의 테스트 하니스를 실행하고, 각 변경을 유지하거나 되돌리는 코딩 에이전트입니다. 커널은 자신의 게이트를 통과한 뒤에만 유지되었습니다.
왜 여기에 CUDA가 필요한가
NVFP4는 16개 블록마다 E4M3 스케일이 붙은 4비트 E2M1 값을 저장합니다. Blackwell의 텐서 코어는 그 스케일을 직접 읽습니다. tcgen05.mma 명령 하나, kind::mxf4nvf4.block_scale.block16이 모델 자신의 바이트를 곱합니다.
AMD의 MI350X와 MI355X는 그렇지 않습니다. AMD 자신의 말로, 그들의 FP4 연산 지원은 MXFP4에 한정되며, MXFP4의 블록은 폭 32에 스케일이 2의 거듭제곱이므로, NVFP4 체크포인트는 그 경로를 쓰려면 먼저 MXFP4로 변환되어야 합니다. Blackwell에서 모델은 자신이 학습된 수치 그대로 구동됩니다.
1행 또는 64행에서 같은 비트
대부분의 추론 엔진은 정확하지 않고 가깝기만 합니다. 배치가 합이 나뉘는 방식을 바꾸고 부동소수점 덧셈은 결합적이지 않기 때문에, 토큰의 결과는 자신의 단계를 함께 쓰는 다른 것들에 의존합니다.
Thinking Machines는 그 고침을 배치 불변성이라 이름 붙였습니다. 행의 결과는 배치에 전혀 의존하지 않아야 합니다. 우리는 이것을 NVFP4와 MXFP8 블록 스케일 텐서 코어, 8개 GPU로 나뉜 엑스퍼트, 그리고 그들 사이의 모든 교환을 통해 유지합니다.
모든 축소는 고정된 모양을 갖습니다. 합은 고정된 청크와 균형 트리에서 실행되고, GPU에 걸친 합은 FP32에서 랭크 순서로 접히며, 빌드는 자동 축약을 끄므로 모든 융합 곱셈-덧셈은 우리가 의도해서 쓴 것입니다.
모든 성질에는 부서진 쌍둥이가 있습니다. 각 비트 동일성 성질은 반드시 잡혀야 하는, 일부러 부서진 변형과 짝을 이룹니다. 정확한 합의 재배열처럼 부서짐이 비트를 움직일 수 없는 곳에서는, 로그가 그것을 세는 대신 그렇다고 말합니다.
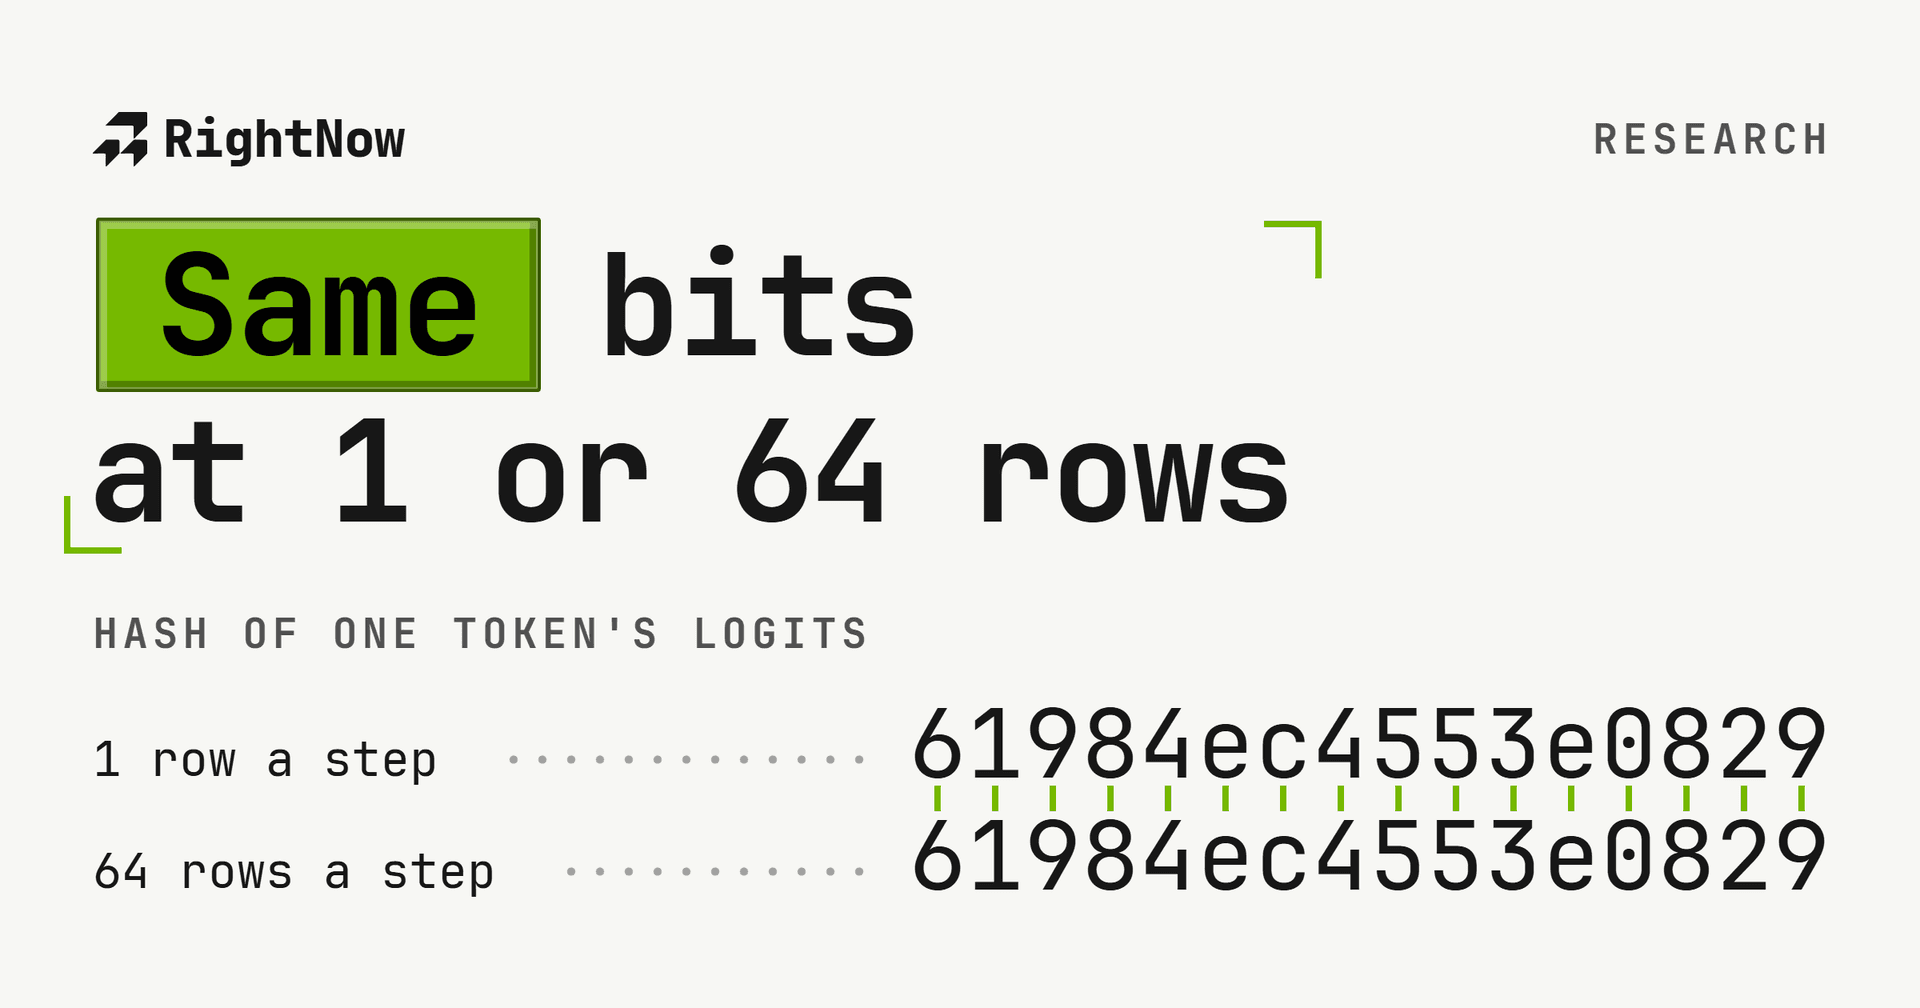
증명은 실제 모델에서 돌아갑니다. 각 프롬프트를 단계마다 64 위치씩, 그리고 1 위치씩 먹이면, 우리가 비교한 599행 모두에서 로짓이 동일합니다. 아래의 모든 칸은 하나의 행입니다. 칸을 호버하거나 탭으로 지나가면 두 해시가 모두 보입니다.
Logit hash per row, 64 rows against 1 row per step
599 of 599same bits
essay143 of 143 same
code152 of 152 same
math157 of 157 same
explain147 of 147 same
essay, row 0same bits
- 64 rows a step
- 61984ec4553e0829
- 1 row a step
- 61984ec4553e0829
우리 엑스퍼트 GEMM의 모든 청크 합은 이 균형 트리에서 끝납니다. 각 덧셈은 컴파일러가 절대 곱셈-덧셈으로 융합하지 않는 명시적인 반올림 덧셈이고, 꼭대기의 swap은 우리 테스트가 반드시 잡아야 하는 부서진 쌍둥이입니다.
커널 1: GPU에 걸쳐 정확하게 나뉜 NVFP4 엑스퍼트
NVFP4 엑스퍼트의 활성값은 실행 시점에 토큰마다 FP32 스케일로 양자화되며, 그 스케일은 행 전체의 최댓값에서 계산됩니다. SGLang의 이 모델용 레시피는 NVFP4 엑스퍼트는 TP 샤딩이 불가능하다고 말합니다. 이유는 "their activation scales must cover each expert's full input width"라는 것이고, 그래서 엔진들은 엑스퍼트 병렬로, GPU마다 엑스퍼트 전체를 돌립니다.
우리는 그럼에도 그들을 샤딩했습니다. GPU마다 모든 엑스퍼트 열의 여덟 분의 일, 그리고 행 최댓값의 교환입니다. 최댓값은 취해지는 순서에 의존하지 않으므로 교환은 정확하고, 양자화기는 기준의 four over six 규칙을 비트 단위로 맞춥니다.
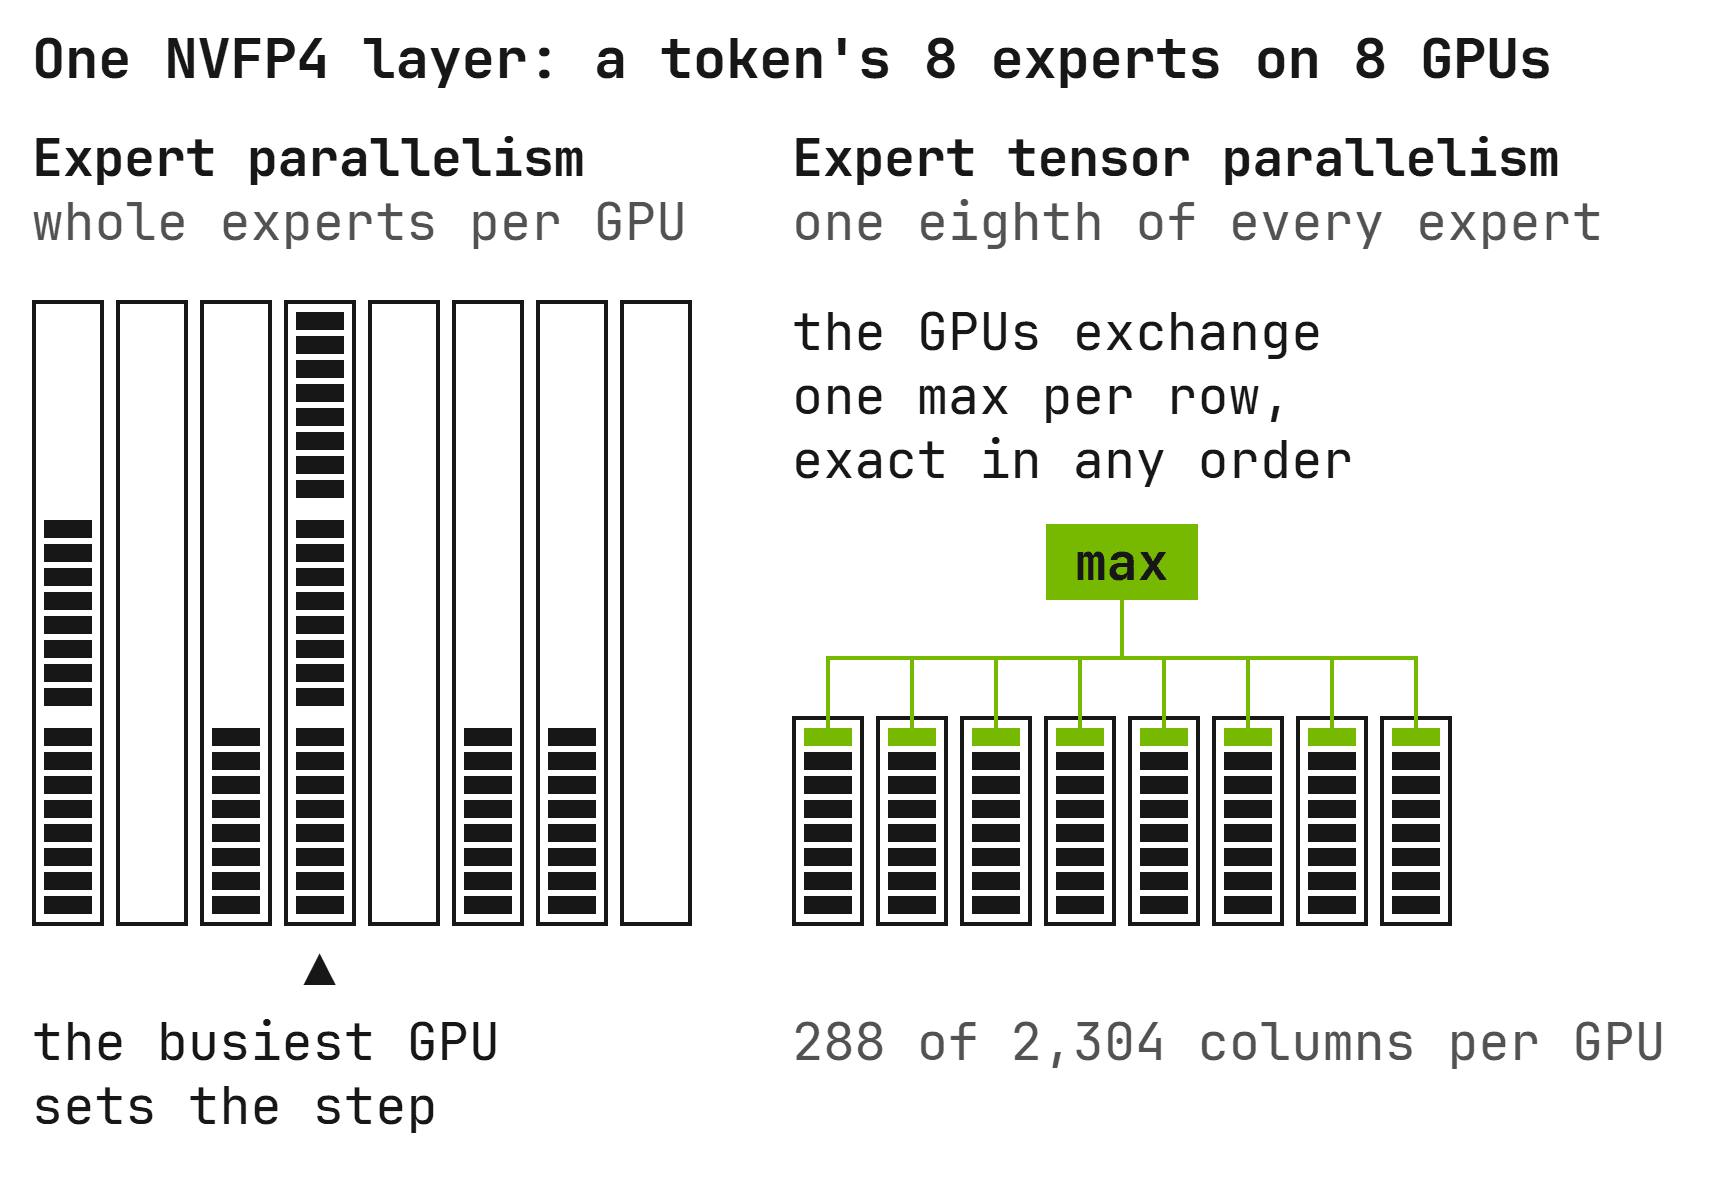
각 GPU는 행의 자기 몫 288열에서 가장 큰 절댓값을 취하고, 모든 GPU는 받은 8개의 최댓값을 fmaxf로 접는데, 이는 어떤 순서에서도 같은 비트를 냅니다. fma 줄은 우리 순열 테스트가 반드시 잡아야 하는 순서 의존 쌍둥이입니다.
교환은 우리가 시험한 8개 랭크 순서 모두에서 같은 비트를 내며, 여기서는 B300 하나에 8개 랭크를 에뮬레이션했고, 순서 의존 결합은 잡힙니다.
모든 GPU는 활성 엑스퍼트마다 같은 크기의 조각을 읽으므로, 어느 GPU도 다른 GPU보다 더 많은 엑스퍼트 바이트를 읽지 않습니다. 대가는 FP4 레이어마다 교환이 하나 더 생기는 것입니다.
두 번째 형태는 최댓값 대신 활성값 자체를 교환하고, w2를 K가 아니라 출력 행으로 나눕니다.
그러면 모든 GPU가 행 전체를 자기 스스로 양자화하고, FP32 부분합을 모으는 마지막 all-reduce가 BF16 조각의 all-gather가 되며, 각 GPU는 FP4 레이어마다 3.2배 적은 바이트를 보냅니다. 1행에서 129 KB에 맞서 40 KB, 8행 검증 단계에서 1.03 MB에 맞서 0.32 MB입니다.
SGLang이 반올림하는 곳에서 반올림합니다. 합 이전에 각 엑스퍼트의 출력을 BF16으로 반올림하고, 우리가 시험한 FP4 레이어에서 그 반올림 지점들을 FP64로 모델링한 것과 오차가 0임을 보였습니다.
커널 2: 토큰 하나를 위해 재구축한 블록 스케일 GEMM
두 커널 모두 가중치를 M으로, 타일마다 128행으로, 토큰을 N으로 맞바꿔 tcgen05.mma를 실행합니다. FP32 어큐뮬레이터를 쓰고 블록 스케일은 텐서 메모리에 둡니다.
재구축된 커널에서는 스레드 하나가 텐서 코어에 데이터를 공급합니다. 각 K 단계마다 가중치와 토큰 블록 스케일을 tcgen05.cp로 TMEM에 복사한 뒤, 블록 스케일 tcgen05.mma 하나를 발행하는데, 그 어큐뮬레이트 술어는 청크의 첫 K 단계에서 꺼져 있어 모든 청크는 0으로 초기화된 FP32 어큐뮬레이터에서 시작합니다.
토큰 하나에서 각 GPU의 w13 GEMM은 레이어마다 FP4 가중치와 스케일 11.9 MB를 스트리밍합니다. 우리의 첫 커널은 각 엑스퍼트 타일에 CTA 하나를 주고, 서로 겹치지 않는 단계로 K를 진행했습니다. 148 SM에 CTA 40개, 114 GB/s였습니다.
재구축된 커널은 고정된 K 청크를 CTA들에 나누고, 모든 단계의 적재를 MMA 아래로 파이프라인합니다. 각 청크는 여전히 0으로 초기화된 어큐뮬레이터에서 같은 K 순서로 같은 블록 스케일 MMA 사슬이고, 마지막에 도착한 CTA가 같은 고정 트리로 청크를 결합하므로, 모든 출력은 자신의 비트를 유지합니다.
각 CTA는 자기 청크의 FP32 부분합을 쓰고, 펜스를 치고 티켓을 뽑습니다. 마지막에 도착한 것이 다음 CUDA 그래프 리플레이를 위해 카운터를 0으로 되돌리고, 청크 순서로 모든 청크를 L2에서 읽어 같은 고정 트리로 합합니다.
Microseconds per launch
- w13 · NVFP45.1xFirst kernel 104.4 microseconds, rebuilt 20.5.
- w13 · MXFP87.5xFirst kernel 184.3 microseconds, rebuilt 24.6.
- w2, first form · NVFP41.0xFirst kernel 14.3 microseconds, rebuilt 14.3.
- w2, first form · MXFP81.3xFirst kernel 20.5 microseconds, rebuilt 16.3.
- w2, second form · NVFP43.3xFirst kernel 55.8 microseconds, rebuilt 16.9.
- w2, second form · MXFP84.6xFirst kernel 88.0 microseconds, rebuilt 19.1.
w13, NVFP4, layer 0
- first kernel
- 104.4
- 114 GB/s
- rebuilt
- 20.5
- 583 GB/s
- weights
- 11.94 MB
- 8 experts
단계마다 8 토큰, 레이어마다 서로 다른 엑스퍼트 40개에서 재구축된 w13은 NVFP4에서 1.39 TB/s, MXFP8에서 1.84 TB/s를 읽습니다. B300 메모리에 대해 우리가 측정한 6.85 TB/s와 비교하면, 이 커널에는 아직 여유가 있습니다.
첫 커널에 맞서, 레이어 0과 40에서 1부터 64행까지, 세 번의 CUDA 그래프 리플레이에 걸쳐, 모든 중간값이 비트 단위로 같습니다. 512행 중 0행이 다릅니다.
커널 3: 한 번의 라운드로 깊이 믹스
Inkling은 모든 어텐션 블록과 모든 엑스퍼트 블록 앞에서 이전 레이어들의 출력을 섞습니다. 최대 아홉 개의 이전 출력에 걸친 소프트맥스, 그다음 정규화입니다. 직접 하면 각 믹스에는 GPU에 걸친 축소 두 개가 필요합니다.
우리는 각 블록이 닫힐 때 한 번 계산되는, 이전 출력들의 그램 행렬을 유지합니다. 그러면 믹스의 노름은 그 행렬과 새 열 하나에서 나옵니다. 둘 대신 축소 하나, 레이어마다 4 라운드 대신 2 라운드, 이렇게 셌습니다.
노름은 우리 테스트에서 직접 계산한 것과 상대 오차 1.6e-7 안에 들며, 보정 합과, 상쇄가 게이트를 넘을 수 있는 행에 대해서는 직접 두 번째 라운드로의 폴백이 따릅니다.
엑스퍼트 라우터를 같은 축소로 접는 것은 실제 라우터에서 레이어 0과 40의 토큰 중 1.1퍼센트와 1.6퍼센트의 상위 8 엑스퍼트를 바꿨으므로, 그것은 넣지 않습니다. 라우팅을 움직이는 변경은 무손실이 아닙니다.
vLLM과 얼마나 가까운가
8 GPU의 전체 모델, vLLM 자신이 이어 쓴 4개 프롬프트에 대해 교사 강제로, 595 위치에서 vLLM의 로그 확률에 맞춰 측정했습니다. vLLM을 두 번 돌리면 자신과 정확히 일치하므로, 아래의 모든 차이는 두 엔진의 연산 사이의 것이지 노이즈가 아닙니다.
Distance from vLLM, nats
- mean
- 0.0249
- median
- 0.0016
- p95
- 0.1285
- max
- 0.7269
- vLLM run twice
- 0.0000
오늘 단계 시간은 어디에 쓰이는가
우리 엔진은 여전히 디코드 단계를 CUDA 그래프로 묶인 개별 커널 실행들로 돌립니다. 초안 없이 1행에서 단계당 약 16 ms, 8 B300 GPU에서입니다. 가장 큰 비용은 우리 첫 커널의 엑스퍼트 GEMM인데, 재구축된 커널이 단독 실행에서 약 5배 줄이지만 아직 엔진에는 들어가 있지 않습니다.
Kernel time per step, one GPU, ms
16.76 in all
- Expert GEMMs5.94
- Exchanges and waits4.93
- Depth mix and conv2.45
- Attention1.39
- Router and work list0.88
- Dense BF16 GEMMs0.63
- Quantize and combine0.48
- Embed and sample0.03
Expert GEMMs35.4%
- 4.03w13 GEMM, NVFP4expert_gemm_tc05_kernel<0,1,4,0>
- 1.42w13 GEMM, MXFP8expert_gemm_tc05_kernel<1,1,4,0>
- 0.36w2 GEMM, NVFP4expert_gemm_tc05_kernel<0,1,1,1>
- 0.12w2 GEMM, MXFP8expert_gemm_tc05_kernel<1,1,1,1>
다음 조각은 GPU마다 영속 디코드 프로그램 하나입니다. 모든 레이어가 하나의 상주 커널에, 교환은 그 안에 들어갑니다.
검증 단계 하나에 대한 우리의 바이트와 지연 예산은 154개 교환에 걸쳐 GPU마다 약 7.8 GB입니다. Inkling 자신의 추측 초안이 단계마다 3.35 토큰이고 레이어마다 서로 다른 엑스퍼트 45개를 가정한 값인데, 이는 아직 측정하지 않았습니다.
그 예산 위에서 이 프로그램은 사용자당 초당 약 1,900 토큰을 목표로 합니다. 약 1,630에서 2,160 범위의 추정입니다. 규모를 가늠해 보면, 같은 초안을 쓰는 vLLM은 우리 자체 8 GPU B300 노드에서 이 모델을 사용자당 초당 666 토큰으로 돌립니다. 다음 글은 우리의 측정값을 비트 단위로 보고합니다.
구성들
전체 소스, 테스트 스위트, 모든 결과를 낸 클라우드 러너는 Apache 2.0 라이선스 아래 github.com/RightNow-AI/inkling-b300-kernels에 있습니다.
모든 커널은 B300의 아키텍처별 타깃에 축약을 끄고 빌드됩니다:
8 GPU의 전체 모델, 단계마다 64행과 1행으로 교사 강제, 그리고 속도 라인:
기준:
조건들
우리 엔진과 vLLM 기준은 NVIDIA B300 SXM6 GPU 8개, 드라이버 620.70.06, 8개 GPU 사이의 모든 피어 투 피어 접근을 갖춘 클라우드 노드 하나에서 실행되었습니다. 커널 스위트와 GEMM 시간은 그 GPU 중 하나에서 측정했습니다.
체크포인트 thinkingmachines/Inkling-2-Small, 리비전 885d78bf. 기준: vLLM 나이틀리 이미지 sha256:c17e9d88. 초안 모델을 쓴 vLLM의 속도(2026-11-21)와 6.85 TB/s 메모리 대역폭(2026-11-20)은 우리 자체 8 GPU B300 노드에서 측정했고, 나머지는 모두 2026-11-21입니다.