
NVIDIA B300 上での Inkling 2 Small のカーネル最適化
, 11分で読めます, By Jaber Jaber
研究RightNow AI は YC 支援の GPU 研究ラボです。私たちは、Thinking Machines の 594B パラメータの MoE である Inkling 2 Small のカーネルを、8 枚の NVIDIA B300 GPU 上で最適化しました。すべてのカーネル、テスト、設定、結果は github.com/RightNow-AI/inkling-b300-kernels でオープンソースとして公開されています。
Thinking Machines はこのモデルを NVFP4 で事前学習、中間学習、事後学習しており、彼らのモデルカードはそれを「このモデルのネイティブ精度」と呼んでいます。私たちはそれらの数値を学習されたとおりに実行します: レイヤー 0 から 39 の NVFP4 エキスパートは Blackwell のブロックスケールド FP4 テンソルコアで、レイヤー 40 から 47 の MXFP8 エキスパートはそのブロックスケールド FP8 テンソルコアで動きます。
| B300 GPU で測定、2026-11-21 | 結果 |
|---|---|
| 同じロジット、ステップあたり 64 行と 1 行の比較、8 GPU 上のフルモデル | ビットごとに 599 行中 0 行が異なる |
| vLLM との次トークンログ確率の差、同じモデルと GPU | 平均 0.025 nats、p95 で 0.13 |
| w13 エキスパート GEMM、1 GPU、1 トークン、最初のカーネルに対する再構築版 | NVFP4 で 5.1 倍速く、MXFP8 で 7.5 倍速く、同じビット |
| 1 枚の B300 上のカーネルテストスイート、8 ランクをエミュレート | 10 個中 10 個が合格 |
ここにあるすべてのカーネルは、私たちの AI カーネルエンジンが書きました。CUDA を書き、私たちのテストハーネスを実行し、各変更を維持するか元に戻すコーディングエージェントです。カーネルは、そのゲートに合格して初めて維持されました。
なぜこれに CUDA が必要なのか
NVFP4 は 4 ビット E2M1 の値を、16 個ごとのブロックにつき 1 つの E4M3 スケールとともに格納します。Blackwell のテンソルコアはそれらのスケールを直接読みます。1 本の tcgen05.mma 命令、kind::mxf4nvf4.block_scale.block16 が、モデル自身のバイトをそのまま乗算します。
AMD の MI350X と MI355X はそうではありません。AMD 自身の言葉では、彼らの FP4 計算サポートは MXFP4 に限定されており、そのブロックは 32 幅でスケールは 2 のべき乗なので、NVFP4 チェックポイントはそのパスを使う前にまず MXFP4 へ変換されなければなりません。Blackwell では、モデルは学習された数値そのもので動きます。
1 行でも 64 行でも同じビット
ほとんどの推論エンジンは、近いものであって同一ではありません。1 トークンの結果は、同じステップに何が同居するかに依存します。バッチが和の分割の仕方を変え、浮動小数点の加算は結合則を満たさないからです。
Thinking Machines はその修正をバッチ不変性と名付けました: ある行の結果は、バッチに一切依存してはならない、と。私たちはそれを、NVFP4 と MXFP8 のブロックスケールドテンソルコア、8 枚の GPU に分割されたエキスパート、そしてその間のすべての交換を通して保ちます。
すべてのリダクションは固定の形を持つ。 和は固定のチャンクとバランス木で走り、GPU 間の和は FP32 でランク順に畳み込まれ、ビルドは自動 FMA 縮約を無効にするので、融合積和はすべて意図して書いたものだけです。
すべての性質は壊れた双子を持つ。 各ビット同一性の性質には、捕まえられなければならない故意に壊れた変種が対になっています。壊してもビットを動かせない場合、たとえば正確な和の並べ替えでは、ログはそれを件数に数えず、その旨を明記します。
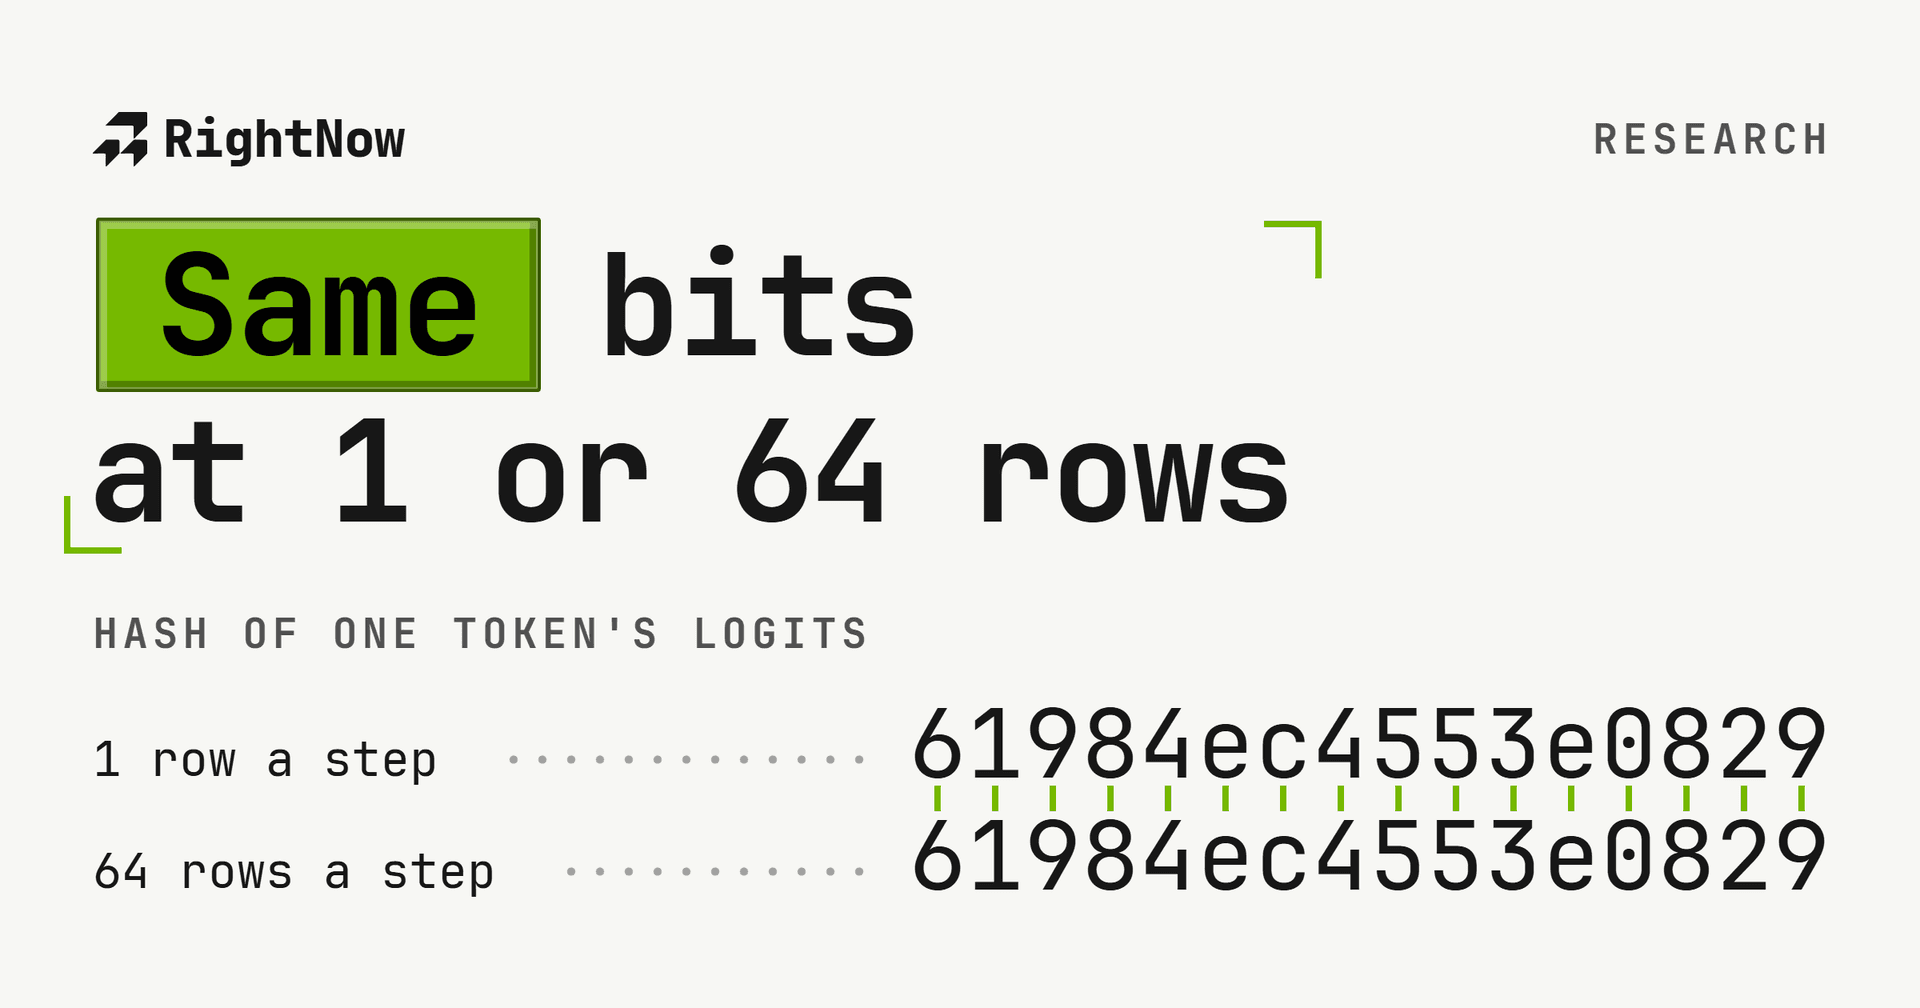
証明は実モデル上で行う。 各プロンプトをステップあたり 64 位置と 1 位置で供給すると、比較した 599 行すべてで同一のロジットが得られます。下のすべてのセルは 1 行です。ホバーするか Tab キーで移動すると、両方のハッシュが見えます。
Logit hash per row, 64 rows against 1 row per step
599 of 599same bits
essay143 of 143 same
code152 of 152 same
math157 of 157 same
explain147 of 147 same
essay, row 0same bits
- 64 rows a step
- 61984ec4553e0829
- 1 row a step
- 61984ec4553e0829
私たちのエキスパート GEMM のすべてのチャンク化和は、このバランス木で終わります。各加算はコンパイラが決して積和に融合しない明示的な最近接丸め加算で、先頭のスワップはテストが捕まえなければならない壊れた双子です。
カーネル 1: NVFP4 エキスパートを GPU 間で正確に分割
NVFP4 エキスパートの活性は、実行時にトークンごとの FP32 スケールで量子化されます。スケールは行全体の最大値から計算されます。このモデルに関する SGLang のレシピは、NVFP4 エキスパートは TP シャーディングできないとしています。その活性スケールは「各エキスパートの全入力幅をカバーしなければならない」からで、そこでエンジンはエキスパート並列、GPU ごとにエキスパート丸ごとという形で実行します。
私たちはそれにもかかわらずシャーディングしました: 各エキスパートの列の 8 分の 1 を GPU ごとに割り当て、行の最大値を交換します。最大値は取る順序に依存しないので、この交換は正確で、量子化器はリファレンスの four over six 規則にビットごとに一致します。
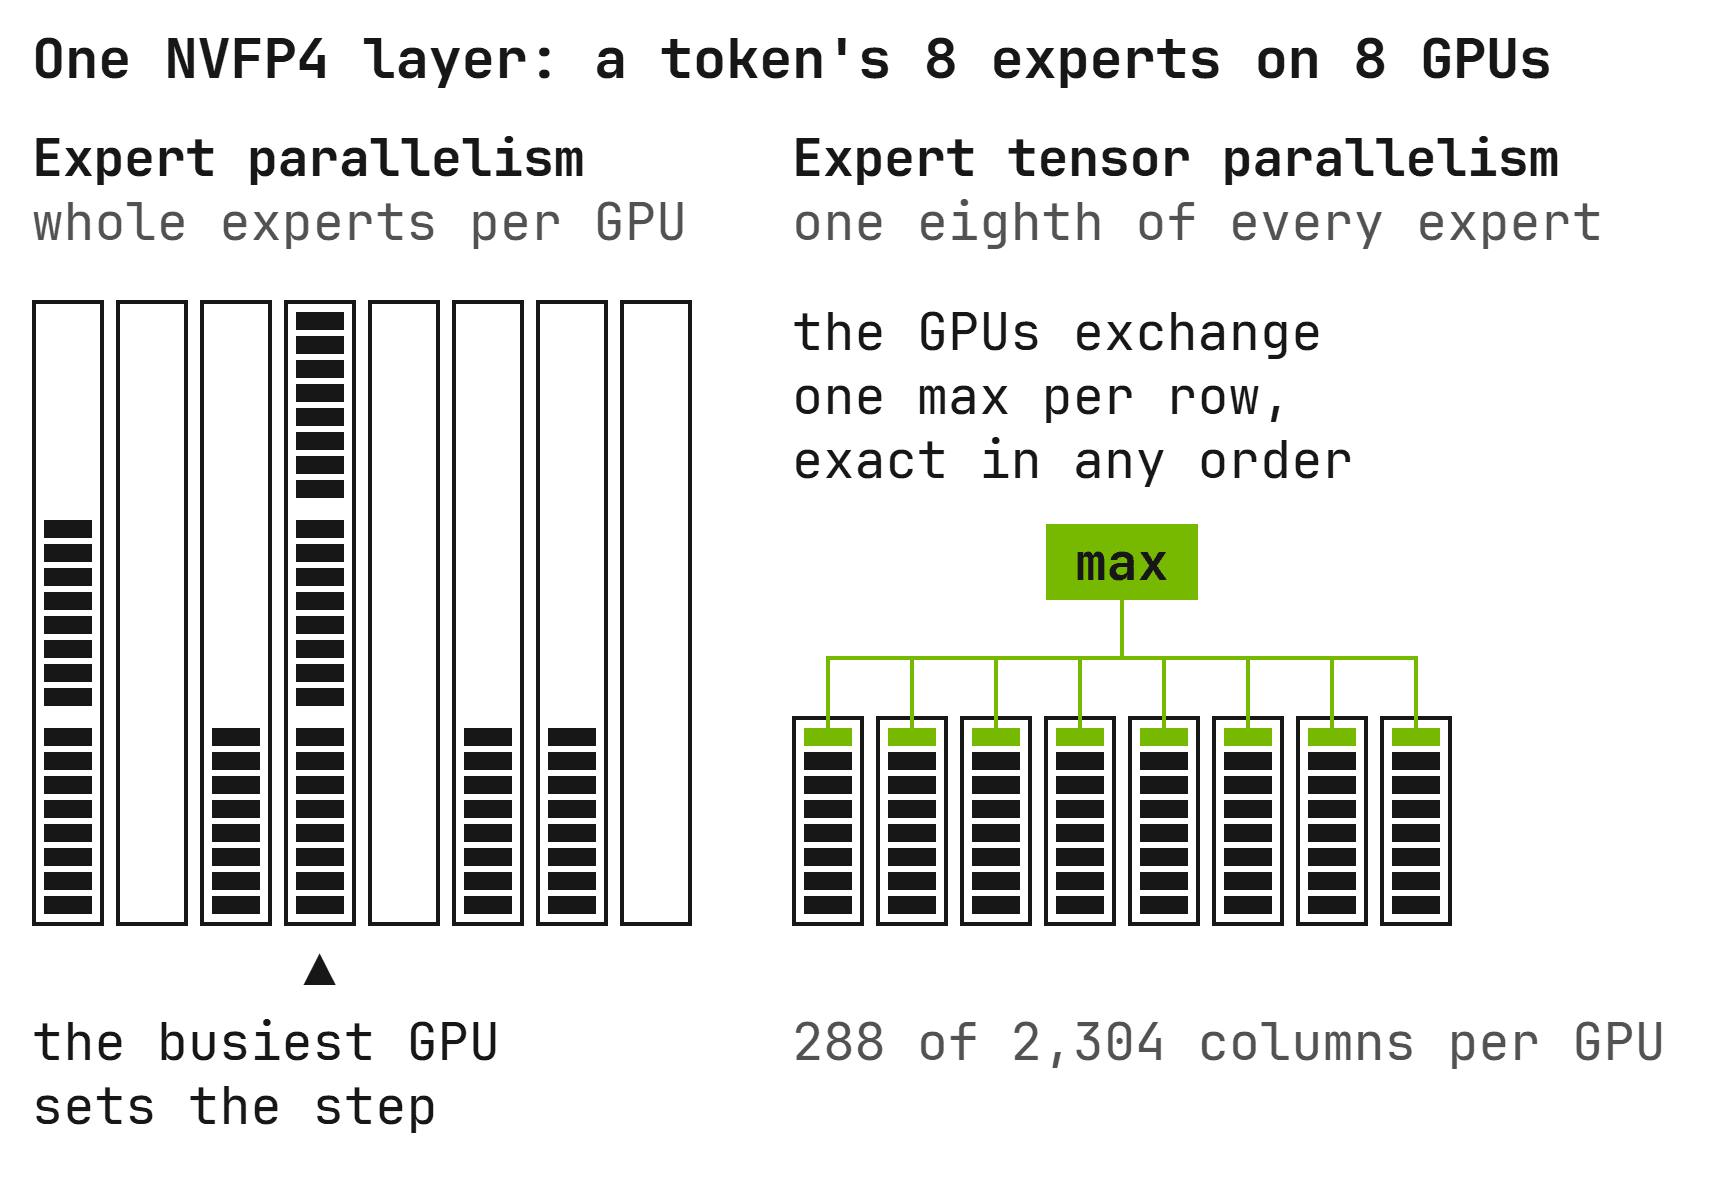
各 GPU は行の自分の 288 列の中で最大の絶対値を取り、すべての GPU は受け取った 8 つの最大値を fmaxf で畳み込みます。これはどの順序でも同じビットを与えます。fma の行は、順列テストが捕まえなければならない順序依存の双子です。
この交換は、1 枚の B300 上で 8 ランクをエミュレートしてテストした 8 通りのランク順すべてで同じビットを与え、順序依存の結合は捕まえられます。
すべての GPU がアクティブなエキスパートそれぞれの等しいスライスを読むので、どの GPU も他より多くのエキスパートバイトを読みません。その代償は、FP4 レイヤーごとに交換が 1 回増えることです。
2 つ目の形式は、最大値の代わりに活性そのものを交換し、K ではなく出力行で w2 を分割します。
すると各 GPU は行全体を自分で量子化し、FP32 部分和の最終段の all-reduce は BF16 スライスのオールギャザーになり、各 GPU は FP4 レイヤーあたりのバイトを 3.2 倍少なく送ります: 1 行では 129 KB に対して 40 KB、8 行の検証ステップでは 1.03 MB に対して 0.32 MB です。
それは SGLang が丸める場所、すなわち各エキスパートの出力を和の前に BF16 へ丸める場所で丸め、テストした FP4 レイヤーでそれらの丸め点の FP64 モデルに対してゼロの誤差を示します。
カーネル 2: 1 トークンのために再構築されたブロックスケールド GEMM
両方のカーネルは tcgen05.mma を、ウェイトを M として、タイルあたり 128 行で、トークンを N にスワップして実行します。累積器は FP32 で、ブロックスケールはテンソルメモリに置きます。
再構築されたカーネルでは、単一のスレッドがテンソルコアに供給します。各 K ステップで、ウェイトとトークンのブロックスケールを tcgen05.cp で TMEM にコピーし、それからブロックスケールド tcgen05.mma を 1 本発行します。その累積述語はチャンクの最初の K ステップではオフで、すべてのチャンクはゼロ初期化された FP32 累積器から始まります。
1 トークンでは、各 GPU の w13 GEMM はレイヤーあたり 11.9 MB の FP4 ウェイトとスケールをストリームします。私たちの最初のカーネルは各エキスパートタイルに 1 つの CTA を与え、決してオーバーラップしないステージで K を進めました: 148 個の SM に対して 40 個の CTA で、114 GB/s でした。
再構築されたカーネルは、固定の K チャンクを CTA 間で分割し、すべてのステージのロードを MMA の下でパイプライン化します。各チャンクは依然として同じブロックスケールド MMA の同じ K 順の連鎖をゼロ初期化累積器から走らせ、最後に到着した CTA が同じ固定木でチャンクを結合するので、すべての出力は自分のビットを保ちます。
各 CTA は自分のチャンクの FP32 部分和を書き、フェンスを張り、チケットを取ります。最後に到着したものは次の CUDA グラフリプレイのためにカウンタをリセットし、すべてのチャンクをチャンク順に L2 から読み、同じ固定木で足し合わせます。
Microseconds per launch
- w13 · NVFP45.1xFirst kernel 104.4 microseconds, rebuilt 20.5.
- w13 · MXFP87.5xFirst kernel 184.3 microseconds, rebuilt 24.6.
- w2, first form · NVFP41.0xFirst kernel 14.3 microseconds, rebuilt 14.3.
- w2, first form · MXFP81.3xFirst kernel 20.5 microseconds, rebuilt 16.3.
- w2, second form · NVFP43.3xFirst kernel 55.8 microseconds, rebuilt 16.9.
- w2, second form · MXFP84.6xFirst kernel 88.0 microseconds, rebuilt 19.1.
w13, NVFP4, layer 0
- first kernel
- 104.4
- 114 GB/s
- rebuilt
- 20.5
- 583 GB/s
- weights
- 11.94 MB
- 8 experts
ステップあたり 8 トークン、レイヤーあたり 40 個の異なるエキスパートで、再構築された w13 は NVFP4 で 1.39 TB/s、MXFP8 で 1.84 TB/s を読みます。B300 のメモリで測定した 6.85 TB/s に対してなので、このカーネルにはまだ余裕があります。
最初のカーネルに対して、レイヤー 0 と 40 で 1 から 64 行、3 回の CUDA グラフリプレイにわたって、すべての中間値はビットごとに等しい: 512 行中 0 行が異なります。
カーネル 3: 1 ラウンドでの深さミックス
Inkling は、すべての attention とすべてのエキスパートブロックの前に、より前のレイヤーの出力をミックスします。最大 9 つの前の出力にわたる softmax、それから正規化です。直接やると、各ミックスは GPU 全体で 2 つのリダクションを必要とします。
私たちは、各ブロックが閉じるときに 1 回計算される、前の出力のグラム行列を保持します。するとミックスの norm はその行列と 1 つの新しい列から得られます: 2 つの代わりに 1 つのリダクションで、レイヤーあたり 4 ラウンドの代わりに 2 ラウンドです。この数は実測です。
この norm は、私たちのテストで直接のものに対して相対 1.6e-7 以内に収まります。補償和と、相殺がしきい値を超えうるすべての行に対する直接の第 2 ラウンドへのフォールバック付きです。
エキスパートルーターを同じリダクションに畳み込むと、レイヤー 0 と 40 の本物のルーターでトークンの 1.1% と 1.6% の上位 8 エキスパートを変えたので、それは入れません: ルーティングを動かす変更はロスレスではありません。
vLLM にどれだけ近いか
8 GPU 上のフルモデルを、4 つのプロンプトの vLLM 自身の継続で teacher forcing し、595 位置で vLLM のログ確率と比較します。vLLM を 2 回実行すると自身と厳密に一致するので、以下の差はすべて 2 つのエンジンの演算の違いであり、ノイズではありません。
Distance from vLLM, nats
- mean
- 0.0249
- median
- 0.0016
- p95
- 0.1285
- max
- 0.7269
- vLLM run twice
- 0.0000
現時点でステップの時間はどこに使われるか
私たちのエンジンは依然として、デコードステップを CUDA グラフの下の個別のローンチとして実行します: ドラフトなしの 1 行で、8 枚の B300 GPU 上でステップあたり約 16 ミリ秒です。最大のコストは最初のカーネルのエキスパート GEMM で、再構築されたカーネルは単体計測では約 5 倍に短縮します、まだエンジンには入っていません。
Kernel time per step, one GPU, ms
16.76 in all
- Expert GEMMs5.94
- Exchanges and waits4.93
- Depth mix and conv2.45
- Attention1.39
- Router and work list0.88
- Dense BF16 GEMMs0.63
- Quantize and combine0.48
- Embed and sample0.03
Expert GEMMs35.4%
- 4.03w13 GEMM, NVFP4expert_gemm_tc05_kernel<0,1,4,0>
- 1.42w13 GEMM, MXFP8expert_gemm_tc05_kernel<1,1,4,0>
- 0.36w2 GEMM, NVFP4expert_gemm_tc05_kernel<0,1,1,1>
- 0.12w2 GEMM, MXFP8expert_gemm_tc05_kernel<1,1,1,1>
次の部品は、GPU ごとに 1 つの常駐デコードプログラムです。すべてのレイヤーを 1 つの常駐カーネルに入れ、その中に交換を置きます。
1 回の検証ステップについての私たちのバイトとレイテンシの予算は、GPU あたり 154 回の交換で約 7.8 GB と試算されます。Inkling 自身の投機ドラフトがステップあたり 3.35 トークン、レイヤーあたり 45 個の異なるエキスパートを仮定したもので、これはまだ測定していません。
この予算の下で、このプログラムはユーザーあたり毎秒約 1,900 トークンを目標にします。約 1,630 から 2,160 の範囲を持つ予測値です。規模の目安として、同じドラフトで vLLM はこのモデルを、当ラボの 8 GPU の B300 ノード上でユーザーあたり毎秒 666 トークンで実行します。次の投稿で、その測定値をビットごとに報告します。
設定
完全なソース、テストスイート、そしてすべての結果を生んだクラウドランナーは github.com/RightNow-AI/inkling-b300-kernels にあり、Apache 2.0 ライセンスの下にあります。
すべてのカーネルは B300 のアーキテクチャ固有ターゲット向けに、FMA 縮約をオフにしてビルドされます。
完全なモデルを 8 GPU 上で、64 行ずつと 1 行ずつの teacher forcing で実行し、速度の設定行:
リファレンス:
諸条件
私たちのエンジンと vLLM リファレンスは、8 枚の NVIDIA B300 SXM6 GPU の 1 つのクラウドノードで、ドライバー 620.70.06、8 GPU 間すべてのピアツーピアアクセス付きで実行されました。カーネルスイートと GEMM のタイミングはそのうちの 1 枚の GPU で走りました。
チェックポイント thinkingmachines/Inkling-2-Small をリビジョン 885d78bf で。リファレンス: vLLM nightly イメージ sha256:c17e9d88。ドラフト付きの vLLM の速度 (2026-11-21) と 6.85 TB/s のメモリ帯域 (2026-11-20) は当ラボの 8 GPU の B300 ノードで測定し、それ以外はすべて 2026-11-21 です。