
Optimización de los kernels de Inkling 2 Small en NVIDIA B300
, 11 min de lectura, By Jaber Jaber
InvestigaciónRightNow AI es un laboratorio de investigación de GPU respaldado por YC. Optimizamos los kernels de Inkling 2 Small, la mezcla de expertos de 594B parámetros de Thinking Machines, en 8 GPUs NVIDIA B300. Cada kernel, prueba, configuración y resultado es de código abierto en github.com/RightNow-AI/inkling-b300-kernels.
Thinking Machines preentrenó, entrenó en una etapa intermedia y post-entrenó este modelo en NVFP4, y su model card lo llama "la precisión nativa para el modelo". Ejecutamos esos números tal como fueron entrenados: los expertos NVFP4 de las capas 0 a 39 en los tensor cores FP4 con escalas de bloque de Blackwell, y los expertos MXFP8 de las capas 40 a 47 en sus tensor cores FP8 con escalas de bloque.
| Medido en GPUs B300, 2026-11-21 | Resultado |
|---|---|
| Logits idénticos, 64 filas por paso contra 1 fila por paso, modelo completo en 8 GPUs | 0 de 599 filas difieren, bit a bit |
| Diferencia de log-probabilidad del siguiente token respecto a vLLM, mismo modelo y GPUs | 0.025 nats de media, 0.13 en p95 |
| GEMM w13 de expertos, una GPU, un token, reconstruida contra nuestro primer kernel | 5.1x más rápida en NVFP4, 7.5x en MXFP8, mismos bits |
| Baterías de pruebas de kernels en un B300, 8 rangos emulados | 10 de 10 pasan |
Cada kernel aquí fue escrito por nuestro motor de kernels con IA: agentes de programación que escriben CUDA, ejecutan nuestro harness de pruebas y conservan o revierten cada cambio. Un kernel se conservaba solo después de pasar sus verificaciones.
Por qué esto necesita CUDA
NVFP4 guarda valores E2M1 de 4 bits con una escala E4M3 por cada bloque de 16. Los tensor cores de Blackwell leen esas escalas directamente: una instrucción tcgen05.mma, kind::mxf4nvf4.block_scale.block16, multiplica los propios bytes del modelo.
Las MI350X y MI355X de AMD no lo hacen. En palabras del propio AMD, su soporte de cómputo en FP4 se limita a MXFP4, cuyos bloques miden 32 de ancho y cuyas escalas son potencias de dos, así que un checkpoint NVFP4 debe convertirse primero a MXFP4 para usar esa vía. En Blackwell el modelo corre en los números en los que fue entrenado.
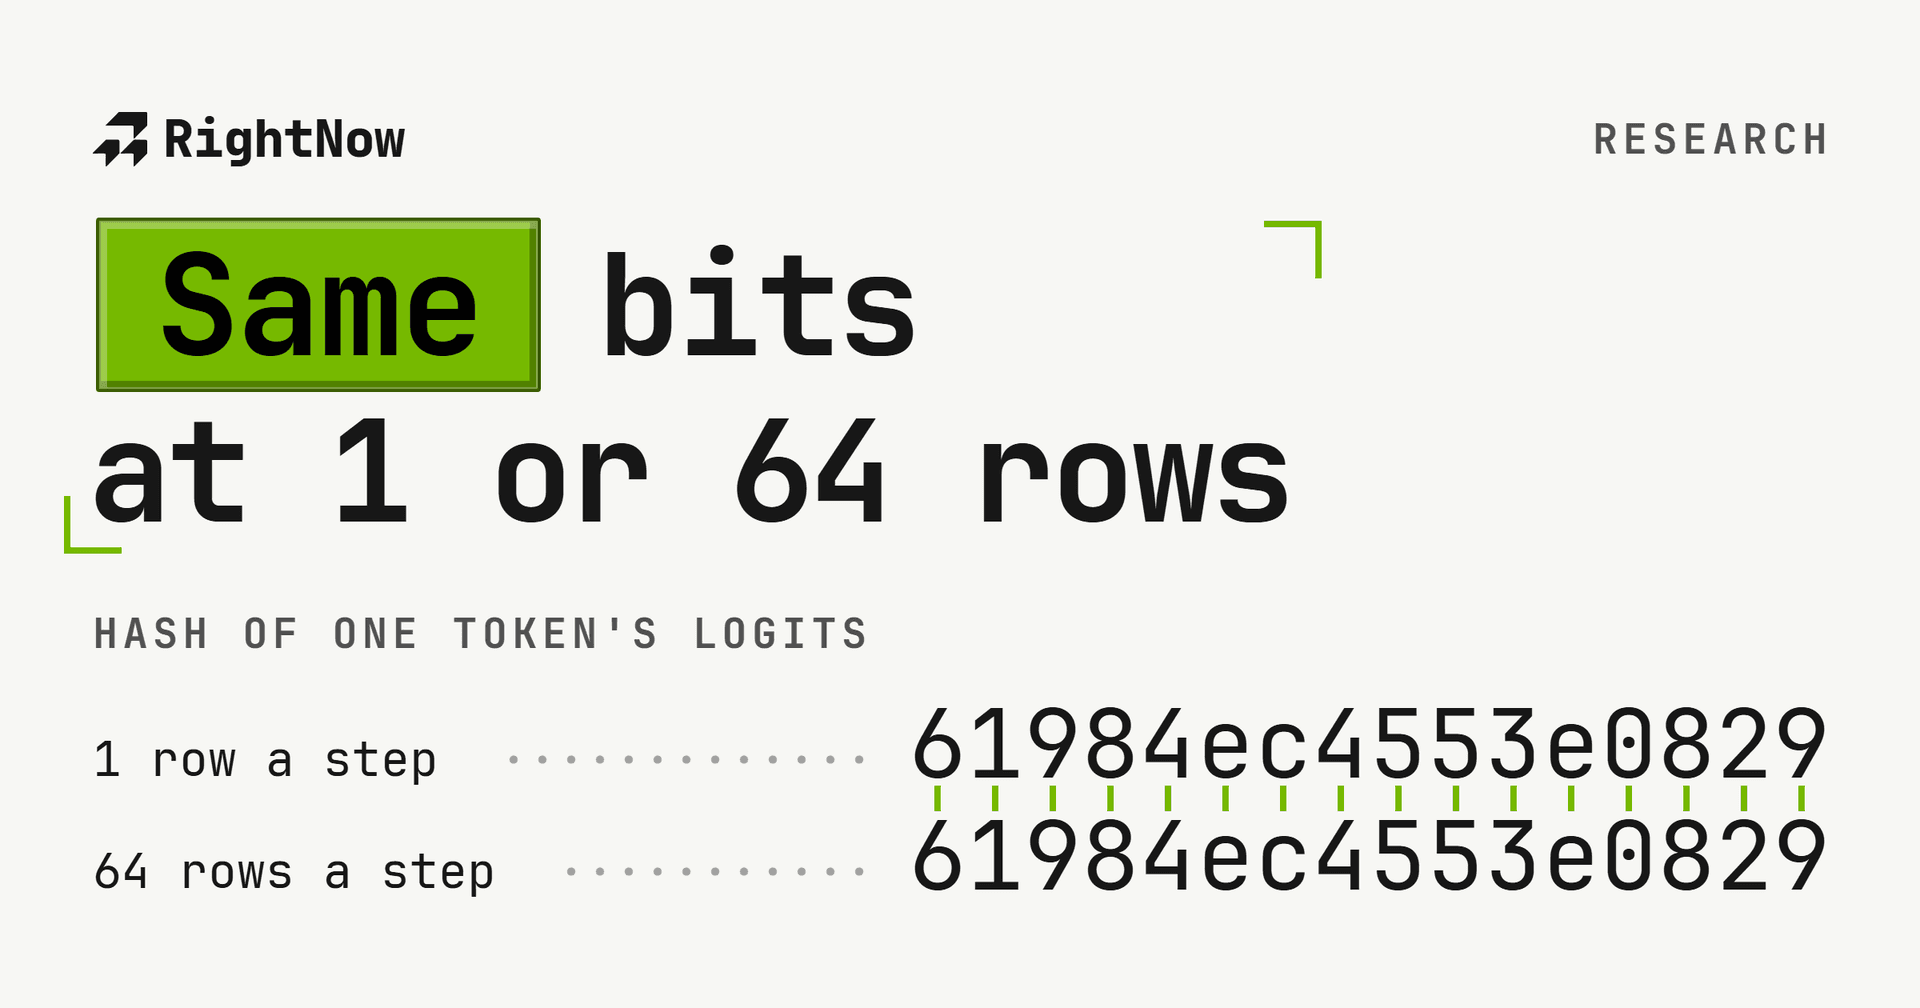
Los mismos bits con 1 o 64 filas
La mayoría de los motores de inferencia dan resultados cercanos, no exactos. El resultado de un token depende de qué más comparte su paso, porque el lote cambia cómo se reparten las sumas y la suma en punto flotante no es asociativa.
Thinking Machines llamó a la solución invariancia de lote: el resultado de una fila no puede depender del lote en absoluto. La mantenemos en los tensor cores NVFP4 y MXFP8 con escalas de bloque, expertos divididos entre 8 GPUs y cada intercambio entre ellas.
Toda reducción tiene una forma fija. Las sumas se ejecutan en trozos fijos y árboles equilibrados, las sumas entre GPUs se pliegan en orden de rango en FP32, y la compilación desactiva la contracción automática, así que cada multiply-add fusionado es uno que escribimos a propósito.
Toda propiedad tiene un gemelo roto. Cada propiedad de identidad de bits se empareja con una variante deliberadamente rota que debe ser detectada. Donde una ruptura no puede mover los bits, como reordenar sumas que son exactas, el registro lo dice en lugar de contarla.
La prueba se ejecuta en el modelo real. Alimentar cada prompt con 64 posiciones por paso y con 1 posición por paso da logits idénticos en las 599 filas que comparamos. Cada celda de abajo es una fila: pasa el cursor o navega con Tab por ella para ver ambos hashes.
Logit hash per row, 64 rows against 1 row per step
599 of 599same bits
essay143 of 143 same
code152 of 152 same
math157 of 157 same
explain147 of 147 same
essay, row 0same bits
- 64 rows a step
- 61984ec4553e0829
- 1 row a step
- 61984ec4553e0829
Cada suma troceada en nuestras GEMM de expertos termina en este árbol equilibrado; cada suma es una suma explícita de redondeo al más cercano que el compilador nunca fusiona en un multiply-add, y el intercambio de arriba es el gemelo roto que nuestras pruebas deben detectar.
Kernel 1: expertos NVFP4 divididos entre GPUs, exactamente
Las activaciones de un experto NVFP4 se cuantizan en tiempo de ejecución con una escala FP32 por token, calculada a partir del máximo de toda la fila. La receta de SGLang para este modelo dice que los expertos de NVFP4 no se pueden fragmentar con TP, "porque sus escalas de activación deben cubrir todo el ancho de entrada de cada experto", así que los motores los ejecutan con paralelismo de expertos, expertos completos por GPU.
Nosotros los fragmentamos de todos modos: una octava parte de las columnas de cada experto por GPU, y un intercambio del máximo de la fila. Un máximo no depende del orden en que se toma, así que el intercambio es exacto y el cuantizador coincide con la regla four over six de la referencia bit a bit.
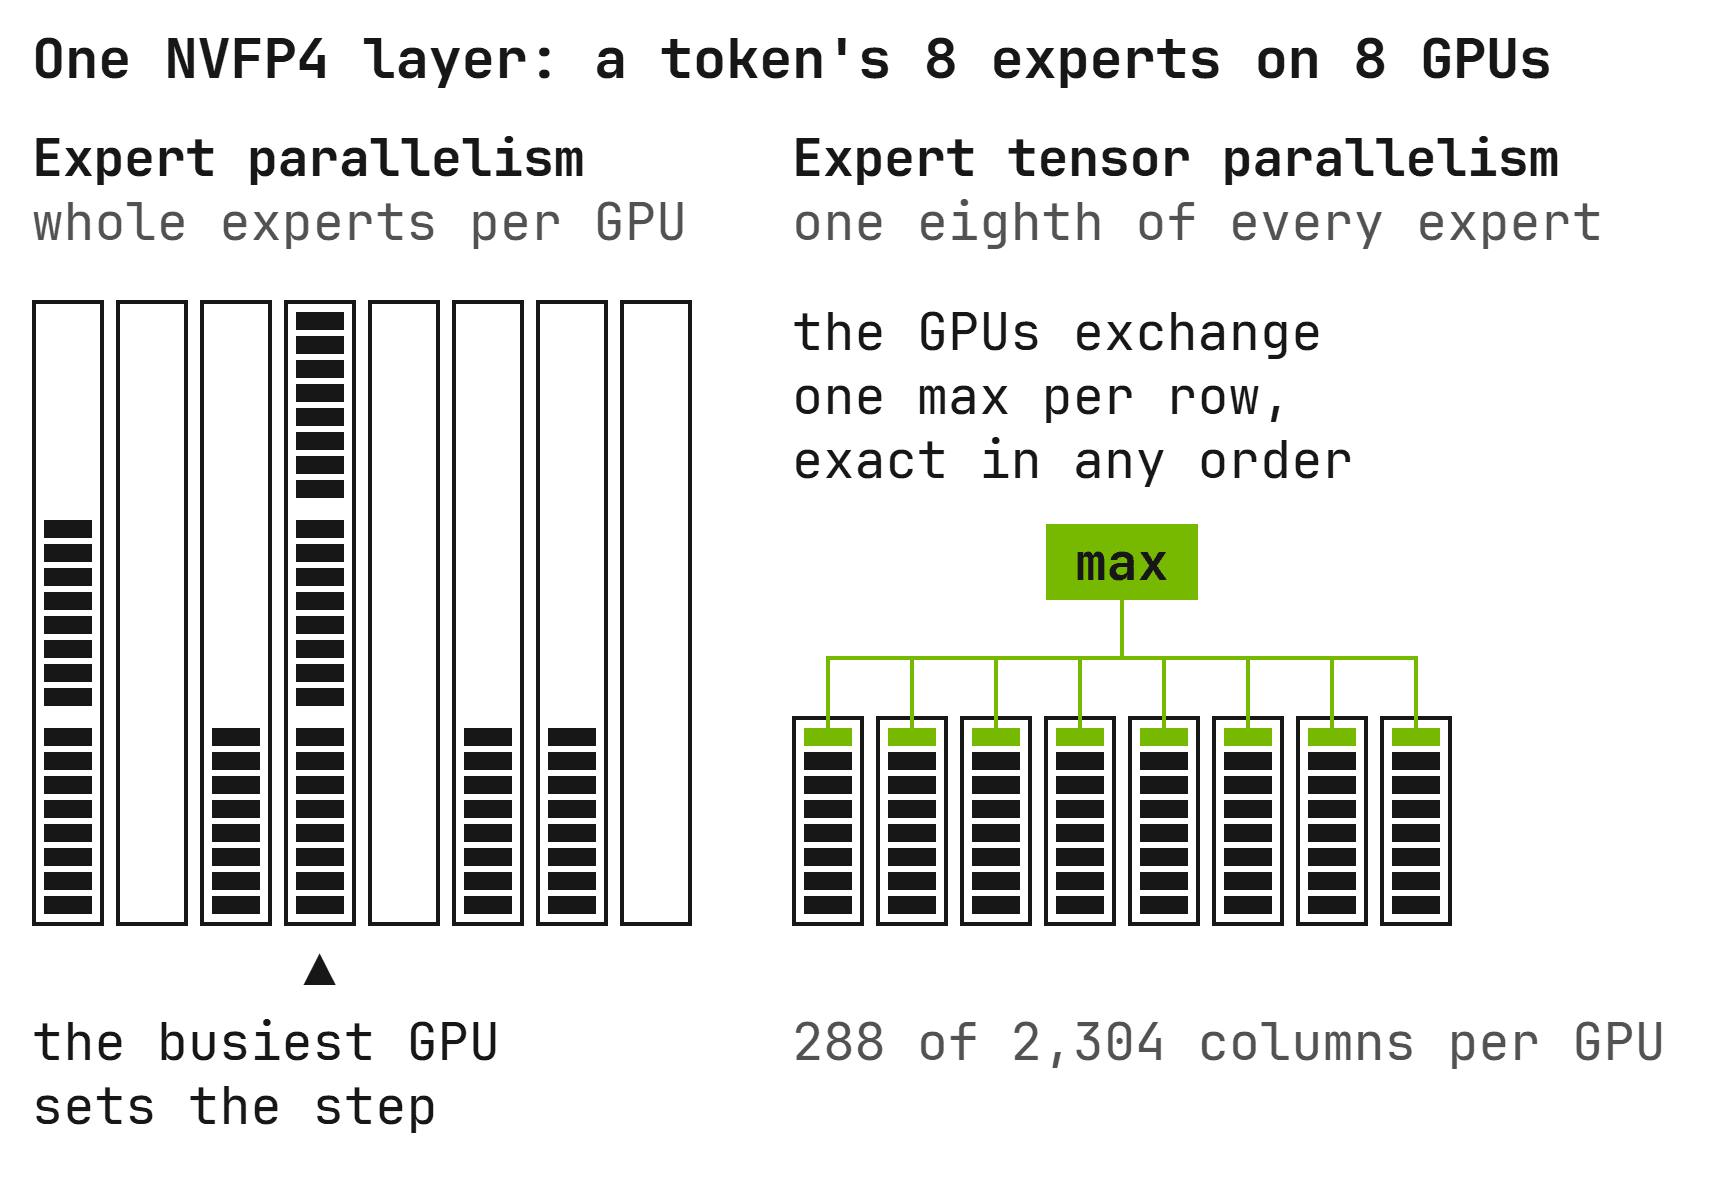
Cada GPU toma la mayor magnitud en sus propias 288 columnas de la fila, y cada GPU luego combina los 8 máximos que recibe con fmaxf, lo que da los mismos bits en cualquier orden; la línea del fma es el gemelo dependiente del orden que nuestra prueba de permutación debe detectar.
El intercambio da los mismos bits en los 8 órdenes de rango que probamos, con los 8 rangos emulados en un B300, y se detecta una combinación dependiente del orden.
Cada GPU lee una porción igual de cada experto activo, así que ninguna GPU lee más bytes de experto que las otras. El precio es un intercambio más por capa FP4.
Una segunda forma intercambia la propia activación en vez de su máximo, y divide w2 por filas de salida en vez de por K.
Cada GPU entonces cuantiza la fila completa por su cuenta, el all-reduce final de los parciales FP32 se convierte en un all-gather de porciones BF16, y cada GPU envía 3.2 veces menos bytes por capa FP4: 40 KB contra 129 KB con una fila, 0.32 MB contra 1.03 MB en un paso de verificación de 8 filas.
Redondea donde SGLang redondea, la salida de cada experto a BF16 antes de la suma, y muestra cero error contra un modelo FP64 de esos puntos de redondeo en la capa FP4 que probamos.
Kernel 2: la GEMM con escalas de bloque, reconstruida para un token
Ambos kernels ejecutan tcgen05.mma con los pesos como M, 128 filas por tile y los tokens pasados a N, con acumuladores FP32 y las escalas de bloque en la memoria de tensores.
En el kernel reconstruido un solo hilo alimenta el tensor core: en cada paso de K copia las escalas de bloque de los pesos y del token a TMEM con tcgen05.cp, y luego emite un tcgen05.mma con escalas de bloque cuyo predicado de acumulación está apagado en el primer paso de K del trozo, así que cada trozo parte de un acumulador FP32 en cero.
Con un token, la GEMM w13 en cada GPU mueve 11.9 MB de pesos y escalas FP4 por capa. Nuestro primer kernel daba a cada tile de experto un CTA y recorría K en etapas que nunca solapaba: 40 CTAs en 148 SMs, a 114 GB/s.
El kernel reconstruido reparte los trozos K fijos entre CTAs y solapa las cargas de todas las etapas con las MMAs. Cada trozo sigue siendo la misma cadena de MMAs con escalas de bloque en el mismo orden de K desde un acumulador en cero, y el último CTA en llegar combina los trozos en el mismo árbol fijo, así que toda salida conserva sus bits.
Cada CTA escribe los parciales FP32 de su trozo, emite un fence y toma un ticket; el último en llegar reinicia el contador para el siguiente replay del CUDA graph, lee cada trozo a través de L2 en orden de trozos y los suma en el mismo árbol fijo.
Microseconds per launch
- w13 · NVFP45.1xFirst kernel 104.4 microseconds, rebuilt 20.5.
- w13 · MXFP87.5xFirst kernel 184.3 microseconds, rebuilt 24.6.
- w2, first form · NVFP41.0xFirst kernel 14.3 microseconds, rebuilt 14.3.
- w2, first form · MXFP81.3xFirst kernel 20.5 microseconds, rebuilt 16.3.
- w2, second form · NVFP43.3xFirst kernel 55.8 microseconds, rebuilt 16.9.
- w2, second form · MXFP84.6xFirst kernel 88.0 microseconds, rebuilt 19.1.
w13, NVFP4, layer 0
- first kernel
- 104.4
- 114 GB/s
- rebuilt
- 20.5
- 583 GB/s
- weights
- 11.94 MB
- 8 experts
Con 8 tokens por paso y 40 expertos distintos por capa, la w13 reconstruida lee 1.39 TB/s en NVFP4 y 1.84 TB/s en MXFP8, contra los 6.85 TB/s que medimos para la memoria de un B300, así que este kernel aún tiene margen.
Contra el primer kernel, en las capas 0 y 40 con 1 a 64 filas y a lo largo de tres replays del CUDA graph, cada intermedio es igual bit a bit: 0 de 512 filas difieren.
Kernel 3: una mezcla de profundidad en una ronda
Inkling mezcla las salidas de capas anteriores antes de cada atención y de cada bloque de expertos: un softmax sobre hasta nueve salidas anteriores y luego una normalización. Hecha directamente, cada mezcla necesita dos reducciones en toda la GPU.
Guardamos la matriz de Gram de las salidas anteriores, calculada una vez cuando cada bloque cierra, así que la norma de la mezcla sale de esa matriz y de una columna nueva: una reducción en lugar de dos, 2 rondas por capa en lugar de 4, contadas.
La norma queda dentro de 1.6e-7 en términos relativos respecto de la directa en nuestras pruebas, con una suma compensada y un respaldo a la segunda ronda directa para toda fila donde la cancelación pudiera superar el umbral.
Plegar el router de expertos en la misma reducción cambió los 8 expertos principales en el 1.1% y el 1.6% de los tokens en los routers reales de las capas 0 y 40, así que se queda fuera: un cambio que mueve el enrutamiento no es un cambio sin pérdida.
Qué tan cerca de vLLM
El modelo completo en 8 GPUs, con teacher forcing sobre las propias continuaciones de vLLM de 4 prompts, contra las log-probabilidades de vLLM en 595 posiciones. vLLM ejecutado dos veces coincide consigo mismo exactamente, así que cada diferencia de abajo es entre la aritmética de los dos motores, no ruido.
Distance from vLLM, nats
- mean
- 0.0249
- median
- 0.0016
- p95
- 0.1285
- max
- 0.7269
- vLLM run twice
- 0.0000
En qué se va el paso hoy
Nuestro motor todavía ejecuta un paso de decodificación como lanzamientos separados bajo CUDA graphs: unos 16 ms por paso con una fila sin el borrador, en 8 GPUs B300. El mayor costo es la GEMM de expertos de nuestro primer kernel, que el kernel reconstruido reduce unas cinco veces de forma aislada pero que aún no está en el motor.
Kernel time per step, one GPU, ms
16.76 in all
- Expert GEMMs5.94
- Exchanges and waits4.93
- Depth mix and conv2.45
- Attention1.39
- Router and work list0.88
- Dense BF16 GEMMs0.63
- Quantize and combine0.48
- Embed and sample0.03
Expert GEMMs35.4%
- 4.03w13 GEMM, NVFP4expert_gemm_tc05_kernel<0,1,4,0>
- 1.42w13 GEMM, MXFP8expert_gemm_tc05_kernel<1,1,4,0>
- 0.36w2 GEMM, NVFP4expert_gemm_tc05_kernel<0,1,1,1>
- 0.12w2 GEMM, MXFP8expert_gemm_tc05_kernel<1,1,1,1>
La siguiente pieza es un programa de decodificación persistente por GPU: cada capa en un kernel residente, con los intercambios dentro de él.
Nuestro presupuesto de bytes y latencia para un paso de verificación da unos 7.8 GB por GPU en 154 intercambios, con el propio borrador especulativo de Inkling a 3.35 tokens por paso y un supuesto de 45 expertos distintos por capa, algo que aún no hemos medido.
Con ese presupuesto el programa apunta a unos 1,900 tokens por segundo por usuario, una proyección con un rango de unos 1,630 a 2,160. Como referencia de escala, vLLM con el mismo borrador corre este modelo a 666 tokens por segundo por usuario en nuestro propio nodo de 8 B300. El siguiente artículo reporta nuestro número medido, bit a bit.
Las configuraciones
El código fuente completo, las baterías de pruebas y el runner en la nube que produjo cada resultado están en github.com/RightNow-AI/inkling-b300-kernels, bajo la licencia Apache 2.0.
Cada kernel se compila para la arquitectura objetivo específica del B300, con la contracción desactivada:
El modelo completo en 8 GPUs, con teacher forcing a 64 filas por paso y a 1, y la línea de velocidad:
La referencia:
Condiciones
Nuestro motor y la referencia vLLM corrieron en un nodo de la nube de 8 GPUs NVIDIA B300 SXM6, driver 620.70.06, con acceso peer to peer entre las 8 GPUs; las baterías de pruebas de kernels y los tiempos de GEMM corrieron en una de sus GPUs.
Checkpoint thinkingmachines/Inkling-2-Small en la revisión 885d78bf. Referencia: imagen nightly de vLLM sha256:c17e9d88. La velocidad de vLLM con el borrador (2026-11-21) y el ancho de banda de memoria de 6.85 TB/s (2026-11-20) se midieron en nuestro propio nodo de 8 B300; todo lo demás se midió el 2026-11-21.