Kernels de GPU, CUDA y escalado. Notas de producto del laboratorio.
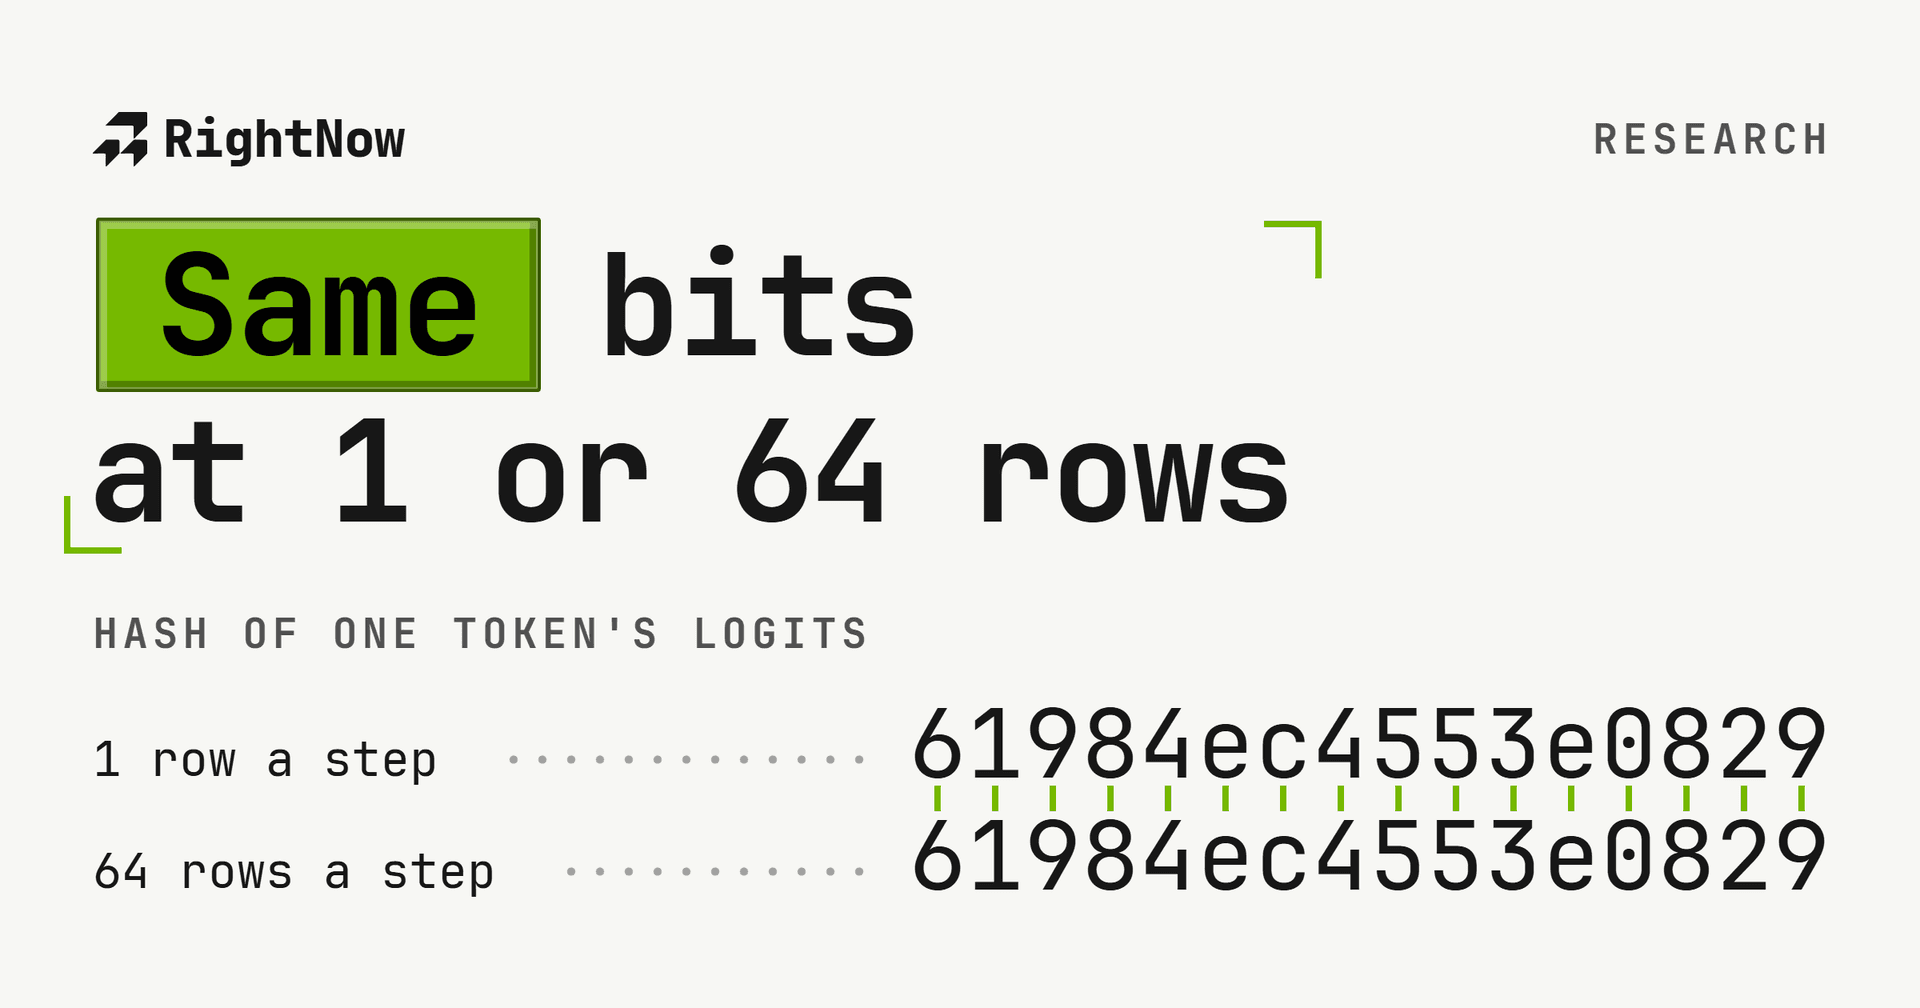
Kernels de código abierto para el modelo Inkling de Thinking Machines en NVIDIA B300: NVFP4 nativo, logits idénticos con 1 o 64 filas por paso.
De Jaber Jaber
RightNow es nuestro primer modelo de decisiones.
De RightNow AI
SGLang de serie sirvió gpt-oss-120b a 411 tokens por segundo en una B200 alquilada. Cuatro ajustes llevaron la misma tarjeta y los mismos pesos a 1,366, y los prompts individuales a 2,215. Ningún kernel escrito, nada recompilado.
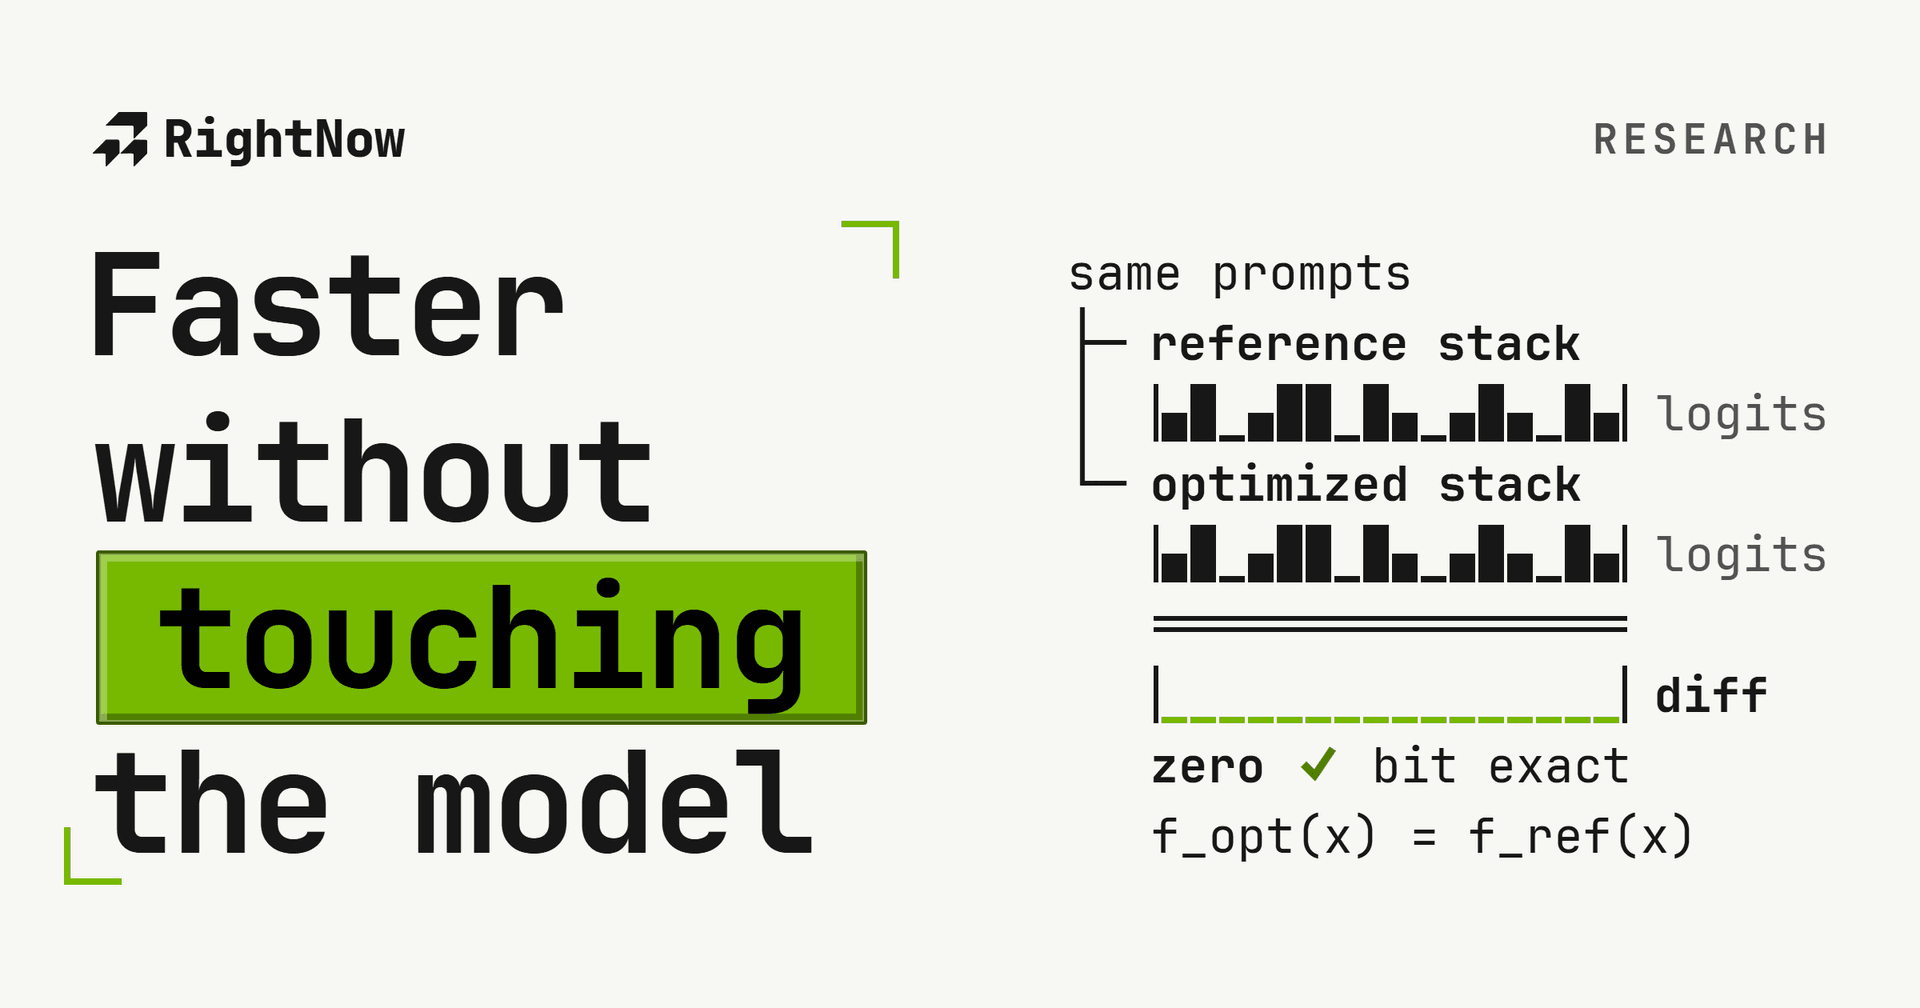
Cómo acelerar el serving de LLM sin tocar el modelo. Kernels exactos, decodificación especulativa, compresión sin pérdida, reutilización de KV y planificación, con las matemáticas y cómo verificarlo con paridad de logits.
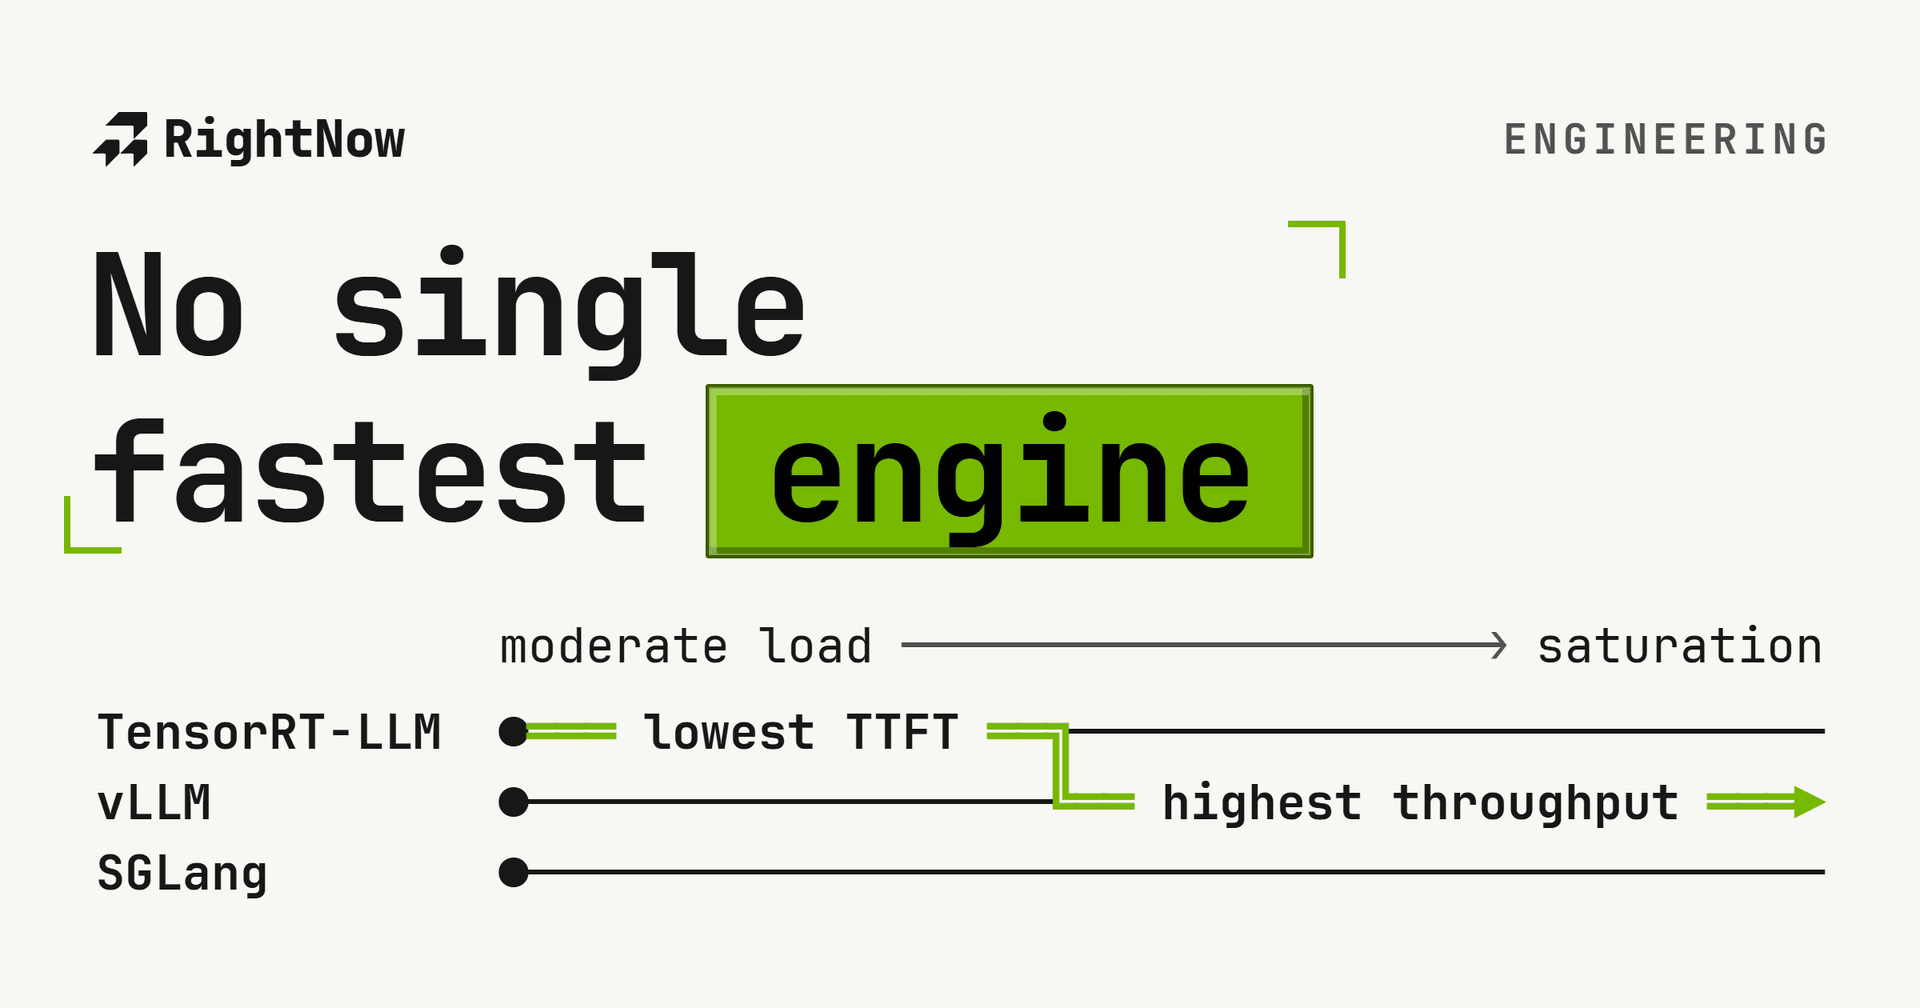
Resultados propios de Llama-3.1-8B para tres motores de inferencia de LLM. Las filas publicadas de throughput con prompts únicos y de latencia cubren H100 bf16. FP8 y L40S aparecen solo en resultados derivados de costo. El harness y los datos crudos no están disponibles públicamente.
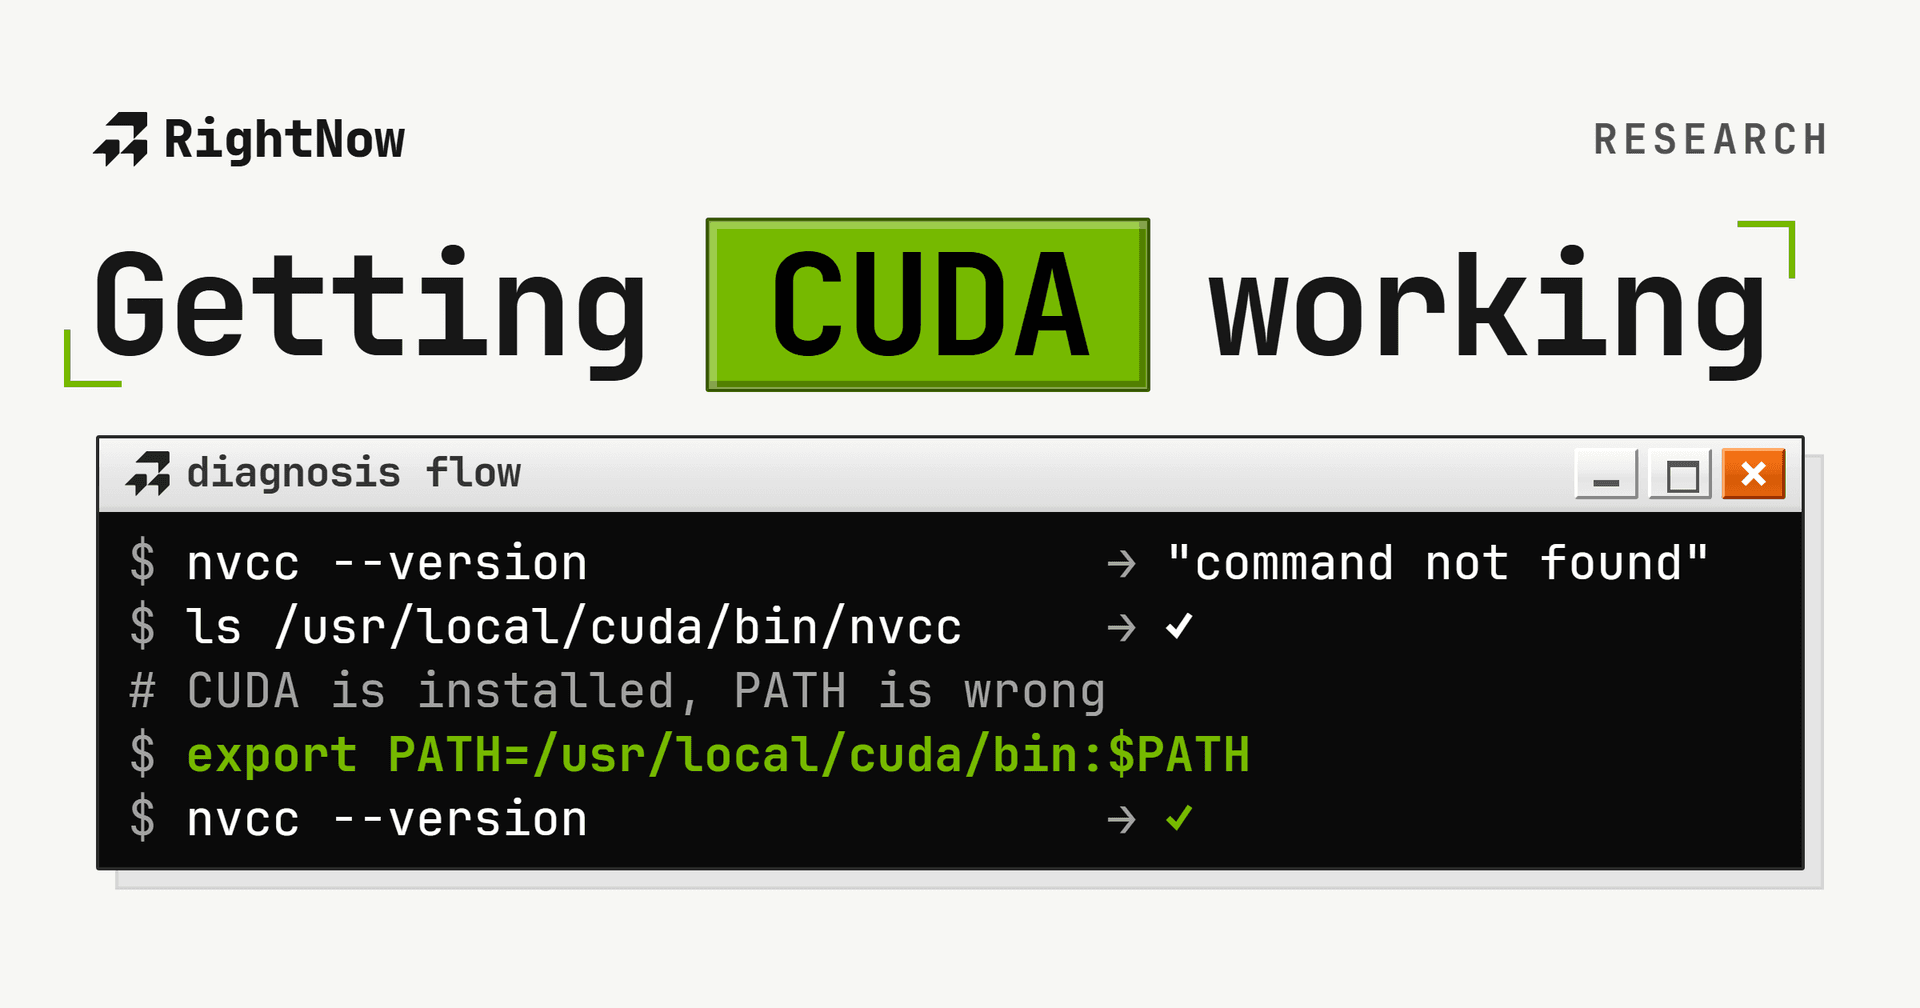
Que CUDA funcione no debería tomar días. Tras analizar cientos de instalaciones fallidas, he reunido todas las correcciones que necesitas para errores de PATH, drivers que no coinciden, problemas de WSL2 y más. Deja de pelear con nvcc y empieza a programar.
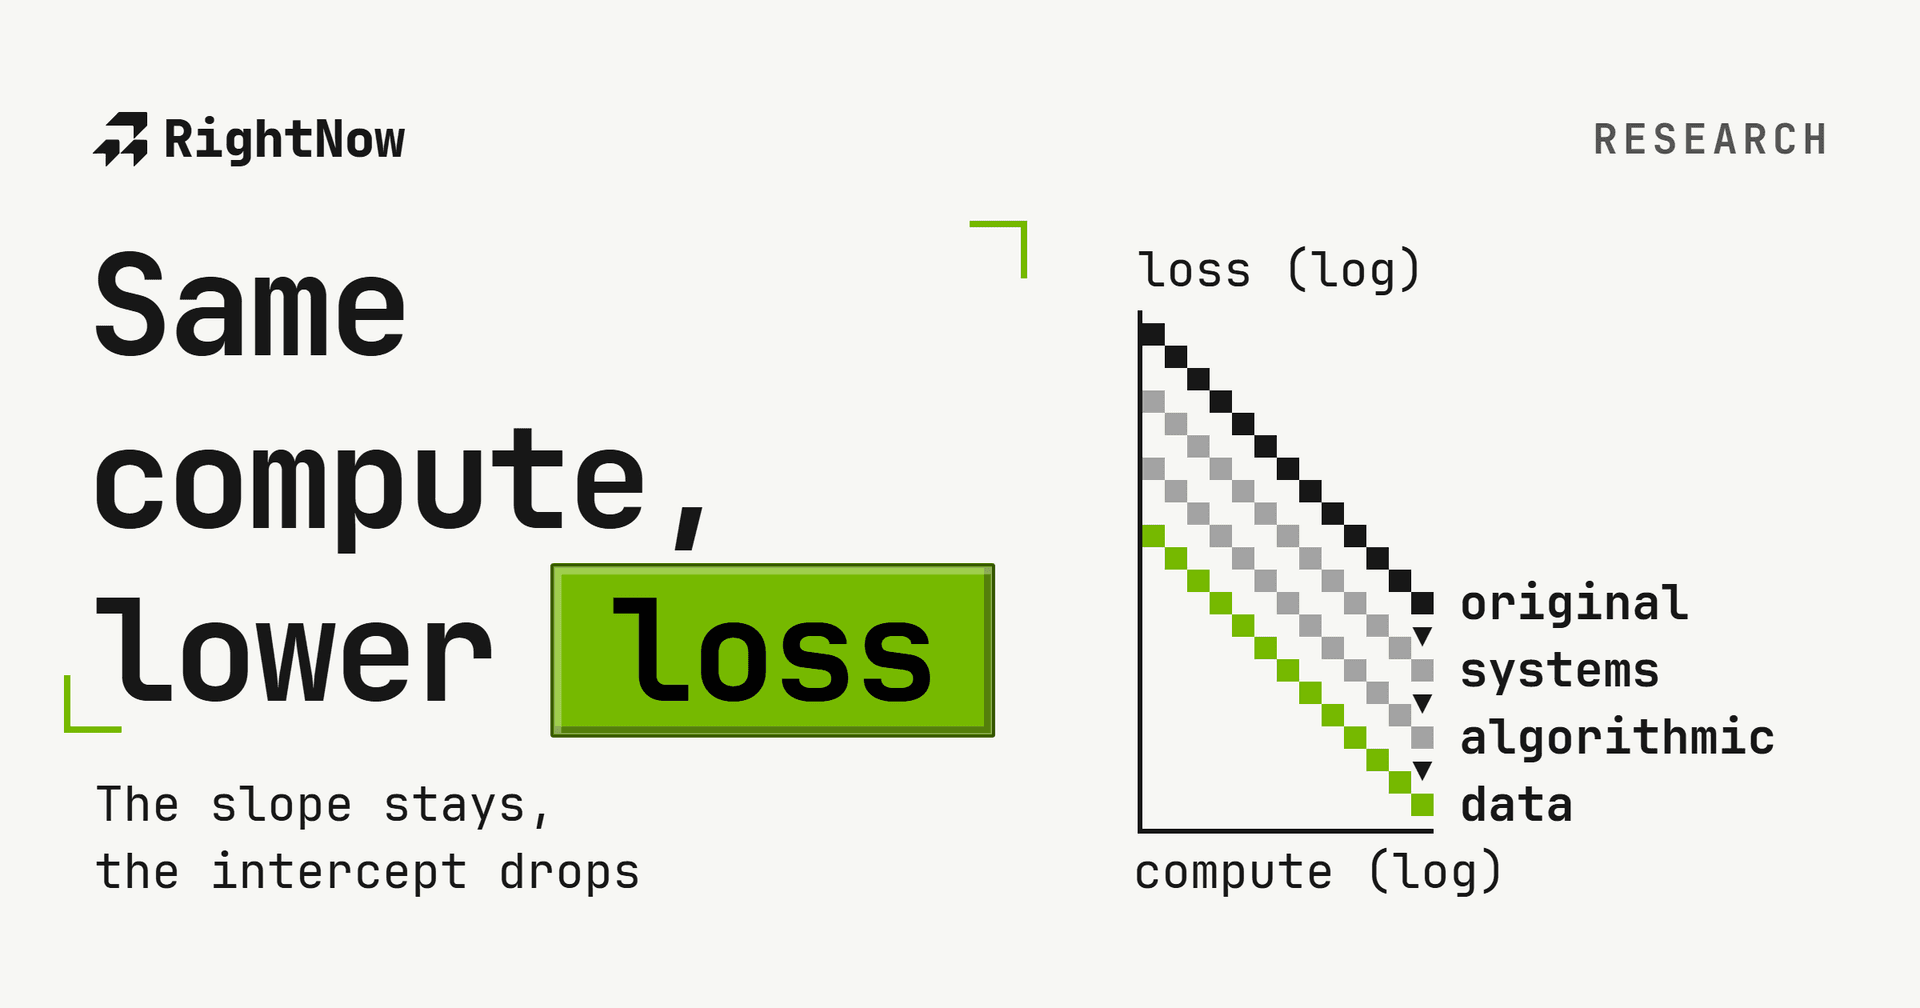
Cuando los investigadores grafican la pérdida de entropía cruzada del modelo contra el cómputo en escala log-log, el resultado es una línea casi recta: la pérdida cae de forma predecible a medida que aumentan el cómputo, el tamaño del modelo o los tokens de entrenamiento. Esa regularidad empírica (la ley de escalado) permite a los equipos pronosticar rendimientos, pero también muestra el límite: comprar más GPUs da rendimientos marginales decrecientes.
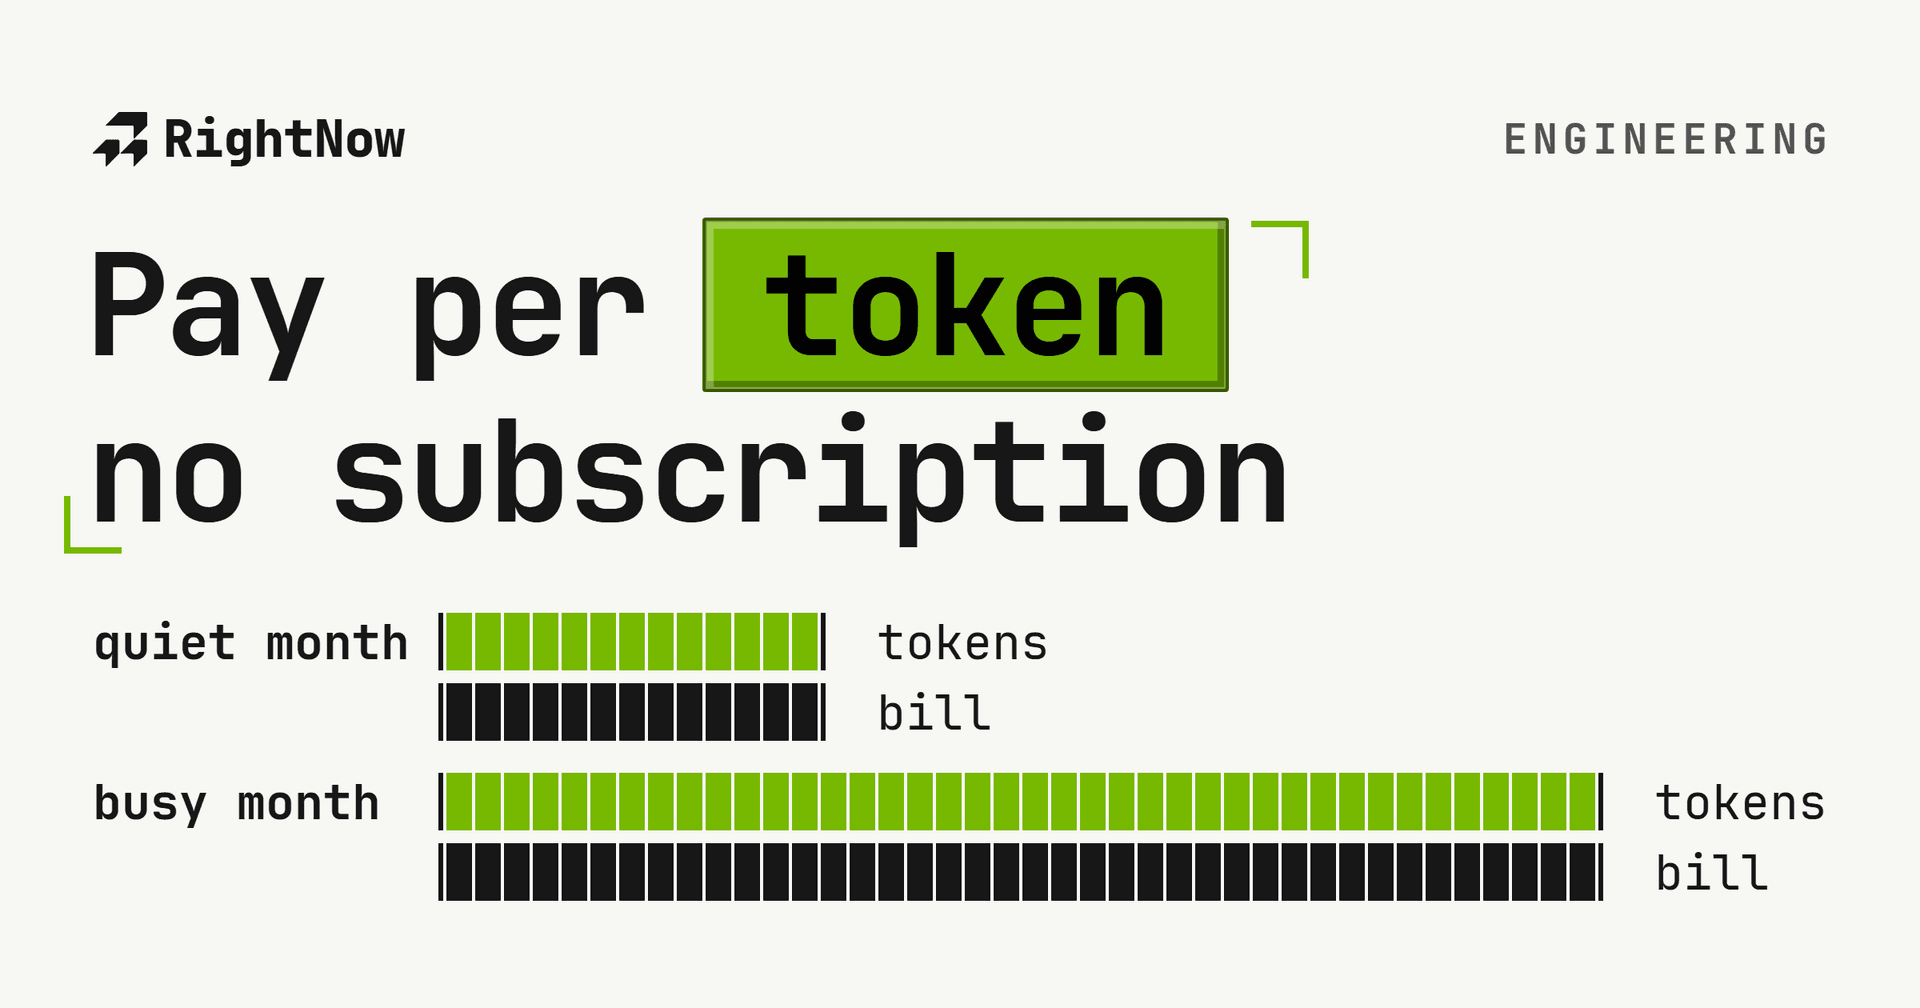
Llama a los modelos abiertos con una clave de workspace por dos protocolos y paga por token desde un solo saldo, sin suscripción.
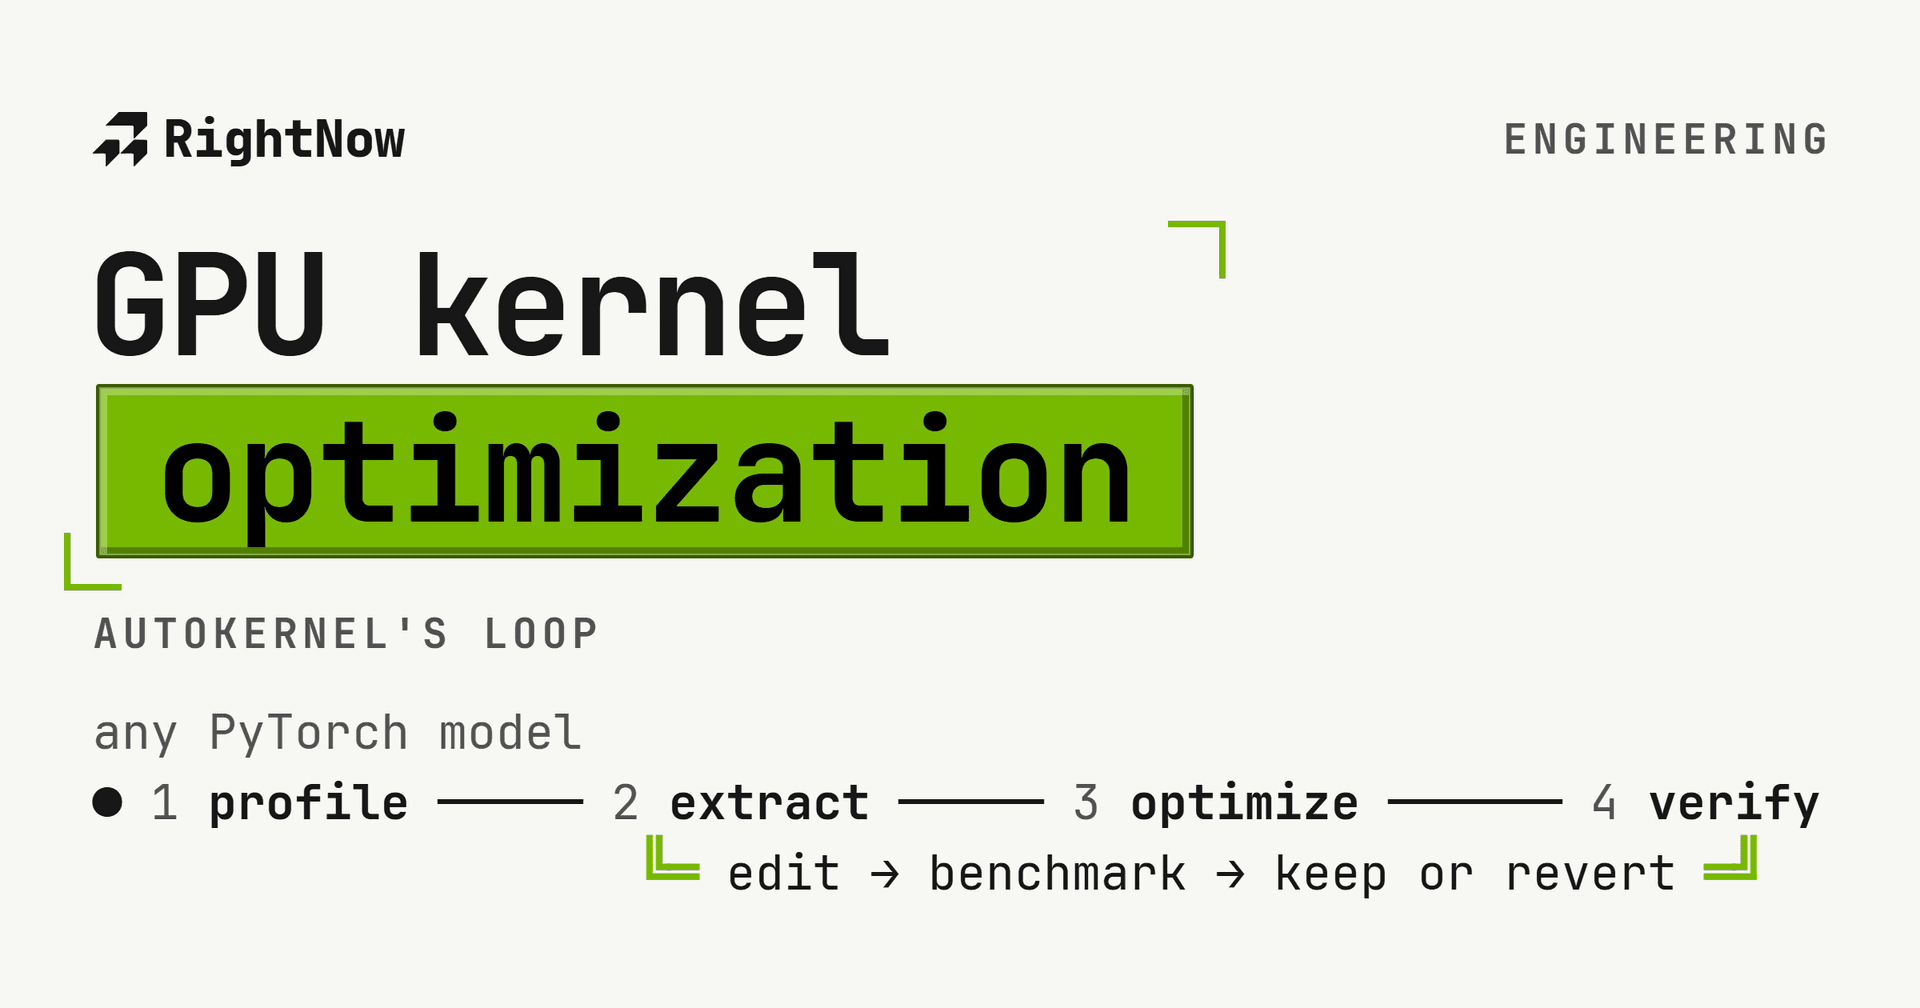
AutoKernel, la herramienta de código abierto de RightNow AI para optimización de kernels de GPU, perfila modelos de PyTorch, prueba variantes de Triton y sigue los cuellos de botella medidos.
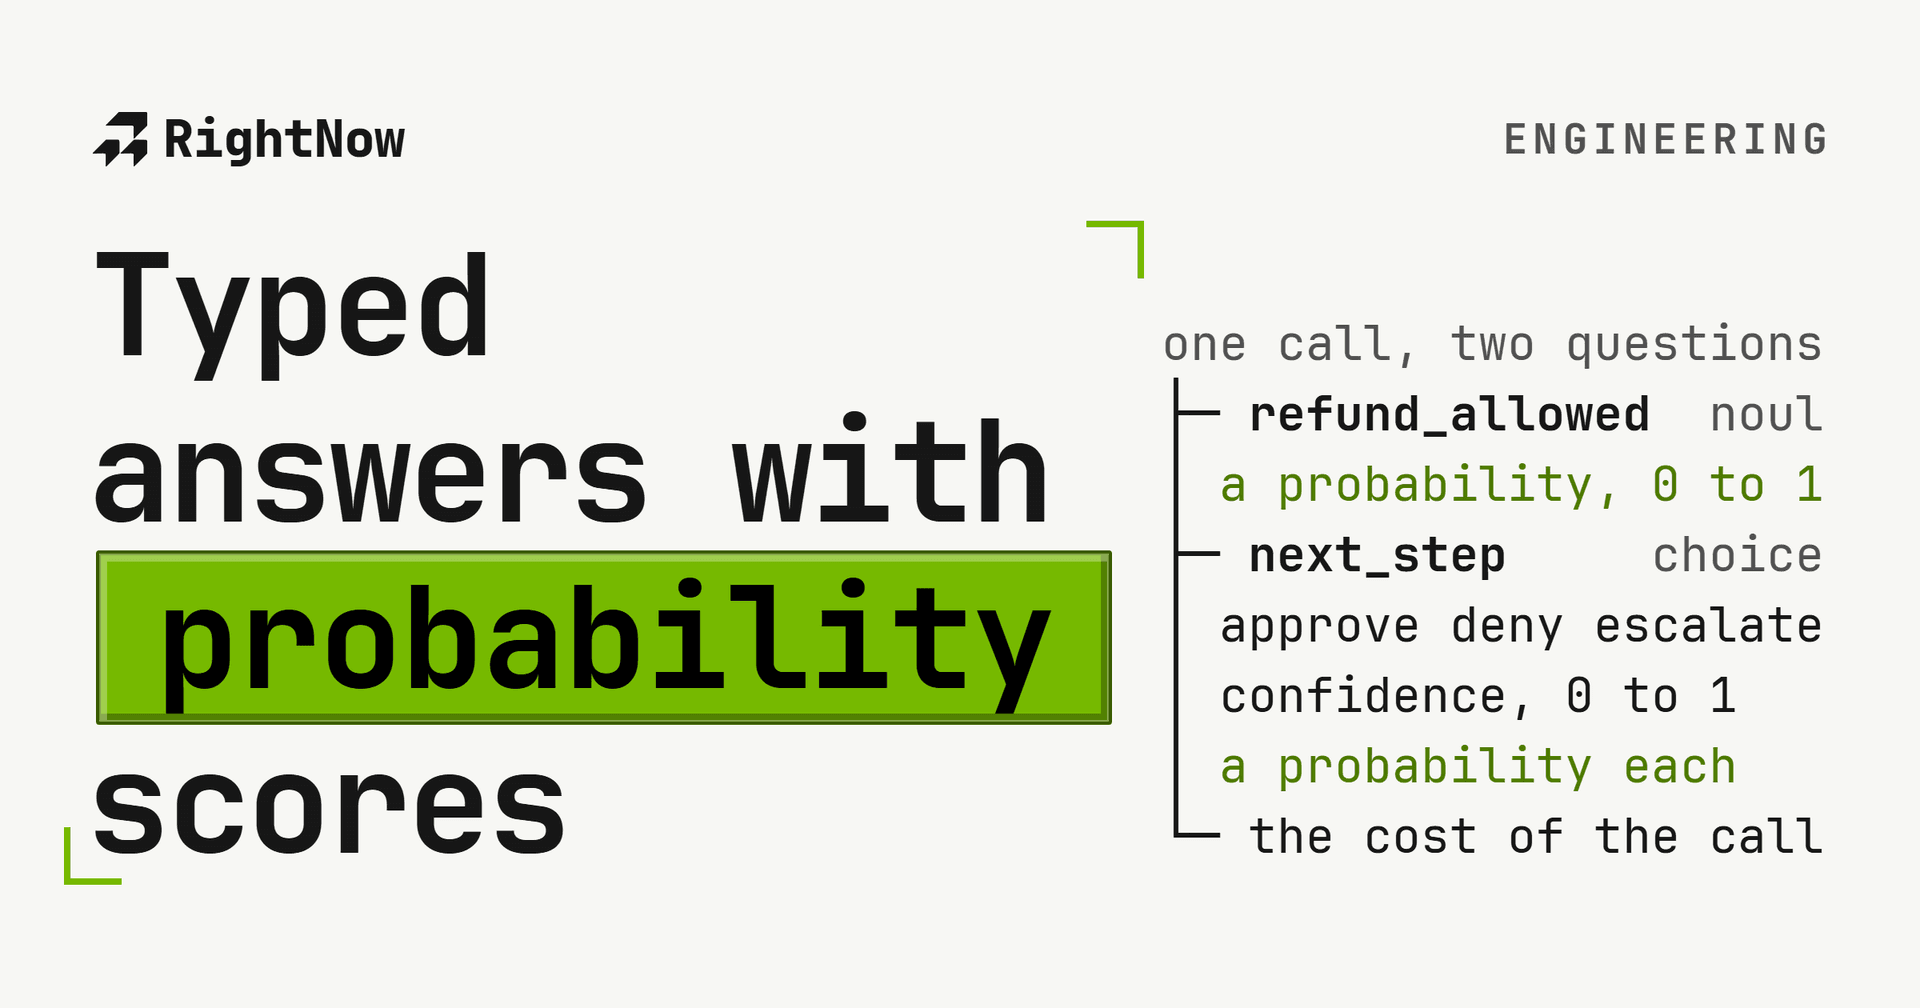
El RightNow decision model toma decisiones estructuradas: envía un estado y preguntas con nombre, luego lee probabilidades, confianza y respuestas tipadas.
La API de modelos abiertos de RightNow cobra por token a precios de lista, sin suscripción ni cargos por usuario, y Batch corre a mitad de precio de lista.