
Con software solo, una B200 supera a la LPU y se acerca a Cerebras
, 16 min de lectura, By Jaber Jaber
IngenieríaNota editorial: Este artículo se publicó primero en nuestro sitio anterior. El producto de optimización descrito aquí está retirado. RightNow sirve modelos abiertos a través de su API.
Corrección, 9 de agosto de 2026
Artificial Analysis cambió sus medianas de proveedores después de que este artículo se publicara el 6 de agosto. El 6 de agosto los puntos de comparación usados aquí decían Cerebras 1,991 tok/s, SambaNova 708, Groq 476, Google Vertex 423, Databricks 324, Azure 300, Amazon 101 y CoreWeave 33. El 9 de agosto la fuente dice Cerebras 1,891, SambaNova 706, Groq 477, Google Vertex 391, Azure 312, Baseten 195, Amazon 86 y CoreWeave 36; Databricks no tiene velocidad reportada en la tabla actual. La prosa y las tablas de abajo usan los valores del 9 de agosto. Las imágenes originales de la tabla del 6 de agosto siguen visibles como instantáneas fechadas de la publicación.
Todos los años alguien publica nuevo silicio diseñado para inferencia. Cerebras puso los pesos en una oblea, Groq construyó la LPU, SambaNova construyó la RDU, y las tres son máquinas reales que mueven tokens rápido. Me gusta que esto esté pasando. La inferencia merece que se diseñe hardware para ella.
Pasé los últimos dos años estudiando la arquitectura de GPU de NVIDIA y AMD para construir un editor de código para kernels de GPU. Leer esos manuales todo el día te enseña lo que una tarjeta puede hacer, y luego miras lo que la gente obtiene de la misma tarjeta y los dos números no coinciden. Así que dejé de intentar escribir cada kernel a mano y empecé a construir agentes que los escriben. Publiqué como código abierto AutoKernel, que genera y afina kernels de GPU, pequeño y legible para que puedas seguir lo que hace. Después AutoMegaKernel, que fusiona un paso completo de decodificación en kernels persistentes para que los intermedios nunca salgan del chip. Todo es para lo mismo: lograr que los modelos corran bien en las tarjetas que la gente ya tiene.
Por eso las tablas de clasificación me molestan. Cuando la tabla decía 423 tokens de GPU por segundo el 6 de agosto para un modelo cuyo presupuesto de bytes podía resolver en papel, mi primer pensamiento no fue que la GPU era lenta. Mi primer pensamiento fue que nadie escribió el software. Así que decidí comprobar si podía cerrar esa brecha en una sola B200 sin tocar más que el software.
Al 9 de agosto, Artificial Analysis lista a Cerebras en 1,891 tokens por segundo. El proveedor de GPU más rápido listado es Google Vertex con 391, luego Azure con 312 y Baseten con 195. Eso pone a Cerebras 4.8x adelante de la GPU listada más rápida, cerca de la ventaja de 5x de la comparación publicada por Cerebras (cerebras.ai/blog/blackwell-vs-cerebras).
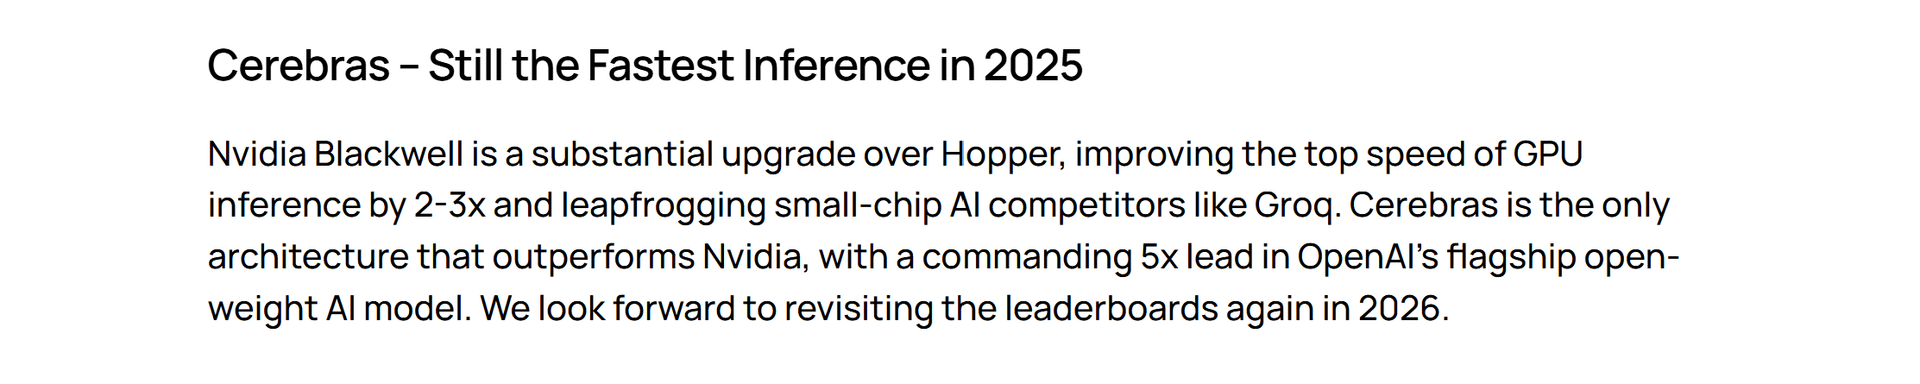
El 1,891 es una respuesta de hardware y una buena. Mantienen los pesos en SRAM en lugar de HBM, así que el cuello de botella con el que el resto de nosotros pelea no existe en su máquina. No voy a discutir eso y no lo superé.
La tabla decía 423 cuando ejecuté la comparación y dice 391 al 9 de agosto. Ese punto de referencia de GPU es el número que perseguí. Alquilé una sola B200 en Modal, que es lo que uso cuando quiero una GPU sin pensarlo, y empecé a medir. De fábrica obtuve 411 tokens por segundo. Cambié cuatro ajustes y la misma tarjeta con los mismos pesos me dio 1,366, y los prompts individuales llegaron a 2,215. No escribí un kernel y no recompilé nada.
| Métrica | Valor | Detalle |
|---|---|---|
| SGLang de fábrica | 411 tok/s | 26 por ciento del ancho de banda de memoria de esta tarjeta |
| Tras cuatro ajustes | 1,366 tok/s | 72 por ciento, y 3.5x el proveedor de GPU más rápido |
| Mejor prompt individual | 2,215 tok/s | por encima de Cerebras, en una tarjeta alquilable |
Eso es 3.5x sobre el proveedor de GPU más rápido en la tabla actual. Supera a Groq en 477 y a SambaNova en 706, y pone una tarjeta alquilada en el 72 por ciento de la oblea.
La abstracción te miente, y no miente sobre el hardware
Cada capa entre tú y el chip está para impedirte pensar en el chip, y funciona. Llamas a generate, salen tokens a cierta tasa, y esa tasa se siente como la velocidad de la máquina. No lo es. Es la velocidad de los valores predeterminados que te tocó llamar.
Por eso la gente culpa al hardware cuando algo es lento, y por qué casi siempre se equivoca. El framework no puede decirte que él es lo que te frena. No lanza ningún error, todo se ve bien, y el número que te da es estable y repetible, así que se siente como física cuando es un archivo de configuración.
La única salida es resolver por tu cuenta lo que la tarjeta puede hacer, desde bytes y ancho de banda, y comparar. Ese número no se preocupa por el framework que uses.
Para gpt-oss-120b en una B200 la aritmética es corta. Decodificar un token lee cada peso activo exactamente una vez, que son 1.91 GB de atención en bf16, 1.90 GB de expertos enrutados top-4 en mxfp4 y 1.16 GB de lm_head en bf16, así que 4.97 GB por token. Una B200 tiene 8 TB/s de HBM3e (nvidia.com/en-us/data-center/dgx-b200), así que el piso es 0.621 milisegundos por token y el techo es aproximadamente 1,610 tokens por segundo.
SGLang de fábrica tomó 2.43 milisegundos por token. El setenta y cuatro por ciento de cada token no fue leer pesos.
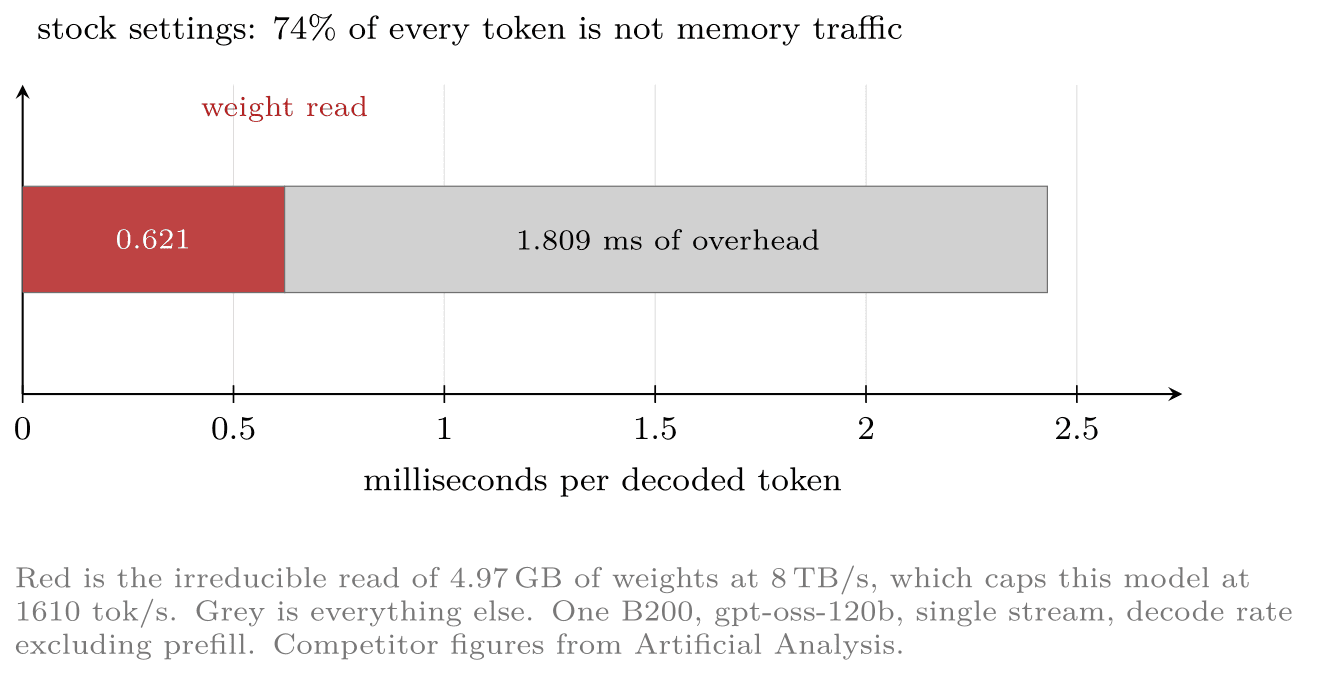
El chip estuvo inactivo tres cuartas partes del tiempo. Cada instinto que dice compra la tarjeta más rápida apunta al 26 por ciento que ya funcionaba.
Qué medí, y cómo
Ejecuté todo en una sola B200 en Modal con 178.4 GiB de HBM3e y 148 SMs. El modelo es openai/gpt-oss-120b, que se publica nativamente en MXFP4 y activa unos 5.1B de sus 120B parámetros por token. Sirviendo con SGLang 0.5.16, greedy a temperatura cero, flujo único, un prompt a la vez, cuatro prompts fijos, tres repeticiones, mediana.
El número reportado es la tasa de decodificación excluyendo el prefill, que es como Artificial Analysis define Output Speed, el número promedio de tokens recibidos por segundo después del primer token recibido (artificialanalysis.ai/methodology). Elegí este modelo porque los tres fabricantes de ASIC publican con él, así que la comparación es los mismos pesos y la misma métrica.
| Proveedor | tok/s | Silicio |
|---|---|---|
| Cerebras | 1,891 | oblea |
| SambaNova | 706 | RDU |
| Groq | 477 | LPU |
| Google Vertex | 391 | GPU |
| Azure | 312 | GPU |
| Baseten | 195 | GPU |
| Amazon | 86 | GPU |
| CoreWeave | 36 | GPU |
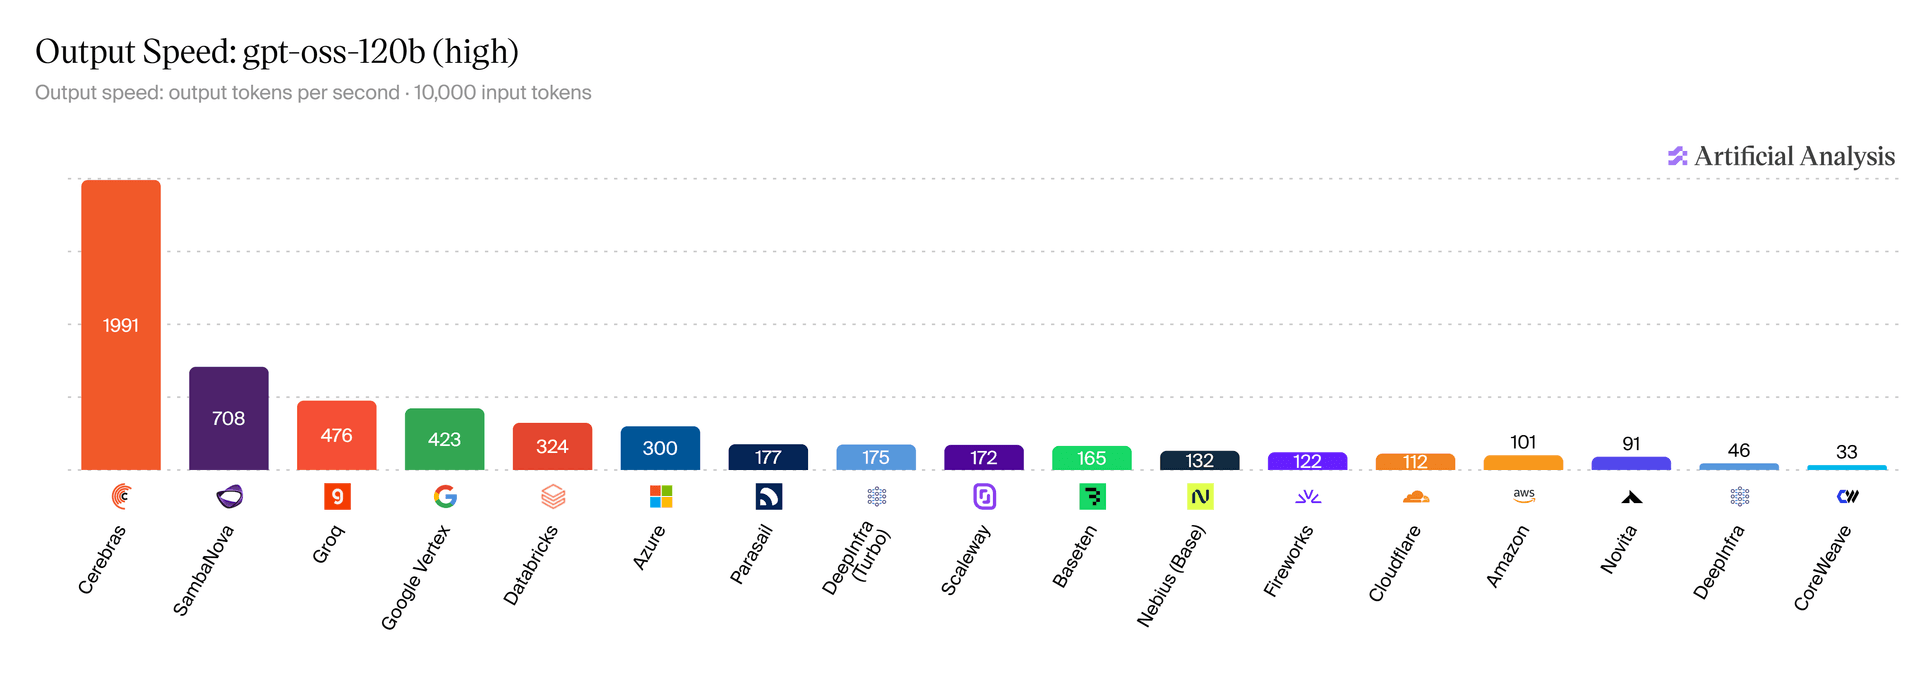
Mira las mediciones de GPU listadas en la tabla actual. Quedan a 10.8x de distancia, desde Google Vertex en 391 hasta CoreWeave en 36, con los mismos pesos abiertos y la misma métrica. La tabla pública no aísla la generación de GPU de los ajustes, los kernels ni el código de serving, así que esto es evidencia de que la pila entregada importa, no una estimación limpia de 10.8x solo de software.
La escalera
| Paso | tok/s |
|---|---|
| valores de fábrica | 411.2 |
| perillas de latencia | 429.9 |
| decodificación especulativa n-gram | 628.5 |
| speculative_attention_mode=decode | 697.1 |
| búsqueda n-gram amplia | 1,165.1 y 1,366.2 |
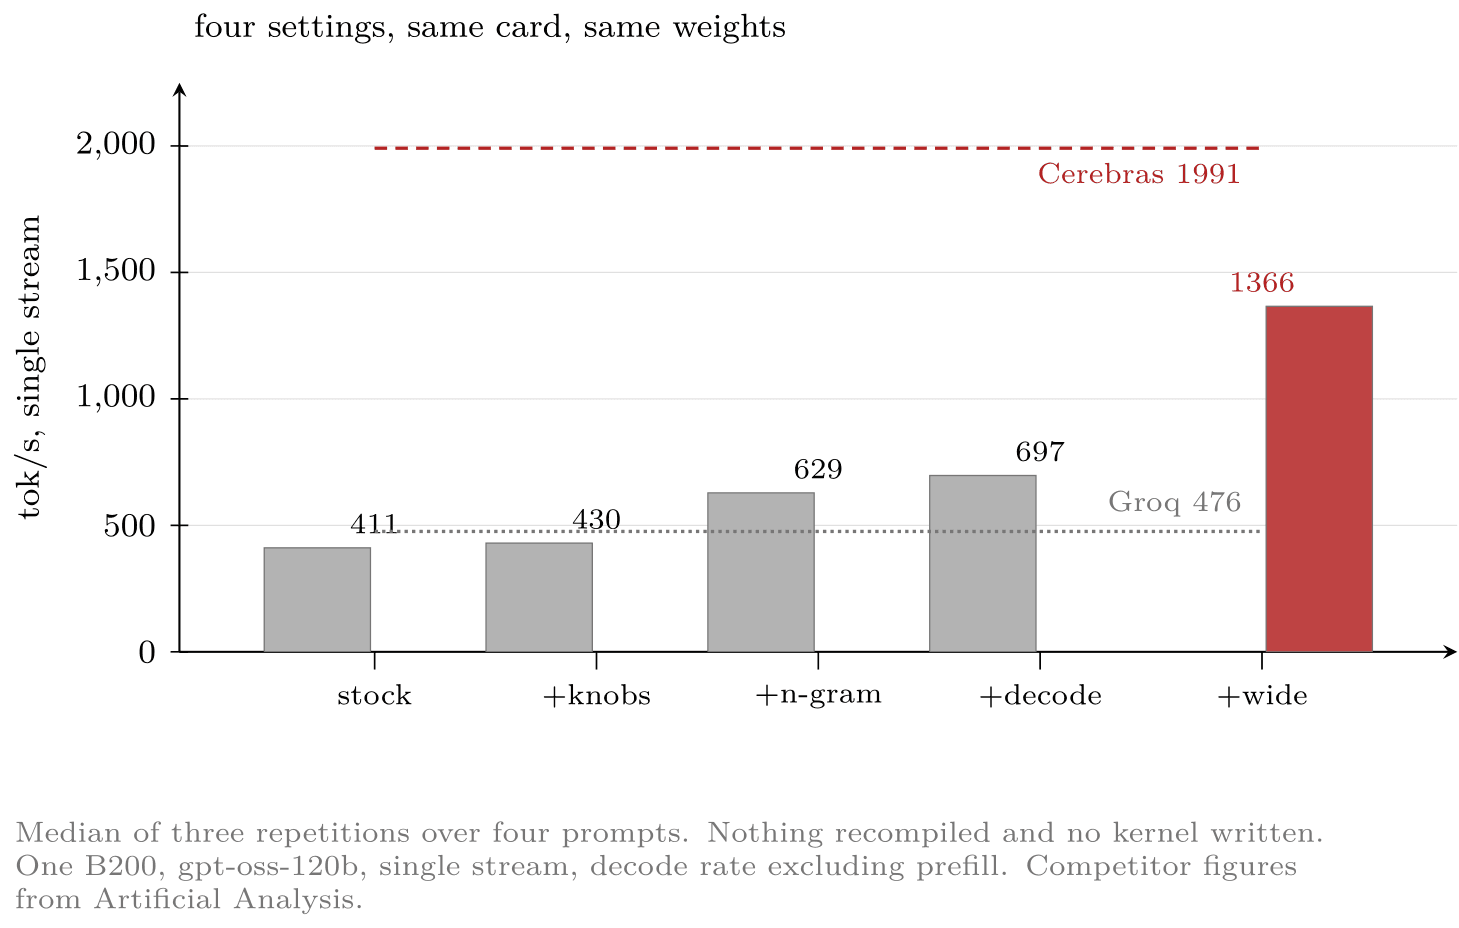
El primer peldaño es pequeño. SGLang trae stream_interval en 1 por defecto, así que destokeniza y despacha en cada token, y scheduler_recv_interval en 1, así que sondea en cada iteración. En un presupuesto de 0.621 milisegundos eso es dinero real, y arreglarlo compró 4.5 por ciento.
El segundo peldaño es la decodificación especulativa, el mismo truco que le dio a Groq sus seis veces. Un borrador propone varios tokens, el objetivo los verifica en una pasada hacia adelante, y cada token aceptado es un token producido sin una lectura separada de 4.97 GB de pesos. No pude usar una cabeza de borrador entrenada, por razones en la sección de fallos, así que esto es especulación n-gram, que borra coincidiendo patrones en el texto generado hasta el momento.
El tercer peldaño fue un flag que nunca había tocado. speculative_attention_mode viene en prefill por defecto, y ponerlo en decode dio 9.7 por ciento.
La última fila son dos números porque ejecuté esa configuración dos veces y obtuve ambos, una brecha del 17 por ciento con ajustes idénticos. La aceptación n-gram depende de lo que haya construido el trie, así que la misma configuración aterriza en un lugar distinto en cada corrida. Si citara el mejor estaría escogiendo un número, no midiéndolo.
El peldaño que importaba se encontró rompiéndolo
Me dijeron, con razón, que el proponente n-gram de CPU se serializaba con la GPU y que su costo de búsqueda era el cuello de botella. Así que lo reduje, max_bfs_breadth de 10 a 2 y max_trie_depth de 18 a 8, esperando que la sobrecarga cayera.
El throughput colapsó a 433.0.
El fallo valió más que una pequeña victoria
Dice que la búsqueda no es sobrecarga, es lo que gana los tokens. Cada candidato extra que el proponente explora es una oportunidad de aceptar otro token, y cada token aceptado evita una lectura completa de 4.97 GB. Gastar unos cientos de microsegundos de CPU para evitar 0.621 milisegundos de tráfico HBM es un intercambio que conviene hacer constantemente.
Así que giré la perilla en el otro sentido, y la curva tiene un pico agudo.
| max_bfs_breadth | tok/s |
|---|---|
| 2 | 433.0 |
| 10, el valor por defecto | 697.1 |
| 24 | 1,165.1 |
| 32 | 1,110.4 |
| 48 | 341.1 |
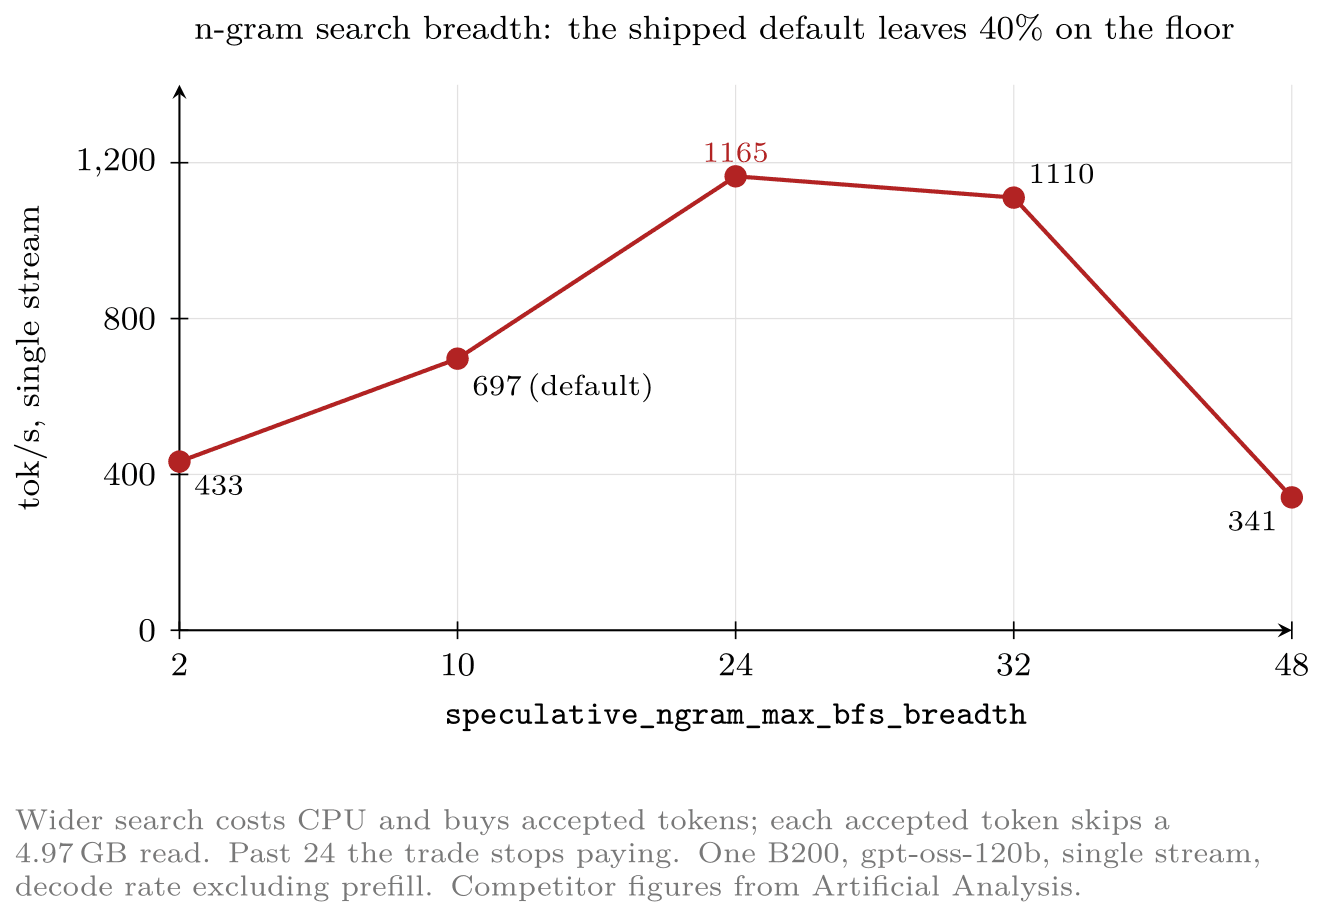
El valor publicado por defecto es 10, y puedes leerlo directamente en la documentación.
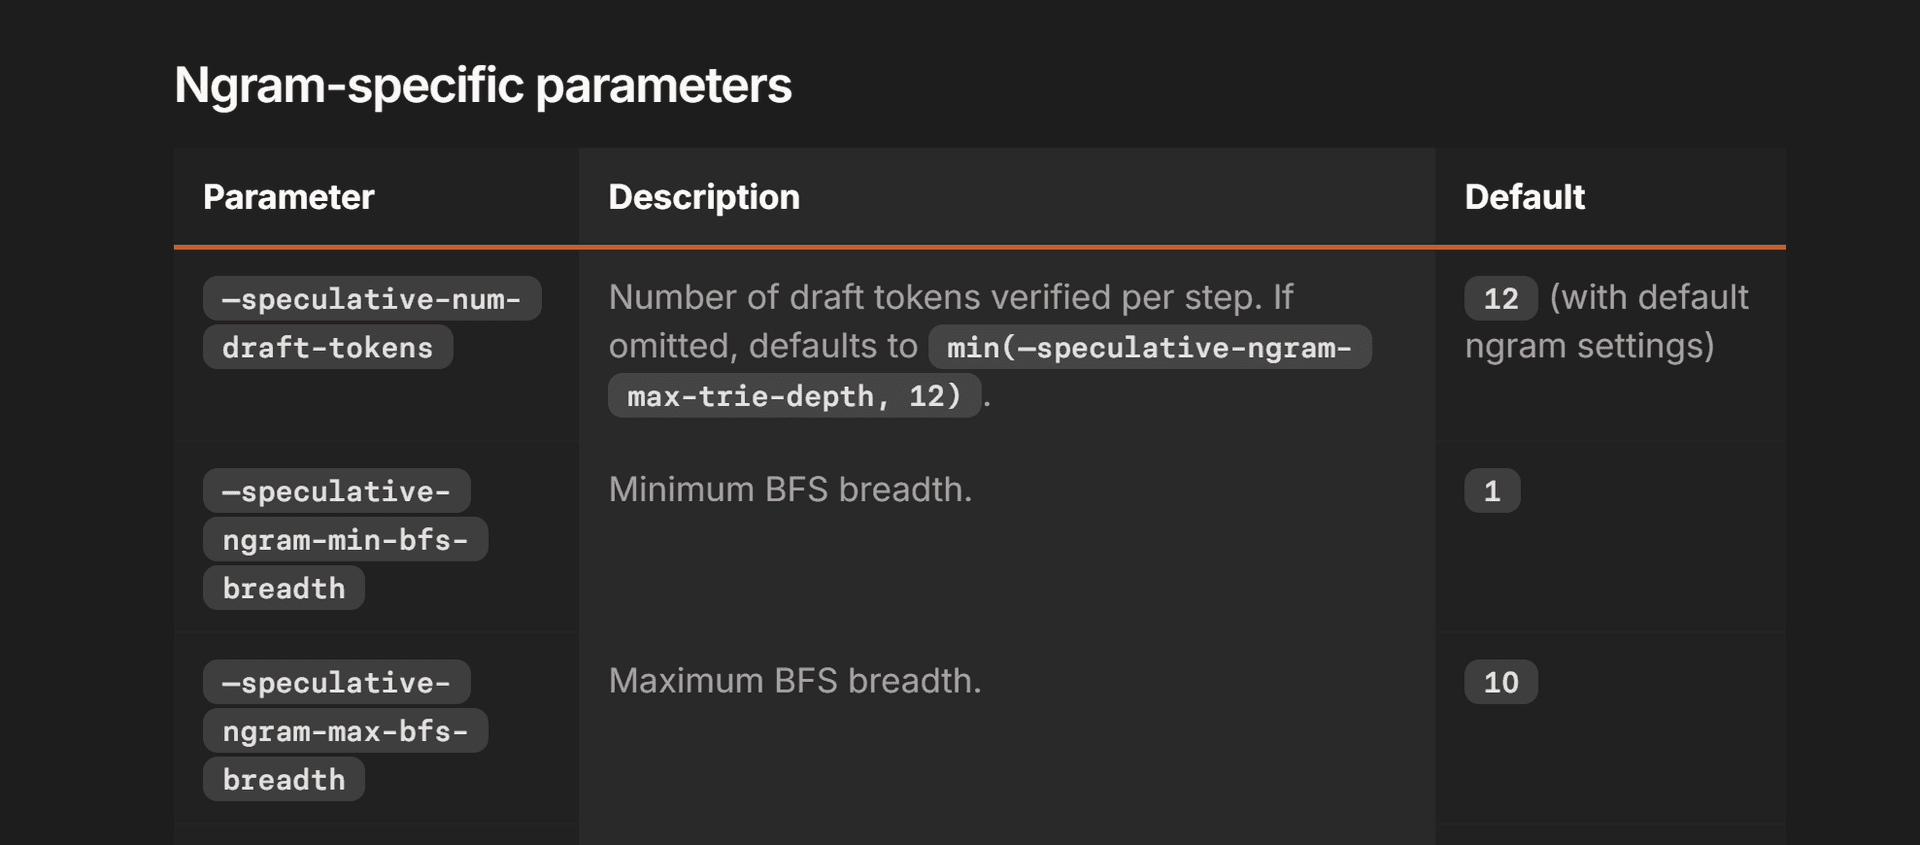
Para decodificación de flujo único eso deja en el suelo un 40 por ciento, y pasado 24 la búsqueda en CPU deja de pagarse y cae por un precipicio. El valor por defecto no es un error. Está puesto para serving de throughput, donde muchas solicitudes comparten la GPU y el tiempo de CPU está apretado. Es el valor por defecto equivocado para un usuario esperando un flujo, y nada en la pila te dice cuál de las dos cosas estás haciendo.
Dónde aterriza eso
| Proveedor | tok/s | Razón |
|---|---|---|
| una B200, dos corridas | 1,165.1 a 1,366.2 | |
| Groq | 477 | 2.44x a 2.87x más rápido |
| SambaNova | 706 | 1.65x a 1.94x más rápido |
| Cerebras | 1,891 | 0.62x a 0.72x |
Por prompt, las dos corridas midieron 447.8, 1930.8, 1882.5, 219.1 y luego 525.3, 2207.0, 2215.6, 291.9 tokens por segundo. Tres de esas ocho lecturas están por encima de la mediana actual de Cerebras de 1,891, en una GPU alquilable.
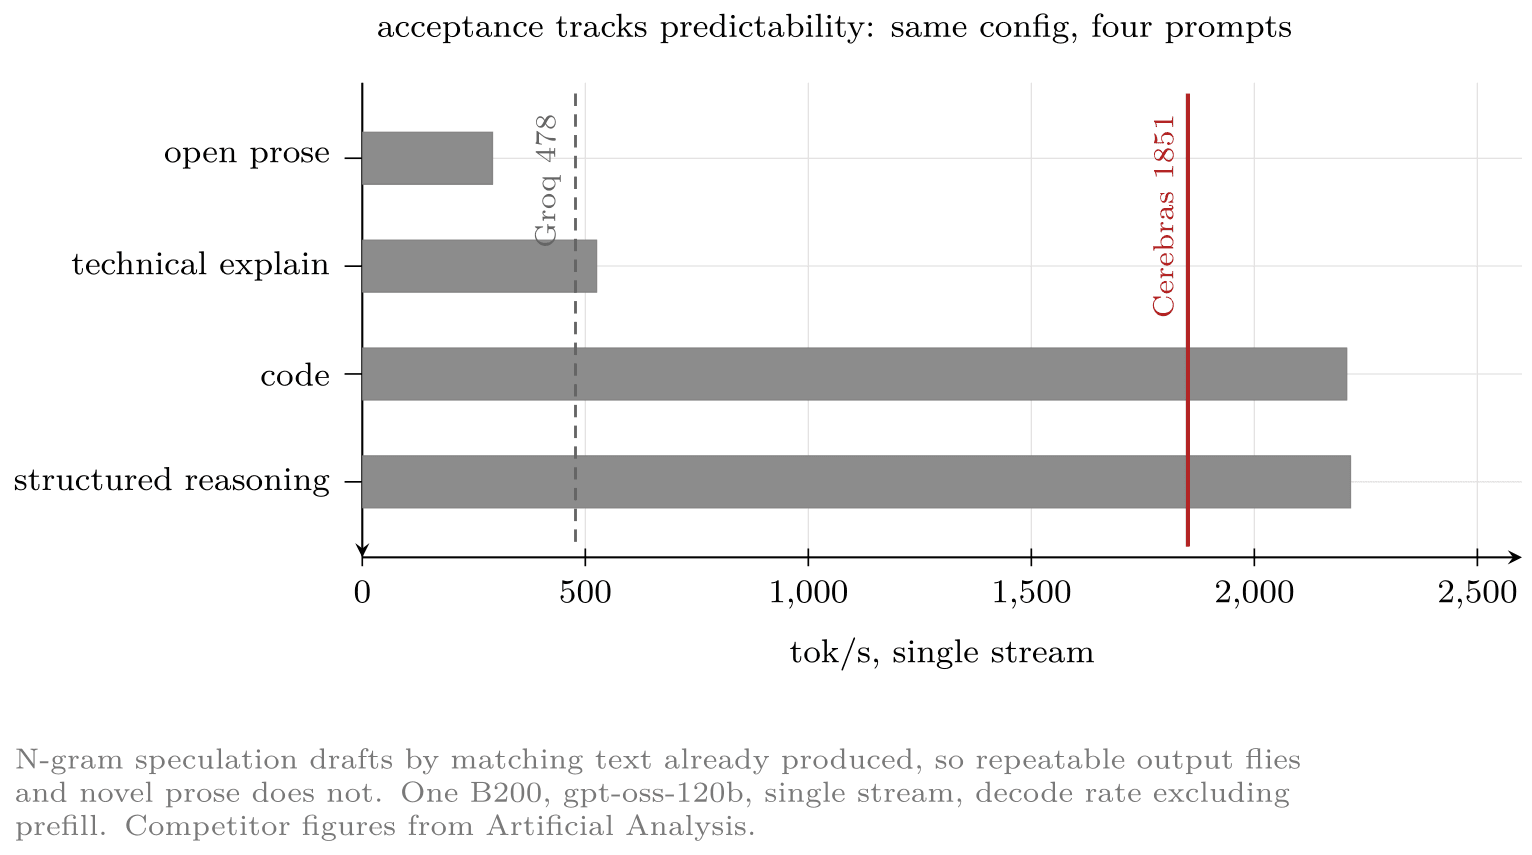
Esa dispersión es lo más útil del artículo, así que la muestro en lugar de esconderme detrás de una mediana. La especulación n-gram borra coincidiendo texto que ya produjo, así que el razonamiento estructurado donde las frases se repiten corre por encima de 2,200 mientras la prosa abierta que nunca se repite corre a 219. El truco paga exactamente en la medida en que la salida es predecible. Un proveedor que reporta un número está promediando su propia mezcla de prompts, y esta forma no se ve para nada.
Qué cambia y qué no cambia la especulación
La verificación greedy es lo que mantiene esto honesto. Un token borrador se acepta solo donde coincide con el token que el modelo objetivo habría producido por su cuenta, y en la primera discrepancia el resto del borrador se descarta y se toma el token del objetivo. Así que la especulación con verificación greedy es exacta, no aproximada. Cambia cuántas pasadas hacia adelante gastas, no qué tokens salen.
Si vas a comprobarlo tú mismo
Comparar una corrida especulativa contra una corrida no especulativa configurada distinto no prueba la especulación, prueba los kernels. Cambiar el backend de atención cambia el orden de las reducciones en punto flotante, y donde dos logits están casi empatados ese reorden voltea el argmax. Tu control debe mantener todos los demás ajustes fijos y encender la especulación por sí sola. Y compara ids de token, nunca texto, con una verificación explícita de longitud en lugar de zip, que trunca al lado más corto y reportará como bit exacta una corrida que murió a mitad. Lo sé porque escribí ese fallo al principio de este proyecto y le pasó un kernel que se había caído.
Lo que no funcionó, que es la mayor parte
Quince configuraciones, y los fallos te dicen más que las victorias.
Ambas cabezas borrador publicadas de EAGLE-3 puntuaron por debajo de correr sin especulación, 417.6 para la de NVIDIA y 325.0 para la del equipo de SGLang, porque la aceptación estaba cerca de cero. NVIDIA entrenó la suya contra su checkpoint NVFP4 y este es el MXFP4, y un borrador que nunca acierta te cuesta la pasada del borrador para nada.
Lograr que la cabeza de NVIDIA cargara siquiera vale la pena registrarlo. Falló con una discrepancia de tensores, 8640 contra 5760, que es tres veces el tamaño oculto contra dos. SGLang v0.5.16 mapea las capas de captura pedidas por el borrador con un error de uno, así que la última de tres capas pedidas queda fuera del ciclo, y la misma versión descarta en silencio el peso input_norm del checkpoint porque nunca construye ese módulo. Ambos se corrigieron aguas arriba en el commit 5df193b4ac, fusionado seis días después de que v0.5.16 se etiquetara. Un nightly con la corrección la cargó, y aun así perdió.
Todo backend de atención excepto triton está disponible aquí. FlashAttention 3 requiere SM 80 a 90 y una B200 es SM100. FA4 fuerza un tamaño de página de 128 y trtllm_mha fuerza 64, y SGLang entonces se niega a ejecutar un árbol especulativo más ancho que un token en un backend paginado porque produce resultados incorrectos. Me alegré de chocar con esa guarda en lugar de recibir en silencio respuestas equivocadas. El runner de MoE triton se queda sin memoria en 156 GiB porque decodifica MXFP4 de vuelta a bf16. torch.compile lanza un assert y luego se queda sin memoria en el mismo camino. DFLASH con un modelo borrador real alcanzó 493.5, mejor que nada y peor que n-gram.
Las advertencias honestas
Ellos sirven tráfico real en endpoints de producción y yo ejecuté cuatro prompts fijos en una caja alquilada, así que esto no es un cara a cara limpio y no voy a pretender que lo sea. Artificial Analysis también alimenta 10,000 tokens de entrada y mis prompts son de unos treinta, y un prompt más largo significa más caché KV que leer en cada paso, así que ellos hacen el trabajo más difícil. Eso ayuda a mi número, así que réstalo un poco al comparar.
Una oblea con los pesos en SRAM es una ventaja arquitectónica genuina en este problema y no marketing. Cerebras es rápido porque la memoria en el chip elimina el cuello de botella que he estado describiendo, y ninguna cantidad de trabajo de kernels convierte HBM en SRAM. Su mediana todavía me supera.
Una tarjeta que se puede alquilar por hora corriendo pesos que puedes descargar alcanza 1,165 a 1,366 tokens por segundo tras cuatro ajustes, y eso supera a dos de los tres chips hechos a medida. Los guiones están en el repositorio y también el JSON crudo por prompt, así que puedes ir a ver la dispersión tú mismo en lugar de confiar en mí.
Por qué construyo lo que construyo
La configuración de fábrica alcanzó el 26 por ciento del ancho de banda de memoria de esta máquina. Cuatro ajustes lo llevaron al 72 por ciento. Nadie reemplazó el hardware, y las 2.8x estaban dentro de una abstracción que no reportó ningún error en todo el tiempo.
Soy joven, soy nuevo en kernels y no soy la mejor persona del mundo escribiéndolos. Lo que se me da bien es construir agentes que los escriben, y creo que esa es la habilidad más útil. Las personas capaces de afinar un kernel a mano son escasas y no escalan, y cada modelo nuevo en cada tarjeta nueva necesita el trabajo de nuevo. El trabajo de kernels es de donde viene la próxima década de rendimiento, no de la próxima fábrica. El editor de código salió de esos dos años leyendo manuales de arquitectura, y he dejado de mantenerlo. AutoKernel y AutoMegaKernel vinieron después, y ambos existen para hacer por máquina lo que yo hice a mano en este artículo. Todo se trata de hacer que los modelos corran en las tarjetas que la gente tiene, no las de los comunicados de prensa.
Construí un optimizador para que no tengas que hacer nada de esto a mano. Lo apuntas a cualquier modelo de Hugging Face y a las tarjetas que ya tengas. Calcula tu techo, escribe y afina los kernels que cierran la brecha, y comprueba que la salida sea bit exacta antes de entregar nada. El trabajo que yo hice a mano aquí él lo hace solo.
El orden de las operaciones importa y la industria sigue teniéndolo al revés. Antes de diseñar una arquitectura distinta deberíamos exprimir lo que ya está en los racks, porque la mayor parte de ese silicio corre a una fracción de lo que puede hacer y lo que falta es código que nadie ha escrito. Grabar un chip para resolver un problema que no has resuelto primero en software significa pagar dieciocho meses y una corrida de fábrica por algo que un flag de configuración podría haberte dado esa misma semana, y los flags que cambié aquí valían 3.3x.
No le quito mérito a Cerebras. Mantener los pesos en SRAM mata exactamente el cuello de botella que he estado describiendo, eso es una solución real para un problema real, y siguen por delante de mí. Pero mucho de lo que parece una brecha de hardware en una tabla de clasificación es software que alguien aún no ha escrito, y solo lo descubres calculando el techo tú mismo y notando que estás al 26 por ciento de él.
Lo que la gente llama diseño de hardware es sobre todo traducción. Un modelo es un grafo de operaciones y un chip es un conjunto de unidades de ejecución y niveles de memoria. Pasar de uno al otro es un problema de compiladores y kernels de punta a punta. Estás decidiendo qué se fusiona, qué se queda en registros, qué se derrama a HBM y qué orden de ciclos quieren los tensor cores. Esa capa de traducción es donde vive el rendimiento, es software, y es la misma capa sea cual sea el silicio debajo, de NVIDIA, de AMD o de algo grabado el año pasado.
Por eso no creo que nada de esto sea permanente, y el caso más claro es AMD. El silicio es bueno y el ancho de banda está ahí. La brecha con NVIDIA en trabajo real es la pila, no los transistores. Si el software es la mayor parte, la brecha se puede cerrar escribiendo software, que es una posición mucho mejor que necesitar una fábrica nueva. Estamos escalando nuestros agentes a AMD enseguida, porque la prueba interesante no es hacer un chip rápido más rápido, es alcanzar números de clase NVIDIA en hardware que la gente ha dado por perdido.
Y no son solo las empresas de chips. OpenAI y Broadcom sacaron un chip de inferencia llamado Jalapeno en junio, y Anthropic confirmó un equipo de silicio interno en agosto, ambos hablando de reducir a la mitad el costo por token (openai.com/index/openai-broadcom-jalapeno-inference-chip). Dos de las mejores empresas de software del mundo decidieron que el próximo lugar donde gastar es la capa de hardware.
Yo lo leo distinto a la mayoría. Si recuperas la mitad de tu costo de inferencia grabando un chip, parte de lo que de verdad estás recomprando es la eficiencia que nunca obtuviste de las GPUs que ya tienes. No creo que sea una crítica hacia ellos, es el mismo 26 por ciento que medí en este artículo, en una escala donde vale una corrida de fábrica arreglarlo.
De lo que estoy menos seguro es de lo que viene después. CUDA es la razón por la que una B200 es fácil de llevar al 72 por ciento, y CUDA son dieciocho años de compiladores, librerías, kernels, perfiladores y gente que sabe dónde están los cadáveres. Ese es el foso, no los transistores. Un chip nuevo empieza en cero en todo eso. Puede ser un mejor diseño y aun así perder, porque lo que decide cuánto de un chip puedes usar de verdad es el software alrededor, y eso toma años construirlo.
Así que la pregunta que haría sobre cualquier chip hecho a medida no es qué tan rápido es el silicio. Es si el software acompaña. Seguirá siendo rápido en el modelo al que cambies el próximo trimestre, en un truco que nadie ha inventado aún, en una forma para la que el compilador nunca fue escrito. Una GPU responde todo eso con una recompilación.
Los chips de inferencia hechos a medida son una apuesta a que una carga se queda quieta el tiempo suficiente para hornearla en silicio. La decodificación especulativa no existía en su forma actual hace tres años y el próximo truco tampoco existe aún. Cuando llegue, la gente en hardware programable con un compilador maduro lo entregará en semanas. La gente que lo grabó en silicio no.
Recuerdo cuando pasé de llamar funciones de PyTorch a escribir los kernels debajo de ellas, pensé que bajaba un nivel por el rendimiento, y ahora estoy más seguro de que bajaba un nivel por el control, porque el rendimiento es lo que obtienes cuando dejas de aceptar lo que el valor por defecto decidió por ti.
Así que cuando la gente me pregunta por qué sigo trabajando en esto en lugar de en algo con una demostración más bonita, esa es la respuesta. El hardware va a seguir siendo bueno. La parte que decide si ves algo de él es el software, y ahora mismo casi nadie lo está escribiendo. Esa es la pieza que importa, y es la pieza que quiero que cualquiera pueda alcanzar.