
소프트웨어만으로 B200 한 장이 LPU를 이기고 Cerebras에 근접하다
, 16분 소요, By Jaber Jaber
엔지니어링편집자 주: 이 글은 처음 우리의 이전 사이트에 실렸습니다. 여기서 설명하는 최적화 제품은 은퇴했습니다. RightNow는 자신의 API로 오픈 모델을 서비스합니다.
정정, 2026년 8월 9일
이 글이 8월 6일에 실린 뒤 Artificial Analysis가 자신의 제공자 중앙값을 바꾸었습니다. 8월 6일에 여기서 쓴 비교점들은 Cerebras 1,991 tok/s, SambaNova 708, Groq 476, Google Vertex 423, Databricks 324, Azure 300, Amazon 101, CoreWeave 33이었습니다. 8월 9일의 출처는 Cerebras 1,891, SambaNova 706, Groq 477, Google Vertex 391, Azure 312, Baseten 195, Amazon 86, CoreWeave 36을 읽습니다. Databricks는 현재 차트에 보고된 속도가 없습니다. 아래의 현재 문장과 표는 8월 9일의 값을 씁니다. 원래 8월 6일 차트 이미지는 날짜가 찍힌 게재 스냅샷으로 그대로 보입니다.
이제 매년 누군가 추론을 위해 만든 새 실리콘을 배포합니다. Cerebras는 웨이퍼에 가중치를 얹었고, Groq는 LPU를 만들었고, SambaNova는 RDU를 만들었습니다. 셋 모두 토큰을 빠르게 옮기는 실제 기계입니다. 이런 일이 일어나는 것이 나는 좋습니다. 추론은 하드웨어를 설계할 가치가 있습니다.
나는 GPU 커널용 코드 편집기를 만들기 위해 지난 2년을 NVIDIA와 AMD GPU 아키텍처를 연구하며 보냈습니다. 그 매뉴얼을 하루 종일 읽으면 카드가 무엇을 할 수 있는지 배우게 됩니다. 그리고 같은 카드에서 사람들이 무엇을 얻고 있는지 보면 두 수는 맞지 않습니다. 그래서 나는 모든 커널을 손으로 쓰려는 것을 멈추고 커널을 쓰는 에이전트를 만들기 시작했습니다. 나는 AutoKernel을 오픈소스로 내놓았습니다. GPU 커널을 생성하고 튜닝하며, 실제로 무엇을 하는지 따라갈 수 있도록 작고 읽기 쉽습니다. 그다음 AutoMegaKernel입니다. 전체 디코드 단계를 영속 커널로 융합하여 중간값이 칩을 떠나지 않게 합니다. 모두 같은 것을 위해서입니다. 사람들이 이미 소유한 카드에서 모델이 제대로 돌게 하는 것입니다.
그래서 리더보드가 나를 괴롭힙니다. 종이 위에서 바이트 예산을 계산할 수 있는 모델에 대해 8월 6일 게시판이 초당 423 GPU 토큰을 읽었을 때, 내 첫 생각은 GPU가 느리다는 것이 아니었습니다. 내 첫 생각은 아무도 소프트웨어를 쓰지 않았다는 것이었습니다. 그래서 소프트웨어 외에는 아무것도 건드리지 않고 단일 B200에서 그 격차를 좆을 수 있는지 확인하기로 했습니다.
8월 9일 기준 Artificial Analysis는 Cerebras를 초당 1,891 토큰으로 올립니다. 목록에서 가장 빠른 GPU 제공자는 Google Vertex의 391, 그다음 Azure의 312와 Baseten의 195입니다. 이것은 가장 빠른 목록된 GPU보다 Cerebras를 4.8배 앞세웁니다. Cerebras가 공개한 비교의 5배 리드에 가깝습니다(cerebras.ai/blog/blackwell-vs-cerebras).
1,891은 하드웨어의 답이고 좋은 답입니다. 그들은 HBM 대신 SRAM에 가중치를 두므로, 우리 나머지가 싸우는 병목이 그들의 기계에는 존재하지 않습니다. 나는 그것에 반론을 펼 생각이 없고, 그것을 이기지도 못했습니다.
내가 비교를 실행했을 때 게시판은 423을 읽었고 8월 9일 기준 391을 읽습니다. 그 GPU 기준점이 내가 쫓은 수입니다. 내가 GPU를 원할 때 아무생각 없이 집는 도구인 Modal에서 B200 하나를 빌려 측정을 시작했습니다. 기본 상태에서 초당 411 토큰을 얻었습니다. 네 설정을 바꾸자 같은 카드가 같은 가중치로 1,366을 냈고, 단일 프롬프트는 2,215에 닿았습니다. 커널을 쓰지 않았고 아무것도 다시 컴파일하지도 않았습니다.
| 지표 | 값 | 상세 |
|---|---|---|
| 스톡 SGLang | 411 tok/s | 이 카드의 메모리 대역폭의 26퍼센트 |
| 네 설정 뒤 | 1,366 tok/s | 72퍼센트, 그리고 가장 빠른 GPU 제공자의 3.5배 |
| 가장 좋은 단일 프롬프트 | 2,215 tok/s | Cerebras 위, 빌릴 수 있는 카드 하나에서 |
현재 게시판에서 가장 빠른 GPU 제공자를 3.5배 지나칩니다. Groq의 477과 SambaNova의 706를 넘고, 빌린 카드 하나를 웨이퍼의 72퍼센트에 놓습니다.
추상화는 당신에게 거짓말을 하고, 하드웨어에 대해서는 거짓말이 아니다
당신과 칩 사이의 모든 계층은 칩에 대해 생각하지 못하게 막으려고 있고, 그것은 작동합니다. generate를 호출하면 토큰이 어떤 속도로 나오고, 그 속도가 기계의 속도처럼 느껴집니다. 아닙니다. 그것은 당신이 우연히 부른 기본값들의 속도입니다.
그래서 무언가 느릴 때 사람들은 하드웨어를 탓하고, 그리고 거의 항상 틀립니다. 프레임워크는 자신이 당신을 붙잡고 있는 그것이라고 말할 수 없습니다. 오류를 던지지 않고, 모든 것이 멀쩡해 보이고, 주는 수는 안정적이고 재현 가능하므로, 물리처럼 느껴집니다. 그런데 그것은 설정 파일입니다.
빠져나올 길은 하나입니다. 카드가 무엇을 할 수 있는지 바이트와 대역폭에서 스스로 계산하고 비교하는 것입니다. 그 수는 당신이 어떤 프레임워크를 쓰는지 신경 쓰지 않습니다.
B200 위의 gpt-oss-120b에 대해 산수는 짧습니다. 토큰 하나의 디코딩은 모든 활성 가중치를 정확히 한 번 읽습니다. bf16의 어텐션이 1.91 GB, mxfp4의 상위 4 라우팅 전문가들이 1.90 GB, bf16의 lm_head가 1.16 GB, 그래서 토큰당 4.97 GB입니다. B200은 8 TB/s의 HBM3e를 갖습니다(nvidia.com/en-us/data-center/dgx-b200). 그래서 바닥은 토큰당 0.621밀리초이고 천장은 초당 약 1,610 토큰입니다.
스톡 SGLang은 토큰당 2.43밀리초가 걸렸습니다. 모든 토큰의 74퍼센트는 가중치를 읽는 일이 아니었습니다.
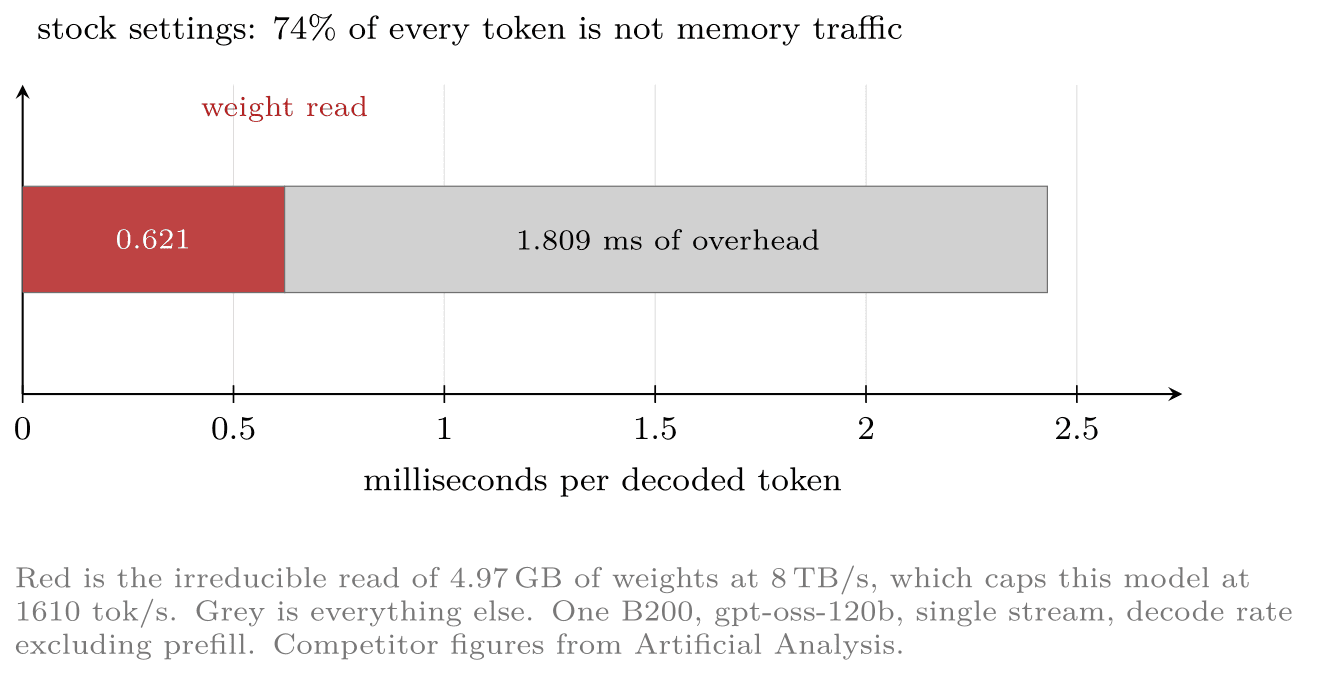
칩은 시간의 4분의 3을 쉬고 있었습니다. 더 빠른 카드를 사라는 모든 직감은 이미 일하고 있던 26퍼센트를 겨냥하고 있었습니다.
무엇을, 어떻게 측정했는가
모두 HBM3e 178.4 GiB와 148 SM을 갖춘 Modal의 단일 B200에서 실행했습니다. 모델은 openai/gpt-oss-120b입니다. 네이티브로 MXFP4에 실려 있고 토큰마다 120B 파라미터 중 약 5.1B를 활성화합니다. 서빙은 SGLang 0.5.16을 통해, 온도 영의 탐욕, 단일 스트림, 한 번에 프롬프트 하나, 고정 프롬프트 넷, 반복 셋, 중앙값입니다.
보고된 수는 프리필을 제외한 디코드 속도입니다. Artificial Analysis가 Output Speed를 그렇게 정의합니다. 첫 토큰을 받은 뒤 초당 받은 토큰 수의 평균입니다(artificialanalysis.ai/methodology). 이 모델을 고른 것은 ASIC 벤더 셋 모두가 그것 위에 수치를 내므로, 비교가 같은 가중치와 같은 지표이기 때문입니다.
| 제공자 | tok/s | 실리콘 |
|---|---|---|
| Cerebras | 1,891 | 웨이퍼 |
| SambaNova | 706 | RDU |
| Groq | 477 | LPU |
| Google Vertex | 391 | GPU |
| Azure | 312 | GPU |
| Baseten | 195 | GPU |
| Amazon | 86 | GPU |
| CoreWeave | 36 | GPU |
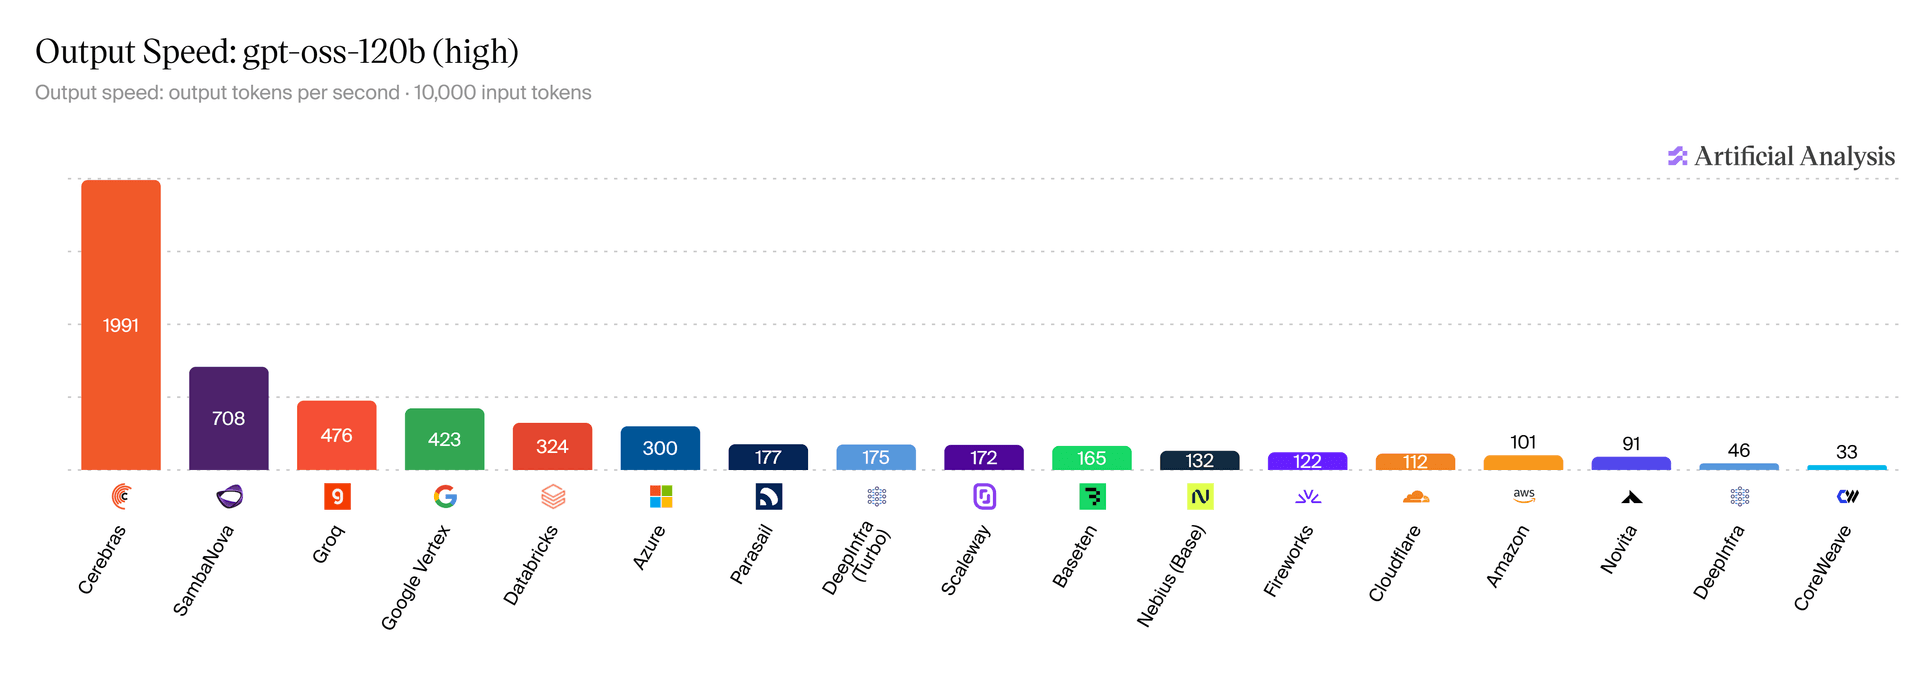
현재 게시판의 측정된 GPU 목록들을 보세요. 같은 오픈 가중치와 지표에서 391의 Google Vertex부터 36의 CoreWeave까지 10.8배 벌어져 있습니다. 공개 차트는 GPU 세대를 설정, 커널, 서빙 코드에서 분리하지 않으므로, 이것은 배달된 스택이 중요하다는 증거이지 깨끗한 소프트웨어만의 10.8배 추정이 아닙니다.
사다리
| 단계 | tok/s |
|---|---|
| 스톡 기본값 | 411.2 |
| 지연 노브 | 429.9 |
| n-gram 추측 디코딩 | 628.5 |
| speculative_attention_mode=decode | 697.1 |
| 넓은 n-gram 탐색 | 1,165.1 과 1,366.2 |
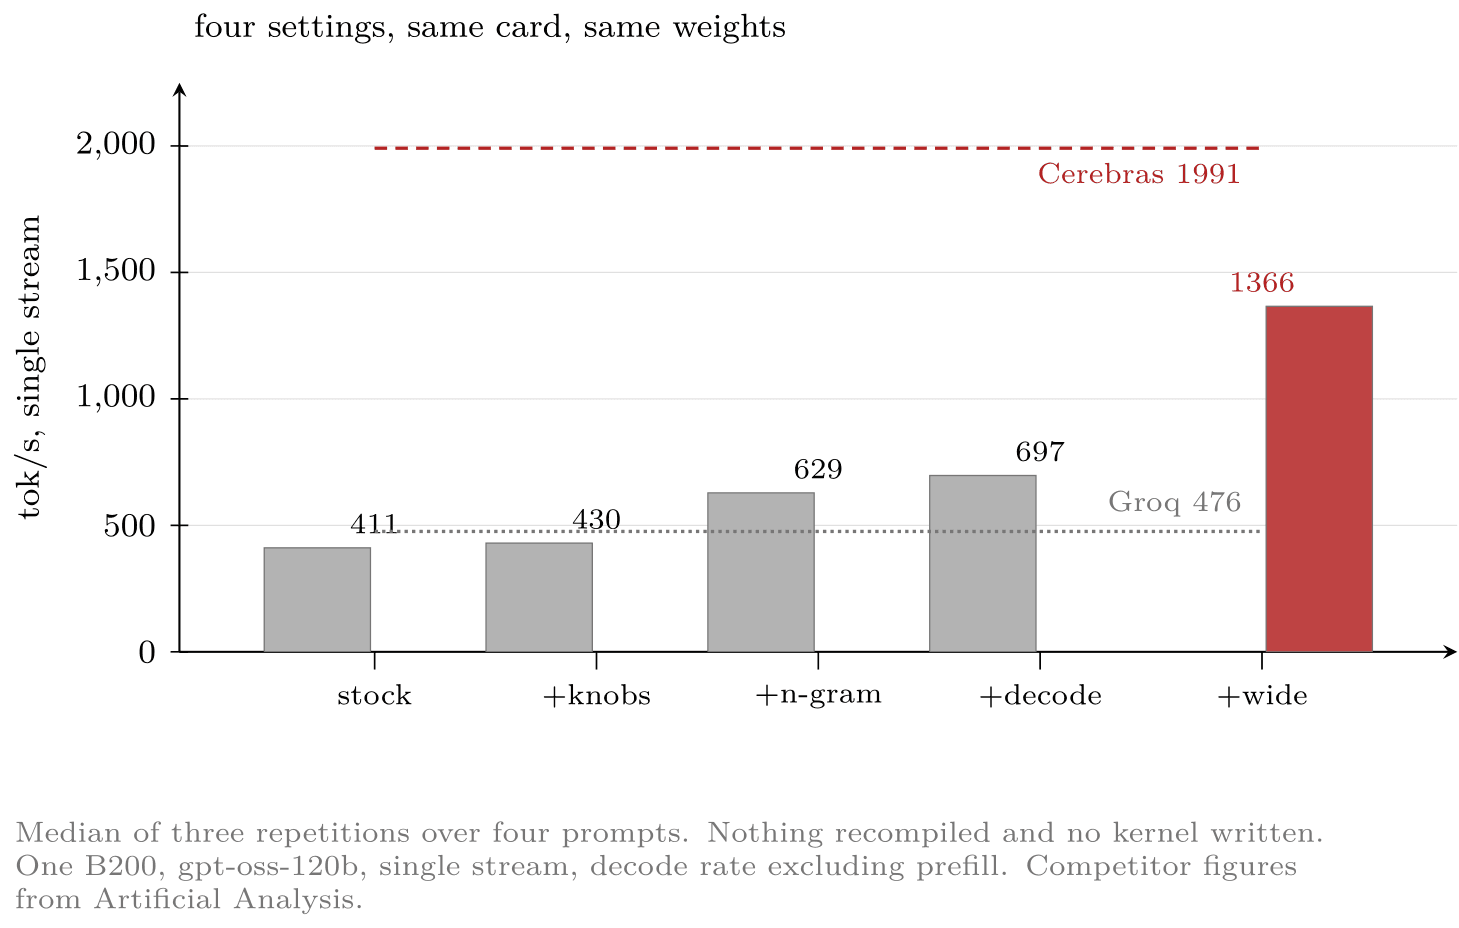
첫 단은 작습니다. SGLang은 stream_interval을 기본 1로 두어 모든 단일 토큰에서 역토큰화하고 디스패치하고, scheduler_recv_interval을 1로 두어 모든 반복을 폴링합니다. 0.621밀리초 예산에서 그것은 실제 돈이고, 고치니 4.5퍼센트를 샀습니다.
둘째 단은 추측 디코딩입니다. Groq에게 여섯 배를 준 같은 기술입니다. 초안이 여러 토큰을 제안하고, 대상이 하나의 순전파에서 검증하고, 수용된 모든 토큰은 별도의 4.97 GB 가중치 읽기 없이 나온 토큰입니다. 나는 훈련된 초안 헤드를 쓸 수 없었습니다. 실패 절의 이유들 때문입니다. 그래서 이것은 n-gram 추측입니다. 지금까지 생성된 텍스트의 패턴을 맞춰 초안을 씁니다.
셋째 단은 내가 한 번도 만진 적 없는 플래그였습니다. speculative_attention_mode의 기본은 prefill이고, decode로 바꾸니 9.7퍼센트가 나왔습니다.
마지막 행이 두 수인 것은 그 구성을 두 번 실행하여 둘 다 얻었기 때문입니다. 같은 설정에서 17퍼센트의 벌어짐입니다. n-gram 수용은 트라이가 무엇을 쌓았는가에 달렸으므로, 같은 설정이 매번 다른 곳에 착지합니다. 더 좋은 쪽만 인용했다면 나는 수를 재는 것이 아니라 고르는 것입니다.
중요했던 단은 그것을 부러뜨려서 찾았다
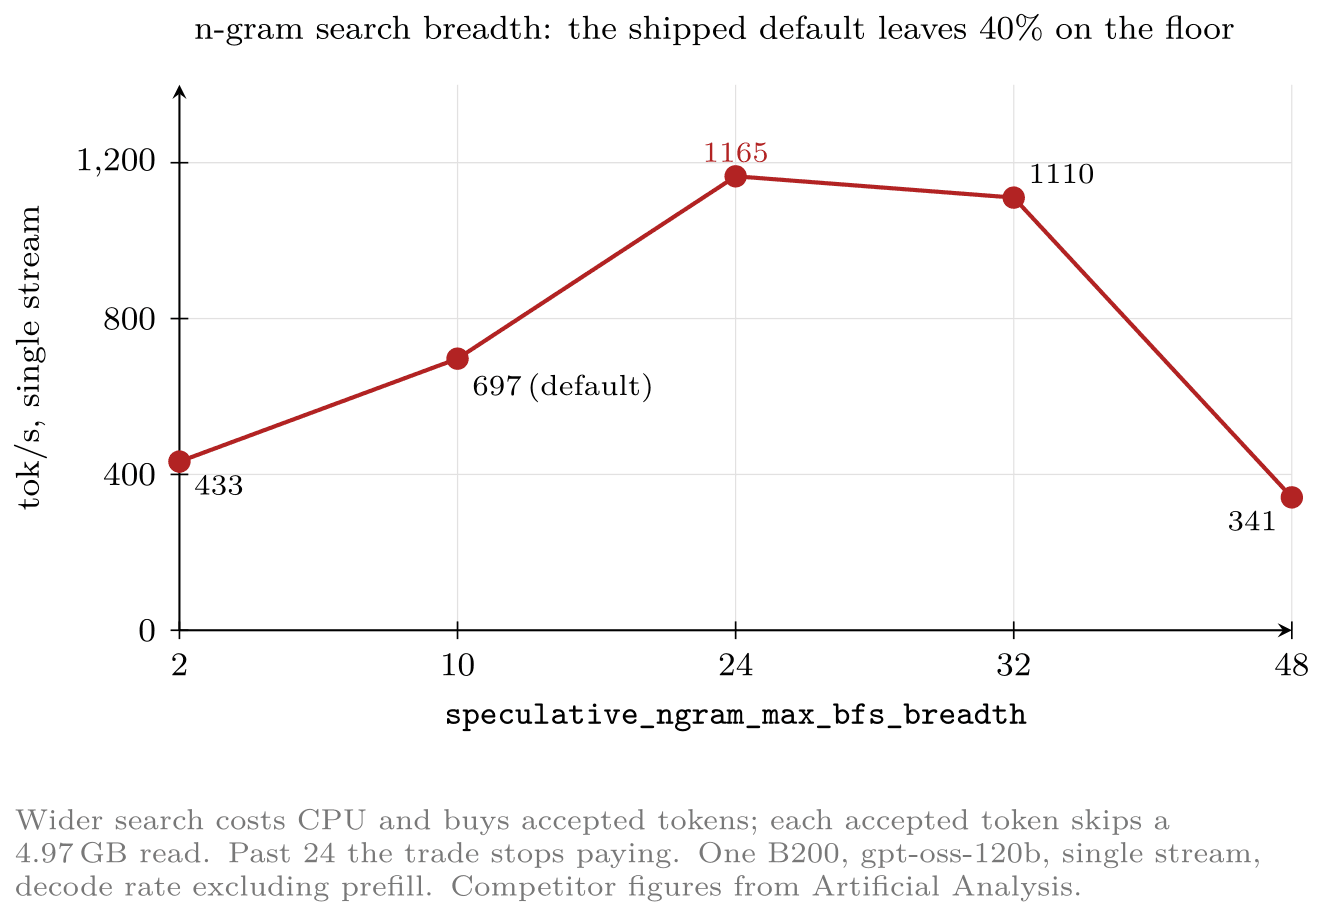
나는 합리적으로도, CPU n-gram 제안자가 GPU와 직렬화되고 그 탐색 비용이 병목이라는 말을 들었습니다. 그래서 그것을 줄였습니다. max_bfs_breadth를 10에서 2로, max_trie_depth를 18에서 8로. 오버헤드가 떨어지리라 기대하며.
처리량은 433.0으로 무너졌습니다.
그 실패는 작은 승리보다 더 값졌다
탐색이 오버헤드가 아니라 토큰을 버는 그것이라고 말합니다. 제안자가 탐색하는 모든 추가 후보는 다른 토큰 하나를 수용할 기회이고, 수용된 모든 토큰은 온전한 4.97 GB 읽기를 건너뜁니다. HBM 트래픽 0.621밀리초를 피하려고 CPU의 몇백 마이크로초를 쓰는 것은 계속하고 싶은 거래입니다.
그래서 노브를 반대로 돌렸고, 곡선은 날카로운 봉우리를 갖습니다.
| max_bfs_breadth | tok/s |
|---|---|
| 2 | 433.0 |
| 10, 기본값 | 697.1 |
| 24 | 1,165.1 |
| 32 | 1,110.4 |
| 48 | 341.1 |
배포된 기본값은 10이고, 문서에서 곧장 읽을 수 있습니다.
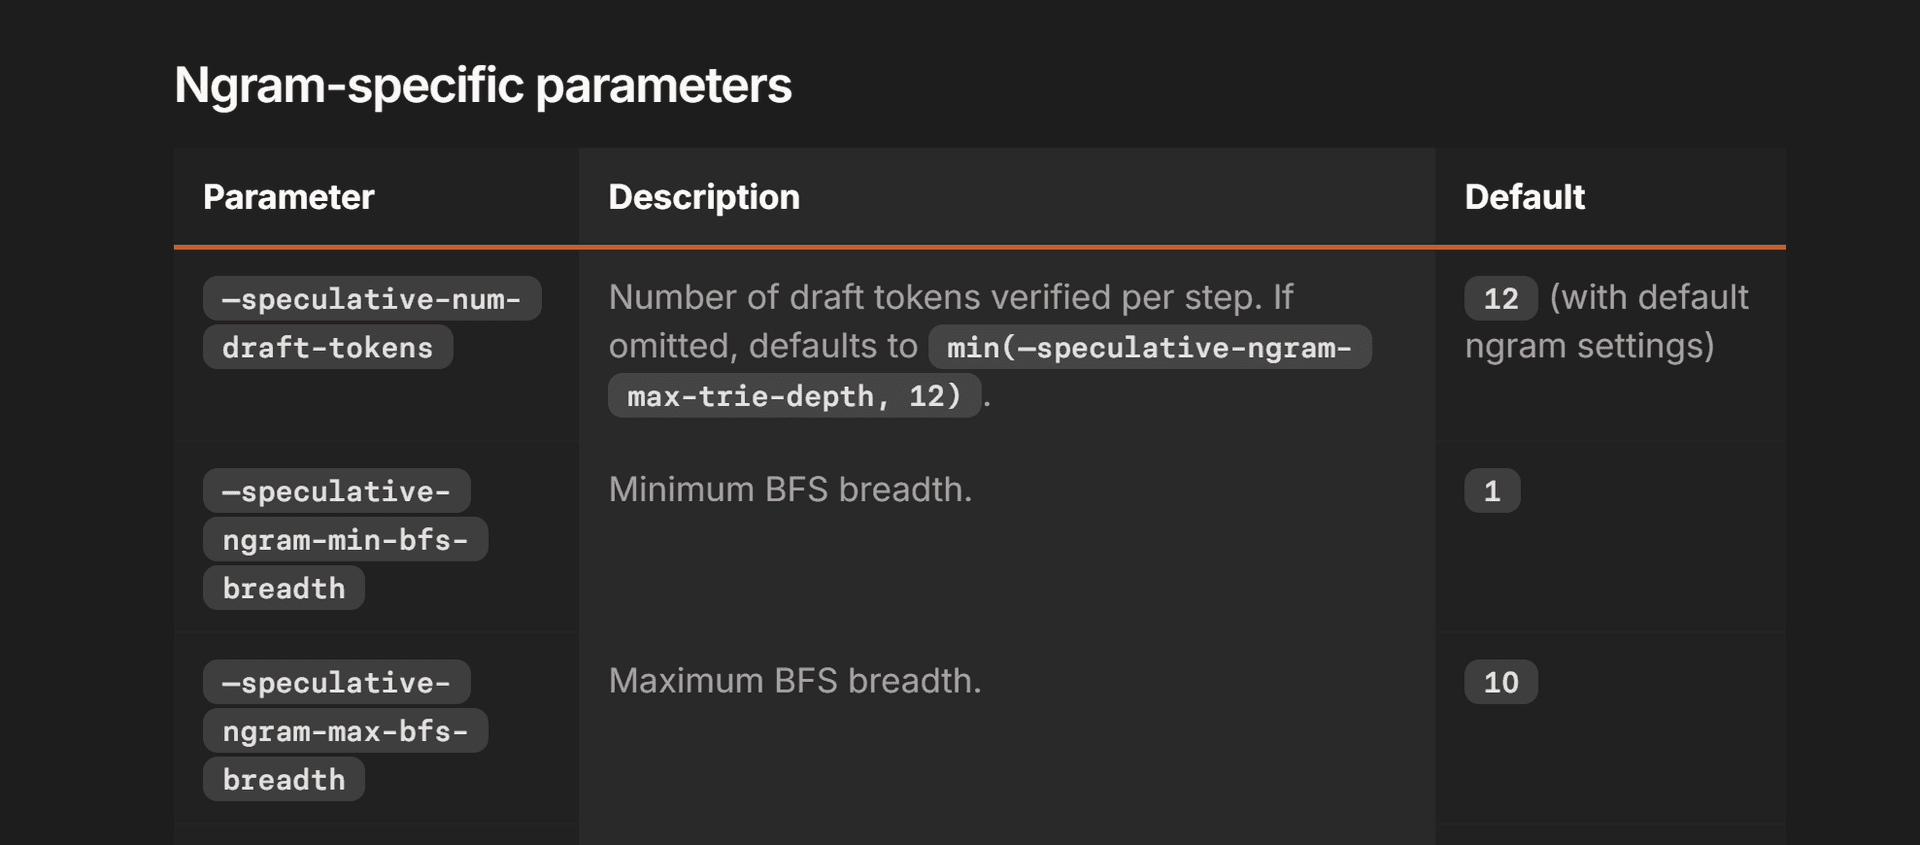
단일 스트림 디코드에는 그것이 약 40퍼센트를 바닥에 남기고, 24를 지나면 CPU 탐색은 제 몸값을 못 치르고 절벽에서 떨어집니다. 기본값은 실수가 아닙니다. 처리량 서빙을 위해 맞춰져 있습니다. 많은 요청이 GPU를 공유하고 CPU 시간이 빠듯한 곳에서요. 한 사용자가 한 스트림을 기다리는 경우에는 잘못된 기본값이고, 스택의 어느 것도 당신이 둘 중 무엇을 하고 있는지 알려주지 않습니다.
그것이 어디에 착지하는가
| 제공자 | tok/s | 비율 |
|---|---|---|
| B200 하나, 두 실행 | 1,165.1 ~ 1,366.2 | |
| Groq | 477 | 2.44배 ~ 2.87배 더 빠름 |
| SambaNova | 706 | 1.65배 ~ 1.94배 더 빠름 |
| Cerebras | 1,891 | 0.62배 ~ 0.72배 |
프롬프트별로, 두 실행은 447.8, 1930.8, 1882.5, 219.1, 그리고 525.3, 2207.0, 2215.6, 291.9 tok/s를 측정했습니다. 그 여덟 판독 중 셋은, 하나의 빌릴 수 있는 GPU 위에서, Cerebras의 현재 1,891 중앙값 위입니다.
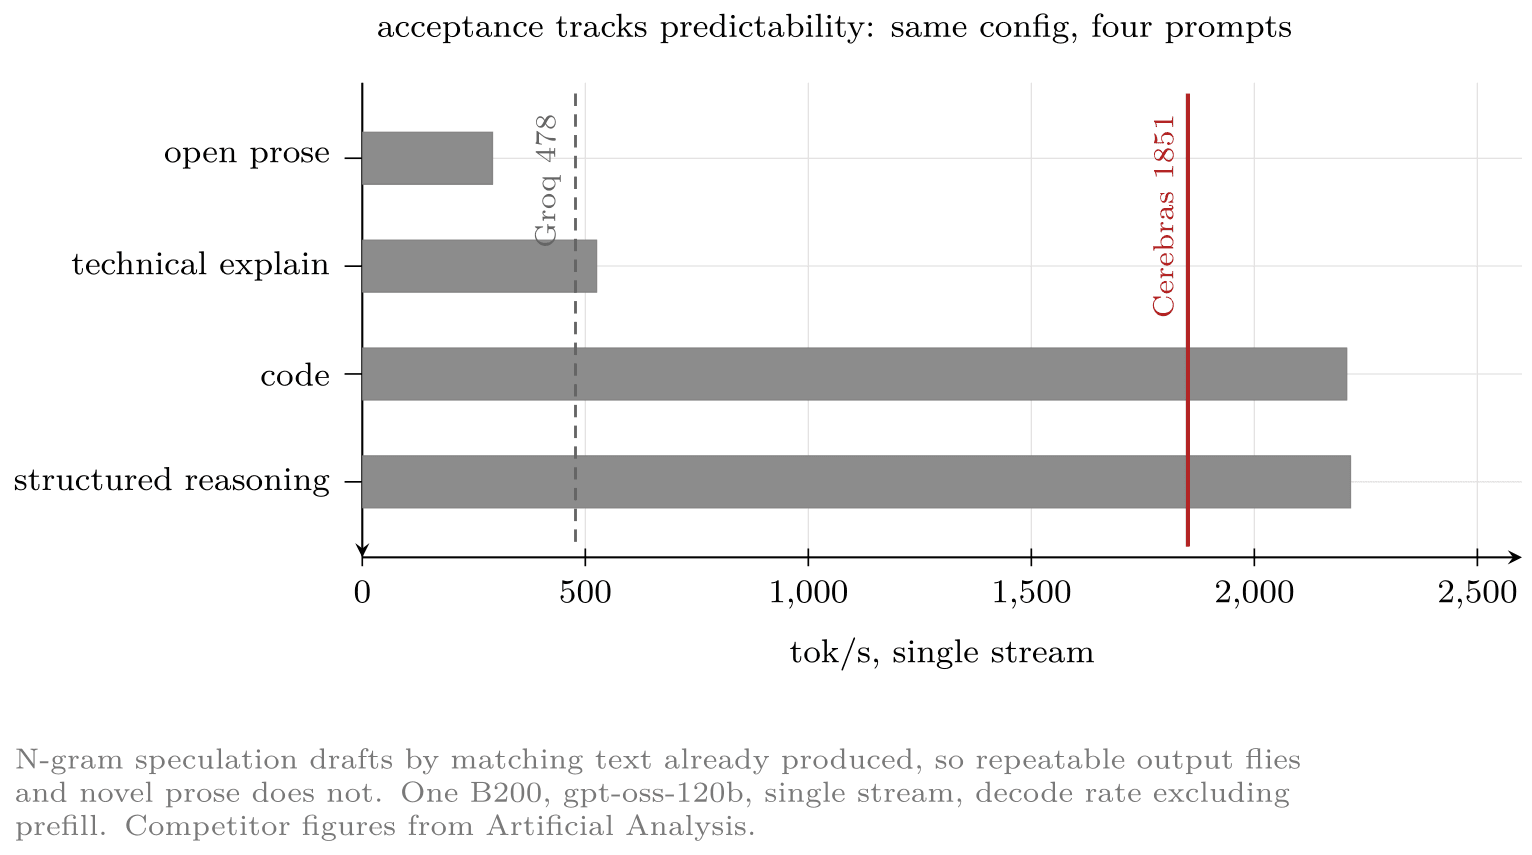
그 벌어짐이 이 글에서 가장 유용한 것이므로, 중앙값 뒤에 숨는 대신 보여줍니다. n-gram 추측은 이미 만든 텍스트를 맞춰 초안을 쓰므로, 표현이 반복되는 구조화된 추론은 2,200 위를 달리고 결코 반복되지 않는 개방 산문은 219를 냅니다. 이 기술은 출력이 예측 가능한 만큼 정확히 이득을 냅니다. 하나의 수를 보고하는 벤더는 자신의 프롬프트 혼합 위에서 평균을 내고, 당신은 이 모양을 전혀 볼 수 없습니다.
추측이 바꾸는 것과 바꾸지 않는 것
탐욕 검증이 이것을 정직하게 유지합니다. 초안 토큰은 대상 모델이 자신의 힘으로 냈을 토큰과 일치하는 곳에서만 수용되고, 첫 불일치에서 초안의 나머지는 버려지고 대상의 토큰이 대신 취해집니다. 그러므로 탐욕 검증 아래의 추측은 근사가 아니라 정확합니다. 몇 번의 순전파를 쓰는가를 바꿀 뿐, 어떤 토큰이 나오는지는 바꾸지 않습니다.
스스로 이것을 확인하러 간다면
추측 실행을 다르게 설정된 비추측 실행과 비교하는 것은 추측을 시험하는 것이 아니라 커널을 시험하는 것입니다. 어텐션 백엔드를 바꾸면 부동소수점 축소의 순서가 바뀌고, 두 로짓이 거의 비긴 곳마다 그 재배열이 아그맥스를 뒤집습니다. 당신의 대조군은 다른 모든 설정을 고정한 채 추측만 홀로 켜야 합니다. 그리고 토큰 id를 비교하세요, 텍스트가 아니라. zip이 아니라 명시적 길이 검사와 함께요. zip은 짧은 쪽으로 자르므로 중간에 죽은 실행을 비트 정확이라 보고합니다. 내가 이것을 아는 것은 이 프로젝트에서 그 버그를 일찍 썼고, 그것이 크래시한 커널을 통과시켰기 때문입니다.
효과가 없었던 것, 즉 대부분
열다섯 구성이었고, 실패들이 승리들보다 더 많은 것을 말해줍니다.
공개된 EAGLE-3 초안 헤드 둘 다 추측 없이 실행한 것보다 낮았습니다. NVIDIA 것은 417.6, SGLang 팀 것은 325.0. 수용이 영에 가까웠기 때문입니다. NVIDIA는 자신들의 NVFP4 체크포인트에 맞춰 훈련했고 이것은 MXFP4입니다. 결코 맞추지 못하는 초안은 초안 통과를 공짜로 잃게 합니다.
NVIDIA의 헤드가 로드되게 하는 것 자체가 기록할 가치가 있습니다. 텐서 불일치로 실패했습니다. 8640 대 5760, 즉 은닉 크기의 세 배 대 두 배입니다. SGLang v0.5.16은 초안이 요청한 캡처 계층에 하나 빠짐을 매핑하여 세 요청 계층의 마지막이 루프 밖에 떨어지고, 같은 버전은 체크포인트의 input_norm 가중치를 조용히 버립니다. 그 모듈을 아예 만들지 않기 때문입니다. 둘 다 업스트림 커밋 5df193b4ac에서 고쳐졌고, v0.5.16이 태그된 뒤 엿새 만에 병합되었습니다. 수정이 든 나이틀리가 그것을 불러왔고, 여전히 졌습니다.
triton을 제외한 모든 어텐션 백엔드는 여기서 이용할 수 없습니다. FlashAttention 3은 SM 80에서 90을 요구하고 B200은 SM100입니다. FA4는 페이지 크기 128을 강제하고 trtllm_mha는 64를 강제하며, SGLang은 그때 토큰 하나보다 넓은 추측 트리를 페이징 백엔드 위에서 돌리길 거부합니다. 잘못된 결과를 내기 때문입니다. 잘못된 답을 조용히 얻는 대신 그 가드를 만난 것이 나았습니다. triton MoE 러너는 MXFP4를 bf16으로 역양자화하여 156 GiB에서 OOM을 냅니다. torch.compile은 주장하고 같은 경로에서 OOM을 냅니다. 실제 초안 모델을 갖춘 DFLASH는 493.5에 도달했습니다. 없는 것보다 낫고 n-gram보다 나빴습니다.
정직한 주의점
그들은 운영 엔드포인트에서 실제 트래픽을 서빙하고 나는 빌린 박스 하나에서 고정 프롬프트 넷을 돌렸으므로, 이것은 깨끗한 맞대결이 아니고 그렇게 주장할 생각도 없습니다. Artificial Analysis는 입력 토큰 10,000개를 먹이고 내 프롬프트는 서른 개쯤이며, 더 긴 프롬프트는 매 단계 읽을 KV 캐시가 더 크다는 뜻이므로, 그들은 더 어려운 일을 하고 있습니다. 그것은 내 수에 도움이 되므로, 비교할 때 조금 깎으세요.
SRAM에 가중치를 담은 웨이퍼는 이 문제에서 진짜 아키텍처 우위이고 마케팅이 아닙니다. Cerebras가 빠른 것은 온칩 메모리가 내내 설명해온 병목을 없애기 때문이고, 어떤 커널 작업도 HBM을 SRAM으로 바꾸지 못합니다. 그들의 중앙값은 여전히 내 것을 이깁니다.
시간당 빌릴 수 있는 카드가 내려받을 수 있는 가중치를 돌려 네 설정 뒤에 초당 1,165에서 1,366 토큰에 도달하고, 그것은 커스텀 칩 셋 중 둘을 이깁니다. 스크립트는 저장소에 있고 프롬프트별 원본 JSON도 있으므로, 나를 믿는 대신 그 벌어짐을 직접 보러 갈 수 있습니다.
내가 왜 이것을 만드는가
스톡 구성은 이 기계 메모리 대역폭의 26퍼센트에 도달했습니다. 네 설정이 그것을 72퍼센트로 가져갔습니다. 아무도 하드웨어를 교체하지 않았고, 그 2.8배는 내내 오류 하나 보고하지 않는 추상화 안에 앉아 있었습니다.
나는 젊고 커널은 새로이며 세계 최고의 커널 작가도 아닙니다. 내가 좋은 것은 그것들을 쓰는 에이전트를 만드는 것이고, 그것이 더 유용한 기술이라고 생각합니다. 손으로 커널을 튜닝할 수 있는 사람은 드물고 그들은 확장되지 않으며, 모든 새 카드의 모든 새 모델은 그 작업이 다시 필요합니다. 커널 작업이 다음 십 년의 성능이 나오는 곳이지 다음 팹이 아닙니다. 코드 편집기는 아키텍처 매뉴얼을 읽던 그 2년에서 나왔고, 나는 그것의 지원을 멈췄습니다. AutoKernel과 AutoMegaKernel이 다음이고, 둘 다 이 글에서 내가 손으로 한 일을 기계가 하게 하려고 존재합니다. 전부 사람들이 소유한 카드에서 모델이 돌게 하는 것에 관한 것이지, 보도자료의 카드가 아닙니다.
나는 최적화 도구를 만들었으므로 당신은 이것 중 무엇도 손으로 할 필요가 없습니다. 그것을 Hugging Face의 아무 모델에, 그리고 이미 갖고 있는 아무 카드에 겨냥하세요. 그것은 천장을 계산하고, 격차를 좆는 커널을 쓰고 튜닝하고, 무엇이든 배포하기 전에 출력이 비트 정확인지 검사합니다. 여기서 내가 손으로 한 일을 그것은 스스로 합니다.
작업의 순서는 중요하고 업계는 계속 거꾸로 합니다. 다른 아키텍처를 설계하기 전에 이미 랙에 있는 것부터 짜야 합니다. 그 실리콘의 대부분은 할 수 있는 일의 한 조각으로 돌고 있고 없는 부분은 아무도 쓰지 않은 코드이기 때문입니다. 소프트웨어에서 먼저 풀지 않은 문제를 풀려고 칩을 찍으면, 열여덟 달과 팹 런을, 같은 주에 설정 플래그 하나가 줬을지 모르는 것에 지불하는 것입니다. 그리고 내가 여기서 바꾼 플래그들은 3.3배의 가치가 있었습니다.
나는 Cerebras에게서 무엇을 빼앗는 것이 아닙니다. SRAM에 가중치를 두는 것은 내내 설명해온 바로 그 병목을 죽이는, 실제 문제에 대한 실제 해결책이고, 그들은 여전히 내 앞에 있습니다. 그러나 리더보드에서 하드웨어 격차로 보이는 많은 것은 아직 아무도 쓰지 않은 소프트웨어이고, 그것은 천장을 스스로 계산하고 자신이 그것의 26퍼센트에 있다는 것을 알아챌 때만 알게 됩니다.
사람들이 하드웨어 설계라 부르는 것은 어차피 대부분 번역입니다. 모델은 연산의 그래프이고 칩은 실행 유닛과 메모리 계층의 집합입니다. 하나에서 다른 것으로 가는 것은 끝까지 컴파일러와 커널 문제입니다. 무엇이 융합되는지, 무엇이 레지스터에 머무는지, 무엇이 HBM에 흘러가는지, 텐서 코어가 어떤 루프 순서를 원하는지 결정하는 것은 당신입니다. 그 번역 계층이 성능이 사는 곳이고, 그것은 소프트웨어이며, 아래의 실리콘이 NVIDIA 것이든 AMD 것이든 작년에 찍힌 것이든 같은 계층입니다.
그래서 이것 중 무엇도 영구적이라 생각하지 않고, 가장 분명한 경우는 AMD입니다. 실리콘은 좋고 대역폭은 있습니다. 실제 작업에서 NVIDIA와의 격차는 트랜지스터가 아니라 스택입니다. 소프트웨어가 더 큰 몫이라면 격차는 소프트웨어를 씀으로써 좁혀지고, 이것은 새 팹이 필요한 것보다 훨씬 나은 위치입니다. 우리는 에이전트를 다음에 AMD로 확장합니다. 흥미로운 시험은 빠른 칩을 더 빠르게 하는 것이 아니라, 사람들이 접어둔 하드웨어에서 NVIDIA급 수에 도달하는 것이기 때문입니다.
칩 회사들만도 아닙니다. OpenAI와 Broadcom은 6월에 Jalapeno라는 추론 칩을 내놓았고, Anthropic은 8월에 사내 실리콘 팀을 확인했으며, 둘 다 토큰당 비용을 대략 절반 깎는 것에 대해 말합니다(openai.com/index/openai-broadcom-jalapeno-inference-chip). 세계 최고의 소프트웨어 회사 둘이 다음 투자 장소가 하드웨어 계층이라고 정했습니다.
나는 그것을 대부분 사람들과 다르게 읽습니다. 칩을 찍어 추론 비용의 절반을 되돌려받는다면, 정말로 되사는 것의 일부는 이미 갖고 있는 GPU에서 결코 얻지 못한 효율입니다. 나는 그것이 그들에 대한 비판이라 생각하지 않습니다. 이 글에서 내가 측정한 바로 그 26퍼센트가, 팹 런으로 고칠 가치가 있는 규모에 앉아 있는 것일 뿐입니다.
내가 덜 확실한 것은 다음에 무엇이 일어나는가입니다. CUDA가 B200에서 72퍼센트에 도달하기 쉬운 이유이고, CUDA는 컴파일러, 라이브러리, 커널, 프로파일러, 그리고 시체가 어디 묻혔는지 아는 사람들의 18년입니다. 해자는 트랜지스터가 아니라 그것입니다. 새 칩은 그 모두에서 영에서 시작합니다. 더 나은 설계이면서도 질 수 있습니다. 칩을 실제로 얼마나 쓸 수 있는가를 결정하는 것은 그 주변의 소프트웨어이고, 그것은 만드는 데 몇 년이 걸립니다.
그래서 아무 커스텀 칩에 대해 내가 물을 질문은 실리콘이 얼마나 빠른가가 아닙니다. 소프트웨어가 따라오는가입니다. 다음 분기에 바꿀 모델에서, 아직 아무도 발명하지 않은 기술에서, 컴파일러가 결코 쓰여지지 않은 모양에서 여전히 빠를 것인가. GPU는 그 모두에 재컴파일 하나로 답합니다.
커스텀 추론 칩은 하나의 워크로드가 실리콘에 굽기에 충분히 오래 멈춰 있으리라는 내기입니다. 추측 디코딩은 3년 전에 현재의 형태로 존재하지 않았고 다음 기술도 아직 존재하지 않습니다. 그것이 도착하면, 성숙한 컴파일러를 갖춘 프로그래밍 가능 하드웨어 위의 사람들은 몇 주 안에 배포할 것입니다. 그것을 찍어낸 사람들은 그렇지 못할 것입니다.
PyTorch 함수를 호출하는 것에서 그 아래의 커널을 쓰는 것으로 옮겼을 때가 기억납니다. 성능을 위해 한 단계 내려간다고 생각했고, 지금은 더 확실합니다. 통제를 위해 한 단계 내려간 것이라고. 성능은 기본값이 당신을 대신해 정한 것을 받아들이기를 멈출 때 얻는 것이기 때문입니다.
그래서 사람들이 더 멋진 데모가 있는 것이 아니라 왜 이것을 계속하느냐고 물을 때, 그것이 답입니다. 하드웨어는 계속 좋을 것입니다. 당신이 그것을 얼마나 보게 되는지를 결정하는 부분은 소프트웨어이고, 지금 거의 아무도 그것을 쓰지 않고 있습니다. 그것이 중요한 조각이고, 내가 누구든 손 뻗을 수 있게 하고 싶은 조각입니다.