
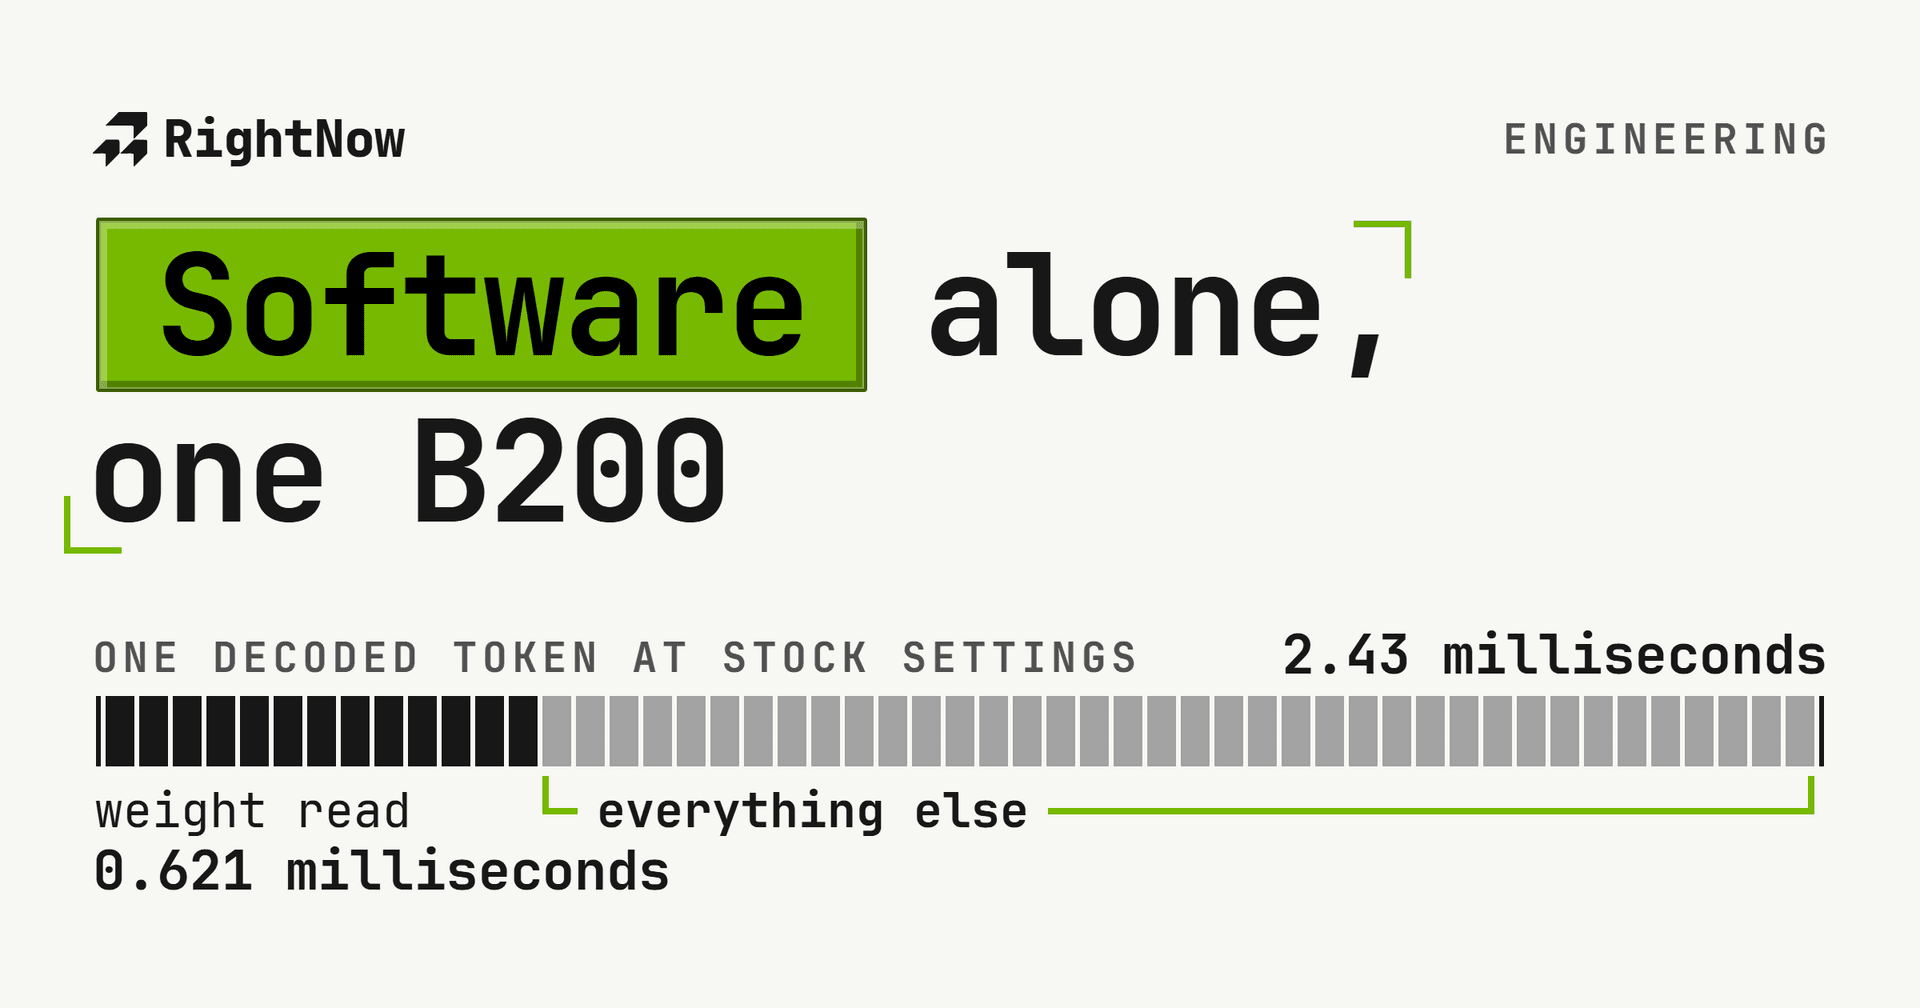
仅靠软件,一张 B200 胜过 LPU 并逼近 Cerebras
, 阅读时间 16 分钟, By Jaber Jaber
工程编者按: 本文首发于我们更早的网站。这里描述的优化产品已退役。RightNow 通过其 API 提供开放模型。
更正,2026 年 8 月 9 日
本文于 8 月 6 日发布后,Artificial Analysis 更改了其提供商中位数。8 月 6 日本文使用的对比点是 Cerebras 1,991 tok/s、SambaNova 708、Groq 476、Google Vertex 423、Databricks 324、Azure 300、Amazon 101 和 CoreWeave 33。8 月 9 日来源读数为 Cerebras 1,891、SambaNova 706、Groq 477、Google Vertex 391、Azure 312、Baseten 195、Amazon 86 和 CoreWeave 36;Databricks 在当前图表中没有报告速度。下文当前的行文和表格使用 8 月 9 日的数值。原始的 8 月 6 日图表图像仍作为带日期的发布快照保留可见。
现在每年都有人为推理推出新的芯片。Cerebras 把权重放在一整片晶圆上,Groq 造了 LPU,SambaNova 造了 RDU,这三者都是快速移动 token 的真实机器。我喜欢这样的事情正在发生。推理值得为它设计硬件。
过去两年我在研究 NVIDIA 和 AMD 的 GPU 架构,为的是给 GPU 内核写一个代码编辑器。整天读那些手册会教你一张卡能做什么,然后你看人们从同一张卡上拿到的数字,两者对不上。于是我不再试图手写每个内核,开始构建能写内核的代理。我开源了 AutoKernel,它生成并调优 GPU 内核,小而可读,你能真正跟上它做的事。然后是 AutoMegaKernel,它把整个解码步融合进持久内核,让中间值永不离开芯片。这一切都为同一件事:让模型在人们已经拥有的卡上正常运行。
这就是排行榜让我在意的原因。当 8 月 6 日榜单对一个我在纸上就能算出字节预算的模型读出每秒 423 个 GPU token 时,我的第一个想法不是 GPU 慢。我的第一个想法是没人写软件。于是我决定检验,只动软件,能否在单张 B200 上缩小这个差距。
截至 8 月 9 日,Artificial Analysis 列 Cerebras 为每秒 1,891 个 token。列出的最快 GPU 提供商是 Google Vertex 的 391,然后是 Azure 的 312 和 Baseten 的 195。这使 Cerebras 领先列出的最快 GPU 4.8 倍,接近 Cerebras 发布对比中的 5 倍领先(cerebras.ai/blog/blackwell-vs-cerebras)。
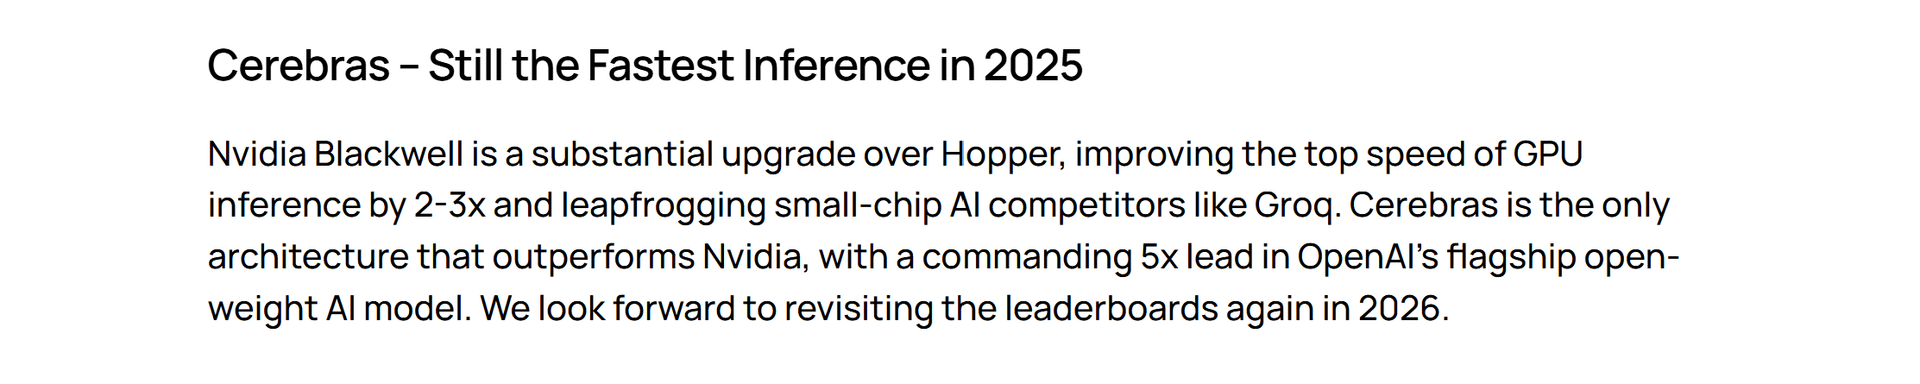
1,891 是一个硬件答案,而且是个好答案。他们把权重放在 SRAM 而不是 HBM 里,所以我们其余人苦斗的瓶颈在他们的机器上不存在。我不打算与此争辩,我也没有打赢它。
我跑对比时榜单读 423,截至 8 月 9 日读 391。那个 GPU 参考点就是我去追的数字。我在 Modal 上租了一张 B200,当我想要一张 GPU 而不想多想时就会用它,然后开始测量。开箱即用我得到每秒 411 个 token。我改了四个设置,同一张卡跑同样的权重给我 1,366,单个提示达到 2,215。我没写内核,也没重新编译任何东西。
| 指标 | 数值 | 细节 |
|---|---|---|
| 原版 SGLang | 411 tok/s | 这张卡内存带宽的 26 个百分点 |
| 四个设置之后 | 1,366 tok/s | 72 个百分点,是最快 GPU 提供商的 3.5 倍 |
| 最佳单提示 | 2,215 tok/s | 高于 Cerebras,在一张可租的卡上 |
这比当前榜单上最快的 GPU 提供商高 3.5 倍。它超过 Groq 的 477 和 SambaNova 的 706,让一张租来的卡达到晶圆的 72 个百分点。
抽象在骗你,而它没有骗硬件
你和芯片之间的每一层都在阻止你思考芯片,而且它成功了。你调用 generate,token 以某个速率出来,这个速率感觉就像机器的速度。它不是。它是你恰好调用的那些默认设置的速度。
这就是为什么出了慢的东西人们怪硬件,也为什么他们几乎总是错的。框架无法告诉你拖住你的是它自己。它不报错,一切看起来正常,它给你的数字稳定可复现,于是它感觉像物理,而它只是一个配置文件。
唯一的出路是你自己从字节数和带宽算出这张卡能做什么,然后比较。那个数字不在乎你用什么框架。
对 B200 上的 gpt-oss-120b,算术很短。解码一个 token 恰好读一次每个活跃权重:bf16 注意力 1.91 GB,mxfp4 的 top-4 路由专家 1.90 GB,bf16 的 lm_head 1.16 GB,合计每 token 4.97 GB。B200 有 8 TB/s 的 HBM3e(nvidia.com/en-us/data-center/dgx-b200),所以下限是每 token 0.621 毫秒,上限约为每秒 1,610 个 token。
原版 SGLang 每 token 花 2.43 毫秒。每个 token 的四分之三没有在读权重。
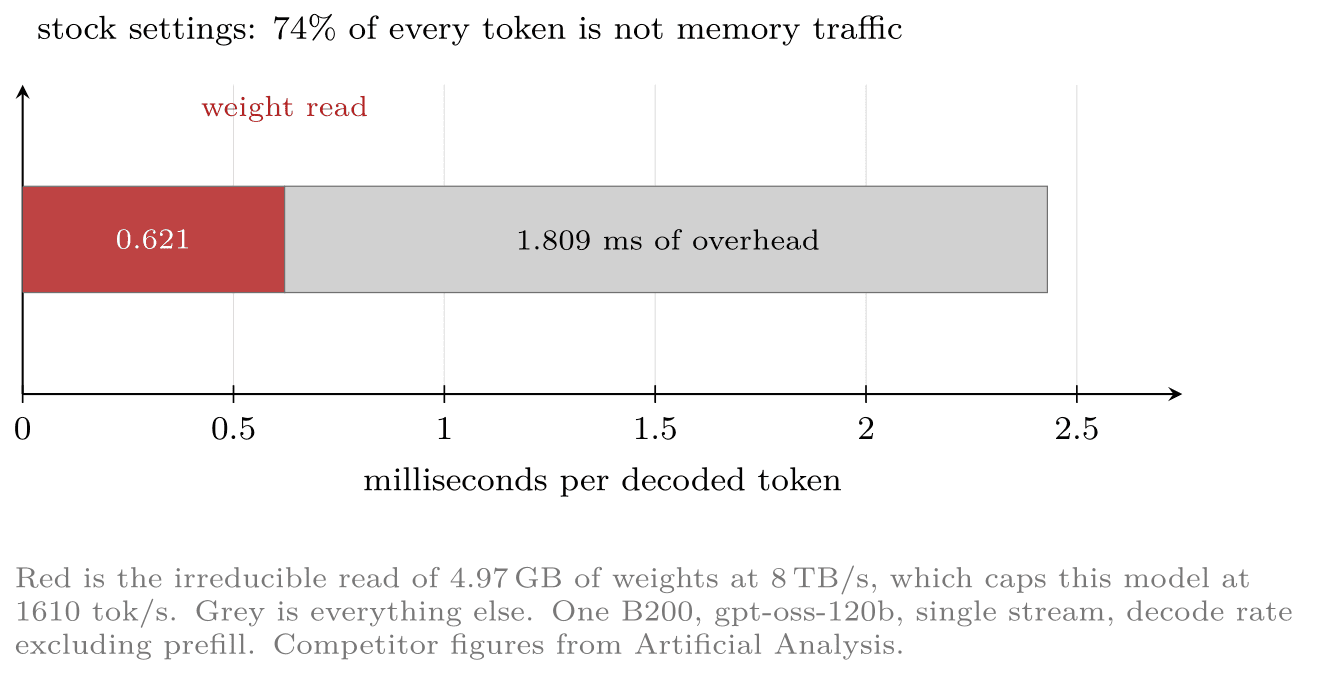
芯片四分之三的时间闲着。每一个说买更快的卡的直觉,都瞄准了那 26 个本来就在工作的百分点。
我测了什么,怎么测
我在 Modal 的单张 B200 上跑了一切,178.4 GiB HBM3e,148 个 SM。模型是 openai/gpt-oss-120b,它原生以 MXFP4 发布,每 token 激活其 120B 参数中的约 5.1B。通过 SGLang 0.5.16 服务,温度零贪心,单流,一次一个提示,四个固定提示,三次重复,取中位数。
报告的数字是不含预填充的解码速率,这也是 Artificial Analysis 对 Output Speed 的定义:收到第一个 token 之后平均每秒收到的 token 数(artificialanalysis.ai/methodology)。我选这个模型是因为三家 ASIC 厂商都在它上面发布,所以对比是同样的权重和同样的指标。
| 提供商 | tok/s | 芯片 |
|---|---|---|
| Cerebras | 1,891 | 晶圆 |
| SambaNova | 706 | RDU |
| Groq | 477 | LPU |
| Google Vertex | 391 | GPU |
| Azure | 312 | GPU |
| Baseten | 195 | GPU |
| Amazon | 86 | GPU |
| CoreWeave | 36 | GPU |
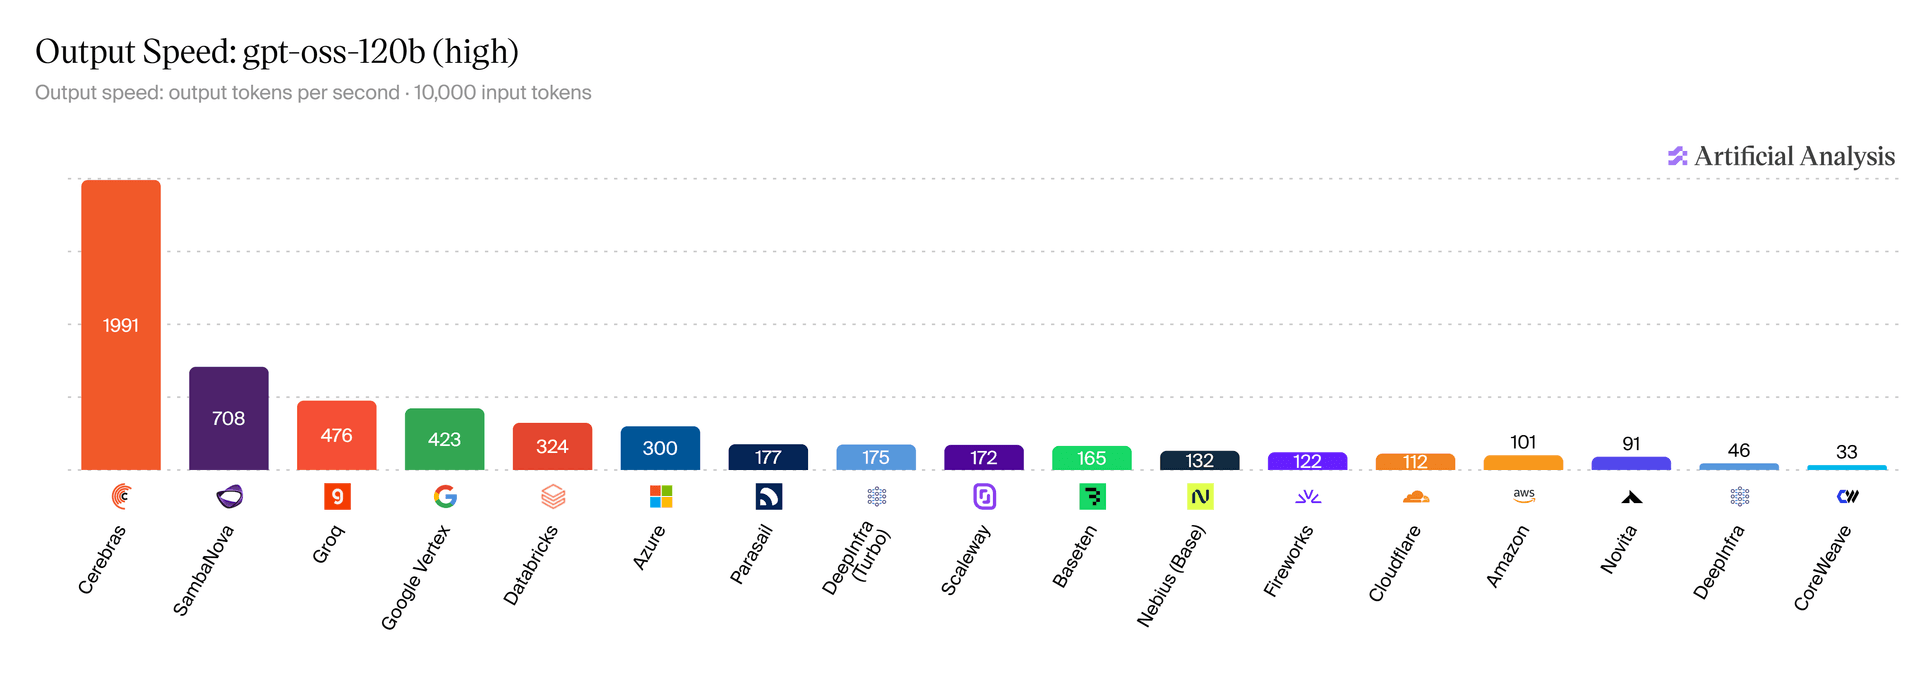
看当前榜单上实测的 GPU 列项。在相同的开放权重和指标下,它们相差 10.8 倍,从 Google Vertex 的 391 到 CoreWeave 的 36。公开图表没有把 GPU 代际与设置、内核或服务代码分开,所以这是交付的栈很重要的证据,不是一个干净的 10.8 倍纯软件估计。
阶梯
| 步骤 | tok/s |
|---|---|
| 原版默认 | 411.2 |
| 延迟旋钮 | 429.9 |
| n-gram 投机解码 | 628.5 |
| speculative_attention_mode=decode | 697.1 |
| 宽 n-gram 搜索 | 1,165.1 与 1,366.2 |
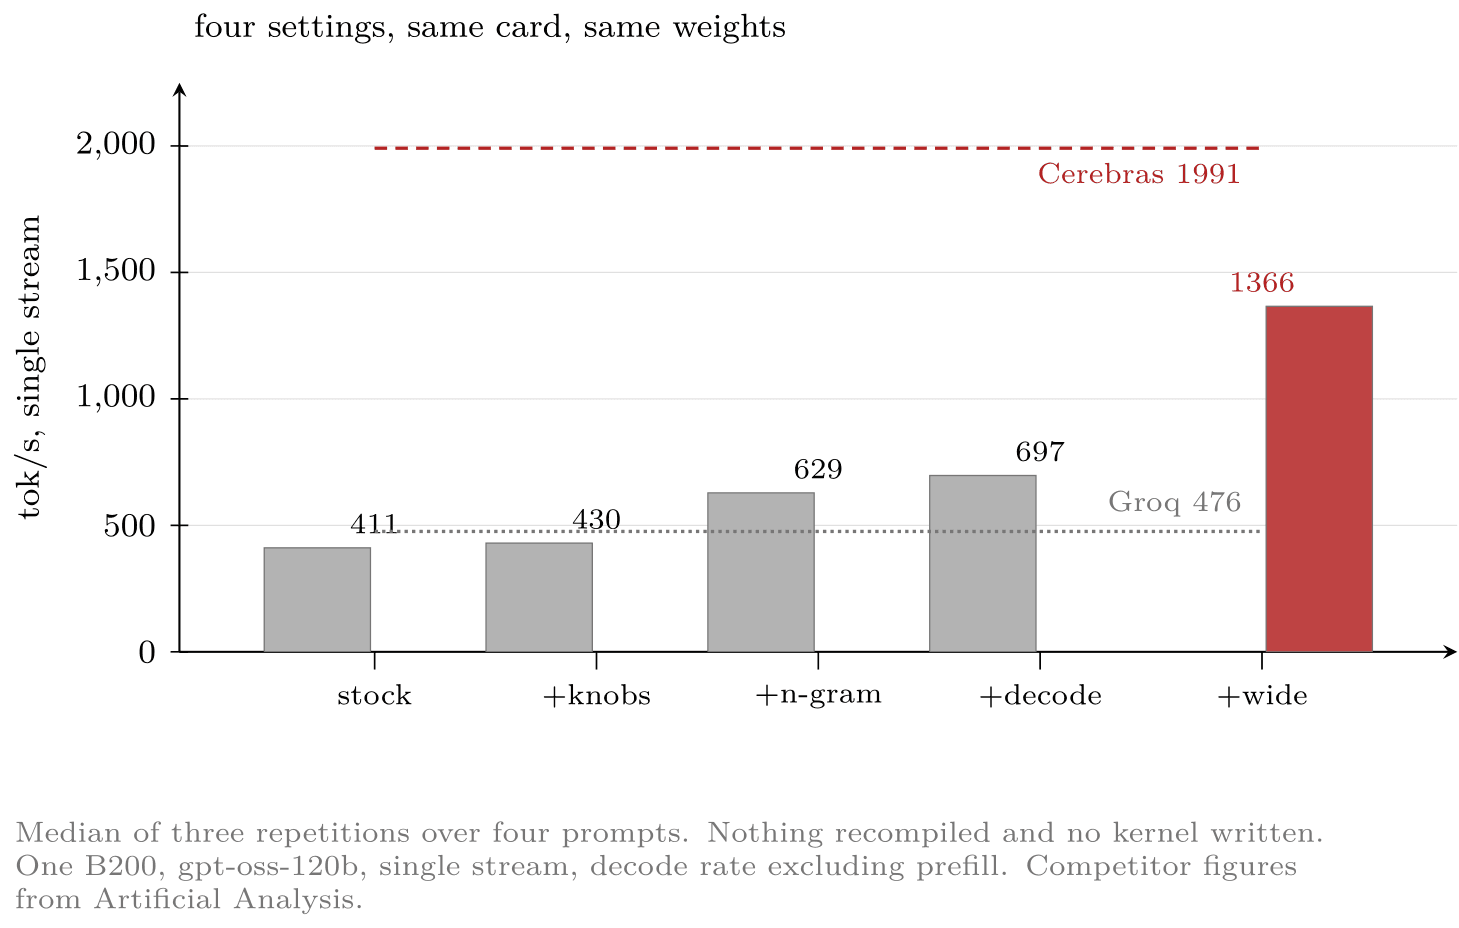
第一级很小。SGLang 默认 stream_interval 为 1,所以它在每个 token 上做反词元化和分发,scheduler_recv_interval 也默认为 1,所以它每次迭代都轮询。在 0.621 毫秒的预算里这是真金白银,修好它买了 4.5 个百分点。
第二级是投机解码,同一个给 Groq 带来六倍的技巧。一个草稿提出若干 token,目标在一次前向中验证它们,每个被接受的 token 都是免掉一次单独 4.97 GB 权重读取而产出的 token。我用不了训练过的草稿头,原因在失败一节,所以这是 n-gram 投机,它靠匹配已生成文本中的模式来起草。
第三级是一个我从没碰过的标志。speculative_attention_mode 默认为 prefill,把它设成 decode 带来 9.7 个百分点。
最后一行是两个数字,因为我把那个配置跑了两遍,两个都得到了,相同设置下相差 17 个百分点。N-gram 接受率取决于前缀树积累了什么,所以同一配置每次运行落在不同位置。如果我引用较好的那个,我是在挑数字,不是在测数字。
那级关键的阶梯是通过弄坏它找到的
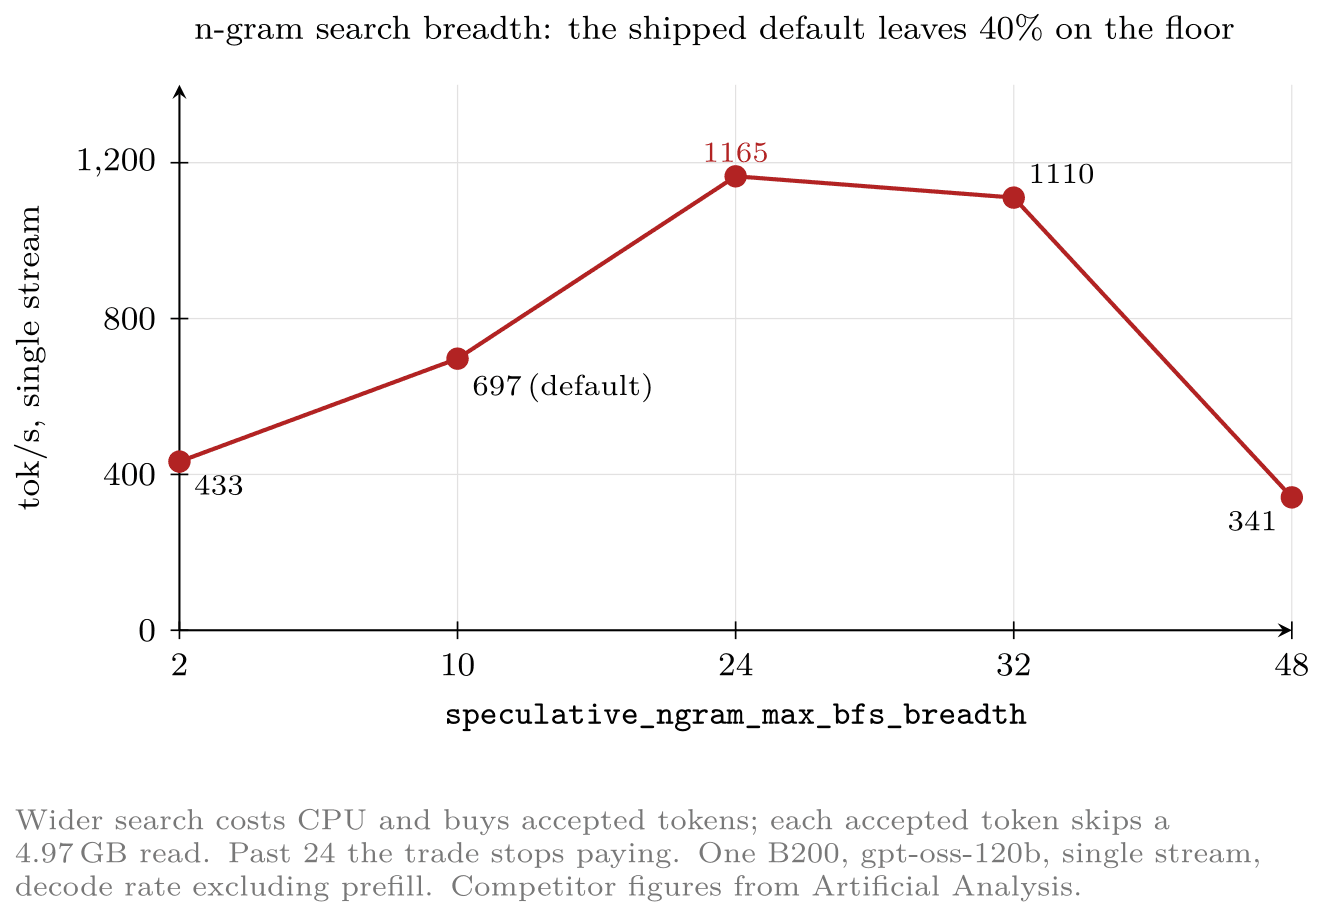
有人告诉我,说得有道理,CPU 的 n-gram 提议器在与 GPU 串行化,它的搜索开销是瓶颈。于是我把它砍小,max_bfs_breadth 从 10 到 2,max_trie_depth 从 18 到 8,预期开销下降。
吞吐塌到 433.0。
这次失败比一次小赢更值钱
它说明搜索不是开销,它是挣来 token 的东西。提议者探索的每个额外候选都是多接受一个 token 的机会,每个被接受的 token 跳过一次完整的 4.97 GB 读取。花几百微秒 CPU 避开 0.621 毫秒的 HBM 流量,这是一笔你想不断做的交易。
于是我把旋钮往另一头拧,曲线有一个尖锐的峰。
| max_bfs_breadth | tok/s |
|---|---|
| 2 | 433.0 |
| 10,默认 | 697.1 |
| 24 | 1,165.1 |
| 32 | 1,110.4 |
| 48 | 341.1 |
出厂默认是 10,你可以从文档上直接读出来。
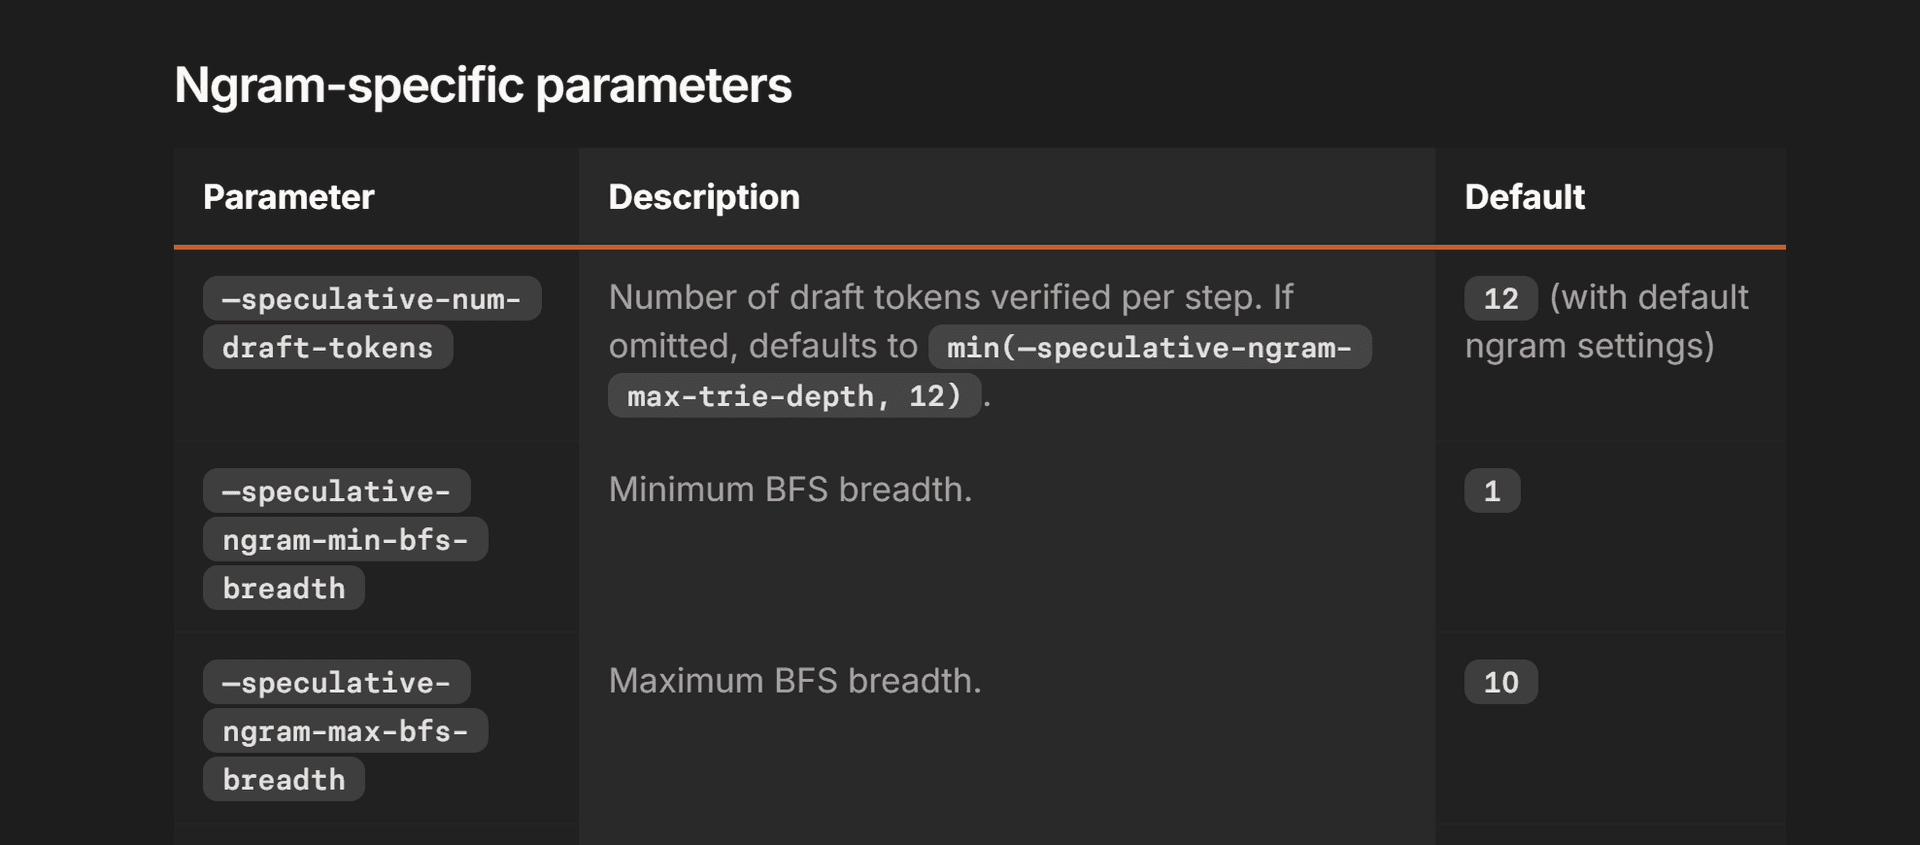
对单流解码,这把约 40 个百分点留在了地上,过了 24,CPU 搜索不再回本,跌下悬崖。默认值不是失误。它为吞吐服务而设,那里许多请求共享 GPU,CPU 时间紧张。对一个用户等一条流来说它是错误的默认,而栈里没有任何东西告诉你你在做这两者中的哪一个。
落在哪里
| 提供商 | tok/s | 比值 |
|---|---|---|
| 一张 B200,两次运行 | 1,165.1 到 1,366.2 | |
| Groq | 477 | 快 2.44 到 2.87 倍 |
| SambaNova | 706 | 快 1.65 到 1.94 倍 |
| Cerebras | 1,891 | 0.62 到 0.72 倍 |
按提示计,两次运行测得每秒 447.8、1930.8、1882.5、219.1,然后是 525.3、2207.0、2215.6、291.9 个 token。这八个读数中有三个高于 Cerebras 当前的 1,891 中位数,在一张可租的 GPU 上。
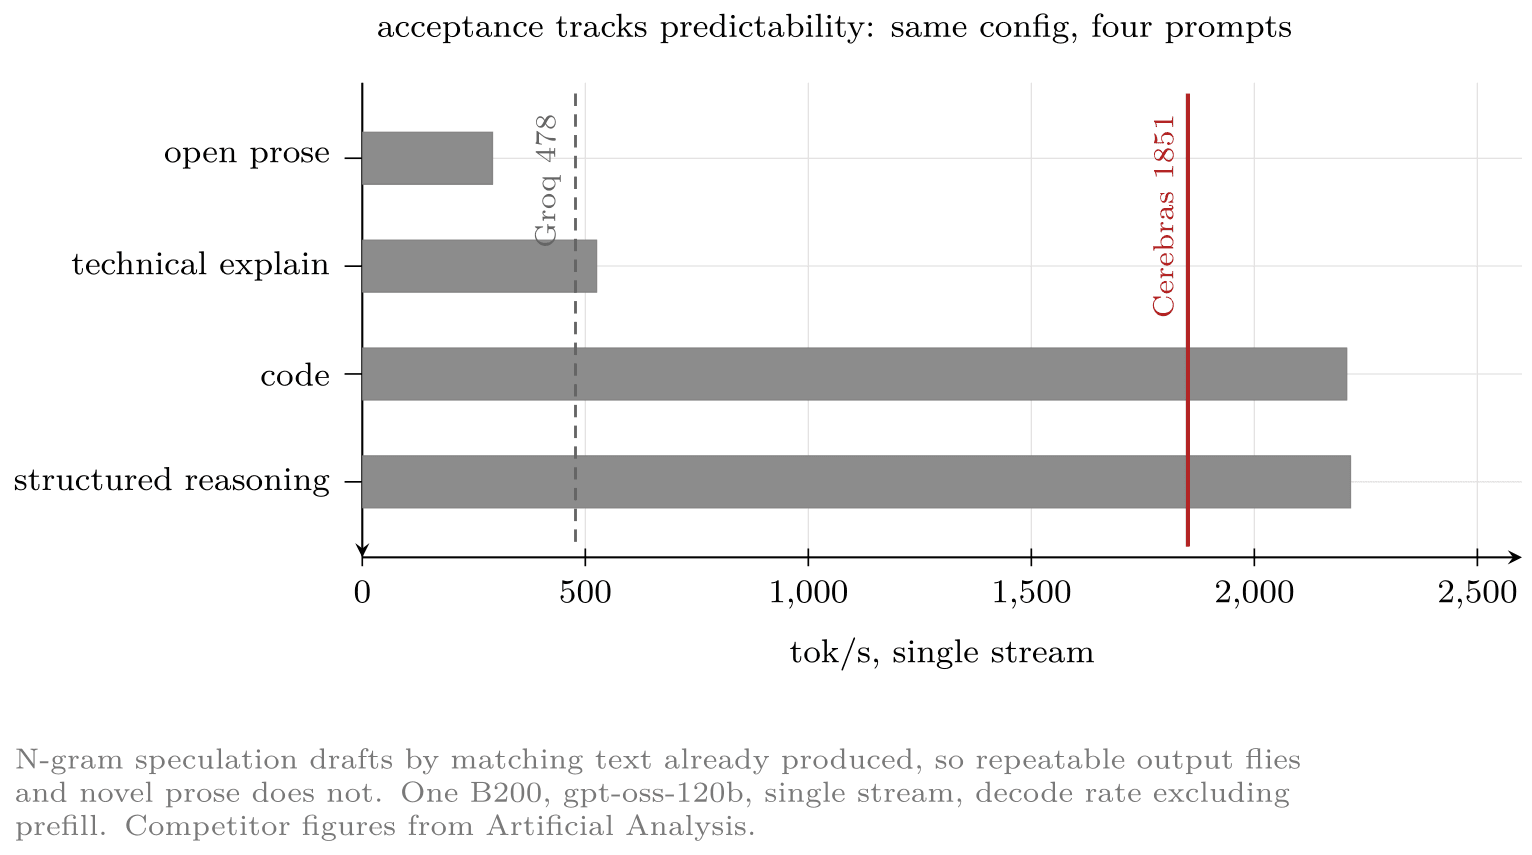
这个差距是全文最有用的东西,所以我把它摆出来,而不是躲在中位数后面。N-gram 投机靠匹配它已产出的文本来起草,所以措辞重复的结构化推理跑在 2,200 之上,而从不自我重复的开放散文跑 219。这个技巧的回报恰好等于输出的可预测程度。报告单一数字的厂商是在对他们自己的提示组合取平均,你完全看不到这个形状。
投机改变什么,不改变什么
贪心验证是让这一切诚实的东西。一个起草的 token 只有在与目标模型自己会产出的 token 相同处才被接受,第一个不匹配处之后草稿的剩余部分被丢弃,改取目标的 token。所以贪心验证下的投机是精确的,不是近似的。它改变你花多少次前向,不改变出来的是哪些 token。
如果你自己去验证这一点
把一次投机运行与一个配置不同的非投机运行相比,测的不是投机,测的是内核。切换注意力后端改变浮点归约的顺序,在两个 logits 几乎并列处,那个重排翻转 argmax。你的对照必须固定其他所有设置,只单独开关投机。而且比较 token id,永远不要比较文本,用显式的长度检查而不是 zip,zip 会截到较短的一侧,会把一个中途死掉的运行报告为位精确。我知道,因为这个项目的早些时候我写过那个 bug,它让一个已经崩溃的内核通过了。
什么没成功,即大部分
十五个配置,失败比成功告诉你更多。
两个已发布的 EAGLE-3 草稿头都低于完全不用投机,NVIDIA 的 417.6,SGLang 团队的 325.0,因为接受率接近零。NVIDIA 是对着他们的 NVFP4 检查点训练的,而这个是 MXFP4 的,一个永远猜不对的草稿让你白付草稿这一遍。
让 NVIDIA 的头能加载这件事本身就值得记录。它以张量不匹配失败,8640 对 5760,即三倍隐藏宽度对两倍。SGLang v0.5.16 映射草稿请求的捕获层时差一,所以三个请求层的最后一个落在循环之外,同一版本还静默丢弃了检查点的 input_norm 权重,因为它从不构建那个模块。两者都在上游 commit 5df193b4ac 中修复,v0.5.16 打标签六天后合入。带修复的 nightly 能加载它,它还是输了。
除 triton 外的每个注意力后端在这里都不可用。FlashAttention 3 要求 SM 80 到 90,而 B200 是 SM100。FA4 强制页大小 128,trtllm_mha 强制 64,然后 SGLang 拒绝在分页后端上运行宽于一个 token 的投机树,因为会产生错误结果。我很高兴撞上的是那个护栏,而不是悄悄拿到错误答案。triton MoE 运行器在 156 GiB 处 OOM,因为它把 MXFP4 反量化回 bf16。torch.compile 先断言然后在同一路径 OOM。带真实草稿模型的 DFLASH 达到 493.5,比没有强,比 n-gram 差。
诚实的注意事项
他们在生产端点上服务真实流量,而我在一台租来的机器上跑四个固定提示,所以这不是干净的对决,我也不打算假装它是。Artificial Analysis 还送 10,000 个输入 token,而我的提示大约三十个,更长的提示意味着每步要读更多 KV 缓存,所以他们在做更难的工作。这有利于我的数字,所以你比较时把它砍掉一些。
把权重保存在 SRAM 里的晶圆在这个问题上是真正的架构优势,不是营销。Cerebras 快,因为片上内存消掉了我一直在描述的瓶颈,再多的内核工作也变不出 SRAM 来替代 HBM。他们的中位数仍然胜过我。
一张能按小时租的卡,跑你能下载的权重,四个设置之后达到每秒 1,165 到 1,366 个 token,这胜过三款定制芯片中的两款。脚本在仓库里,每个提示的原始 JSON 也在,所以你可以自己去看那个差距,而不是信我。
我为什么造我造的东西
原版配置达到这台机器内存带宽的 26 个百分点。四个设置把它带到 72。没有人换硬件,那 2.8 倍一直坐在一个从头到尾没报过任何错误抽象里面。
我年轻,我是内核新手,我也不是世界上写内核最好的人。我擅长的是构建写内核的代理,我认为那是更有用的技能。能手工调优内核的人稀缺且不可扩展,而每张新卡上的每个新模型都要把工作重做一遍。内核工作是下一个十年性能的来源,不是下一座工厂。代码编辑器出自那两年读架构手册的日子,我已经停止支持它。接下来是 AutoKernel 和 AutoMegaKernel,两者的存在都是为了用机器做我在本文里用手做的事。这一切都是为了让模型在人们拥有的卡上运行,而不是新闻稿里的那些。
我造了一个优化器,这样你就不必手工做这些。你把它指向 Hugging Face 上的任意模型和你已有的任何卡。它算出你的上限,写好并调优缩小差距的内核,在交付任何东西之前检查输出位精确。我在这里用手做的工作,它自己就能做。
操作的顺序很重要,而整个行业一直做反。在设计另一种架构之前,我们应该先挤干已经上架的东西,因为那大部分硅运行在其能力的一小部分上,缺的是没人写的代码。为了解决一个你还没有先在软件里解决的问题而流片,意味着为某个配置标志可能在同一周就给你的东西付出十八个月和一次流片,而我在这里改的这些标志值 3.3 倍。
我没有贬低 Cerebras 的意思。把权重放进 SRAM 恰好消掉了我一直在描述的瓶颈,那是对真实问题的真实修复,他们仍然在我前面。但排行榜上看起来像硬件差距的东西,很多是还没人写的软件,而只有自己算出上限并注意到你在它的 26 个百分点上,你才会发现这一点。
人们称为硬件设计的东西,大部分本来就是翻译。一个模型是一个操作图,一张芯片是一组执行单元和内存层级。从一个到另一个,端到端是编译器和内核问题。你在决定什么融合、什么留在寄存器、什么溢出到 HBM,以及张量核心想要哪种循环顺序。性能就住在这层翻译里,它是软件,而且不管底下的硅来自 NVIDIA、AMD 还是去年流片的什么,它都是同一层。
所以我不认为这一切里有任何东西是永久的,最清楚的例子是 AMD。硅是好的,带宽在那里。真实工作上对 NVIDIA 的差距在栈,不在晶体管。如果软件占更大份额,那么差距可以通过写软件来缩小,这远比需要一座新工厂的处境好。我们接下来正把代理扩展到 AMD,因为有趣的测试不是把快的芯片变得更快,而是在人们已经写掉的硬件上达到 NVIDIA 级的数字。
也不只是芯片公司。OpenAI 和 Broadcom 在六月推出了一款叫 Jalapeno 的推理芯片,Anthropic 在八月确认了一个内部芯片团队,两者都在谈把每 token 成本大约减半(openai.com/index/openai-broadcom-jalapeno-inference-chip)。世界上最好的两家软件公司认定下一个值得投入的地方是硬件层。
我对此的解读与多数人不同。如果你通过流片拿回推理成本的一半,你真正买回的一部分,是你从未从已有 GPU 里拿到的效率。我不认为这是对他们的批评,它只是我在本文里测到的同一个 26 个百分点,只是处在一个值得用一次流片去修的规模上。
我不那么确定的是接下来会发生什么。CUDA 是 B200 上容易达到 72 个百分点的原因,而 CUDA 是十八年的编译器、库、内核、分析器,还有知道坑在哪的人。那才是护城河,不是晶体管。一款新芯片在所有这些上从零开始。它可以是更好的设计却仍然输,因为决定你实际能用上多少芯片的是它周围的软件,而那些要花多年去建。
所以对任何定制芯片我会问的问题不是硅有多快,而是软件跟不跟得上。下季度你换的那个模型上,在还没人发明的新技巧上,在编译器从未为之写过的形状上,它还会快吗。GPU 用一次重编译回答所有这些。
定制推理芯片是一场赌注,赌一个工作负载静止得足够久,能把它烧进硅里。三年前投机解码还不存在现在的形式,下一个技巧也还不存在。它到来时,在可编程硬件上带着成熟编译器的人会在几周内交付它。把它流片进硅的人不会。
我记得从调用 PyTorch 函数转到写它们底下的内核时,我以为我是为了性能往下走一层,现在我更确信我是为了控制往下走一层,因为性能是当你不再接受默认替你决定的东西时得到的。
所以当人们问我为什么一直做这个,而不是做个演示更漂亮的东西时,这就是答案。硬件会一直好下去。决定你能不能看到它的那一部分是软件,而现在几乎没人在写它。那才是要紧的那块,也是我希望任何人都能伸手拿到的那块。