
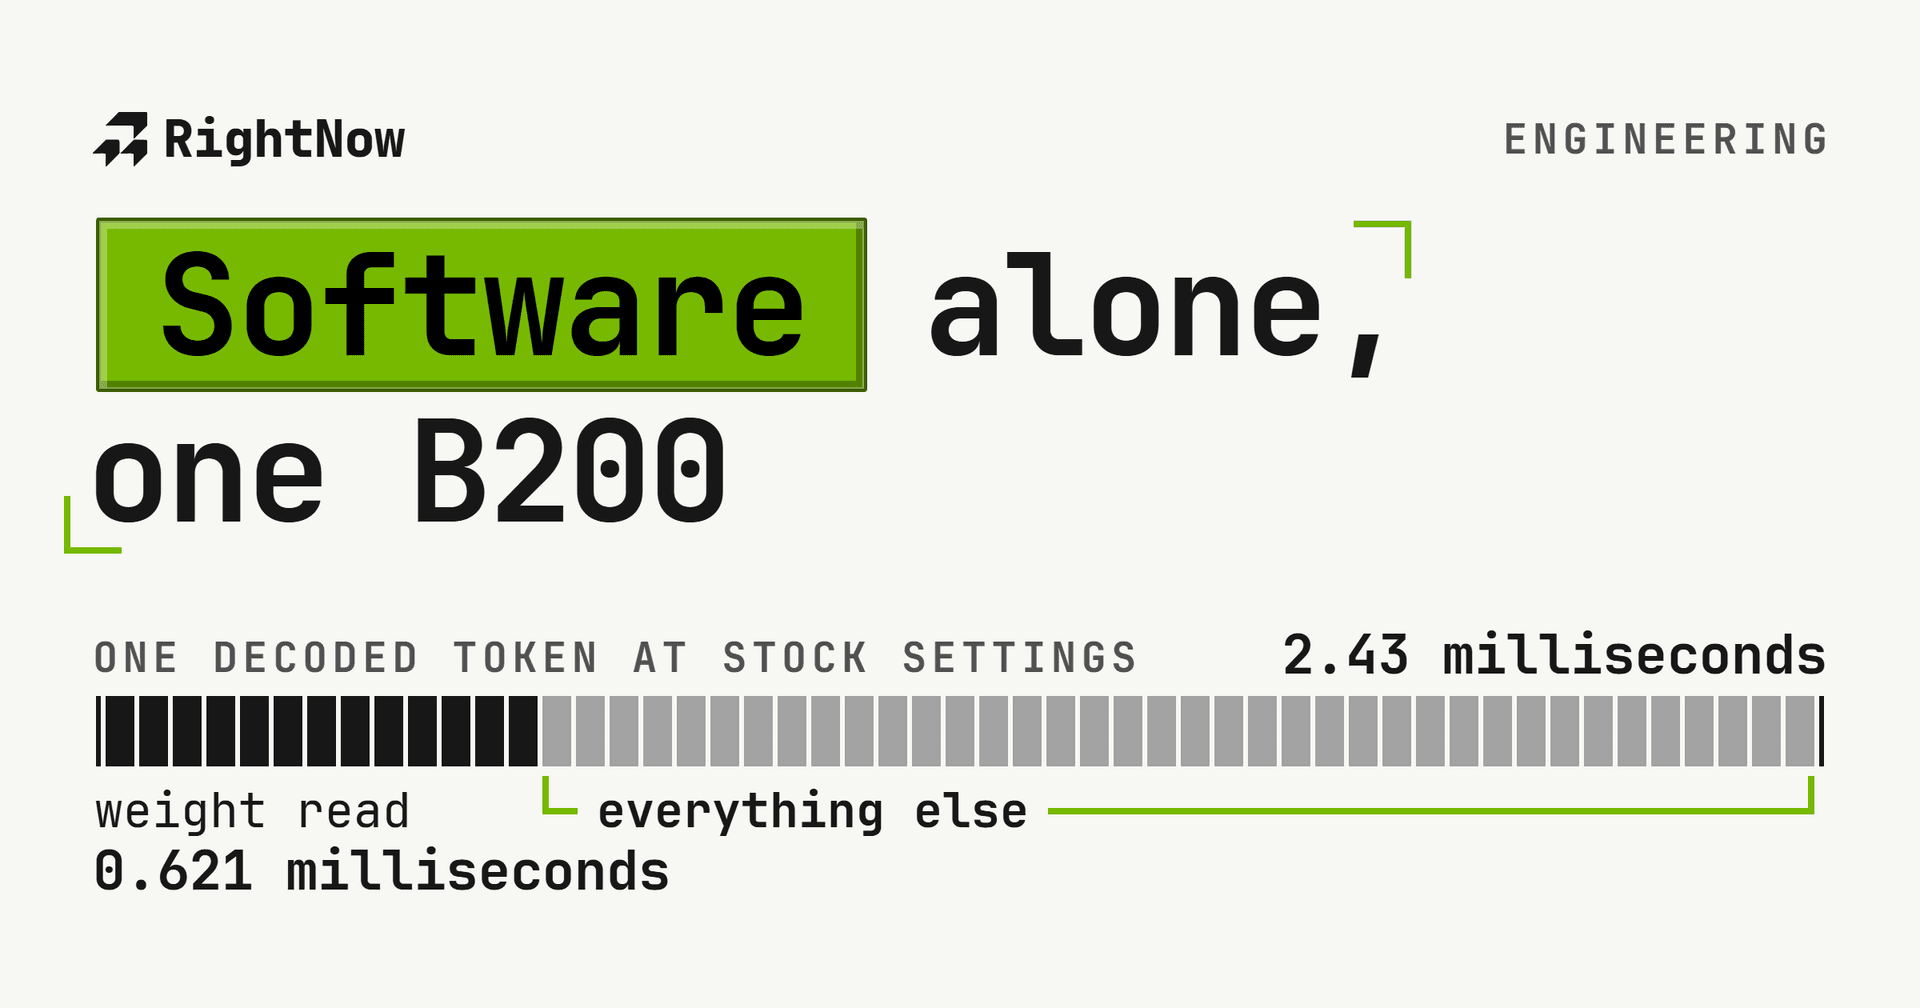
Só com software, uma B200 supera a LPU e chega perto da Cerebras
, 16 min de leitura, By Jaber Jaber
EngenhariaNota editorial: Este artigo foi publicado primeiro no nosso site anterior. O produto de otimização descrito aqui está aposentado. A RightNow serve modelos abertos por sua API.
Correção, 9 de agosto de 2026
A Artificial Analysis mudou suas medianas de provedores depois que este artigo foi publicado em 6 de agosto. Em 6 de agosto os pontos de comparação usados aqui diziam Cerebras 1,991 tok/s, SambaNova 708, Groq 476, Google Vertex 423, Databricks 324, Azure 300, Amazon 101 e CoreWeave 33. Em 9 de agosto a fonte diz Cerebras 1,891, SambaNova 706, Groq 477, Google Vertex 391, Azure 312, Baseten 195, Amazon 86 e CoreWeave 36; Databricks não tem velocidade reportada na tabela atual. A prosa e as tabelas abaixo usam os valores de 9 de agosto. As imagens originais da tabela de 6 de agosto continuam visíveis como instantâneos datados da publicação.
Todo ano agora alguém publica silício novo feito para inferência. A Cerebras pôs os pesos numa wafer, a Groq construiu a LPU, a SambaNova construiu a RDU, e as três são máquinas reais que movem tokens rápido. Gosto que isso esteja acontecendo. Inferência merece que se projete hardware para ela.
Passei os últimos dois anos estudando a arquitetura de GPU da NVIDIA e da AMD para construir um editor de código para kernels de GPU. Ler esses manuais o dia todo ensina o que uma placa pode fazer, e depois você olha o que as pessoas estão tirando da mesma placa e os dois números não batem. Então parei de tentar escrever cada kernel à mão e comecei a construir agentes que os escrevem. Publiquei como código aberto o AutoKernel, que gera e afina kernels de GPU, pequeno e legível para você conseguir acompanhar o que ele faz. Depois o AutoMegaKernel, que funde um passo inteiro de decodificação em kernels persistentes para os intermediários nunca saírem do chip. Tudo é para a mesma coisa: fazer os modelos rodarem direito nas placas que as pessoas já têm.
É por isso que as tabelas de classificação me incomodam. Quando a tabela dizia 423 tokens de GPU por segundo em 6 de agosto para um modelo cujo orçamento de bytes eu resolvia no papel, meu primeiro pensamento não foi que a GPU era lenta. Meu primeiro pensamento foi que ninguém escreveu o software. Então decidi verificar se eu podia fechar essa lacuna numa única B200 sem tocar em nada além do software.
Em 9 de agosto, a Artificial Analysis lista a Cerebras em 1,891 tokens por segundo. O provedor de GPU mais rápido listado é o Google Vertex com 391, depois Azure com 312 e Baseten com 195. Isso coloca a Cerebras 4.8x à frente da GPU listada mais rápida, perto da vantagem de 5x na comparação publicada pela Cerebras (cerebras.ai/blog/blackwell-vs-cerebras).
O 1,891 é uma resposta de hardware e uma boa. Eles mantêm os pesos na SRAM em vez da HBM, então o gargalo com que o resto de nós briga não existe na máquina deles. Não vou discutir isso e não o superei.
A tabela dizia 423 quando eu rodei a comparação e diz 391 em 9 de agosto. Esse ponto de referência de GPU é o número que eu persegui. Aluguei uma única B200 na Modal, que é o que uso quando quero uma GPU sem pensar, e comecei a medir. De fábrica obtive 411 tokens por segundo. Mudei quatro ajustes e a mesma placa rodando os mesmos pesos me deu 1,366, e prompts individuais chegaram a 2,215. Não escrevi um kernel e não recompilei nada.
| Métrica | Valor | Detalhe |
|---|---|---|
| SGLang de fábrica | 411 tok/s | 26 por cento da largura de banda de memória desta placa |
| Após quatro ajustes | 1,366 tok/s | 72 por cento, e 3.5x o provedor de GPU mais rápido |
| Melhor prompt individual | 2,215 tok/s | acima da Cerebras, numa placa alugável |
Isso é 3.5x além do provedor de GPU mais rápido na tabela atual. Supera a Groq em 477 e a SambaNova em 706, e coloca uma placa alugada em 72 por cento da wafer.
A abstração mente para você, e não está mentindo sobre o hardware
Cada camada entre você e o chip existe para impedir que você pense no chip, e funciona. Você chama generate, tokens saem a alguma taxa, e essa taxa parece a velocidade da máquina. Não é. É a velocidade dos padrões que você por acaso chamou.
É por isso que as pessoas culpam o hardware quando algo está lento, e por que quase sempre estão erradas. O framework não pode dizer que ele é o que está segurando você. Ele não lança erro nenhum, tudo parece bem, e o número que ele dá é estável e repetível, então parece física quando é um arquivo de configuração.
A única saída é resolver você mesmo o que a placa pode fazer, a partir de bytes e largura de banda, e comparar. Esse número não se importa com o framework que você usa.
Para o gpt-oss-120b numa B200 a aritmética é curta. Decodificar um token lê cada peso ativo exatamente uma vez, que são 1.91 GB de atenção em bf16, 1.90 GB de especialistas roteados top-4 em mxfp4 e 1.16 GB de lm_head em bf16, então 4.97 GB por token. Uma B200 tem 8 TB/s de HBM3e (nvidia.com/en-us/data-center/dgx-b200), então o piso é 0.621 milissegundos por token e o teto é cerca de 1,610 tokens por segundo.
O SGLang de fábrica levou 2.43 milissegundos por token. Setenta e quatro por cento de cada token não era ler pesos.
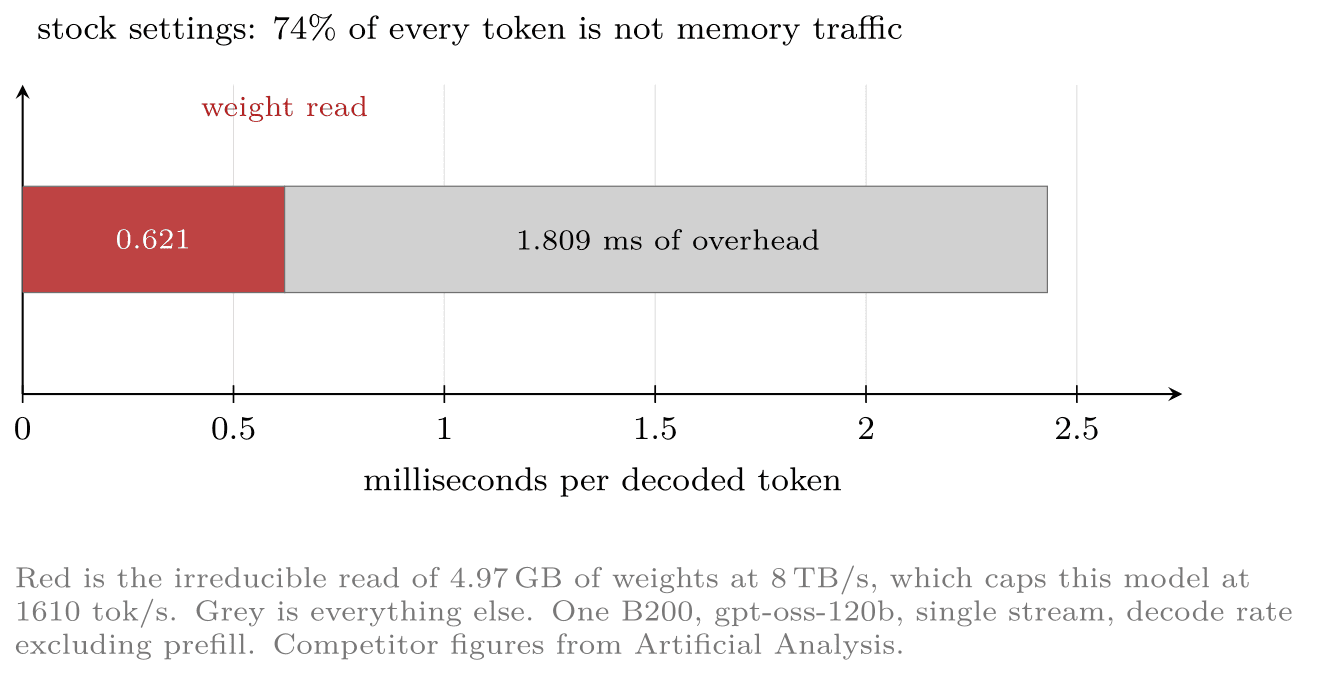
O chip ficou ocioso três quartos do tempo. Cada instinto que diz compra a placa mais rápida mira os 26 por cento que já estavam trabalhando.
O que medi, e como
Rodei tudo numa única B200 na Modal com 178.4 GiB de HBM3e e 148 SMs. O modelo é openai/gpt-oss-120b, que vem nativamente em MXFP4 e ativa cerca de 5.1B dos seus 120B parâmetros por token. Servindo com SGLang 0.5.16, greedy a temperatura zero, fluxo único, um prompt por vez, quatro prompts fixos, três repetições, mediana.
O número reportado é a taxa de decodificação excluindo o prefill, que é como a Artificial Analysis define Output Speed, o número médio de tokens recebidos por segundo depois do primeiro token recebido (artificialanalysis.ai/methodology). Escolhi este modelo porque os três fabricantes de ASIC publicam com ele, então a comparação é os mesmos pesos e a mesma métrica.
| Provedor | tok/s | Silício |
|---|---|---|
| Cerebras | 1,891 | wafer |
| SambaNova | 706 | RDU |
| Groq | 477 | LPU |
| Google Vertex | 391 | GPU |
| Azure | 312 | GPU |
| Baseten | 195 | GPU |
| Amazon | 86 | GPU |
| CoreWeave | 36 | GPU |
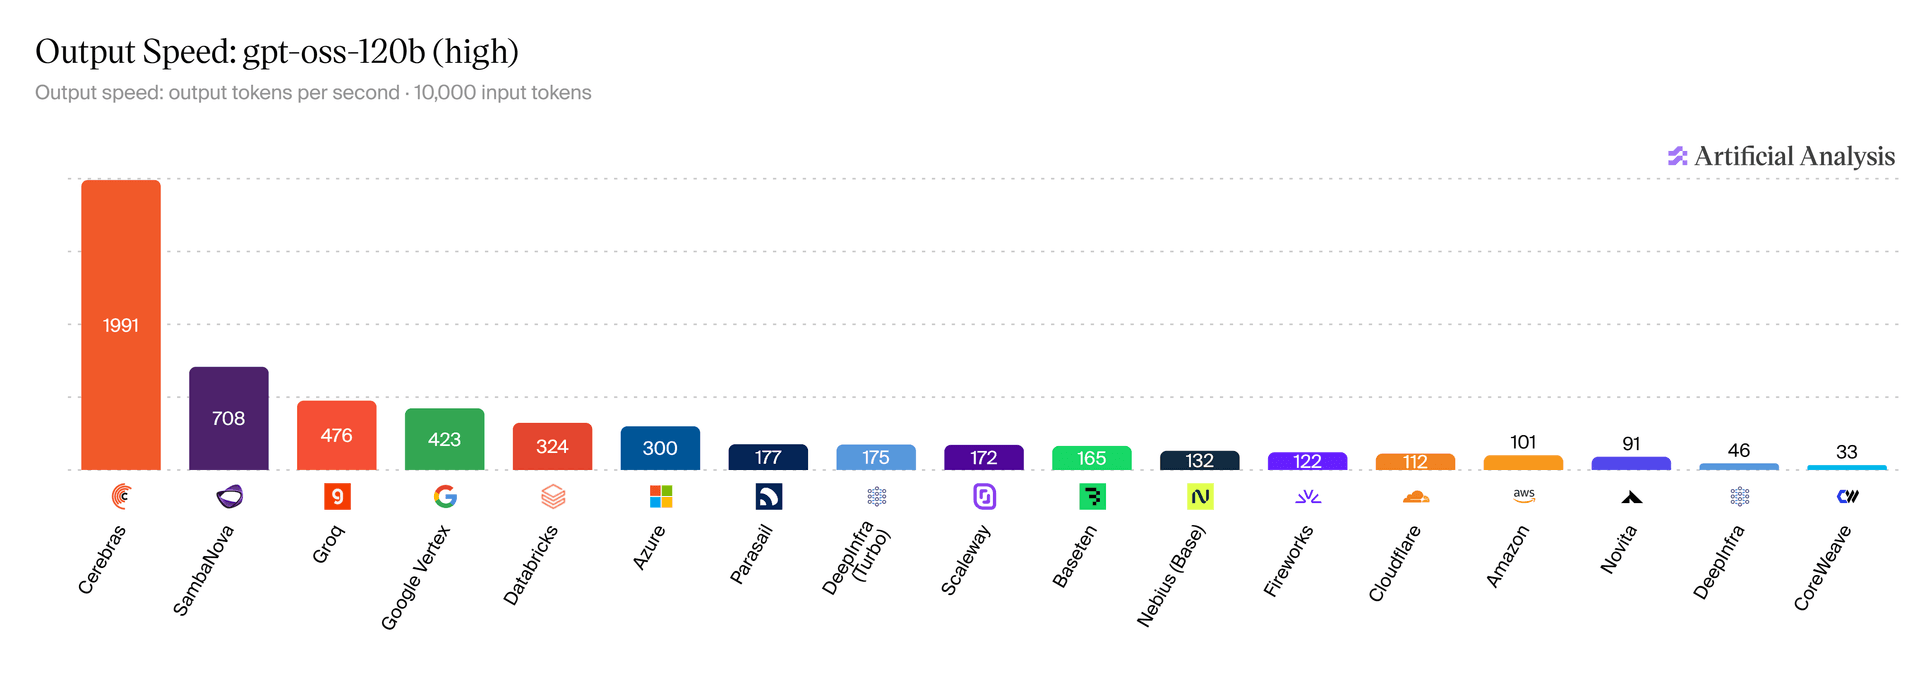
Olhe as medições de GPU listadas na tabela atual. Elas ficam a 10.8x de distância, do Google Vertex em 391 até a CoreWeave em 36, com os mesmos pesos abertos e a mesma métrica. A tabela pública não isola a geração da GPU dos ajustes, kernels ou código de serving, então isso é evidência de que a pilha entregue importa, não uma estimativa limpa de 10.8x só de software.
A escada
| Passo | tok/s |
|---|---|
| padrões de fábrica | 411.2 |
| botões de latência | 429.9 |
| decodificação especulativa n-gram | 628.5 |
| speculative_attention_mode=decode | 697.1 |
| busca n-gram ampla | 1,165.1 e 1,366.2 |
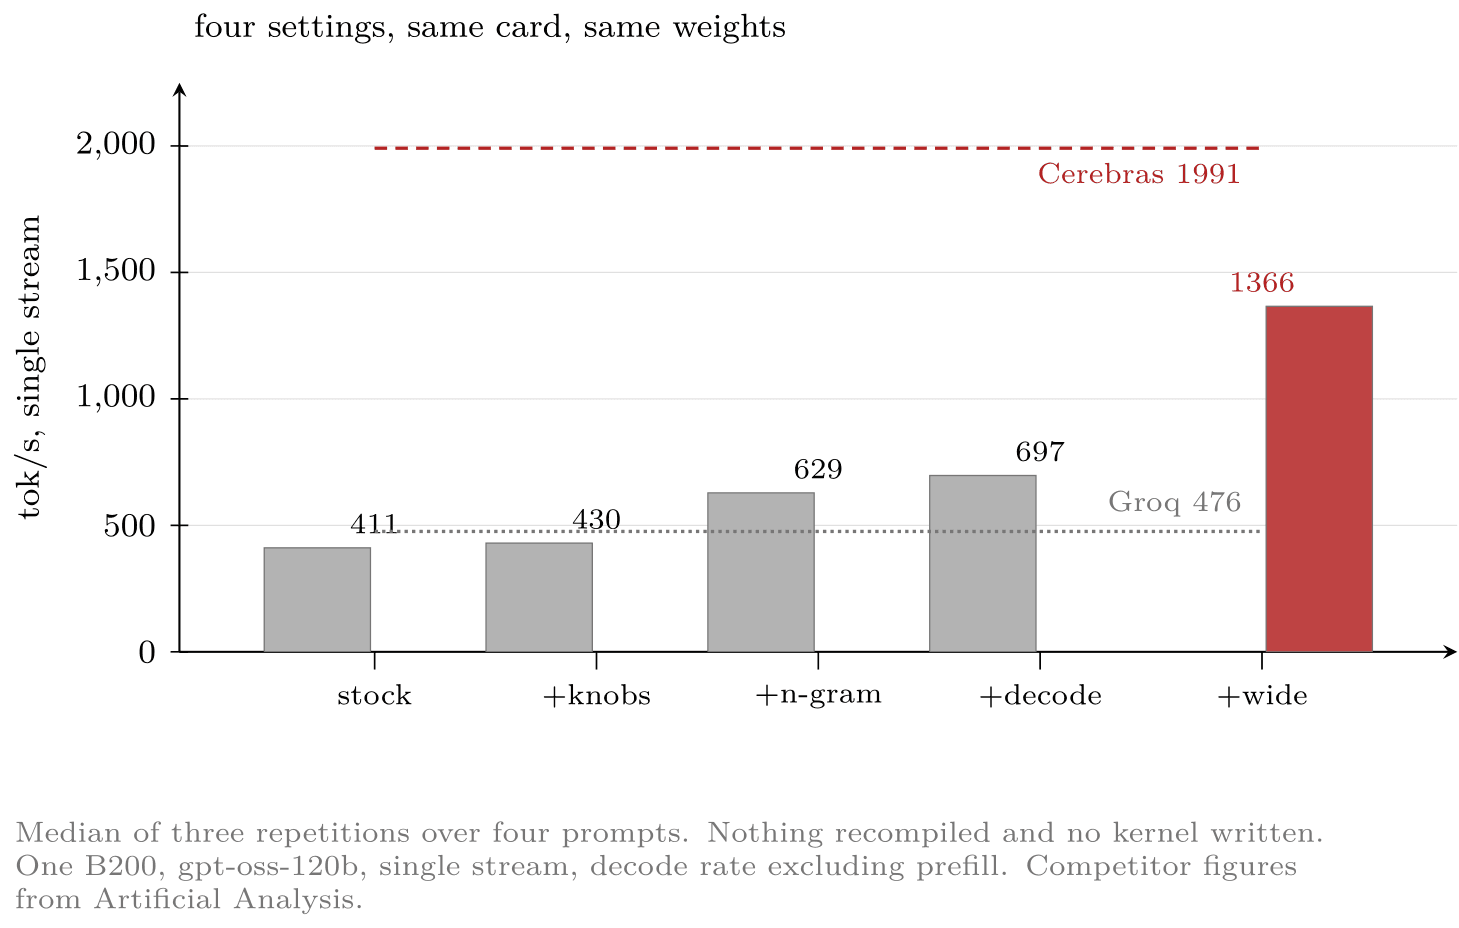
O primeiro degrau é pequeno. O SGLang traz stream_interval em 1 por padrão, então destokeniza e despacha em cada token, e scheduler_recv_interval em 1, então consulta a cada iteração. Num orçamento de 0.621 milissegundos isso é dinheiro real, e consertar comprou 4.5 por cento.
O segundo degrau é a decodificação especulativa, o mesmo truque que deu à Groq suas seis vezes. Um rascunho propõe vários tokens, o alvo os verifica numa passada, e cada token aceito é um token produzido sem uma leitura separada de 4.97 GB de pesos. Não pude usar uma cabeça de rascunho treinada, por razões na seção de falhas, então isto é especulação n-gram, que rascunha casando padrões no texto gerado até agora.
O terceiro degrau foi um flag que eu nunca tinha tocado. speculative_attention_mode vem em prefill por padrão, e pô-lo em decode deu 9.7 por cento.
A última linha são dois números porque rodei essa configuração duas vezes e obtive ambos, uma dispersão de 17 por cento em ajustes idênticos. A aceitação n-gram depende do que o trie construiu, então a mesma configuração aterrissa num lugar diferente a cada rodada. Se eu citasse o melhor estaria escolhendo um número, não medindo.
O degrau que importava foi encontrado quebrando-o
Me disseram, com razão, que o propositor n-gram de CPU serializava com a GPU e que o custo da busca dele era o gargalo. Então eu o reduzi, max_bfs_breadth de 10 a 2 e max_trie_depth de 18 a 8, esperando a sobrecarga cair.
O throughput colapsou a 433.0.
A falha valeu mais que uma pequena vitória
Diz que a busca não é sobrecarga, é o que ganha os tokens. Cada candidato extra que o propositor explora é uma chance de aceitar mais um token, e cada token aceito pula uma leitura completa de 4.97 GB. Gastar algumas centenas de microssegundos de CPU para evitar 0.621 milissegundos de tráfego HBM é uma troca que você quer fazer constantemente.
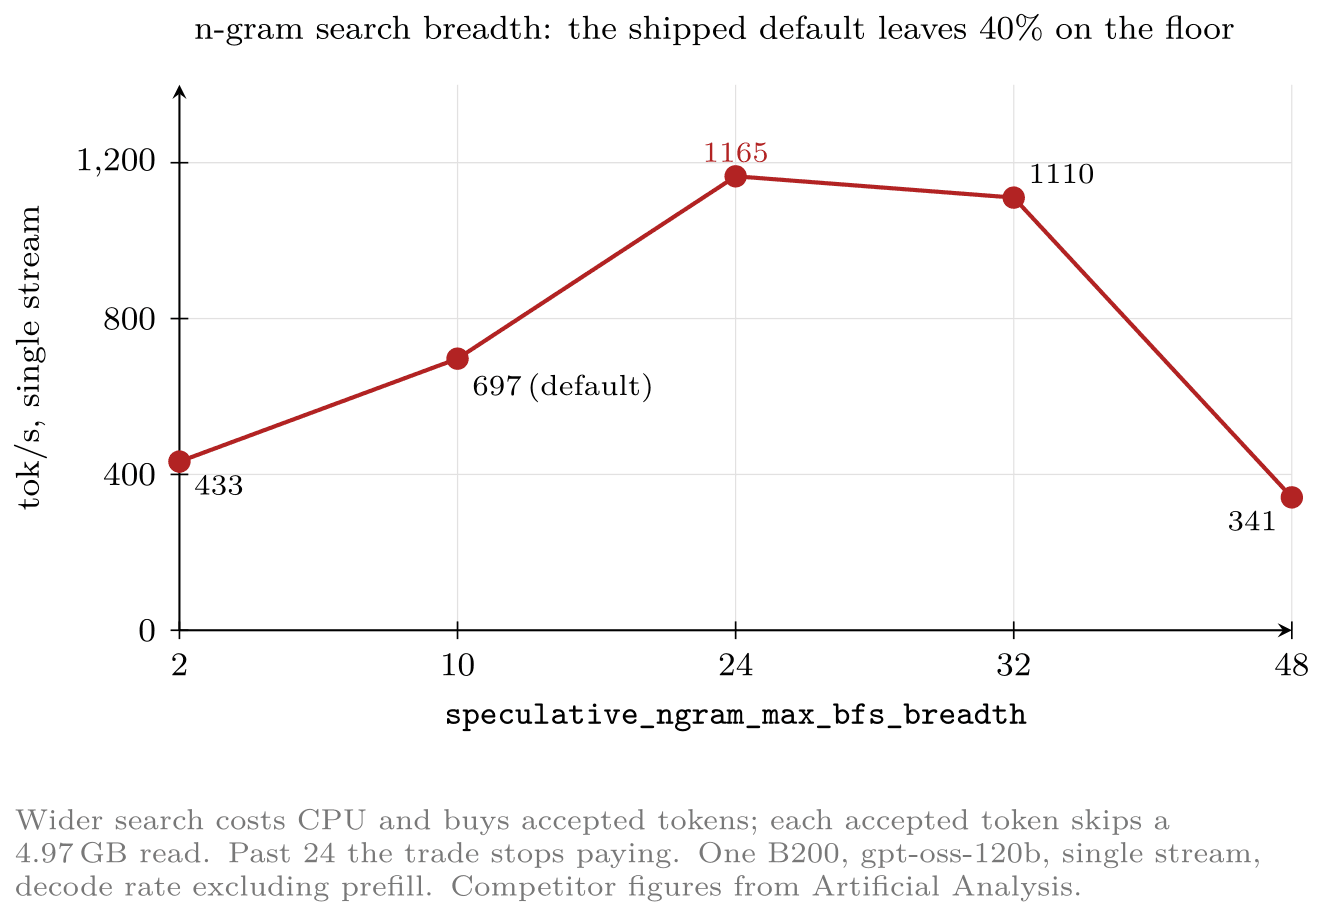
Então virei o botão no outro sentido, e a curva tem um pico agudo.
| max_bfs_breadth | tok/s |
|---|---|
| 2 | 433.0 |
| 10, o padrão | 697.1 |
| 24 | 1,165.1 |
| 32 | 1,110.4 |
| 48 | 341.1 |
O padrão publicado é 10, e você pode ler direto na documentação.
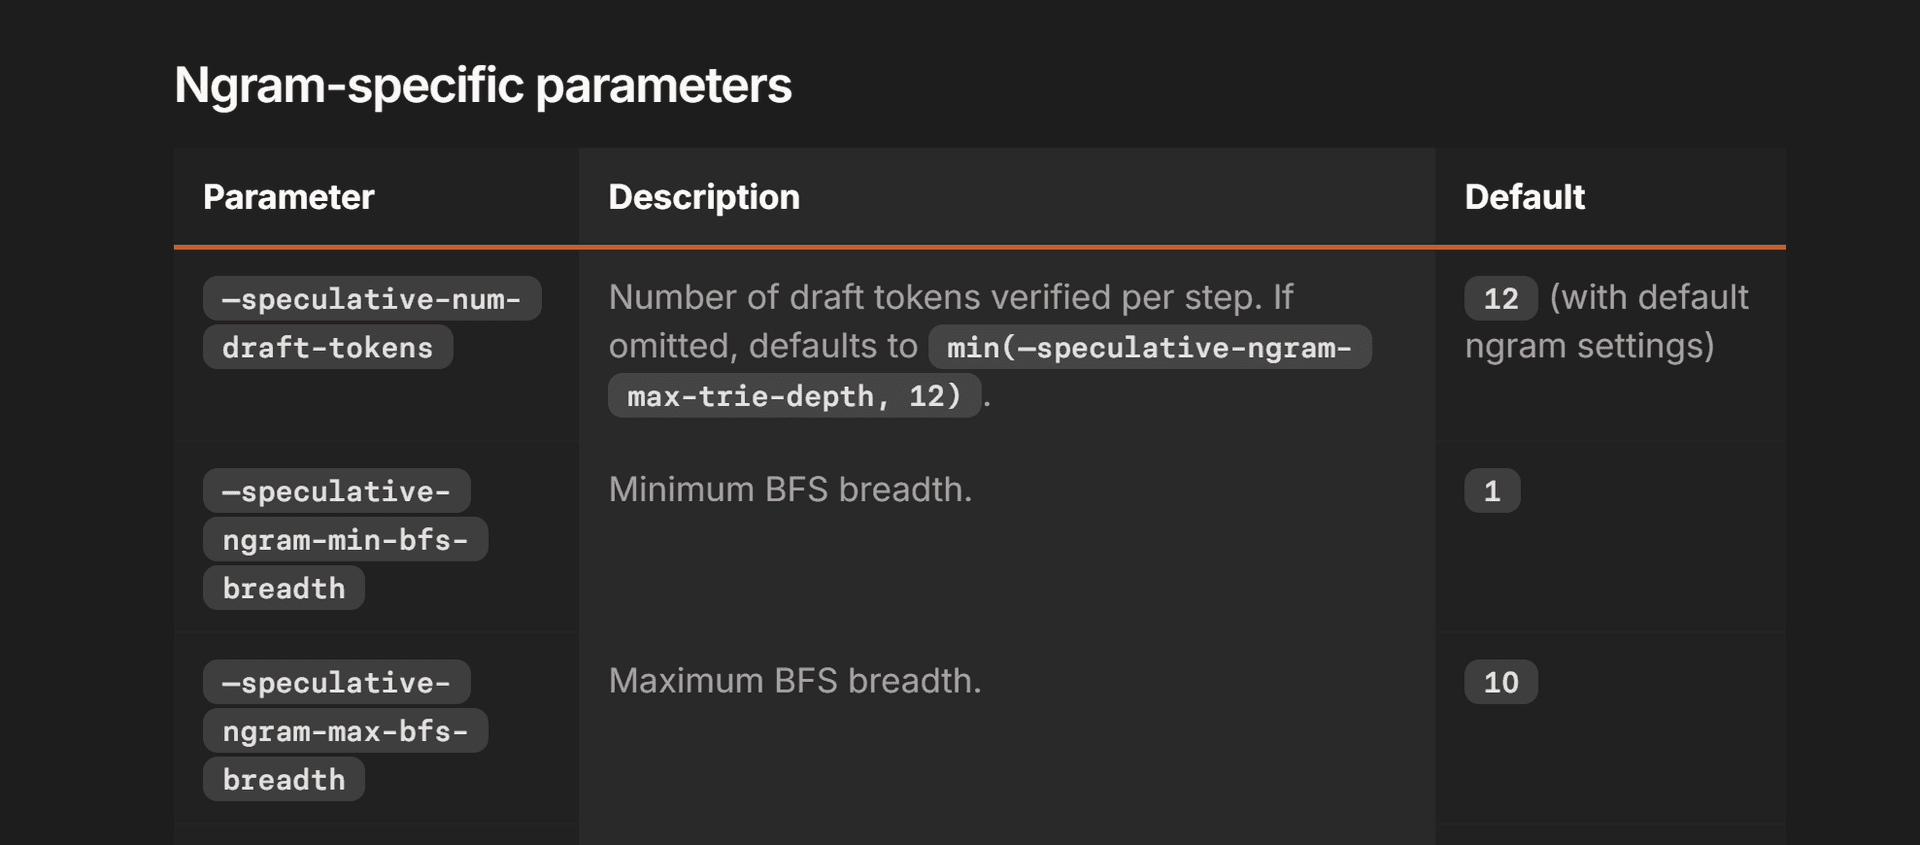
Para decodificação de fluxo único isso deixa uns 40 por cento no chão, e passado 24 a busca em CPU para de se pagar e cai de um penhasco. O padrão não é um erro. É definido para serving de throughput, onde muitas solicitações dividem a GPU e o tempo de CPU é apertado. É o padrão errado para um usuário esperando um fluxo, e nada na pilha diz qual das duas coisas você está fazendo.
Onde isso aterrissa
| Provedor | tok/s | Razão |
|---|---|---|
| uma B200, duas rodadas | 1,165.1 a 1,366.2 | |
| Groq | 477 | 2.44x a 2.87x mais rápido |
| SambaNova | 706 | 1.65x a 1.94x mais rápido |
| Cerebras | 1,891 | 0.62x a 0.72x |
Por prompt, as duas rodadas mediram 447.8, 1930.8, 1882.5, 219.1 e depois 525.3, 2207.0, 2215.6, 291.9 tokens por segundo. Três dessas oito leituras estão acima da mediana atual de 1,891 da Cerebras, numa GPU alugável.
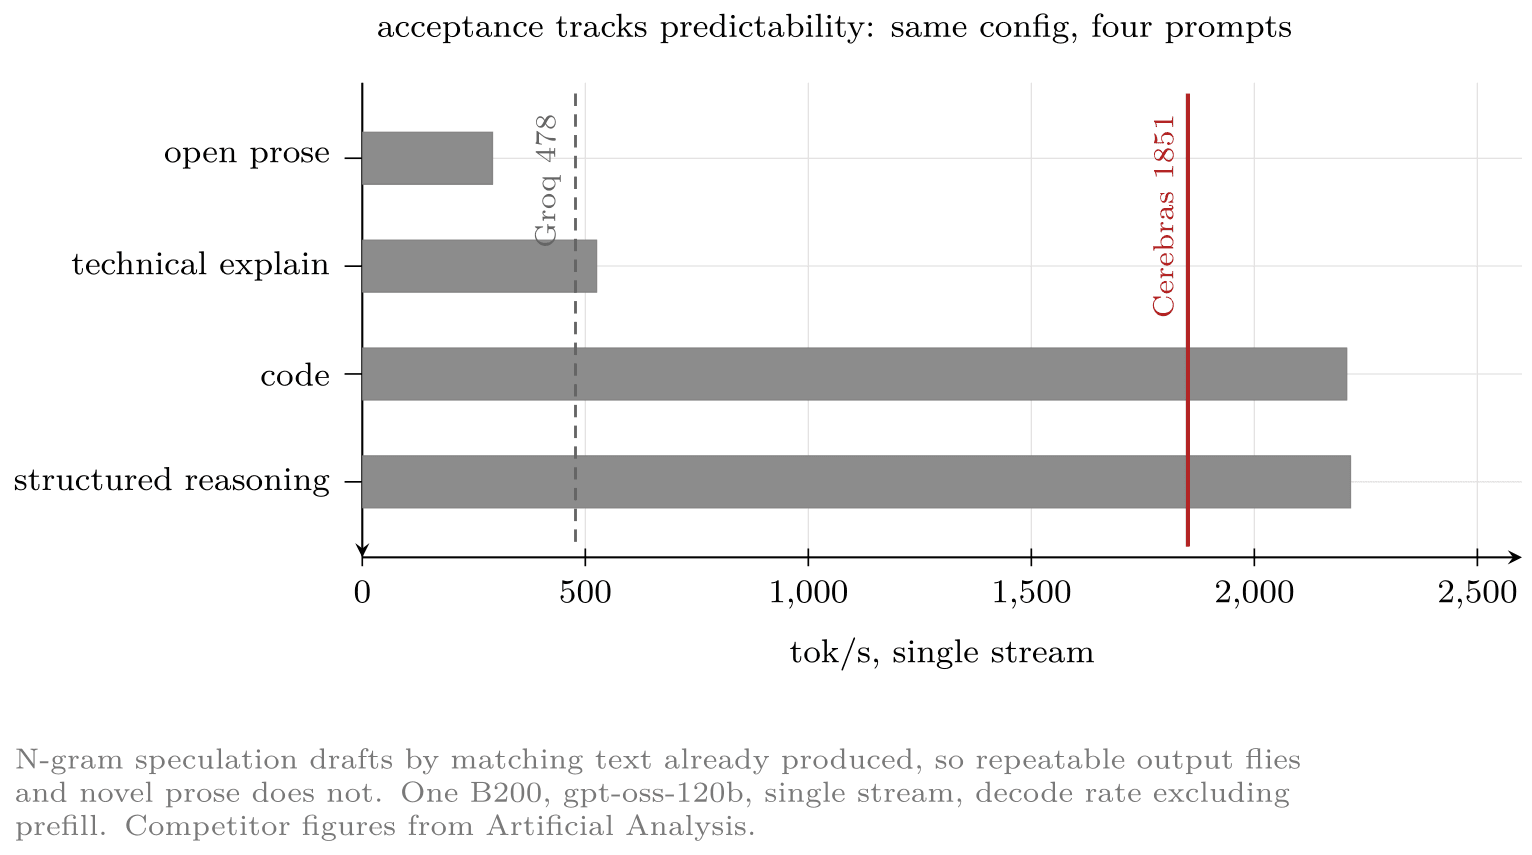
Essa dispersão é a coisa mais útil do artigo, então a mostro em vez de me esconder atrás de uma mediana. A especulação n-gram rascunha casando texto que já produziu, então raciocínio estruturado onde a frase se repete corre acima de 2,200 enquanto prosa aberta que nunca se repete corre a 219. O truque paga exatamente na medida em que a saída é previsível. Um fornecedor que reporta um número está tirando média da própria mistura de prompts, e você não vê essa forma de jeito nenhum.
O que a especulação muda e não muda
A verificação greedy é o que mantém isso honesto. Um token rascunhado é aceito apenas onde coincide com o token que o modelo alvo teria produzido sozinho, e na primeira divergência o resto do rascunho é descartado e o token do alvo é tomado. Então especulação com verificação greedy é exata, não aproximada. Muda quantas passadas você gasta, não quais tokens saem.
Se você for conferir isso você mesmo
Comparar uma rodada especulativa contra uma rodada não especulativa configurada diferente não testa a especulação, testa os kernels. Trocar o backend de atenção muda a ordem das reduções em ponto flutuante, e onde dois logits estão quase empatados esse reordenamento troca o argmax. Seu controle precisa manter todo o resto fixo e ligar a especulação sozinha. E compare ids de token, nunca texto, com uma verificação explícita de comprimento em vez de zip, que trunca para o lado mais curto e vai reportar como bit exata uma rodada que morreu no meio. Eu sei porque escrevi esse bug no começo deste projeto e ele aprovou um kernel que tinha caído.
O que não funcionou, que é a maior parte
Quinze configurações, e as falhas dizem mais que as vitórias.
Ambas as cabeças de rascunho publicadas do EAGLE-3 pontuaram abaixo de rodar sem especulação, 417.6 para a da NVIDIA e 325.0 para a do time do SGLang, porque a aceitação estava perto de zero. A NVIDIA treinou a sua contra o checkpoint NVFP4 dela e este é o MXFP4, e um rascunho que nunca acerta custa a passada do rascunho para nada.
Conseguir que a cabeça da NVIDIA carregasse vale registrar. Falhou com uma divergência de tensores, 8640 contra 5760, que é três vezes o tamanho oculto contra dois. O SGLang v0.5.16 mapeia as camadas de captura pedidas pelo rascunho com um erro de um, então a última de três camadas pedidas cai fora do laço, e a mesma versão descarta em silêncio o peso input_norm do checkpoint porque nunca constrói esse módulo. Ambos foram corrigidos upstream no commit 5df193b4ac, fundido seis dias depois de v0.5.16 ser etiquetada. Um nightly com a correção carregou, e ainda assim perdeu.
Todo backend de atenção exceto triton está disponível aqui. O FlashAttention 3 exige SM 80 a 90 e uma B200 é SM100. O FA4 força um tamanho de página de 128 e o trtllm_mha força 64, e o SGLang então se recusa a rodar uma árvore especulativa mais larga que um token num backend paginado porque produz resultados incorretos. Fiquei feliz de bater nessa guarda em vez de receber respostas erradas em silêncio. O runner de MoE triton estoura memória em 156 GiB porque desquantiza MXFP4 de volta a bf16. O torch.compile lança um assert e depois estoura memória no mesmo caminho. O DFLASH com um modelo de rascunho real alcançou 493.5, melhor que nada e pior que n-gram.
As ressalvas honestas
Eles servem tráfego real em endpoints de produção e eu rodei quatro prompts fixos numa máquina alugada, então isto não é um confronto limpo e não vou fingir que é. A Artificial Analysis também alimenta 10,000 tokens de entrada e meus prompts são uns trinta, e um prompt mais longo significa mais cache KV para ler a cada passo, então eles estão fazendo o trabalho mais difícil. Isso ajuda meu número, então desconte um pouco na hora de comparar.
Uma wafer com pesos na SRAM é uma vantagem arquitetural genuína neste problema e não marketing. A Cerebras é rápida porque a memória no chip remove o gargalo que venho descrevendo, e nenhuma quantidade de trabalho de kernels transforma HBM em SRAM. A mediana deles ainda me supera.
Uma placa que se aluga por hora rodando pesos que você baixa alcança 1,165 a 1,366 tokens por segundo depois de quatro ajustes, e isso supera dois dos três chips feitos sob medida. Os scripts estão no repositório e também o JSON bruto por prompt, então você pode ver a dispersão você mesmo em vez de confiar em mim.
Por que construo o que construo
A configuração de fábrica alcançou 26 por cento da largura de banda de memória desta máquina. Quatro ajustes levaram a 72 por cento. Ninguém trocou o hardware, e as 2.8x estavam dentro de uma abstração que não reportou erro nenhum o tempo todo.
Sou jovem, sou novo em kernels e não sou a melhor pessoa do mundo escrevendo-os. O que faço bem é construir agentes que os escrevem, e acho que essa é a habilidade mais útil. As pessoas capazes de afinar um kernel à mão são raras e não escalam, e cada modelo novo em cada placa nova precisa do trabalho de novo. O trabalho de kernels é de onde vem a próxima década de desempenho, não a próxima fábrica. O editor de código saiu desses dois anos lendo manuais de arquitetura, e parei de mantê-lo. AutoKernel e AutoMegaKernel vieram depois, e ambos existem para fazer por máquina o que eu fiz à mão neste artigo. Tudo é sobre fazer os modelos rodarem nas placas que as pessoas têm, não nas de comunicado de imprensa.
Construí um otimizador para você não ter que fazer nada disso à mão. Aponte para qualquer modelo na Hugging Face e para as placas que você já tem. Ele calcula seu teto, escreve e afina os kernels que fecham a lacuna, e confere que a saída é bit exata antes de entregar qualquer coisa. O trabalho que fiz à mão aqui ele faz sozinho.
A ordem das operações importa e a indústria insiste em fazê-la ao contrário. Antes de projetar uma arquitetura diferente devíamos espremer o que já está nos racks, porque a maior parte desse silício roda a uma fração do que pode e o que falta é código que ninguém escreveu. Gravar um chip para resolver um problema que você não resolveu primeiro em software significa pagar dezoito meses e uma rodada de fábrica por algo que um flag de configuração poderia ter entregado na mesma semana, e os flags que mudei aqui valiam 3.3x.
Não estou tirando nada da Cerebras. Manter os pesos na SRAM mata exatamente o gargalo que venho descrevendo, isso é uma correção real para um problema real, e eles seguem à minha frente. Mas muito do que parece lacuna de hardware numa tabela é software que alguém ainda não escreveu, e você só descobre calculando o teto você mesmo e notando que está em 26 por cento dele.
O que as pessoas chamam de projeto de hardware é em grande parte tradução. Um modelo é um grafo de operações e um chip é um conjunto de unidades de execução e níveis de memória. Passar de um ao outro é um problema de compiladores e kernels de ponta a ponta. Você está decidindo o que funde, o que fica em registradores, o que transborda para HBM e qual ordem de laços os tensor cores querem. Essa camada de tradução é onde o desempenho vive, é software, e é a mesma camada venha o silício de baixo da NVIDIA, da AMD ou de algo gravado no ano passado.
É por isso que acho que nada disso é permanente, e o caso mais claro é a AMD. O silício é bom e a largura de banda está lá. A lacuna para a NVIDIA em trabalho real é a pilha, não os transistores. Se o software é a maior parte, a lacuna se fecha escrevendo software, que é uma posição muito melhor que precisar de uma fábrica nova. Estamos escalando nossos agentes para a AMD em seguida, porque o teste interessante não é fazer um chip rápido mais rápido, é alcançar números de classe NVIDIA em hardware que as pessoas descartaram.
E não são só as empresas de chips. OpenAI e Broadcom lançaram um chip de inferência chamado Jalapeno em junho, e a Anthropic confirmou um time de silício interno em agosto, ambas falando em cortar pela metade o custo por token (openai.com/index/openai-broadcom-jalapeno-inference-chip). Duas das melhores empresas de software do mundo decidiram que o próximo lugar para gastar é a camada de hardware.
Eu leio isso diferente da maioria. Se você recupera metade do seu custo de inferência gravando um chip, parte do que você está recomprando é a eficiência que nunca tirou das GPUs que já tem. Não acho que seja uma crítica a eles, é só o mesmo 26 por cento que medi neste artigo, numa escala onde vale uma rodada de fábrica consertar.
Do que estou menos certo é do que vem depois. CUDA é o motivo de uma B200 ser fácil de levar a 72 por cento, e CUDA são dezoito anos de compiladores, bibliotecas, kernels, profilers e gente que sabe onde os corpos estão enterrados. Esse é o fosso, não os transistores. Um chip novo começa do zero em tudo isso. Pode ser um projeto melhor e ainda assim perder, porque o que decide quanto de um chip você realmente usa é o software ao redor, e isso leva anos para construir.
Então a pergunta que eu faria sobre qualquer chip feito sob medida não é quão rápido é o silício. É se o software acompanha. Vai continuar rápido no modelo para o qual você trocar no próximo trimestre, num truque que ninguém inventou ainda, numa forma para a qual o compilador nunca foi escrito. Uma GPU responde tudo isso com uma recompilação.
Chips de inferência feitos sob medida são uma aposta de que uma carga fica parada tempo suficiente para assá-la em silício. A decodificação especulativa não existia na forma atual há três anos e o próximo truque também ainda não existe. Quando chegar, as pessoas em hardware programável com um compilador maduro entregam em semanas. As pessoas que o gravaram em silício não.
Lembro de quando passei de chamar funções do PyTorch a escrever os kernels por baixo delas, achei que descia um nível pelo desempenho, e agora tenho mais certeza de que descia um nível pelo controle, porque desempenho é o que você ganha quando para de aceitar o que o padrão decidiu por você.
Então quando as pessoas me perguntam por que continuo trabalhando nisto em vez de algo com uma demo mais bonita, essa é a resposta. O hardware vai continuar sendo bom. A parte que decide se você vê algo dele é o software, e agora quase ninguém está escrevendo. Essa é a peça que importa, e é a peça que quero que qualquer um possa alcançar.