
ソフトウェアだけで、B200 1 枚が LPU を上回り Cerebras に迫る
, 16分で読めます, By Jaber Jaber
エンジニアリング編集注: この投稿は、まず私たちの以前のサイトで公開されました。ここで説明する最適化製品は提供を終了しています。RightNow は API でオープンモデルを提供しています。
訂正、2026 年 8 月 9 日
この記事が 8 月 6 日に公開された後、Artificial Analysis はプロバイダの中央値を変更しました。8 月 6 日、ここで使った比較ポイントは Cerebras 1,991 tok/s、SambaNova 708、Groq 476、Google Vertex 423、Databricks 324、Azure 300、Amazon 101、CoreWeave 33 と読めていました。8 月 9 日、ソースは Cerebras 1,891、SambaNova 706、Groq 477、Google Vertex 391、Azure 312、Baseten 195、Amazon 86、CoreWeave 36 と読みます。Databricks は現在のチャートに報告された速度がありません。以下の現在の文章と表は 8 月 9 日の値を使います。元の 8 月 6 日のチャート画像は、日付付きの公開スナップショットとして残されています。
推論のために造られた新しいシリコンが、今や毎年どこかから出荷されています。Cerebras はウェハーの上にウェイトを置き、Groq は LPU を造り、SambaNova は RDU を造りました。この 3 つはすべて、トークンを速く動かす本物のマシンです。これが起きていることを私は気に入っています。推論はハードウェアを設計する価値があります。
私は GPU カーネル用のコードエディタを作るため、2 年を NVIDIA と AMD の GPU アーキテクチャの研究に費やしました。マニュアルを一日中読んでいると、カードに何ができるかがわかります。それから、同じカードから人々が絞り出しているものを見ると、2 つの数字が一致しません。そこで私はすべてのカーネルを手で書くのをやめ、それを書くエージェントを作り始めました。GPU カーネルを生成してチューニングする AutoKernel をオープンソースにしました。小さく読みやすいので、何をしているか実際に追えます。次に AutoMegaKernel です。デコードステップ全体を永続カーネルに融合し、中間値がチップの外に出ないようにします。すべては同じことのためです。人々がすでに持っているカードで、モデルをきちんと動かせるようにすること。
だからリーダーボードが私を悩ませます。8 月 6 日、ボードが 423 GPU tok/s と読んだとき、紙の上で計算できるバイト予算のモデルについて、私の最初の考えは GPU が遅いということではありませんでした。誰もソフトウェアを書いていない、ということでした。そこで、ソフトウェア以外には何も触らずに、単一の B200 でそのギャップを埋められるか確かめることにしました。
8 月 9 日時点で、Artificial Analysis は Cerebras を毎秒 1,891 トークンとして載せています。最速の掲載 GPU プロバイダは Google Vertex の 391、次に Azure の 312、Baseten の 195 です。これは Cerebras を最速掲載 GPU の 4.8 倍前に置き、Cerebras が公表した比較の 5 倍のリードに近い値です (cerebras.ai/blog/blackwell-vs-cerebras)。
1,891 はハードウェアの答えで、良い答えです。彼らはウェイトを HBM ではなく SRAM に保持するので、私たち残りの者が戦うボトルネックは彼らのマシンには存在しません。それに異論を唱えるつもりはなく、私はそれを超えませんでした。
私が比較を実行したときボードは 423 と読み、8 月 9 日時点では 391 です。この GPU の基準点が、私が追いかけた数字です。Modal で単一の B200 をレンタルしました。GPU が欲しいときに考えずに手を伸ばす先です。箱から出してすぐは毎秒 411 トークンでした。4 つの設定を変えると、同じカードが同じウェイトを走らせたまま 1,366 になり、単一プロンプトは 2,215 に達しました。カーネルは 1 つも書かず、再コンパイルもしていません。
| 指標 | 値 | 詳細 |
|---|---|---|
| 標準の SGLang | 411 tok/s | このカードのメモリ帯域の 26 パーセント |
| 4 つの設定の後 | 1,366 tok/s | 72 パーセント、最速 GPU プロバイダの 3.5 倍 |
| 最良の単一プロンプト | 2,215 tok/s | Cerebras を上回る、レンタル可能なカード 1 枚で |
これは現在のボードの最速 GPU プロバイダを 3.5 倍超えています。477 の Groq と 706 の SambaNova をクリアし、レンタルした 1 枚のカードをウェハーの 72 パーセントに置きます。
抽象化はあなたに嘘をつき、ハードウェアについて嘘はついていない
あなたとチップの間のすべての階層は、チップについて考えさせないために存在し、それはうまくいっています。generate を呼ぶと、トークンが何らかの速度で出てきて、その速度がマシンの速度のように感じられます。違います。それは、たまたま呼んだデフォルトの速度です。
だから人々は何かが遅いとハードウェアのせいにし、だからほとんどの場合間違っています。フレームワークは、自分が足を引っ張っている張本人だとは教えてくれません。エラーを出さず、すべて問題なさそうに見え、出してくる数字は安定して再現できるので、設定ファイル 1 つなのに物理のように感じられるのです。
抜け道は 1 つだけです。バイトと帯域から、カードに何ができるかを自分で計算して、比べること。その数字は、どのフレームワークを使っていても関知しません。
B200 上の gpt-oss-120b では、計算は短いです。1 トークンのデコードは、アクティブなウェイトすべてをちょうど 1 回読みます。それは bf16 の attention が 1.91 GB、mxfp4 の上位 4 ルーティングエキスパートが 1.90 GB、bf16 の lm_head が 1.16 GB で、トークンあたり 4.97 GB です。B200 は 8 TB/s の HBM3e を持つ (nvidia.com/en-us/data-center/dgx-b200) ので、下限はトークンあたり 0.621 ミリ秒で、天井は毎秒約 1,610 トークンです。
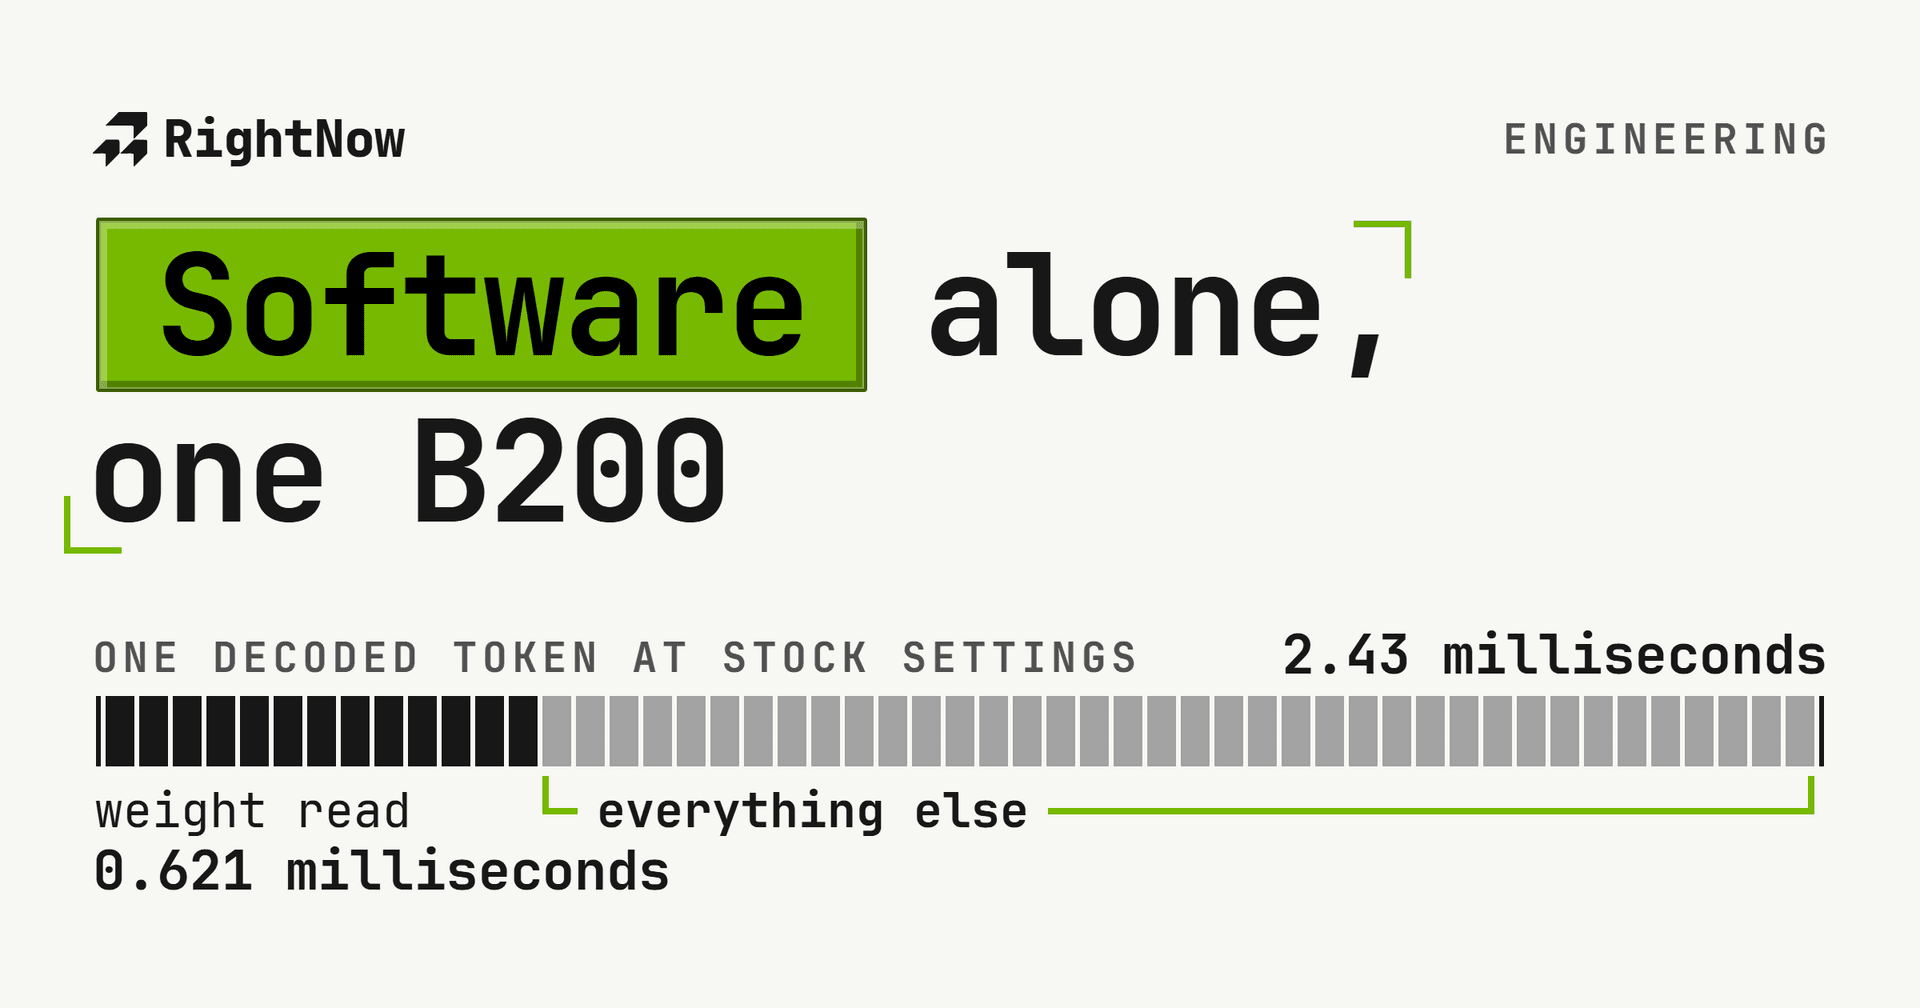
標準の SGLang はトークンあたり 2.43 ミリ秒かかりました。すべてのトークンの 74 パーセントは、ウェイトを読んでいなかったのです。
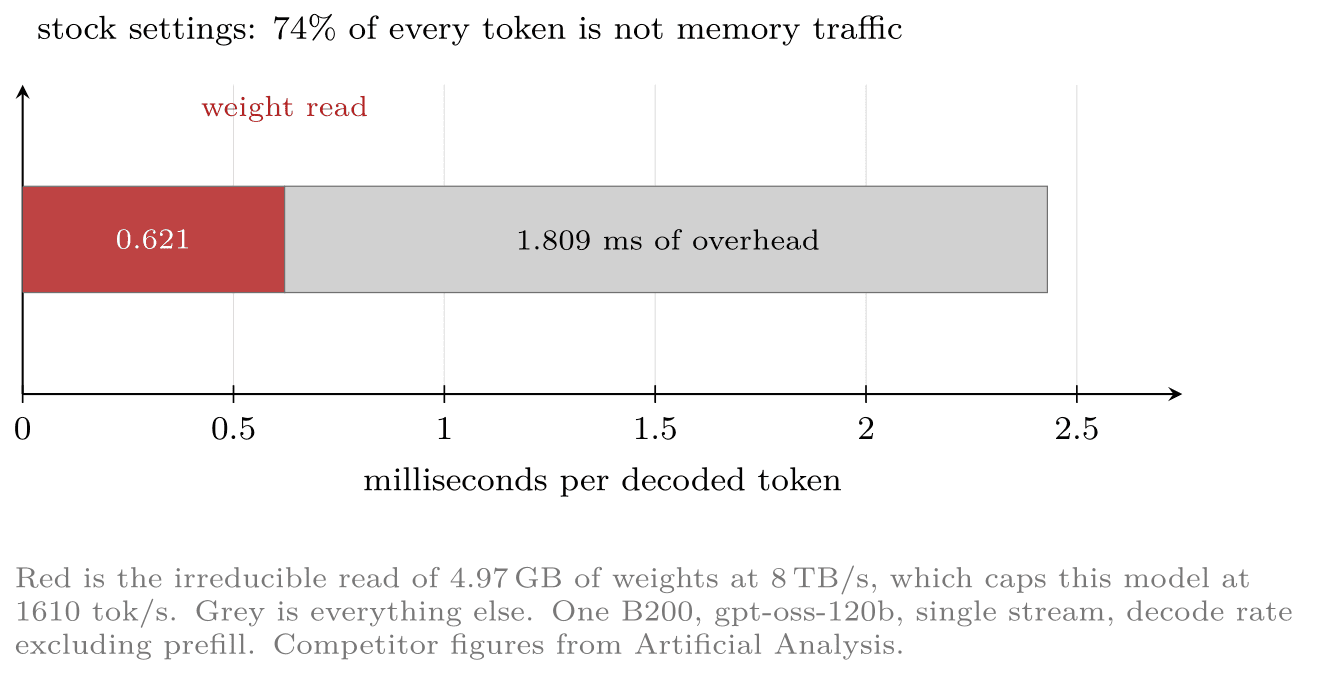
チップは 4 分の 3 の時間、アイドルで座っていました。速いカードを買えと言うすべての直感は、すでに動いていた 26 パーセントに向けられています。
何をどう測ったか
すべてを、178.4 GiB の HBM3e と 148 SM を持つ Modal 上の単一の B200 で実行しました。モデルは openai/gpt-oss-120b で、ネイティブに MXFP4 で出荷され、120B のパラメータのうちトークンあたり約 5.1B を活性化します。サービングは SGLang 0.5.16、温度ゼロの貪欲、シングルストリーム、一度に 1 プロンプト、固定 4 プロンプト、3 回反復、中央値です。
報告する数値はプリフィルを除くデコード速度で、Artificial Analysis が Output Speed と定義するもの、つまり最初のトークンを受け取った後の 1 秒あたりの平均受信トークン数です (artificialanalysis.ai/methodology)。このモデルを選んだのは、3 つの ASIC ベンダーすべてがこれで公表しているからで、比較は同じウェイトと同じメトリックになります。
| プロバイダ | tok/s | シリコン |
|---|---|---|
| Cerebras | 1,891 | ウェハー |
| SambaNova | 706 | RDU |
| Groq | 477 | LPU |
| Google Vertex | 391 | GPU |
| Azure | 312 | GPU |
| Baseten | 195 | GPU |
| Amazon | 86 | GPU |
| CoreWeave | 36 | GPU |
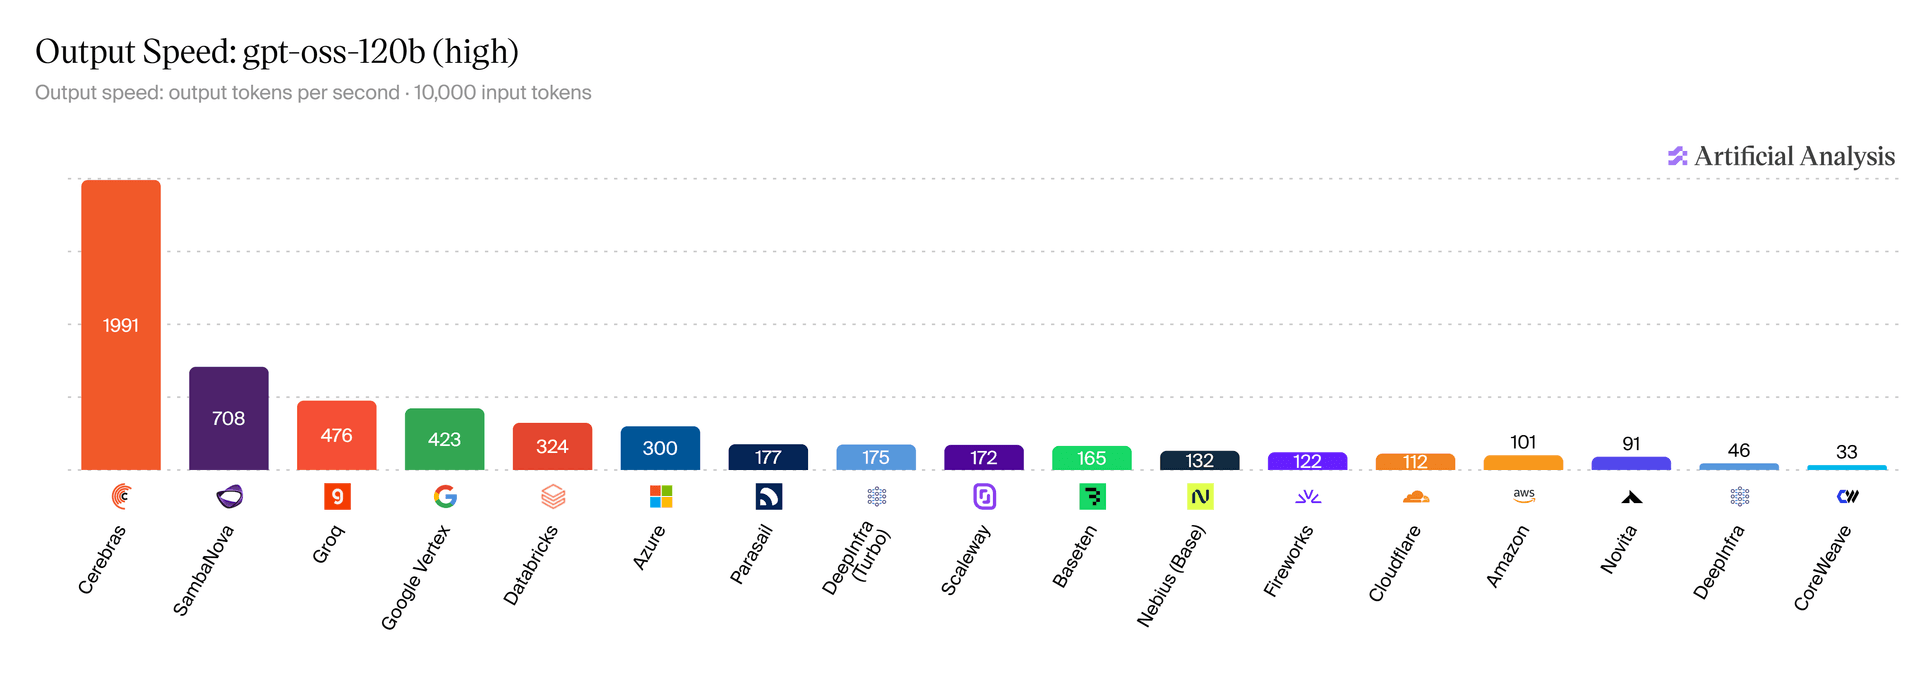
現在のボードにある測定済み GPU の掲載を見てください。同じオープンウェイトとメトリックで、Google Vertex の 391 から CoreWeave の 36 まで、10.8 倍の差に並びます。公開チャートは GPU 世代を設定、カーネル、サービングコードから切り離さないので、これは納品されたスタックが重要だという証拠であって、きれいな 10.8 倍のソフトウェアのみの推定ではありません。
はしご
| ステップ | tok/s |
|---|---|
| 標準のデフォルト | 411.2 |
| レイテンシノブ | 429.9 |
| n-gram 投機的デコーディング | 628.5 |
| speculative_attention_mode=decode | 697.1 |
| 広い n-gram 探索 | 1,165.1 と 1,366.2 |
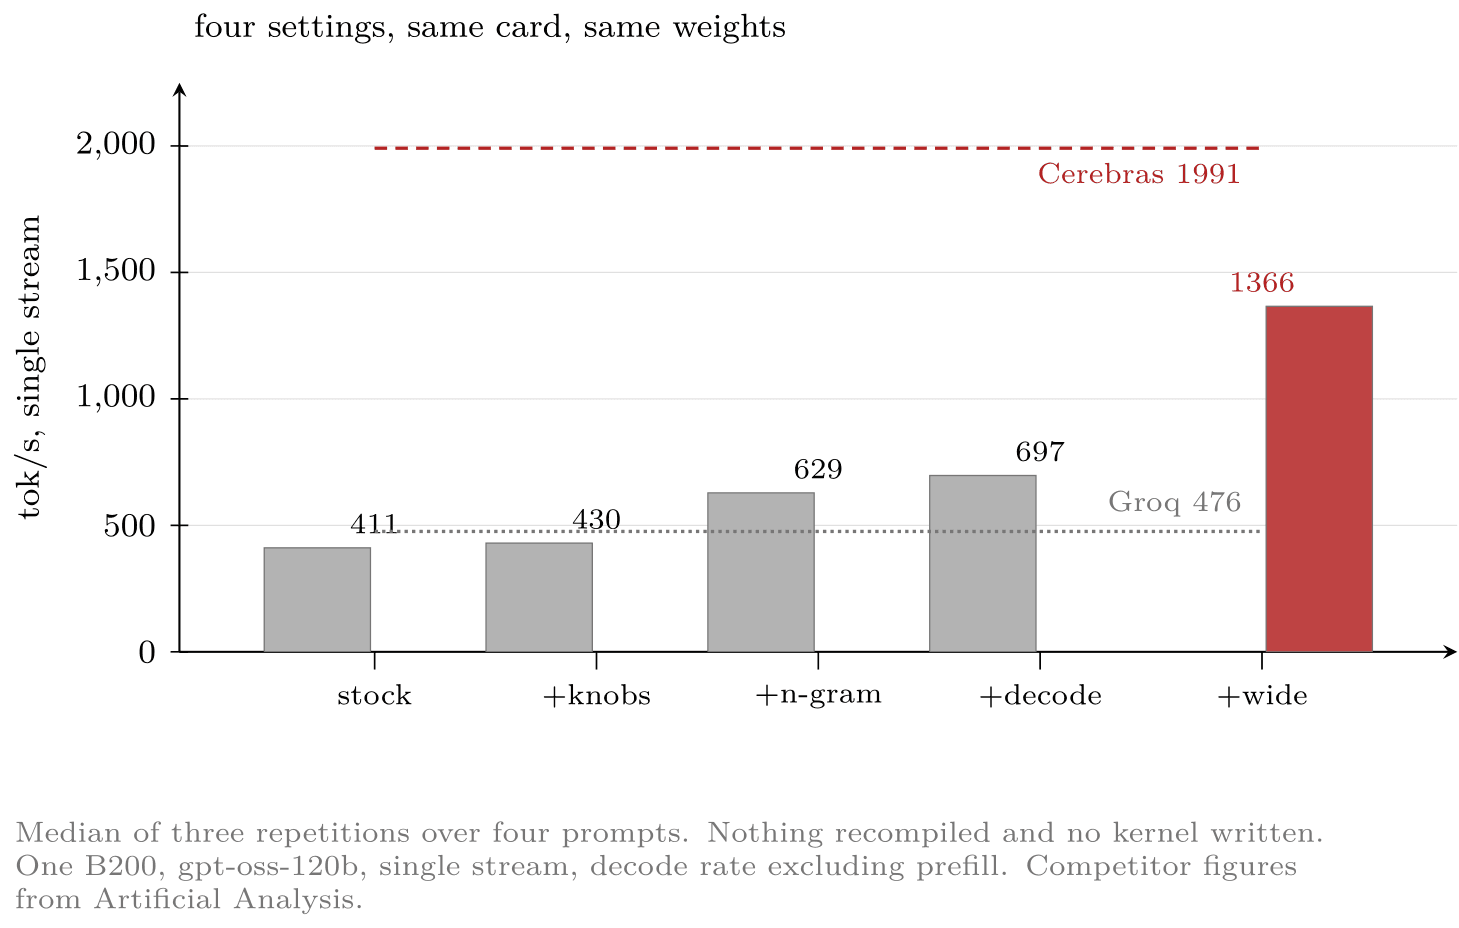
最初の横木は小さいです。SGLang は stream_interval をデフォルト 1 にするので、すべてのトークンでデトークナイズとディスパッチをし、scheduler_recv_interval を 1 にするので、すべてのイテレーションでポーリングします。0.621 ミリ秒の予算ではそれは本当にお金で、直すと 4.5 パーセントを買いました。
2 番目の横木は投機的デコーディングで、Groq に 6 倍を与えたのと同じトリックです。ドラフトがいくつかのトークンを提案し、ターゲットが 1 回のフォワードパスで検証し、受理されたすべてのトークンは、別の 4.97 GB のウェイト読み取りなしで産み出されたトークンになります。学習済みのドラフトヘッドは、失敗の節で述べる理由で使えなかったので、これは n-gram による投機で、これまでに生成されたテキストのパターンを照合して起草します。
3 番目の横木は触れたことのないフラグでした。speculative_attention_mode はデフォルトで prefill で、decode にすると 9.7 パーセントをくれました。
最後の行が 2 つの数字なのは、その構成を 2 回実行して両方を得たからで、同一設定での 17 パーセントの幅です。n-gram の受理は trie に蓄積されたものに依存するので、同じ設定でも実行ごとに違う場所に着地します。より良い方だけを引用したら、測定ではなく数字を選んでいることになります。
開いた横木は、壊して見つけた
CPU の n-gram 提案者が GPU と直列化していて、その探索コストがボトルネックだと、もっともなことを言われました。そこで私は、max_bfs_breadth を 10 から 2 へ、max_trie_depth を 18 から 8 へ削り、オーバーヘッドが下がることを期待しました。
スループットは 433.0 まで崩れました。
その失敗は、小さな勝ちより価値があった
探索はオーバーヘッドではなく、トークンを稼ぐものだということです。提案者が探究する候補 1 つ 1 つが、もう 1 つのトークンを受理する機会で、受理されたすべてのトークンが完全な 4.97 GB の読み取りを 1 回飛ばします。0.621 ミリ秒の HBM トラフィックを避けるために数百マイクロ秒の CPU を使うのは、絶えずやりたい取引です。
そこでノブを逆に回しました。すると曲線には鋭いピークがあります。
| max_bfs_breadth | tok/s |
|---|---|
| 2 | 433.0 |
| 10、デフォルト | 697.1 |
| 24 | 1,165.1 |
| 32 | 1,110.4 |
| 48 | 341.1 |
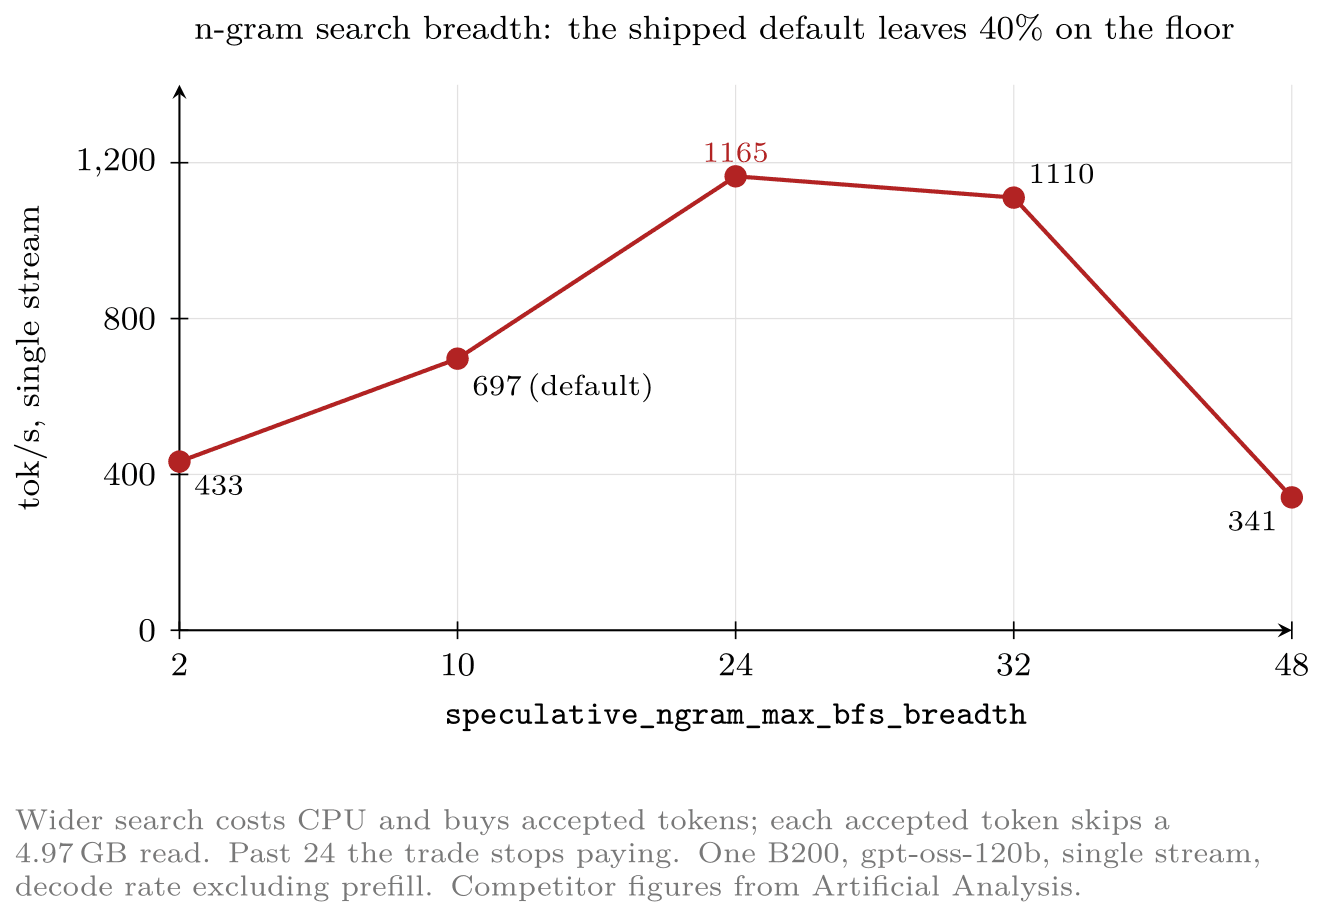
出荷時のデフォルトは 10 で、ドキュメントからすぐに読み取れます。
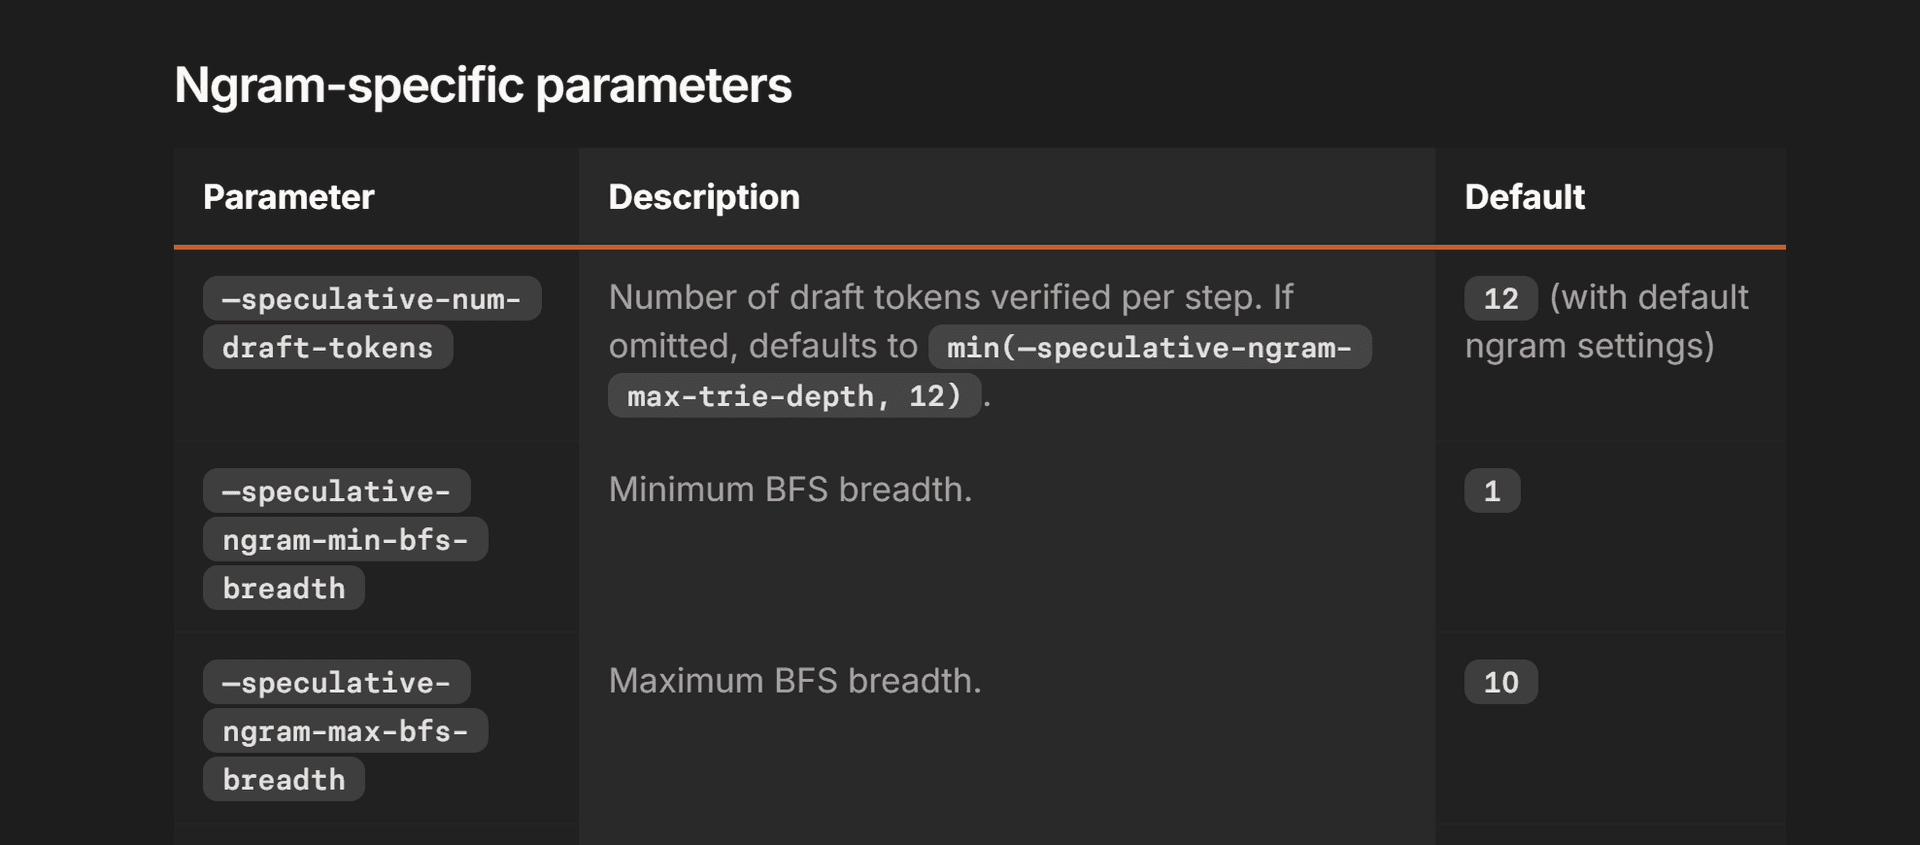
シングルストリームのデコードでは、これが床に約 40 パーセントを残します。24 を過ぎると CPU 探索は自分の分を払いきれなくなり、崖から落ちます。デフォルトが間違いなのではありません。多くのリクエストが GPU を共有し CPU 時間が張り詰めたスループットサービング用に設定されているのです。1 人のユーザーが 1 つのストリームを待つ場合には間違ったデフォルトで、スタックのどこにも、あなたがその 2 つのどちらをしているかを教えてくれません。
それがどこに着地するか
| プロバイダ | tok/s | 比 |
|---|---|---|
| 1 枚の B200、2 回の実行 | 1,165.1 から 1,366.2 | |
| Groq | 477 | 2.44 倍から 2.87 倍速い |
| SambaNova | 706 | 1.65 倍から 1.94 倍速い |
| Cerebras | 1,891 | 0.62 倍から 0.72 倍 |
プロンプトごとには、2 回の実行で毎秒 447.8、1930.8、1882.5、219.1、続いて 525.3、2207.0、2215.6、291.9 トークンが測られました。この 8 つの読み取りのうち 3 つは、レンタル可能な GPU 1 枚で、Cerebras の現在の 1,891 の中央値を上回っています。
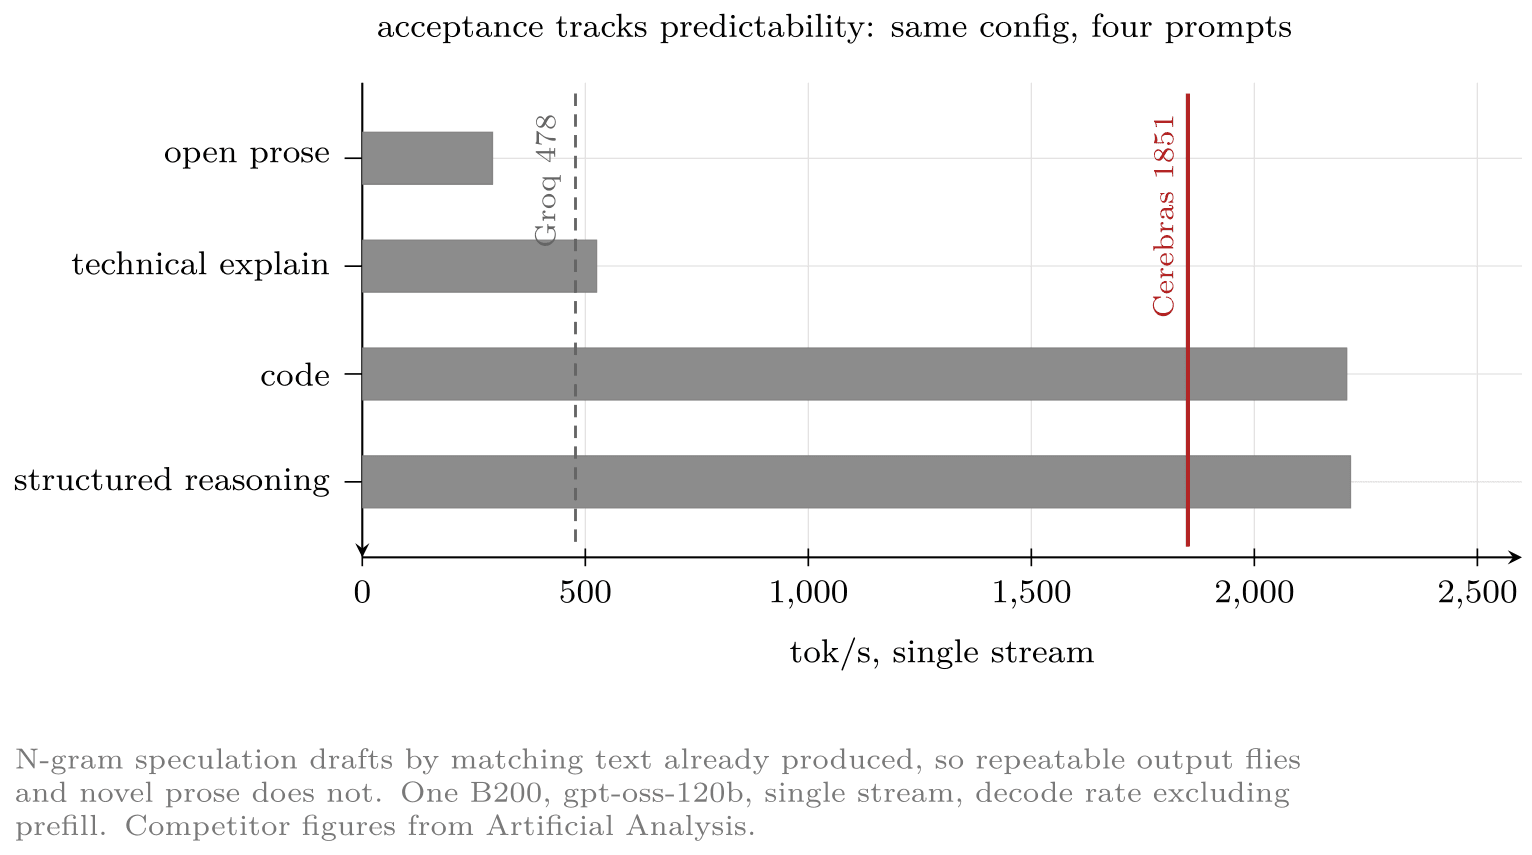
この幅がこの投稿で最も有用なものなので、私は中央値の後ろに隠れずにこれを見せます。n-gram による投機はすでに産み出したテキストを照合して起草するので、言い回しが繰り返される構造化推論は 2,200 超、繰り返しのない自由な散文は 219 で走ります。このトリックは、出力が予測可能なだけの見返りをよこします。1 つの数字を報告するベンダーは自分のプロンプトのミックスで平均を取っており、この形はまったく見えません。
投機が変えるものと変えないもの
貪欲な検証が、これを正直に保っています。起草されたトークンは、ターゲットモデルが自力で産み出したはずのトークンと一致する場合にのみ受理されます。最初の不一致で、ドラフトの残りは捨てられ、ターゲットのトークンが代わりに取られます。つまり貪欲な検証の下の投機は、近似ではなく正確です。費やすフォワードパスの回数を変えるのであって、どのトークンが出てくるかは変えません。
自分でこれを確かめるなら
投機的な実行を、異なる設定の非投機的な実行と比べても、投機はテストされず、カーネルがテストされます。attention バックエンドを切り替えると浮動小数点のリダクション順序が変わり、2 つのロジットがほぼ同点の場所では、その並べ替えが argmax を反転させます。あなたの対照実験は、他のすべての設定を固定し、投機だけを単独で切り替えなければなりません。そして比較はテキストではなくトークン ID で、zip ではなく明示的な長さチェック付きで。zip は短い側に切り詰めるので、途中で死んだ実行をビット正確と報告します。私がこのプロジェクトの初期にそのバグを書いて、クラッシュしたはずのカーネルを合格にしたからです。
効かなかったもの、つまりほとんどすべて
15 の構成で、失敗は勝ちよりも多くを語ります。
公表された 2 つの EAGLE-3 ドラフトヘッドは、投機なしで走るより低く、NVIDIA のが 417.6、SGLang チームのが 325.0 でした。受理率がゼロに近かったからです。NVIDIA は自分たちの NVFP4 チェックポイントに対して学習させたもので、こちらは MXFP4 です。一度も正しく推測しないドラフトは、ドラフトパスを無駄に払わせます。
NVIDIA のヘッドをロードすること自体、記録する価値があります。テンソルの不一致 8640 対 5760、つまり隠れサイズの 3 倍対 2 倍で失敗しました。SGLang v0.5.16 はドラフトが要求するキャプチャレイヤをオフバイワンで対応付け、要求された 3 層の最後がループの外に落ちます。同じバージョンは、そのモジュールを一切ビルドしないためにチェックポイントの input_norm ウェイトを黙って落とします。どちらもアップストリームでコミット 5df193b4ac として修正され、v0.5.16 のタグの 6 日後にマージされました。修正入りナイトリーはロードできましたが、それでも負けました。
triton 以外のすべての attention バックエンドが、この環境では使えません。FlashAttention 3 は SM 80 から 90 を要求し、B200 は SM100 です。FA4 はページサイズ 128 を強制し、trtllm_mha は 64 を強制し、SGLang は、ページングバックエンド上の 1 トークンを超える幅の投機ツリーは誤った結果を産むため、実行を拒否します。静かに間違った答えをもらうより、そのガードに当たってよかったです。triton の MoE ランナーは MXFP4 を bf16 に逆量子化するため、156 GiB で OOM します。torch.compile は同じ経路で assert し、その後 OOM します。本物のドラフトモデルを使った DFLASH は 493.5 に達し、無いよりは良く、n-gram よりは悪いです。
正直な注意
彼らは本番のエンドポイントで本物のトラフィックをサーブしていて、私はレンタル箱で 4 つの固定プロンプトを走らせただけなので、これはきれいなガチ対決ではありませんし、そう装うつもりもありません。Artificial Analysis は 10,000 入力トークンを与え、私のプロンプトは 30 ほどで、長いプロンプトは毎ステップで読む KV キャッシュが増えるので、彼らのほうが難しい仕事をしています。これは私の数字を助けるので、比べるときは少し割り引いてください。
ウェイトを SRAM に保持するウェハーは、この問題では本物のアーキテクチャ上の優位で、マーケティングではありません。Cerebras が速いのは、オンチップメモリが私がずっと説明してきたボトルネックを取り除くからで、どれだけカーネル作業をしても HBM は SRAM になりません。彼らの中央値は今も私を上回っています。
時間でレンタルでき、ダウンロードできるウェイトを走らせるカードが、4 つの設定で毎秒 1,165 から 1,366 トークンに達し、3 つのカスタムチップのうち 2 つに勝ります。スクリプトはリポジトリにあり、プロンプトごとの生の JSON もあるので、私を信じる代わりに、あなた自身でその幅を見に行けます。
私が作るものをなぜ作るのか
標準設定は、このマシンのメモリ帯域の 26 パーセントに達しました。4 つの設定で 72 パーセントまで行きました。誰もハードウェアを交換しておらず、2.8 倍は、最後まで一度もエラーを報告しなかった抽象化の中に座っていました。
私は若く、カーネルは初めてで、書く世界一の人間ではありません。私が得意なのは、それを書くエージェントを作ることで、それがより有用な技能だと思います。手でカーネルをチューニングできる人は珍しく、スケールしません。新しいカードごとの新しいモデルに、その仕事はまた必要になります。今後 10 年の性能は次のファブからでなくカーネル作業から来ます。コードエディタはアーキテクチャマニュアルを読んだ 2 年から生まれ、私はその対応をやめました。次に AutoKernel と AutoMegaKernel が来て、その両方とも、この投稿で手でやったことを機械にやらせるために存在します。すべては、プレスリリースのカードではなく、人々が持っているカードでモデルを動かすことについてです。
私はオプティマイザを作りました。あなたがこれを手でやる必要がないようにです。Hugging Face の任意のモデルと、あなたがすでに持っている任意のカードを指します。天井を計算し、ギャップを埋めるカーネルを書いてチューニングし、出すものがビット正確かどうかを出荷の前に確認します。私がここで手でやった仕事を、それは自分でやります。
作業の順序は重要で、業界はそれを絶えず逆にしています。別のアーキテクチャを設計する前に、すでにラックにあるものを絞り切るべきです。そのシリコンのほとんどは、できることの一部で走っていて、欠けている部分は誰も書いていないコードだからです。ソフトウェアで先に解決していない問題を解決するためにチップをテープアウトするのは、設定フラグなら同じ週に手に入ったかもしれないものに、18 か月と 1 回のファブランを払うことです。私がここで変えたフラグは 3.3 倍の価値がありました。
Cerebras から何かを取り上げるつもりはありません。ウェイトを SRAM に置くことは、私がずっと説明してきたまさにそのボトルネックを殺します。それは本物の問題への本物の修正で、彼らは今も私の前にいます。しかしリーダーボード上でハードウェアのギャップに見えるものの多くは、まだ誰も書いていないソフトウェアで、それは天井を自分で計算して、26 パーセントにいると気づくことでしか確かめられません。
人々がハードウェア設計と呼ぶものは、大部分が翻訳です。モデルは演算のグラフで、チップは実行ユニットとメモリ階層の集合です。一方から他方へ行くことは、端から端までコンパイラとカーネルの問題です。何を融合し、何をレジスタに置き、何を HBM にこぼし、テンソルコアがどのループ順を好むかを決めています。その翻訳階層こそが性能のありかで、それはソフトウェアです。下のシリコンが NVIDIA からか AMD からか、昨年テープアウトされたものかには関わりません。
だから私はこれが永久ではないと思っていて、最も明白なケースは AMD です。シリコンは良く、帯域はそこにあります。実際の仕事での NVIDIA とのギャップは、トランジスタではなくスタックです。ソフトウェアの占める割合が大きいなら、ギャップはソフトウェアを書くことで閉じられ、新しいファブが必要なよりずっと良い立場です。私たちは次にエージェントを AMD にスケールしています。面白いテストは、速いチップを速くすることではなく、書き捨てられたと人々が思っているハードウェアで NVIDIA 級の数字に届くことだからです。
チップ企業だけの話でもありません。OpenAI と Broadcom は 6 月に Jalapeno という推論チップを出し、Anthropic は 8 月に社内シリコンチームを確認しました。どちらもトークンあたりのコストをほぼ半分にすることを話しています (openai.com/index/openai-broadcom-jalapeno-inference-chip)。世界で最も優れたソフトウェア会社 2 社が、次に使うべき場所はハードウェア階層だと決めたのです。
私はそれを多くの人とは違う読み方をします。チップをテープアウトして推論コストの半分を取り戻しているなら、あなたが本当に買い戻しているものの一部は、すでに持っている GPU から一度も得られなかった効率です。それは彼らへの批判ではないと思います。この投稿で私が測ったのと同じ 26 パーセントが、修正するのにファブラン 1 回の価値がある規模で座っている、というだけのことです。
私がより確信できないのは、この先に何が起きるかです。CUDA は B200 で 72 パーセントに届くのが簡単である理由で、CUDA は 18 年のコンパイラ、ライブラリ、カーネル、プロファイラと、どこに問題が埋まっているかを知る人々です。それが堀であって、トランジスタではありません。新しいチップはそこすべてをゼロから始めます。より優れた設計でありながら負けることがあります。チップをどこまで実際に使えるかを決めるのはその周りのソフトウェアで、それには何年もかかるからです。
だから任意のカスタムチップについて私が尋ねる問いは、シリコンがどれだけ速いかではありません。ソフトウェアが追いつくかどうかです。来四半期に切り替えるモデルでも、まだ誰も発明していないトリックでも、コンパイラが書かれたことのない形状でも、まだ速いか。GPU はそのすべてに再コンパイル 1 つで答えます。
カスタム推論チップは、1 つのワークロードがシリコンに焼き込めるほど長く動かない、という賭けです。投機的デコーディングは 3 年前には今の形で存在せず、次のトリックもまだ存在しません。それが届いたとき、成熟したコンパイラを持つプログラマブルハードウェアの人々は数週間で出荷します。テープアウトした人々は違います。
PyTorch の関数を呼ぶことからその下のカーネルを書くことに移ったとき、性能のために 1 階層下りたのだと思っていましたが、それは制御のために 1 階層下りたのだと、今はもっと確信しています。性能とは、デフォルトがあなたの代わりに決めたことを受け入れるのをやめたときに手に入るものだからです。
だから、もっと見栄えのするデモのある何かではなく、なぜこれをやり続けるのかと聞かれたら、それが答えです。ハードウェアはこれからも良くなり続けます。そのうちどれだけがあなたに見えるかを決めるのはソフトウェアで、今はほとんど誰もそれを書いていません。それが重要な部分で、誰にでも手が届くようにしたい部分です。