Kernels de GPU, CUDA e escala. Notas de produto do laboratório.
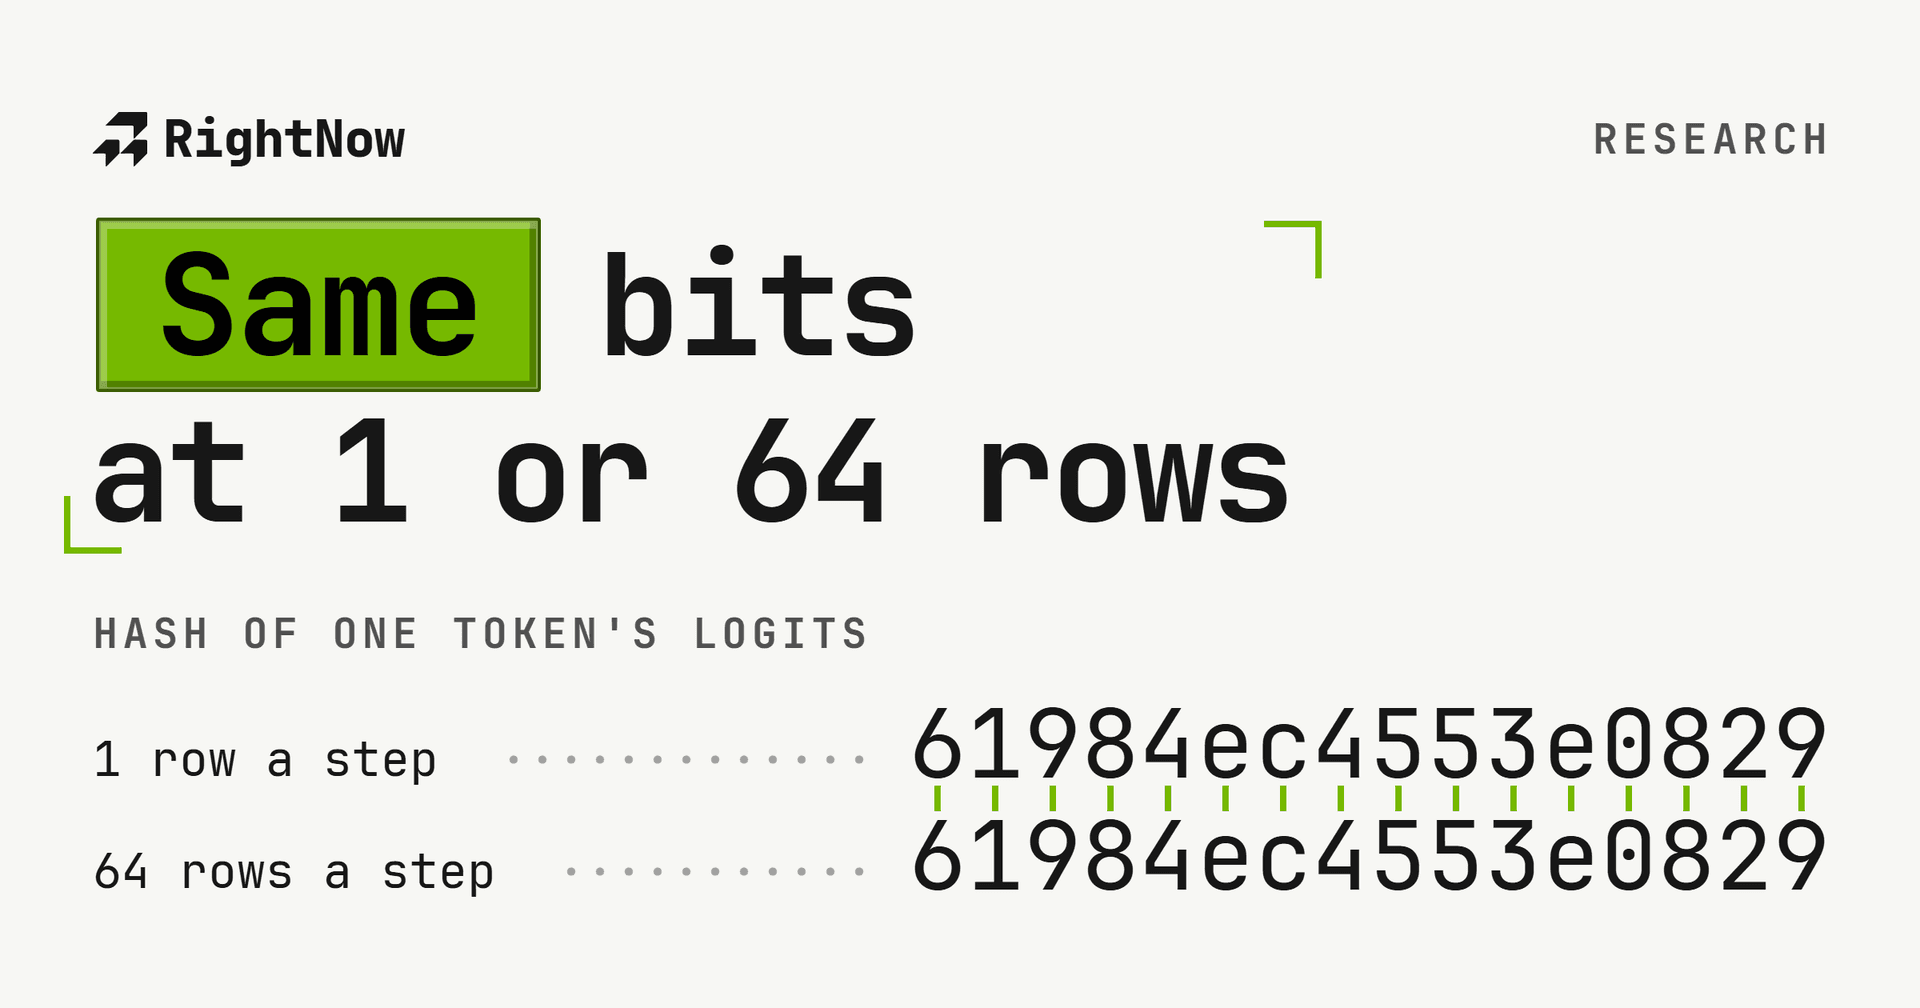
Kernels abertos para o modelo Inkling da Thinking Machines na NVIDIA B300: NVFP4 nativo, logits idênticos com uma ou sessenta e quatro linhas por passo.
Por Jaber Jaber
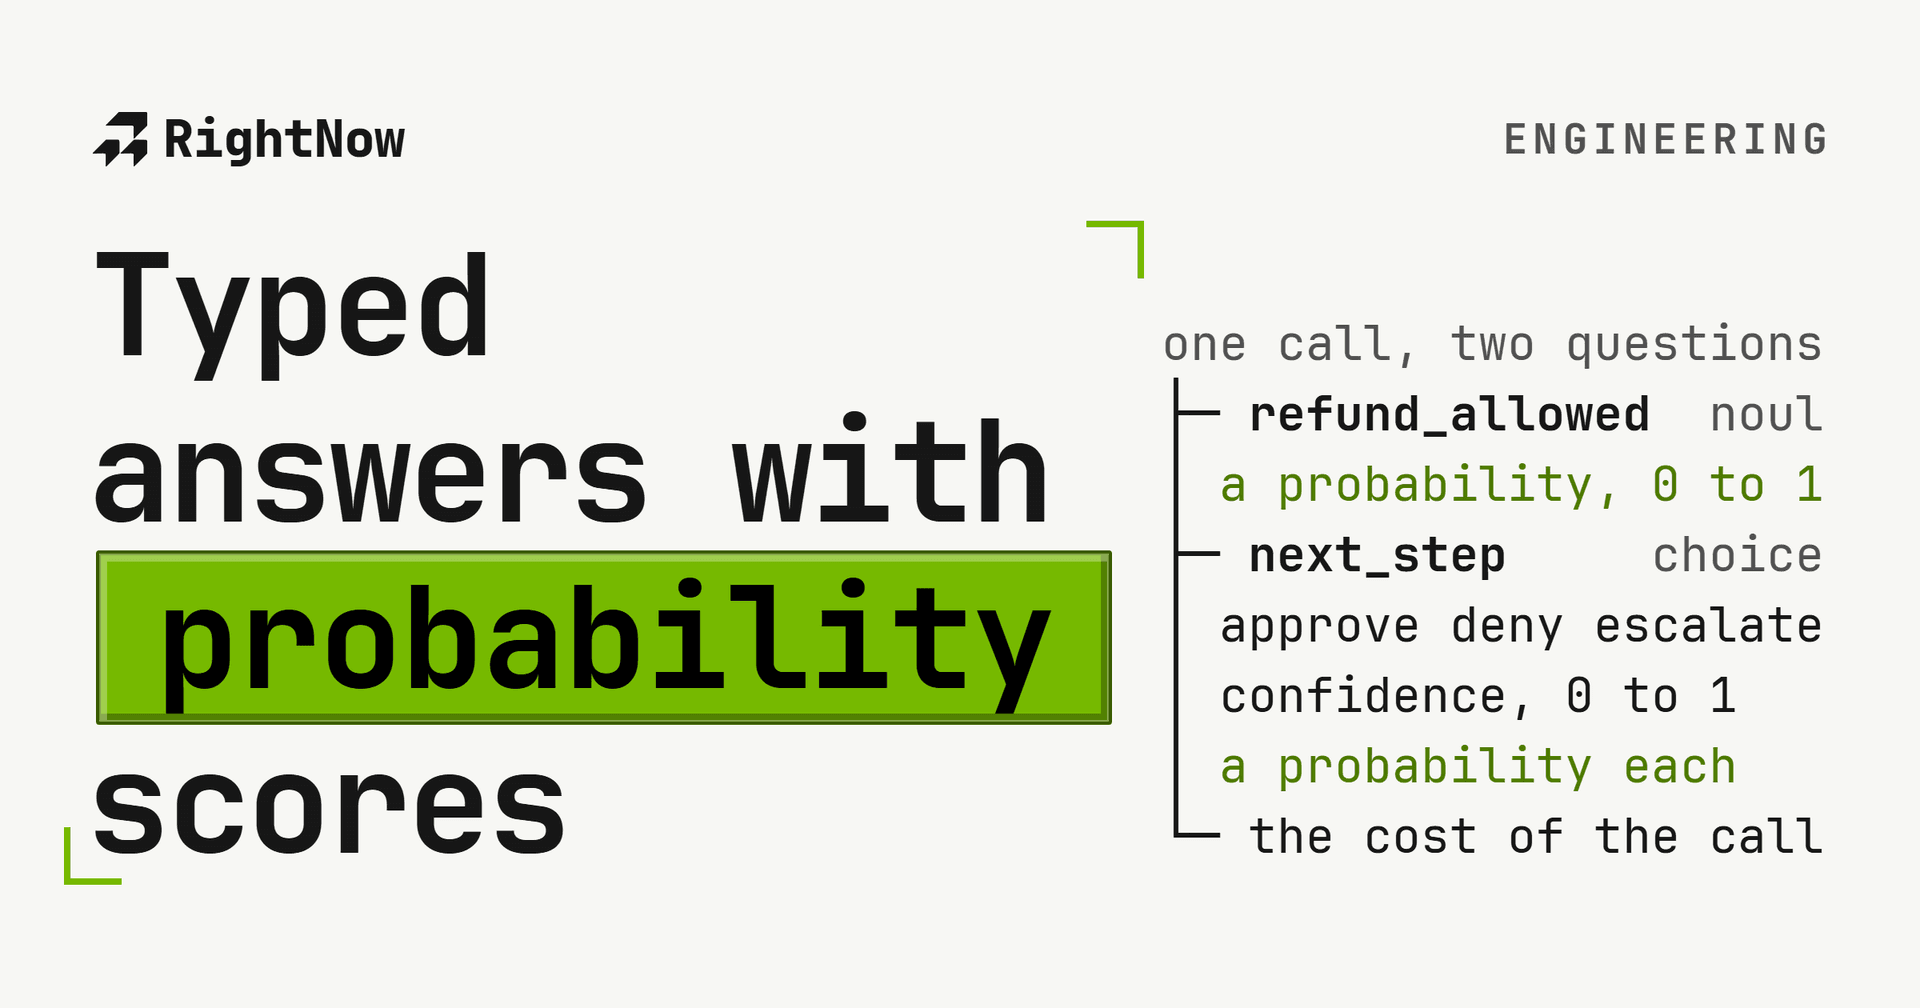
RightNow é o nosso primeiro modelo de decisão.
Por RightNow AI
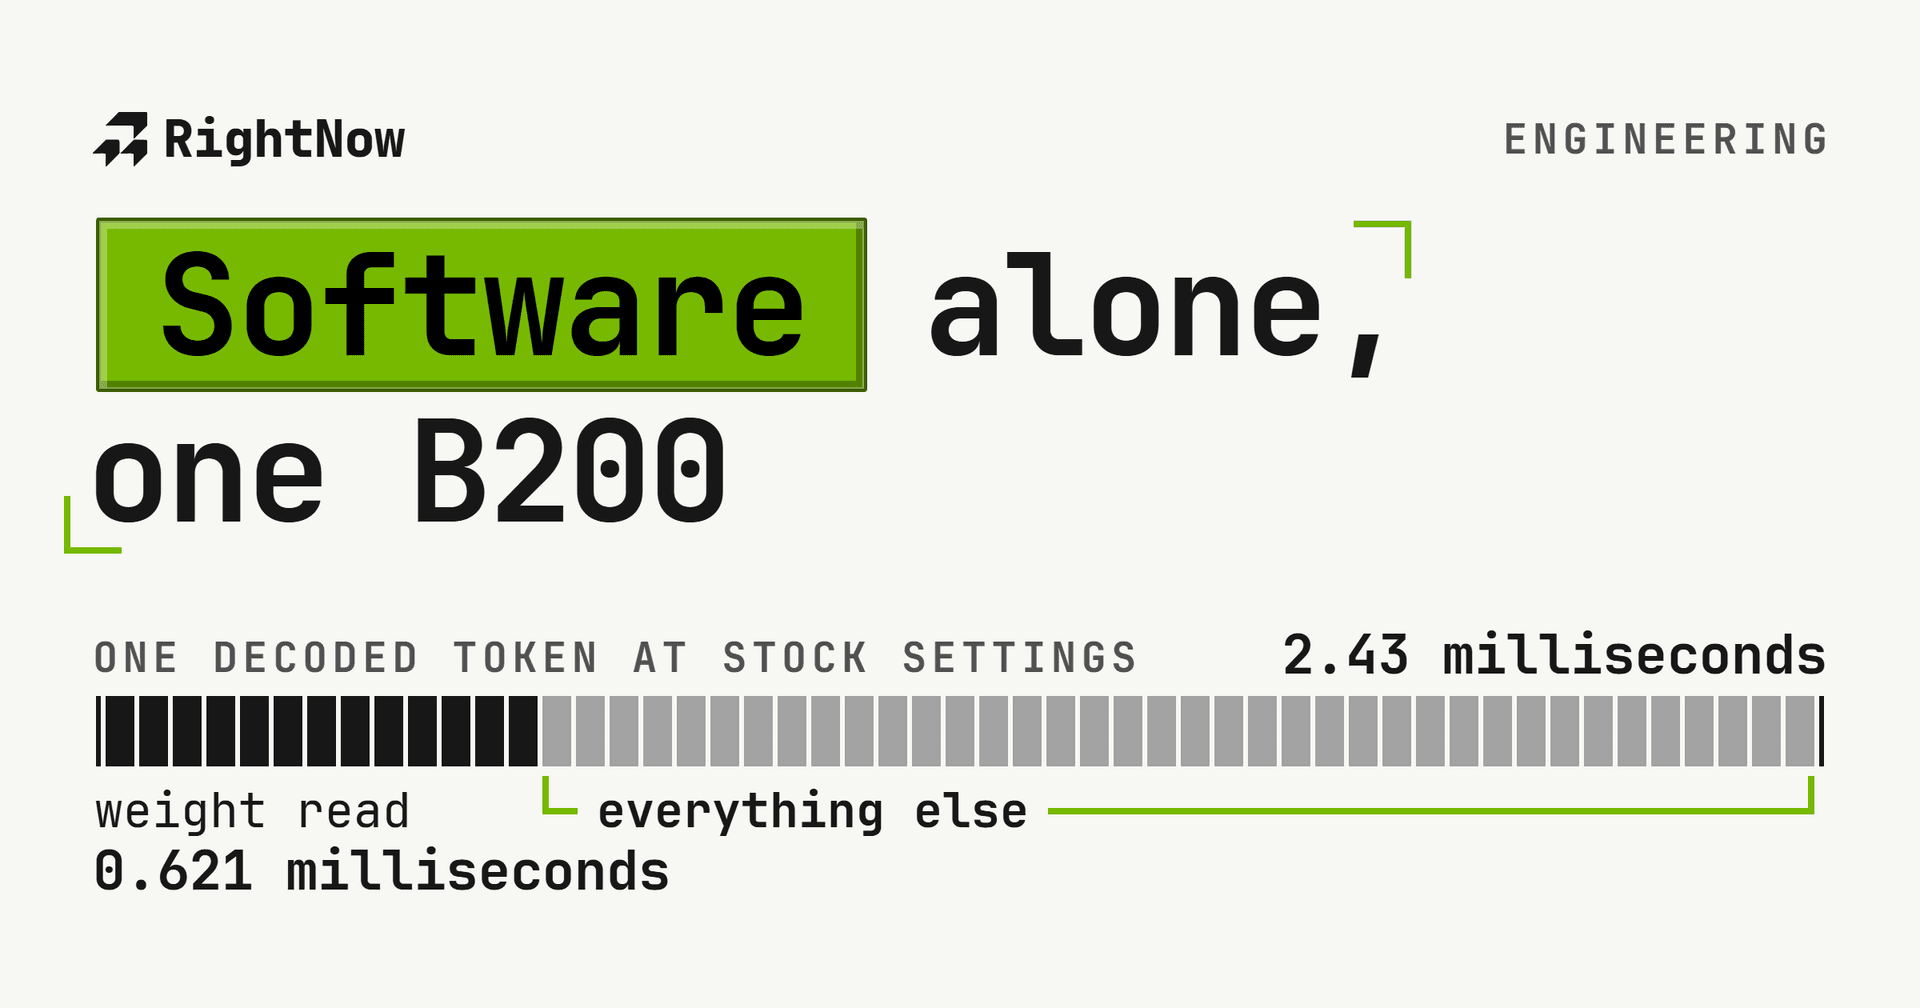
O SGLang de fábrica serviu gpt-oss-120b a 411 tokens por segundo numa B200 alugada. Quatro ajustes levaram a mesma placa e os mesmos pesos a 1,366, e prompts individuais a 2,215. Nenhum kernel escrito, nada recompilado.
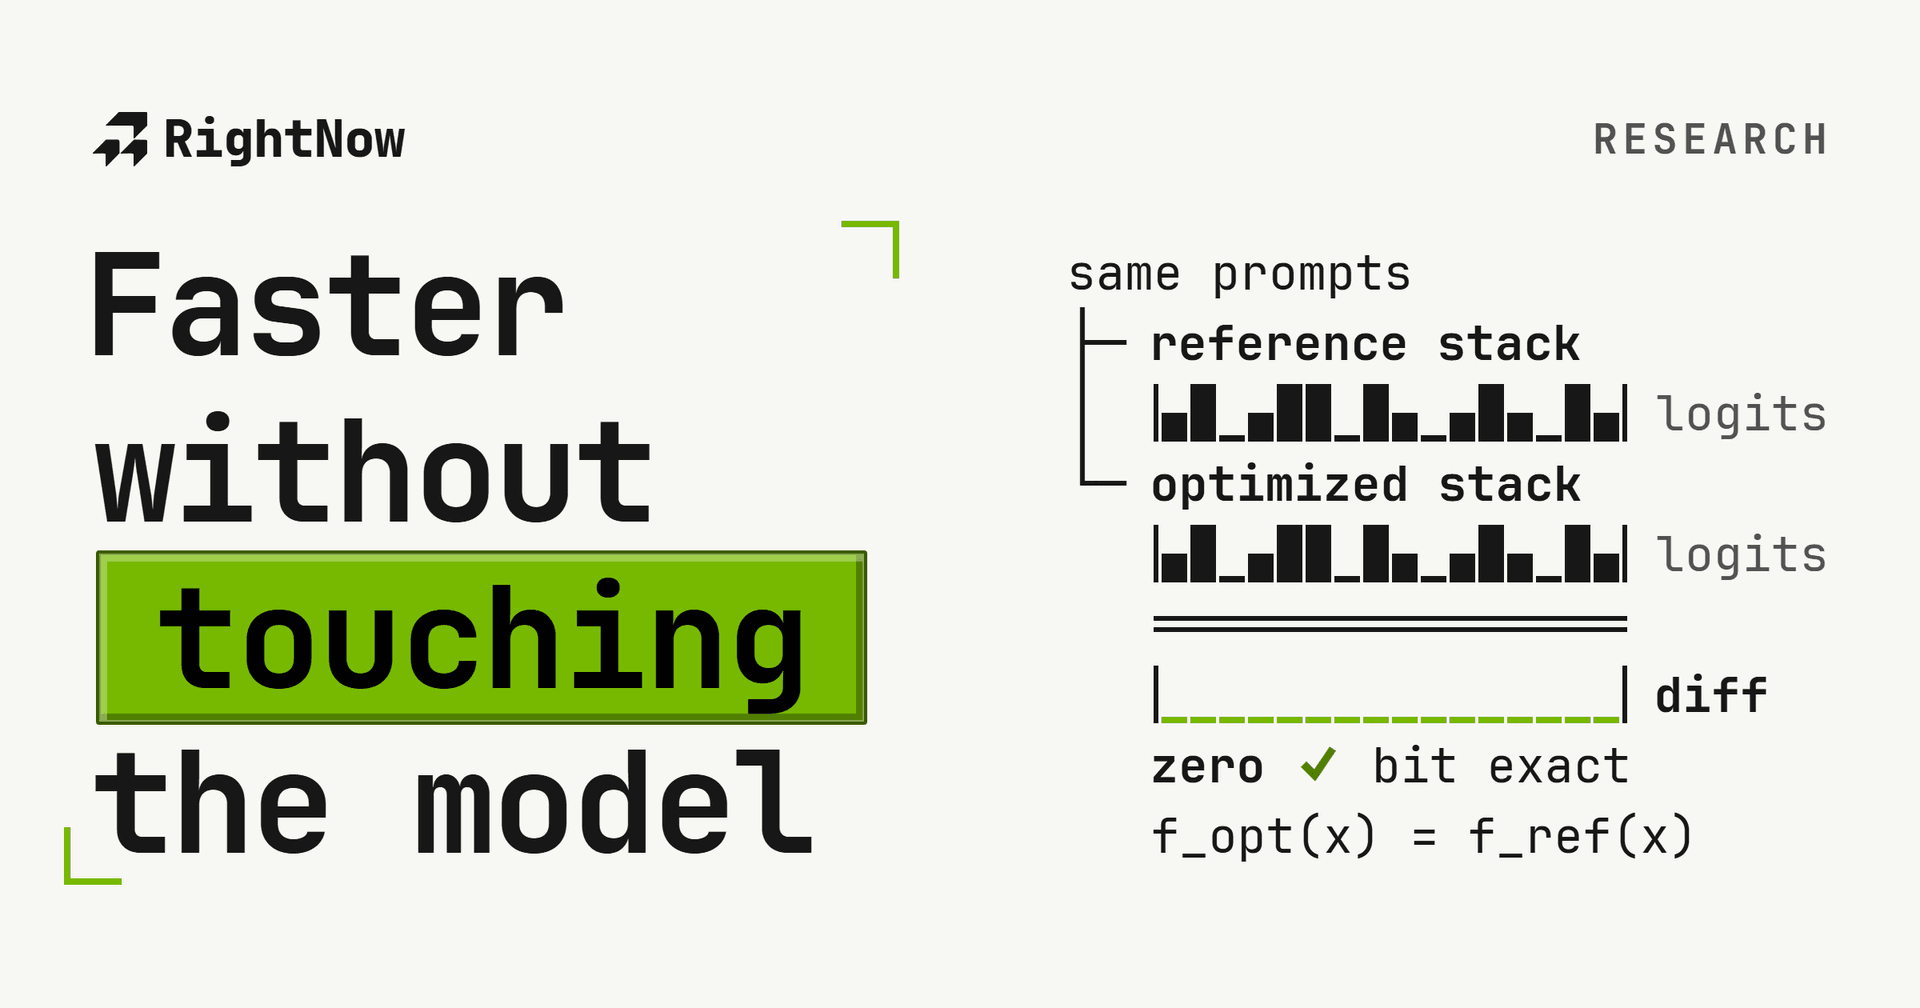
Como tornar o serving de LLM mais rápido sem tocar no modelo. Kernels exatos, decodificação especulativa, compressão sem perdas, reuso de KV e escalonamento, com a matemática e como verificar com paridade de logits.
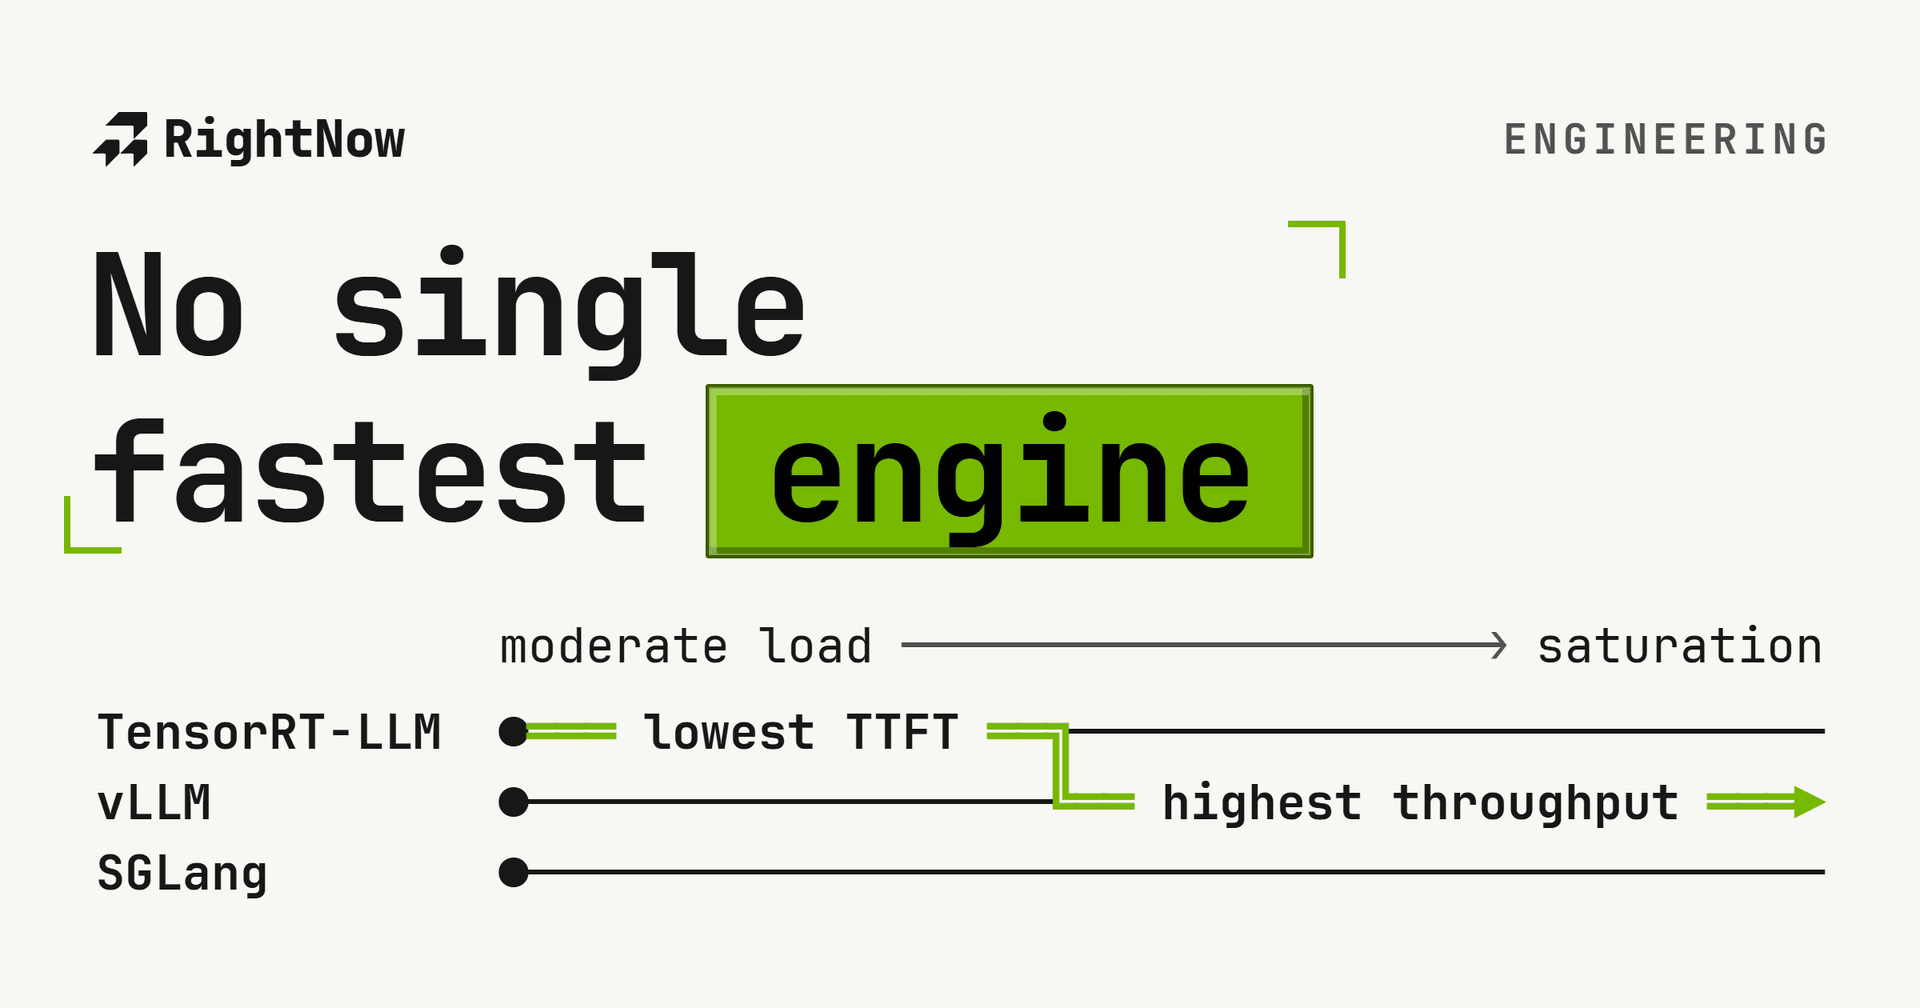
Resultados próprios de Llama-3.1-8B para três motores de inferência de LLM. As linhas publicadas de throughput com prompts únicos e de latência cobrem H100 bf16. FP8 e L40S aparecem apenas em resultados derivados de custo. O harness e os dados brutos não estão disponíveis publicamente.
Fazer o CUDA funcionar não deveria levar dias. Depois de analisar centenas de instalações com falha, reúni todas as correções de que você precisa para erros de PATH, drivers incompatíveis, problemas de WSL2 e mais. Pare de brigar com o nvcc e comece a programar.
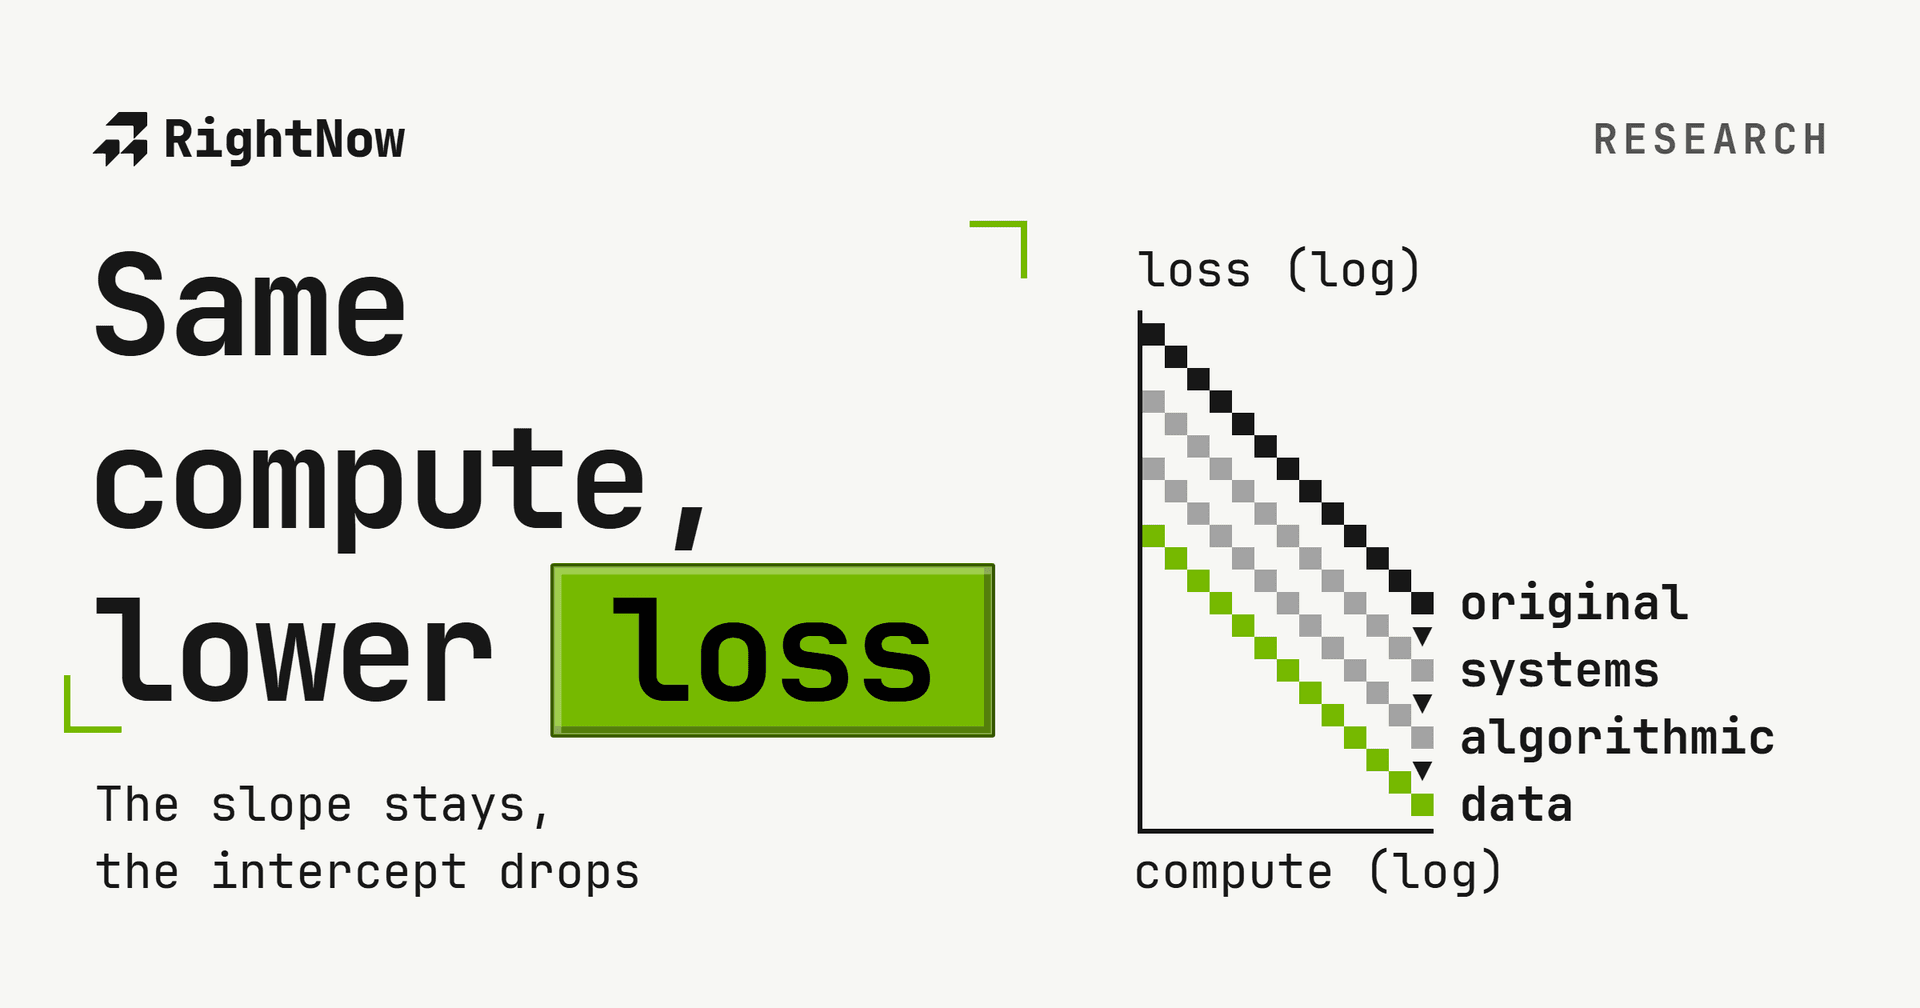
Quando pesquisadores plotam a perda de entropia cruzada do modelo contra a computação em escala log-log, o resultado é uma linha quase reta: a perda cai de forma previsível conforme aumentam a computação, o tamanho do modelo ou os tokens de treinamento. Essa regularidade empírica (a lei de escala) permite às equipes prever retornos, mas também mostra o limite: comprar mais GPUs dá retornos marginais decrescentes.
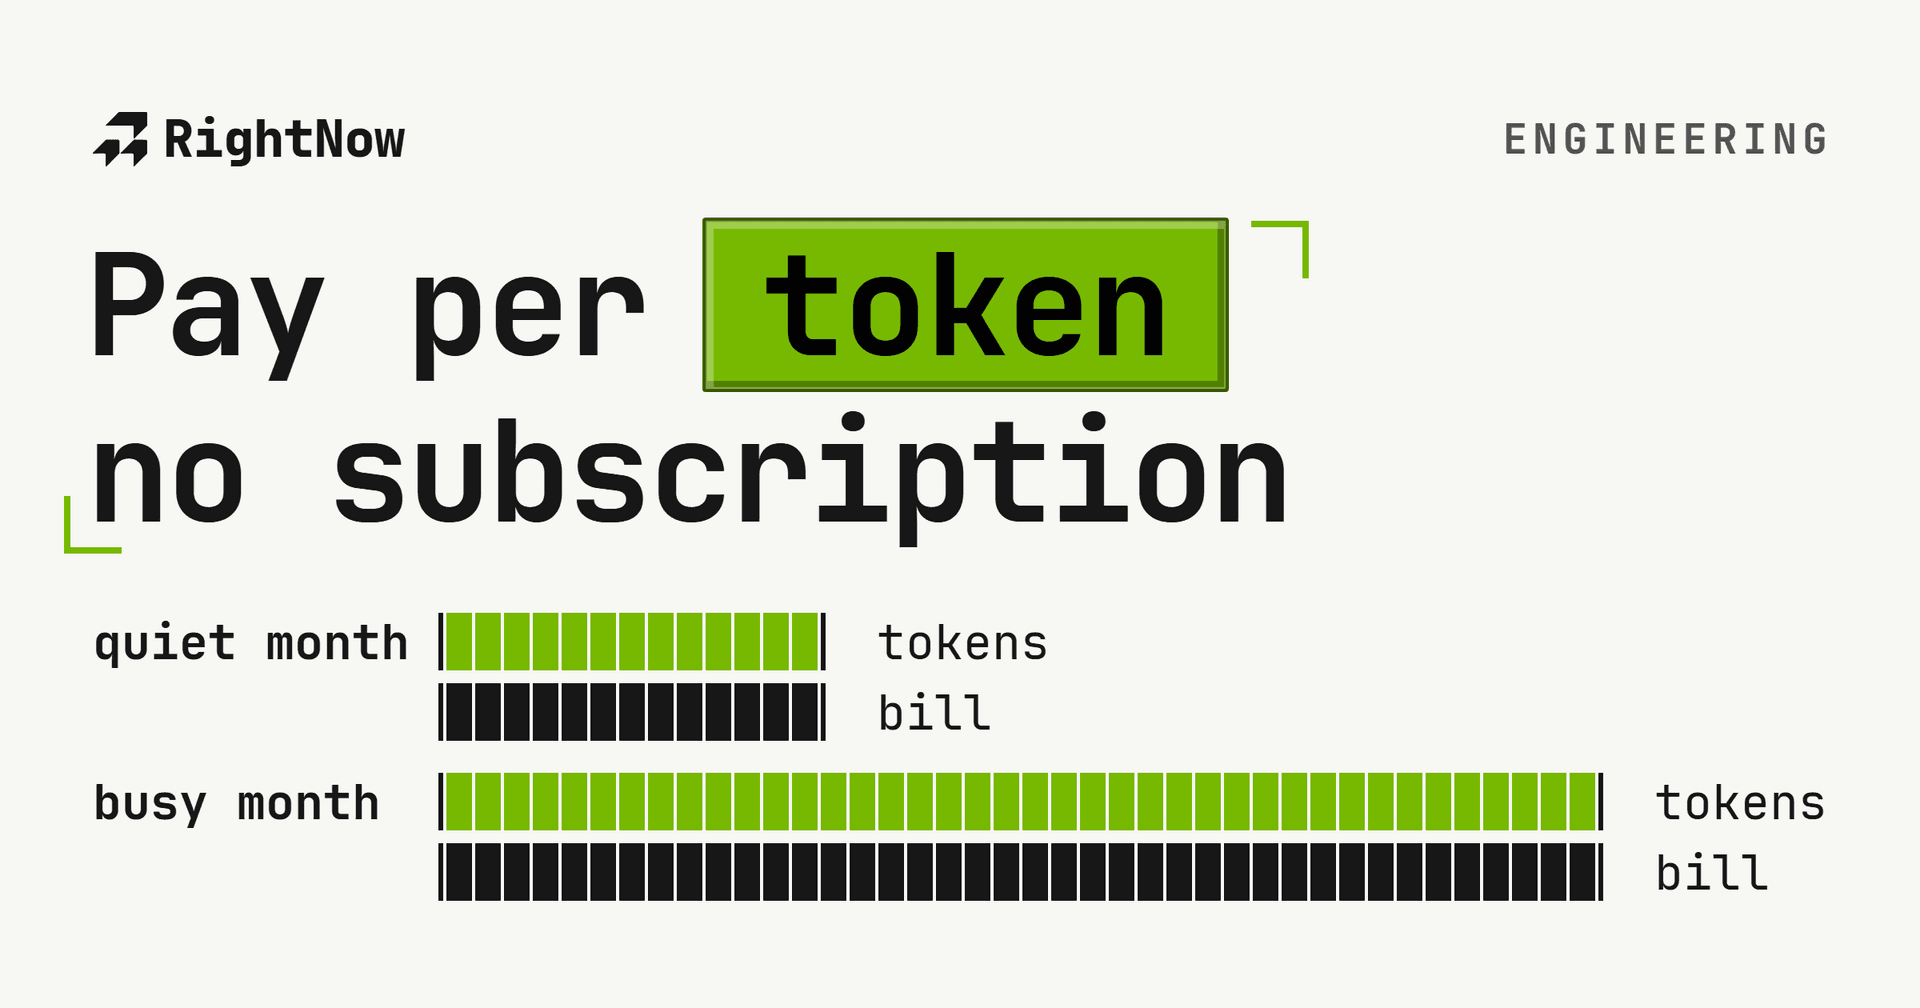
Chame os modelos abertos com uma chave de workspace por dois protocolos e pague por token de um único saldo, sem assinatura.
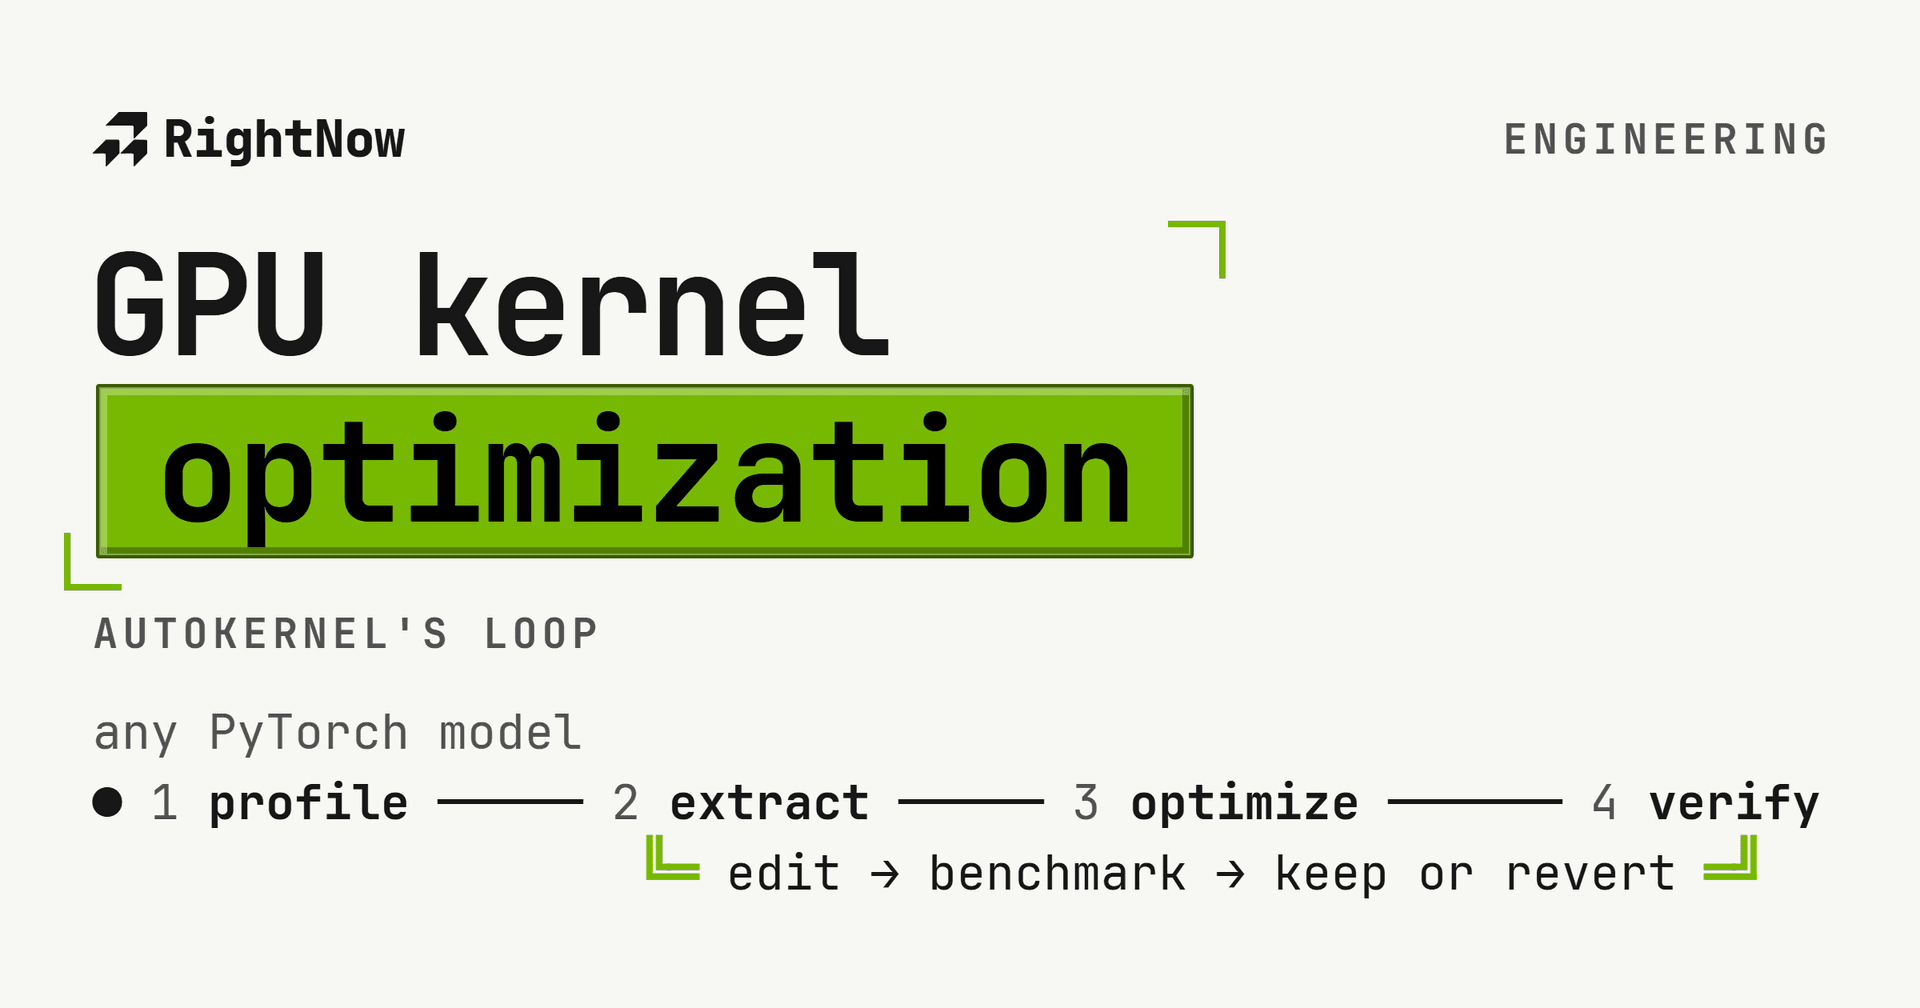
AutoKernel, a ferramenta de código aberto da RightNow AI para otimização de kernels de GPU, faz profiling de modelos PyTorch, testa variantes de Triton e segue gargalos medidos.
O RightNow decision model toma decisões estruturadas: envie um estado e perguntas nomeadas, depois leia probabilidades, confiança e respostas tipadas.
A API de modelos abertos da RightNow cobra por token a preços de tabela, sem assinatura e sem cobrança por usuário, e o Batch roda a metade do preço de tabela.