
Preços da API de modelos abertos: pague por token, sem assinatura
, 3 min de leitura, By Jaber Jaber
EngenhariaA API de modelos abertos da RightNow é paga por token, sem assinatura e sem cobrança por usuário. Cada modelo de pesos abertos tem seu próprio preço de tabela por milhão de tokens de entrada e saída, e o Batch processa um arquivo de solicitações pela metade do preço de tabela. $1 grátis para uma conta nova.
Como a inferência de modelos abertos é cobrada?
Com preço por modelo. A página de Preços lista as tarifas de entrada, entrada em cache e saída por milhão de tokens; sem uma tarifa de cache separada, a entrada em cache é faturada à tarifa de entrada.
| Model | Input | Cached input | Output |
|---|---|---|---|
| DeepSeek V4.1 Flash 1017DeepSeek | USD 0.15 | USD 0.01 | USD 0.60 |
| GLM 5.3Z.ai | USD 1.30 | USD 0.13 | USD 4.20 |
| GLM 5.3 FlashZ.ai | USD 0.11 | USD 0.03 | USD 0.45 |
| Nemotron 3.5 Lightning 30BNVIDIA | USD 0.05 | USD 0.01 | USD 0.15 |

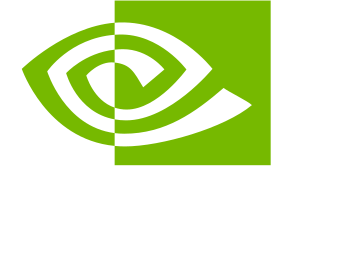
Cada workspace tem um único saldo. Um crédito é um dólar americano. Adicione créditos quando precisar e pague conforme o uso.
Existe assinatura ou cobrança por usuário?
Não. O pagamento por uso é faturado por token sem assinatura, em capacidade compartilhada. Não há cobrança por usuário, e seu preço não muda com o tamanho do seu time.
Sem gasto mínimo: qualquer conta pode chamar a API de modelos abertos. As recargas começam em USD 5, com recarga automática opcional, e continuam válidas por um ano. Esse $1 nunca expira.
E se o nosso volume variar de mês a mês?
A fatura conta tokens, então um mês calmo custa menos que um movimentado. Defina um orçamento mensal para cada chave. Com saldo zerado, chamadas à API de modelos abertos devolvem 402 Payment Required e não são faturadas.
Os limites crescem conforme escalamos?
As compras aumentam seus limites. Cada chave começa com 10,000 solicitações por minuto, 50,000 ao comprar créditos, e 200,000 quando suas compras atingem USD 200. Veja Limites.
Como baixamos uma fatura que não para de crescer?
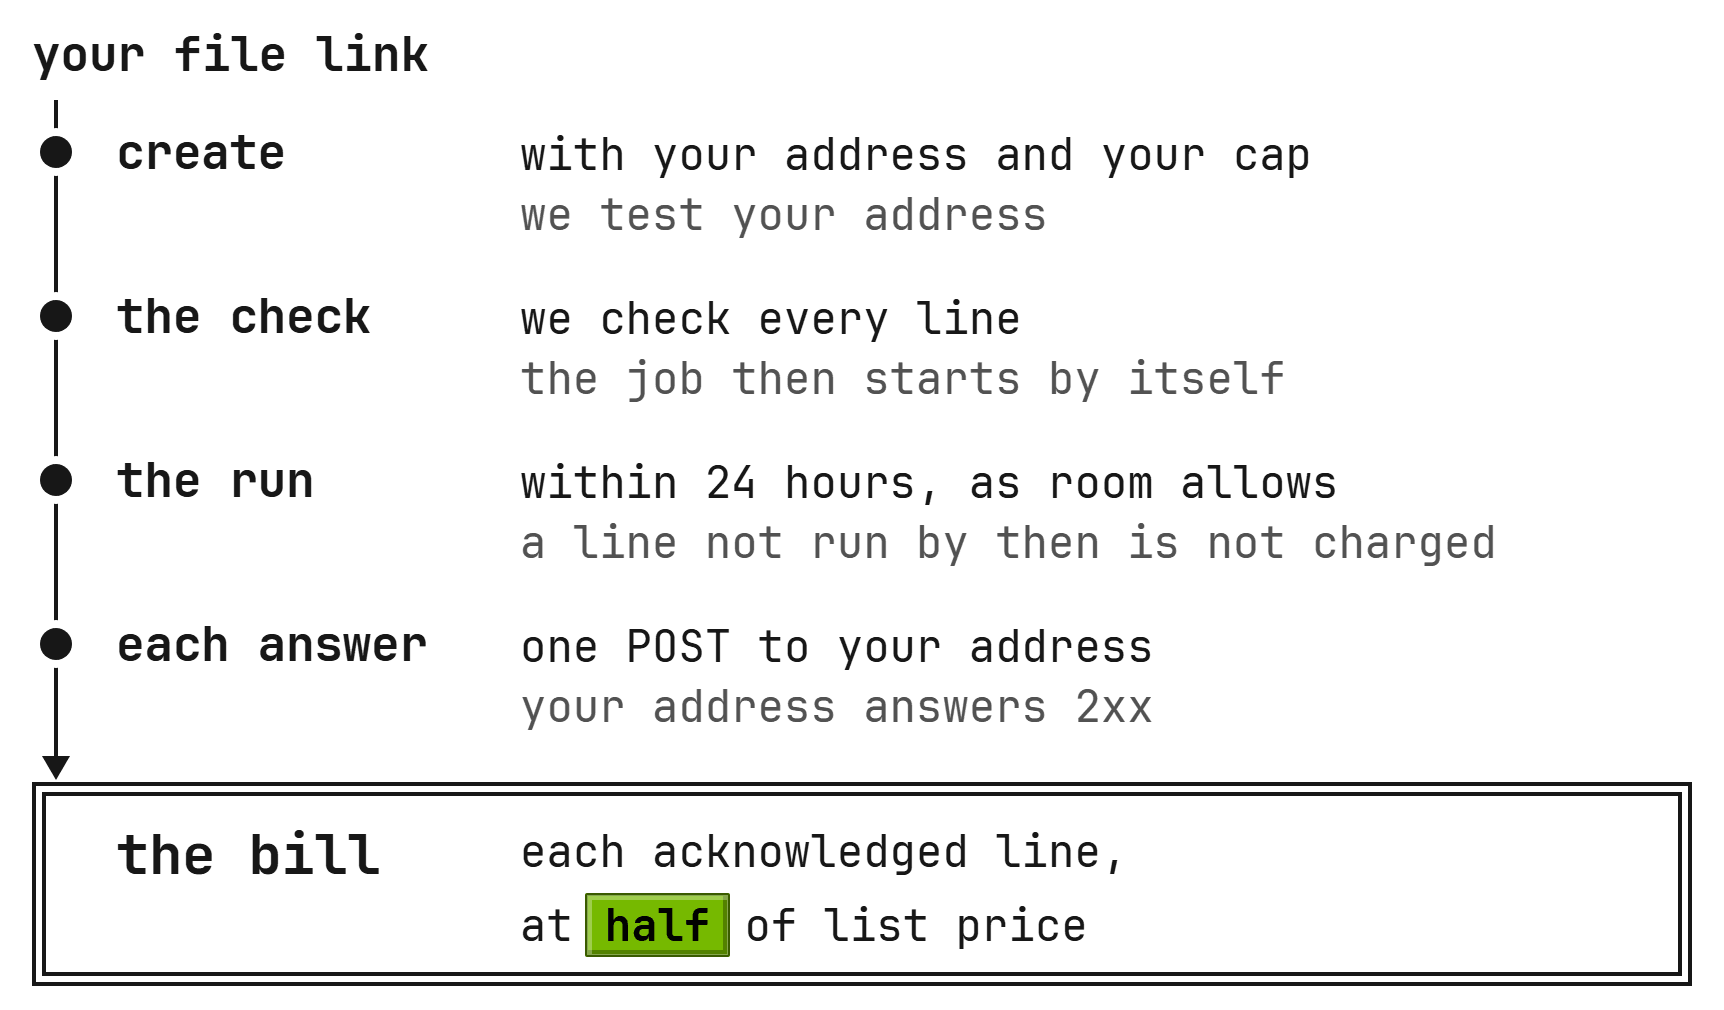
O Batch processa um arquivo de solicitações pela metade do preço de tabela, e cada resposta é publicada no seu próprio endereço. Um trabalho roda dentro de 24 horas conforme há espaço, e uma linha não executada até então não é cobrada.
Uma linha custa metade do preço de tabela em entrada, entrada em cache e saída, e é cobrada depois que seu endereço respondeu 2xx. O Batch usa a capacidade ociosa de um modelo, então não há hora de início prometida. Se o trabalho não pode esperar, use a API normal.
Uma solicitação também pode pedir o preço de Batch: envie service_tier: "flex" com ela. Uma solicitação que o preço de Batch não cobre não é recusada. Ela é atendida ao preço ordinário.
Prompts repetidos custam menos: o cache é automático e de melhor esforço. A entrada em cache é faturada ao preço de entrada em cache declarado pelo modelo escolhido. Veja Cache de prompts.
Quanto custaria um mês?
Escolha um modelo e digite os tokens que você espera em um mês. O valor de tabela é esses tokens de entrada e saída aos preços de tabela do modelo. O valor de Batch é a metade, para um modelo que oferece o preço de Batch.
Os valores são calculados a partir dos preços de tabela. Os preços de cada modelo estão na página de Preços.
Como começamos?
$1 grátis para uma conta nova. O guia rápido, Chamar um modelo aberto, leva você de uma chave de workspace a uma solicitação de chat no servidor. Cada modelo aberto tem sua própria página, com seus preços, em Modelos abertos.