
Precios de la API de modelos abiertos: pago por token, sin suscripción
, 3 min de lectura, By Jaber Jaber
IngenieríaLa API de modelos abiertos de RightNow es de pago por token, sin suscripción y sin cargos por usuario. Cada modelo de pesos abiertos tiene su propio precio de lista por millón de tokens de entrada y salida, y Batch procesa un archivo de solicitudes a mitad de precio de lista. $1 gratis para una cuenta nueva.
¿Cómo se cobra la inferencia de modelos abiertos?
Con precio por modelo. La página de Precios muestra las tarifas de entrada, entrada en caché y salida por millón de tokens; sin una tarifa de caché separada, la entrada en caché se factura a la tarifa de entrada.
| Model | Input | Cached input | Output |
|---|---|---|---|
| DeepSeek V4.1 Flash 1017DeepSeek | USD 0.15 | USD 0.01 | USD 0.60 |
| GLM 5.3Z.ai | USD 1.30 | USD 0.13 | USD 4.20 |
| GLM 5.3 FlashZ.ai | USD 0.11 | USD 0.03 | USD 0.45 |
| Nemotron 3.5 Lightning 30BNVIDIA | USD 0.05 | USD 0.01 | USD 0.15 |

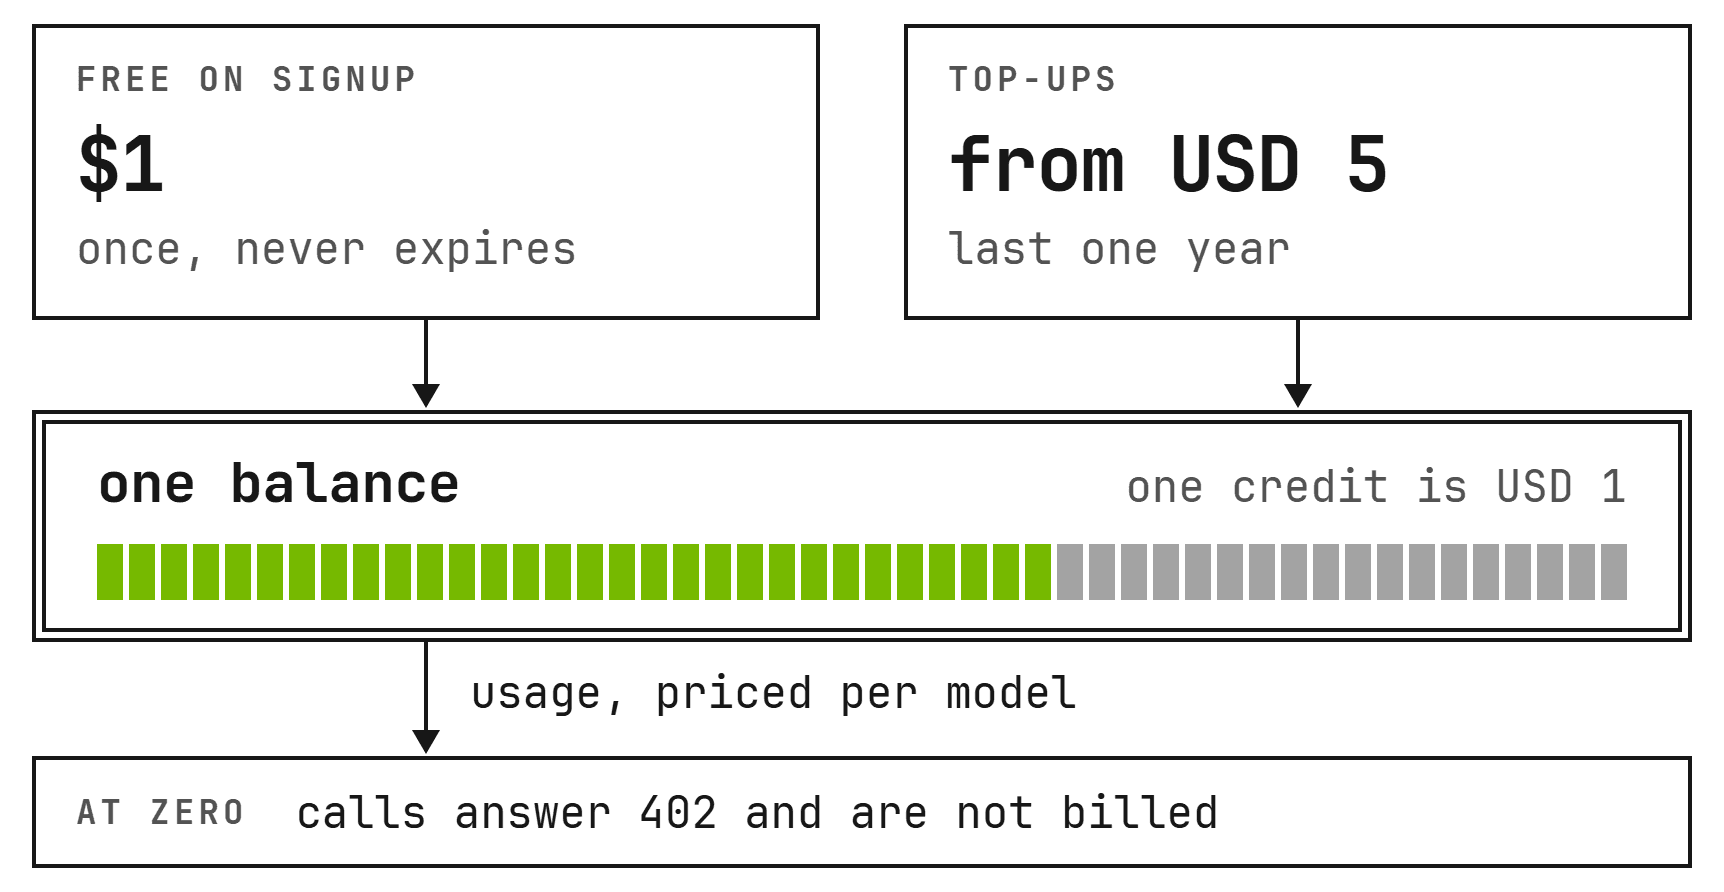
Cada workspace tiene un solo saldo. Un crédito es un dólar estadounidense. Agrega créditos cuando los necesites y paga a medida que uses.
¿Hay suscripción o cargo por usuario?
No. El pago por uso se factura por token sin suscripción, sobre capacidad compartida. No hay cargos por usuario, y tu precio no cambia con el tamaño de tu equipo.
Sin gasto mínimo: cualquier cuenta puede llamar a la API de modelos abiertos. Las recargas empiezan en USD 5, con recarga automática opcional, y se mantienen válidas por un año. Ese $1 nunca expira.
¿Y si nuestro volumen cambia de mes a mes?
La factura cuenta tokens, así que un mes tranquilo cuesta menos que uno ocupado. Fija un presupuesto mensual para cada clave. Con saldo en cero, las llamadas a la API de modelos abiertos devuelven 402 Payment Required y no se facturan.
¿Los límites crecen al escalar?
Las compras suben tus límites. Cada clave empieza con 10,000 solicitudes por minuto, 50,000 al comprar créditos, y 200,000 cuando tus compras alcanzan USD 200. Ver Límites.
¿Cómo bajamos una factura que no deja de crecer?
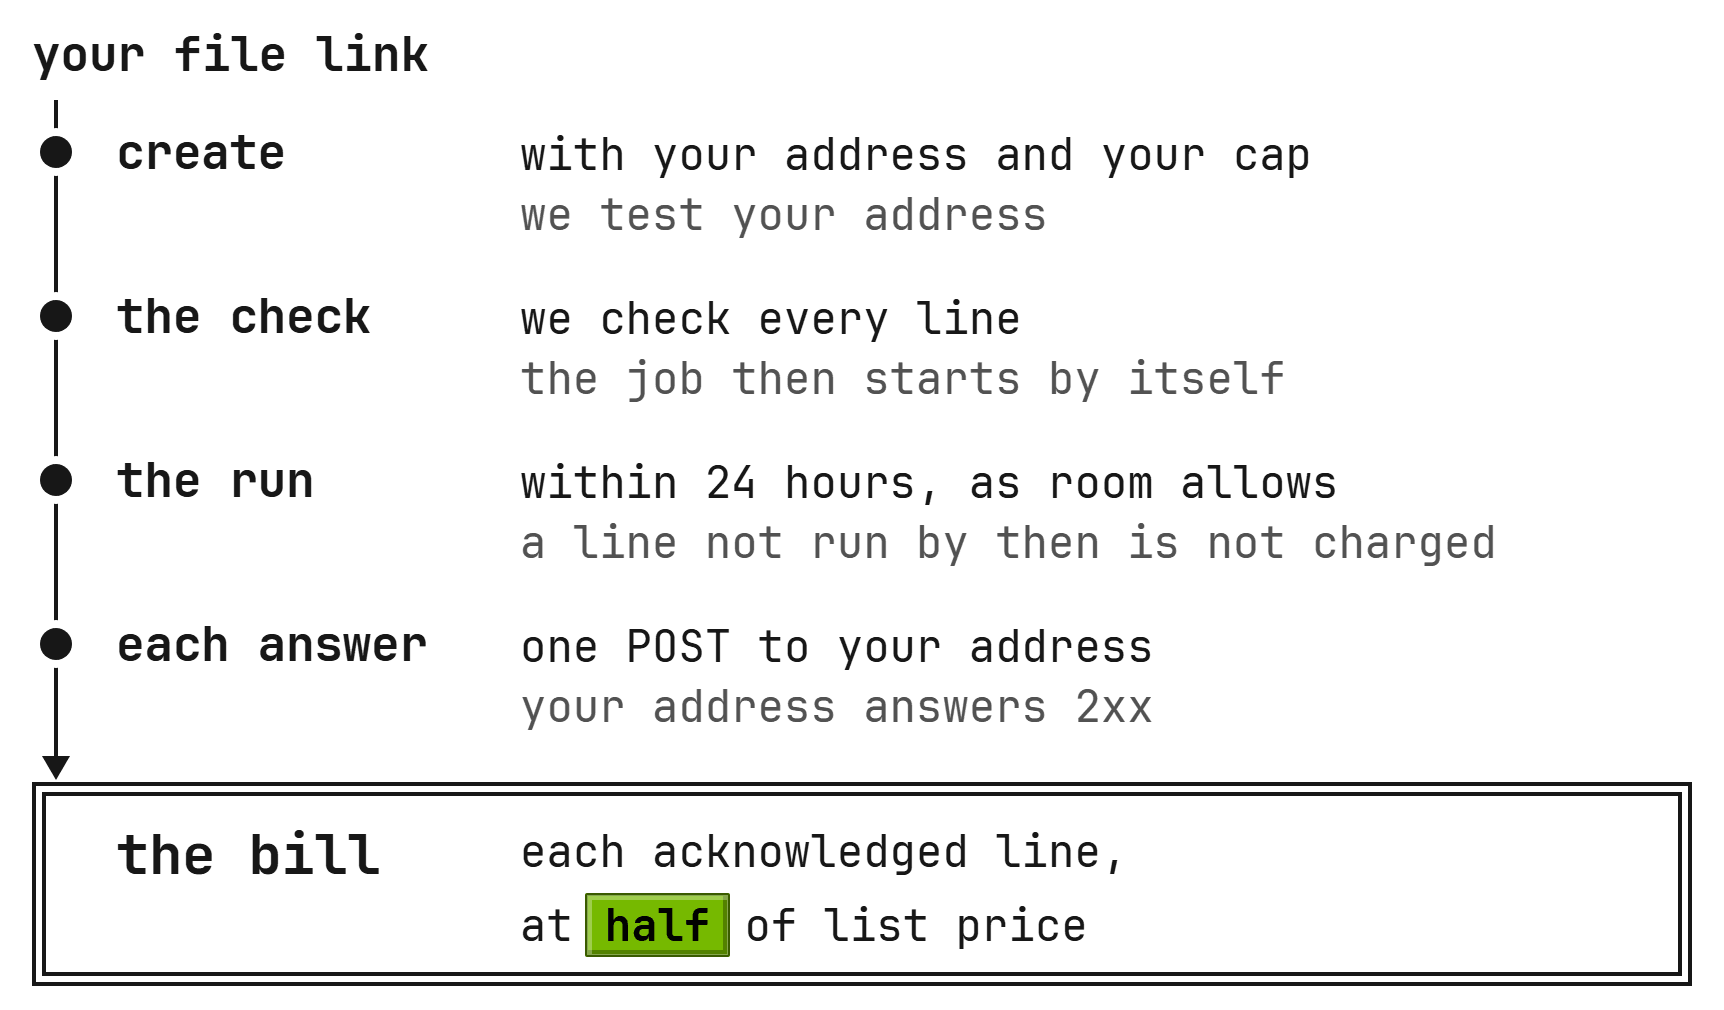
Batch procesa un archivo de solicitudes a mitad de precio de lista, y cada respuesta se publica en tu propia dirección. Un trabajo se ejecuta dentro de 24 horas según haya espacio, y una línea no ejecutada para entonces no se cobra.
Una línea cuesta la mitad del precio de lista en entrada, entrada en caché y salida, y se cobra después de que tu dirección respondió 2xx. Batch usa la capacidad libre de un modelo, así que no hay hora de inicio prometida. Si el trabajo no puede esperar, usa la API normal.
Una solicitud también puede pedir el precio de Batch: envía service_tier: "flex" con ella. Una solicitud que el precio de Batch no cubre no se rechaza. Se sirve al precio ordinario.
Los prompts repetidos cuestan menos: el caché es automático y de mejor esfuerzo. La entrada en caché se factura al precio de entrada en caché declarado por el modelo elegido. Ver Caché de prompts.
¿Cuánto costaría un mes?
Elige un modelo y escribe los tokens que esperas en un mes. El monto de lista es esos tokens de entrada y salida a los precios de lista del modelo. El monto de Batch es la mitad, para un modelo que ofrece el precio de Batch.
Los montos se calculan a partir de los precios de lista. Los precios de cada modelo están en la página de Precios.
¿Cómo empezamos?
$1 gratis para una cuenta nueva. La guía rápida, Llamar a un modelo abierto, te lleva de una clave de workspace a una solicitud de chat del lado del servidor. Cada modelo abierto tiene su propia página, con sus precios, en Modelos abiertos.