
Como quebrar o muro da escala
, 3 min de leitura, By Jaber Jaber
ResearchQuando pesquisadores plotam a perda de entropia cruzada do modelo contra a computação em escala log-log, o resultado é uma linha quase reta: a perda cai de forma previsível conforme aumentam a computação, o tamanho do modelo ou os tokens de treinamento. Essa regularidade empírica (a lei de escala) permite às equipes prever retornos, mas também mostra o limite: comprar mais GPUs dá retornos marginais decrescentes.
O trabalho compute-optimal da DeepMind mostrou depois que, com um orçamento fixo de computação, treinar mais tokens no tamanho de modelo certo pode superar o simples aumento do número de parâmetros. Por isso tokens e higiene de dados importam tanto quanto a escala bruta do modelo.
Esses dois fatos definem o problema que nos importa. A pergunta de engenharia não é se a lei de escala existe. A pergunta é como deslocar o intercepto dessa linha log-log para que os mesmos FLOPs comprem menos perda.
A seguir eu esboço os mecanismos que movem o intercepto de forma confiável e dou um plano de uma semana que você pode rodar em qualquer stack.
O que realmente move o intercepto
1) Torne cada token mais informativo: higiene e foco de dados. Remova duplicatas e texto de baixo valor. Pontue e pondere exemplos de alto sinal. Gere conjuntos de dados sintéticos pequenos e direcionados a modos de falha reais em vez de despejar texto sintético aleatório no treinamento. Esses passos aumentam a eficiência de amostra e elevam o valor efetivo de cada passo de treinamento.
2) Aumente a capacidade efetiva sem FLOPs lineares: truques algorítmicos. Computação condicional (esparcidade, MoE) ativa apenas os parâmetros que você precisa por token. Adaptadores de baixo posto (LoRA) permitem ajustar capacidades com muito menos parâmetros treináveis. Quantização prática (por exemplo, fluxos de 4 bits) reduz os custos de memória e largura de banda preservando a precisão.
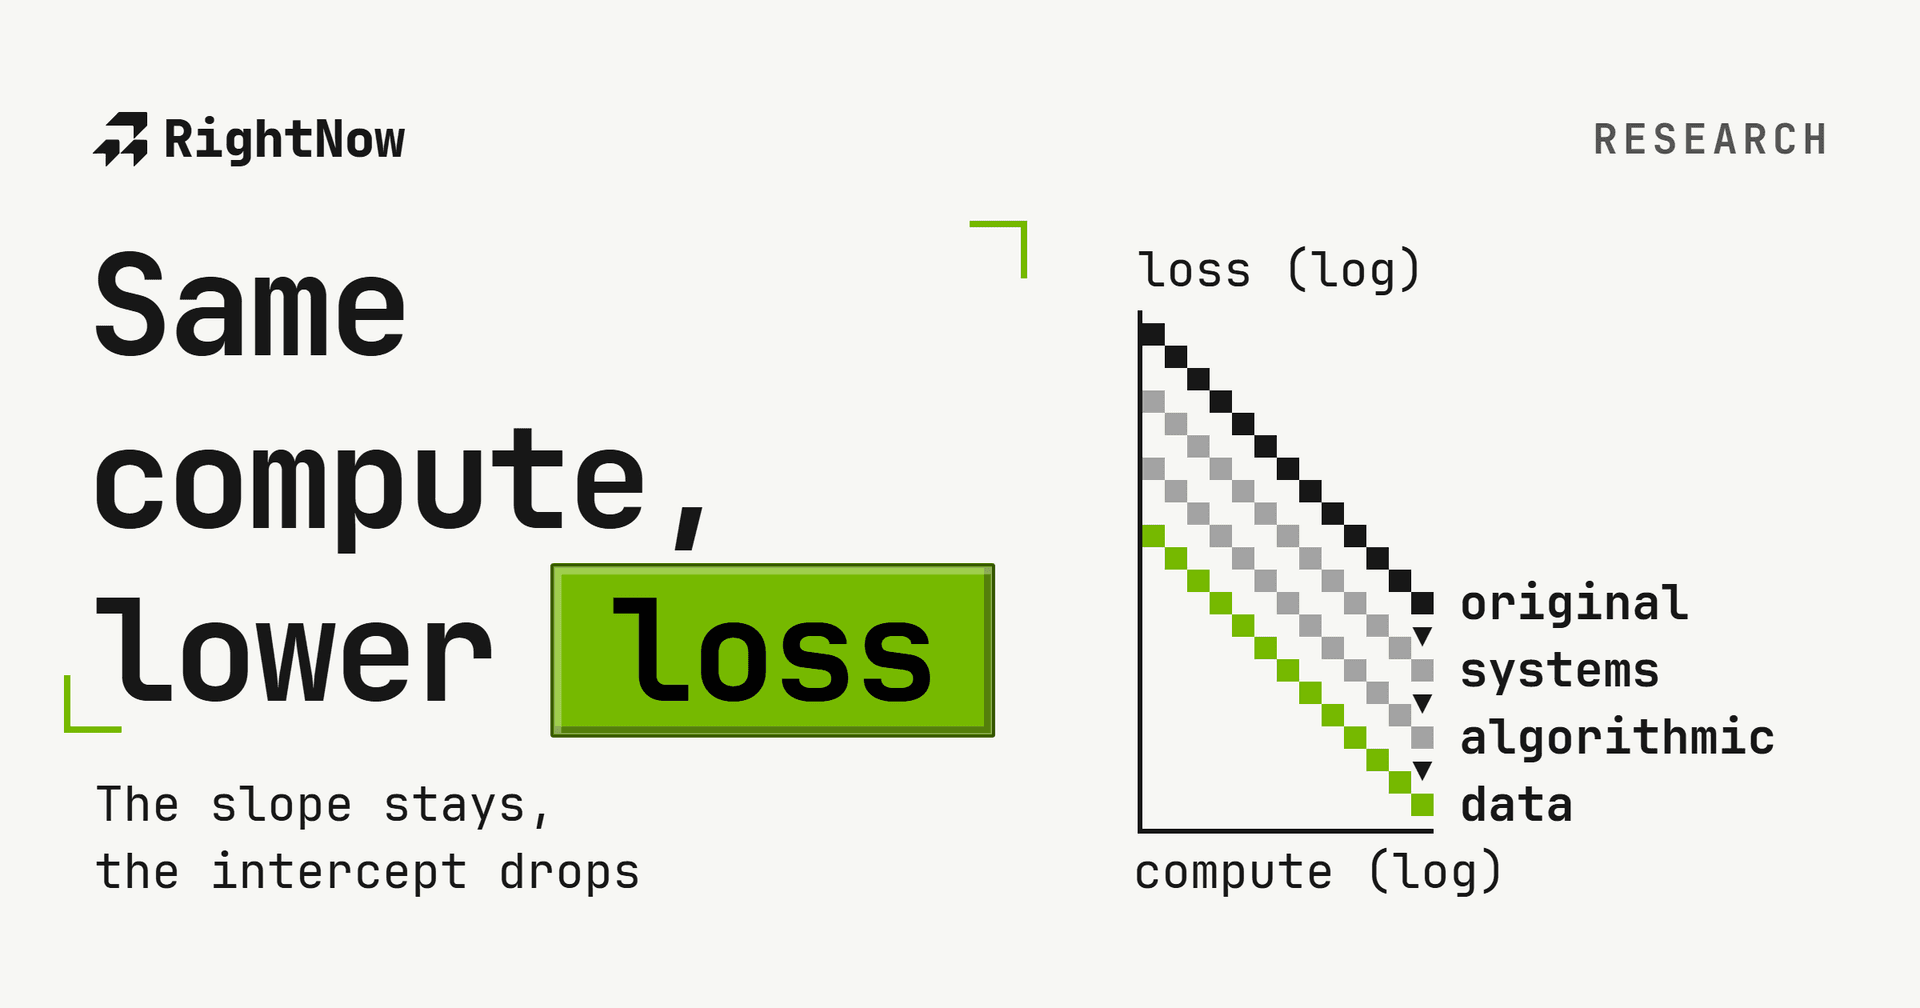
Essas técnicas mudam as constantes da lei de escala: a inclinação fica, o intercepto cai.
3) Esprema o hardware: engenharia de sistemas que converte ciclos pagos em progresso útil. Faça profiling de execuções reais e corrija os caminhos quentes. Substitua atenção pesada em IO por kernels conscientes de IO (FlashAttention), funda kernels para eliminar cópias extras, otimize os layouts de memória e ajuste sua mistura de paralelismo de pipeline/tensor/dados. Sharding de memória (ZeRO) reduz a pressão de memória por GPU e as travas de comunicação.
Essas correções transformam ciclos ociosos ou bloqueados em FLOPs que de fato reduzem a perda.
Empilhe esses três grupos e você obtém menos perda com o mesmo orçamento de FLOPs: na prática, desloca a linha inteira para baixo no gráfico log-log.
Visualização do escalonamento
Loss (log)
  │
  │\
  │ \\
  │  \\\    original scaling (Kaplan-style power law)
  │   \\\
  │    \\\     ← after systems optim (FlashAttention, ZeRO)
  │     \\\
  │      \\\   ← after algorithmic optim (MoE, LoRA, quant)
  │       \\\  ← after data optim (dedupe, targeted synth)
  └──────────────────────────────────── Compute (log)
     C0     C1     C2     C3
Interpretação: A inclinação (o expoente de escala) permanece. Intervenções de dados, algoritmo e sistema abaixam o intercepto: mesma computação, menor perda.
Onde a computação paga costuma se perder (meça primeiro)
Typical waste breakdown (illustrative)
┌─────────────────────────────────────┐
│ Duplicates / low-value tokens : 30% │
│ Kernel inefficiencies         : 25% │
│ Communication / imbalance     : 20% │
│ Checkpoint / IO overhead      : 15% │
│ Suboptimal hyperconfig        : 10% │
└─────────────────────────────────────┘
Recuperar mesmo uma parte dessas perdas pode produzir o resultado efetivo de um cluster muito maior.
Um plano de uma semana (prático: rode agora)
Dia 1: Profile uma execução completa. Capture rastros de kernels e comunicação; ache os 3 pontos quentes por tempo de relógio.
Dia 2: Higiene de dados. Rode deduplicação e pontuação de qualidade numa fatia representativa. Retreine uma época e compare a perda de validação.
Dia 3: Ajuste barato. Substitua um retreino completo por LoRA/QLoRA em modos de falha específicos e meça o ganho por hora de GPU.
Dia 4: Correções de kernels. Troque um operador crítico por uma implementação consciente de IO (por exemplo, FlashAttention), funda kernels ou mude o layout do tensor. Meça a mudança no tempo de relógio.
Dia 5: Ajuste distribuído. Aplique sharding/ZeRO onde couber; reprofile e remova o desequilíbrio.
Dia 6: Pequena sonda de computação condicional. Prototipe um MoE minúsculo ou um bloco condicional num subconjunto para validar ganhos de capacidade.
Dia 7: Sintetize e itere. Gere exemplos sintéticos direcionados aos erros restantes, adapte e meça.
Sempre converta melhorias em dólares ou contagens de experimentos: segundos economizados → horas de GPU economizadas → experimentos ganhos por mês.
Justificativas científicas rápidas
Leis de escala: a relação empírica de lei de potência entre computação, tokens e tamanho do modelo fornece a inclinação para o planejamento. (Kaplan et al., 2020)
Compromisso compute-optimal: Chinchilla mostra que tokens importam; treinar no ponto compute-optimal costuma favorecer mais tokens no tamanho de modelo certo. (Hoffmann et al., 2022)
Vitórias de sistemas: atenção consciente de IO e kernels fundidos reduzem drasticamente o tempo de relógio em execuções pesadas de atenção (FlashAttention).
Eficiência algorítmica: LoRA e adaptadores de baixo posto permitem ajustes baratos; MoE e computação condicional rendem modelos efetivamente grandes com menos FLOPs ativos.
Sharding de memória: ZeRO e técnicas relacionadas de sharding permitem escalar modelos entre nós sem explosão linear de memória.