
如何打破缩放之墙
, 阅读时间 3 分钟, By Jaber Jaber
Research当研究人员把模型的交叉熵损失与计算量画在对数-对数坐标上时,结果接近一条直线:随着计算量、模型规模或训练 token 的增加,损失可预测地下降。这一经验规律(缩放定律)让团队能预测回报,但它也显示了一个极限:购买更多 GPU 的边际回报递减。
DeepMind 的计算最优工作后来表明,在固定的计算预算下,以合适的模型规模训练更多 token 可以胜过单纯增加参数量。这就是 token 和数据清洗与原始模型规模同样重要的原因。
这两个事实确定了我们关心的问题。工程问题不是缩放定律是否存在,而是如何移动这条对数-对数线的截距,让同样的 FLOPs 买到更低的损失。
下面我概述能可靠移动截距的机制,并给出一周行动手册,可在任何技术栈上运行。
真正移动截距的是什么
1) 让每个 token 信息更多:数据清洗与定向。 去除重复和低价值文本。对高信号样本打分并加权。生成小而定向的合成数据集,针对真实失败模式,而不是把随机合成文本倒进训练。这些步骤提高样本效率,提升每个训练步的有效价值。
2) 不付线性 FLOPs 就提高有效容量:算法技巧。 条件计算(稀疏化、MoE)只激活每个 token 需要的参数。低秩适配器(LoRA)让你用少得多的可训练参数微调能力。实用的量化(如 4-bit 工作流)在保持精度的同时降低内存和带宽成本。
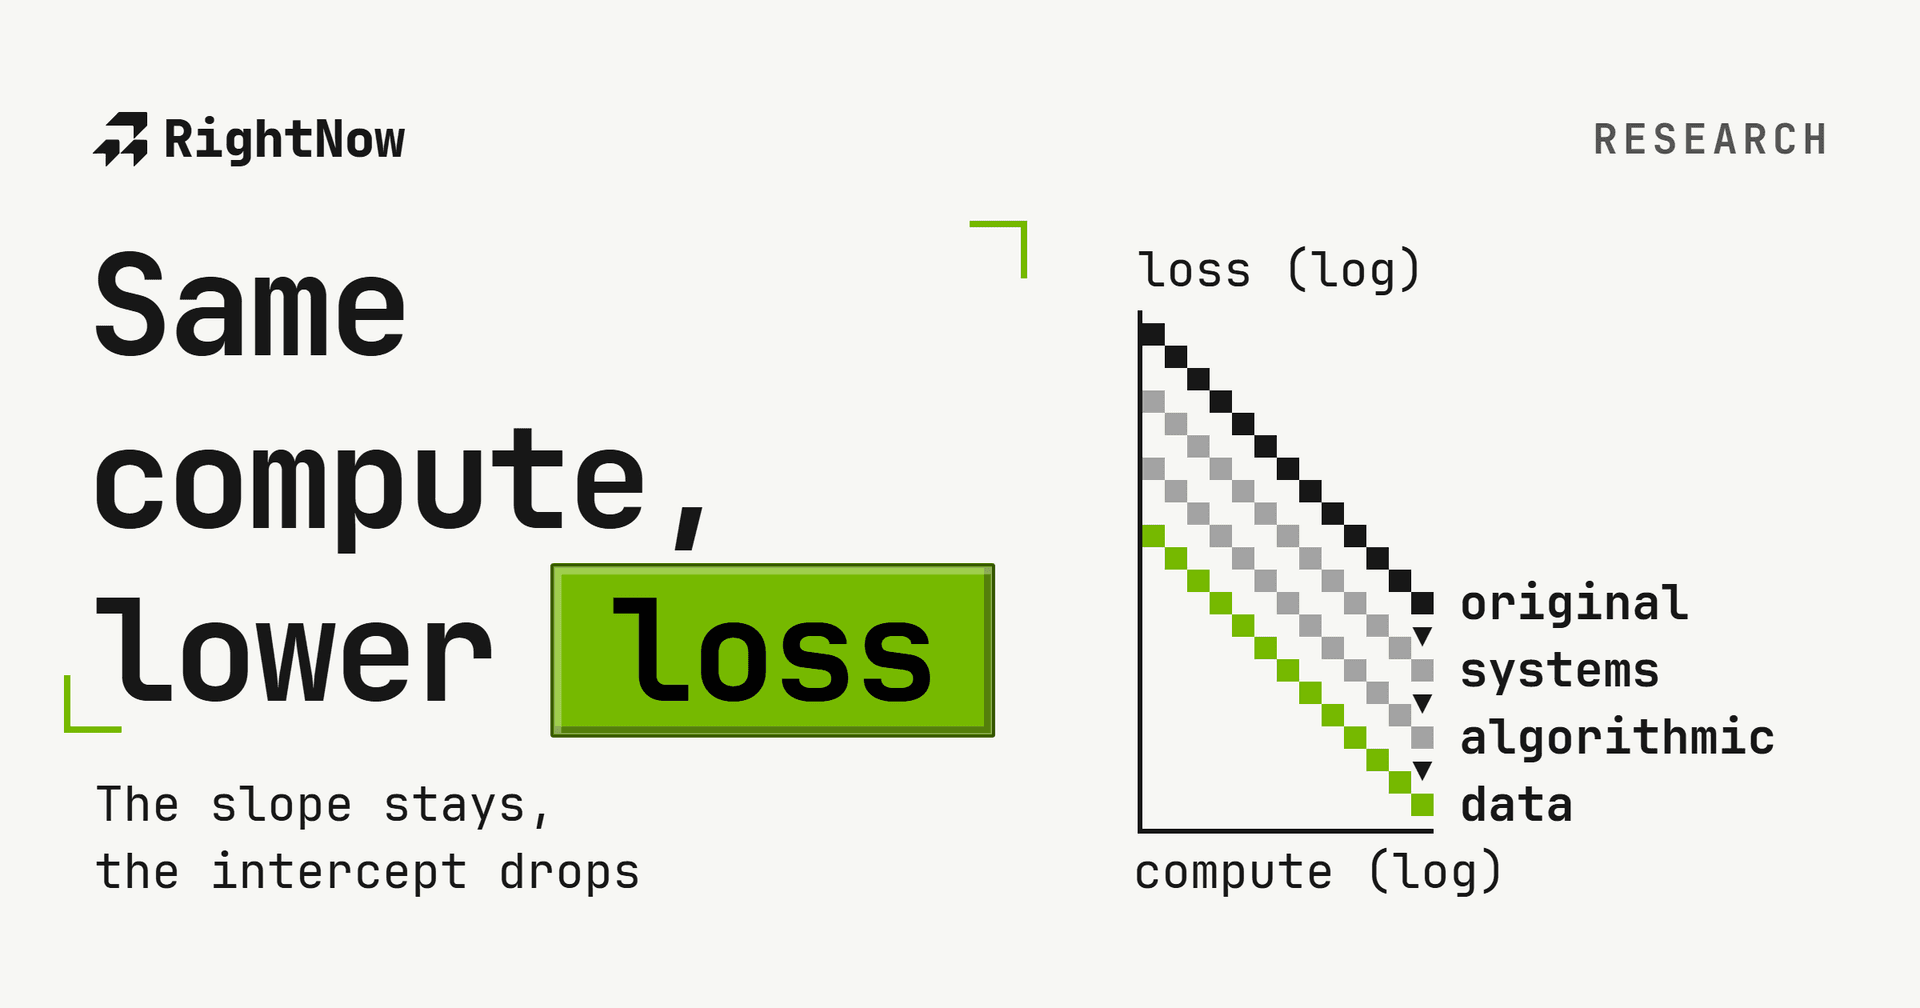
这些技术改变缩放定律中的常数:斜率不变,截距下降。
3) 挤压硬件:把买来的周期转化为有用进展的系统工程。 剖析真实运行,修复热点路径。用感知 IO 的内核(FlashAttention)替换 IO 密集的注意力,融合内核以消除多余拷贝,优化内存布局,调优流水线/张量/数据并行的组合。内存分片(ZeRO)降低单 GPU 内存压力和通信停顿。
这些修复把空闲或阻塞的周期变成真正降低损失的 FLOPs。
把这三组叠起来,同样的 FLOP 预算就得到更低损失:等于把整条线在对数-对数图上向下移。
缩放可视化
Loss (log)
  │
  │\
  │ \\
  │  \\\    original scaling (Kaplan-style power law)
  │   \\\
  │    \\\     ← after systems optim (FlashAttention, ZeRO)
  │     \\\
  │      \\\   ← after algorithmic optim (MoE, LoRA, quant)
  │       \\\  ← after data optim (dedupe, targeted synth)
  └──────────────────────────────────── Compute (log)
     C0     C1     C2     C3
解读: 斜率(缩放指数)保持不变。数据、算法和系统的介入降低截距:同样的计算量,更低的损失。
买来的计算量通常丢在哪里(先测量)
Typical waste breakdown (illustrative)
┌─────────────────────────────────────┐
│ Duplicates / low-value tokens : 30% │
│ Kernel inefficiencies         : 25% │
│ Communication / imbalance     : 20% │
│ Checkpoint / IO overhead      : 15% │
│ Suboptimal hyperconfig        : 10% │
└─────────────────────────────────────┘
找回这些损失的一部分,就能产出相当于一个大得多的集群的有效产出。
一周行动手册(实用:现在就运行)
第 1 天:剖析一次完整运行。 采集内核和通信 trace;按墙上时钟时间找出前三个热点。
第 2 天:数据清洗。 在有代表性的一切片上跑去重和质量打分。重训一个 epoch,比较验证损失。
第 3 天:低成本微调。 用针对失败模式的 LoRA/QLoRA 替代完整重训,测量每 GPU 小时的收益。
第 4 天:内核修复。 把一个关键算子换成感知 IO 的实现(如 FlashAttention),融合内核,或改变张量布局。测量墙上时钟变化。
第 5 天:分布式调优。 在合适之处应用分片/ZeRO;重新剖析,消除不均衡。
第 6 天:小规模条件计算探针。 在一个子集上原型化一个微型 MoE 或条件块,验证容量收益。
第 7 天:合成并迭代。 为剩余错误生成定向合成样本,适配并测量。
始终把改进换算成美元或实验数:省下的秒数 → 省下的 GPU 小时数 → 每月多出的实验数。
快速的科学依据
缩放定律:计算量、token 数与模型规模之间的经验幂律关系为规划提供斜率。(Kaplan et al., 2020)
计算最优权衡:Chinchilla 表明 token 重要;在计算最优点训练往往偏向以合适模型规模用更多 token。(Hoffmann et al., 2022)
系统收益:感知 IO 的注意力和融合内核在注意力密集的运行中大幅缩短墙上时钟时间(FlashAttention)。
算法效率:LoRA 和低秩适配器让微调便宜;MoE 与条件计算以更低的活跃 FLOPs 产出更大的有效模型。
内存分片:ZeRO 及相关分片技术让你跨节点扩展模型而没有线性内存爆炸。