
Otimização de kernels de GPU para desenvolvedores CUDA: AutoKernel
, 3 min de leitura, By Jaber Jaber
EngenhariaAutoKernel é a ferramenta de código aberto da RightNow AI para otimização de kernels de GPU. AutoKernel faz profiling de modelos PyTorch, testa variantes de Triton e segue gargalos medidos. Um agente de programação edita um kernel por vez, roda um benchmark fixo e mantém ou reverte cada mudança.
O que o AutoKernel faz?
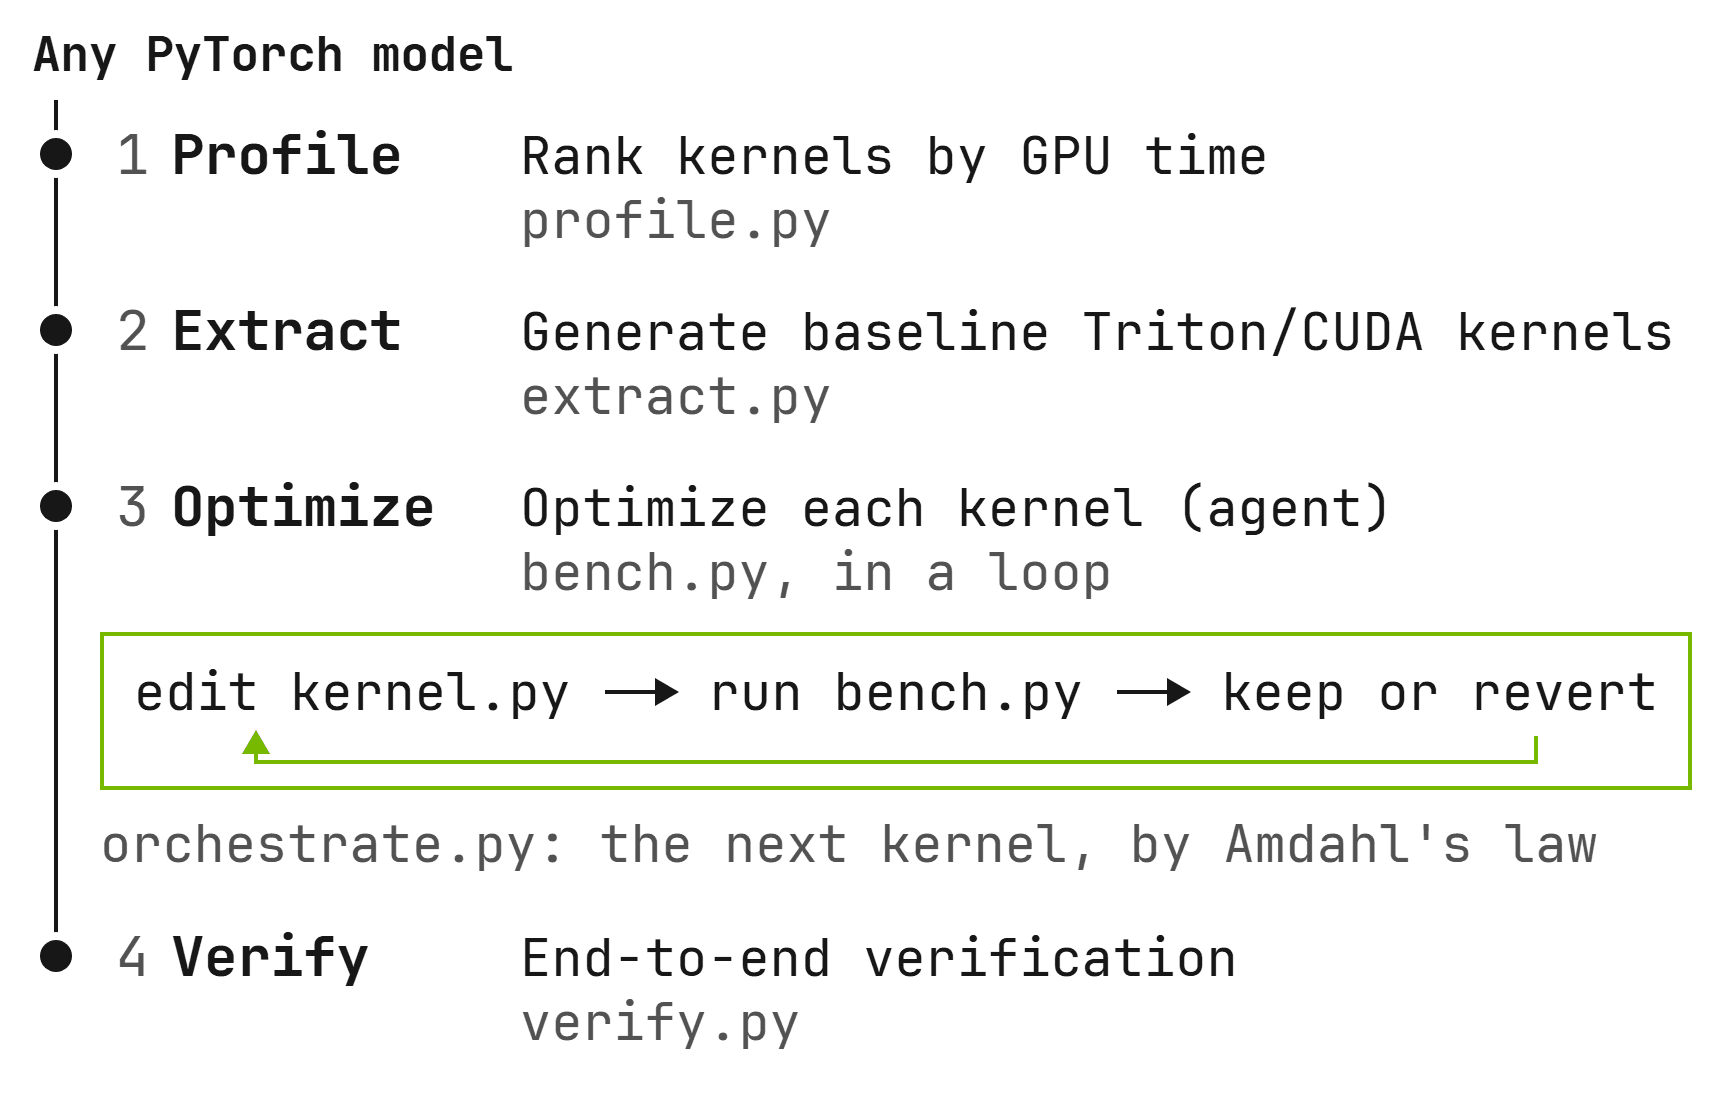
Dê ao AutoKernel qualquer modelo PyTorch. Ele faz profiling do modelo para encontrar quais kernels de GPU são gargalos. Ele extrai cada gargalo como um kernel autônomo de Triton ou CUDA. Ele otimiza cada kernel de forma autônoma: editar, medir, manter ou reverter, e repetir. Ele verifica a correção de ponta a ponta e informa a aceleração total.
Como o ciclo funciona?
O agente lê program.md, que contém instruções completas para a operação autônoma. Inclui um manual de otimização de 6 níveis, um arcabouço de decisões, tratamento de falhas e raciocínio com a lei de Amdahl.
O agente edita kernel.py um kernel por vez. Ele roda bench.py, um benchmark fixo com verificações de correção em 5 estágios e análise roofline, e mantém ou reverte a mudança.
O orquestrador decide quando passar ao próximo kernel usando a lei de Amdahl. Ele prioriza por impacto e segue em frente quando os retornos começam a diminuir. O agente só toca kernel.py, então o escopo continua administrável, os diffs revisáveis e as reversões limpas.
Cada experimento é registrado num arquivo results.tsv simples. Cada linha anota o kernel, seu throughput, sua latência e se passou: PASS, FAIL, TIMEOUT ou CRASH.
Como ele mantém um kernel correto?
O benchmark compara a saída do kernel com PyTorch antes de medir o desempenho. Um kernel rápido porém errado é revertido imediatamente. Os cinco estágios de correção são fumaça, varredura de formas, estabilidade numérica, determinismo e casos extremos.
Cada tipo de kernel tem uma referência PyTorch em reference.py. No fim, verify.py reinsere os kernels otimizados no modelo, verifica a correção de ponta a ponta e informa a aceleração total.
Como começar?
Clone o repositório e rode uv sync. Rode uv run prepare.py uma vez para preparar os dados de teste e as linhas de base. Faça profiling de um modelo com profile.py, extraia os principais kernels gargalo com extract.py, e confira que o benchmark funciona com bench.py.
Depois inicie um agente de programação no diretório e peça que leia program.md e comece pela configuração. O agente apresenta o plano de otimização, cria um branch e otimiza cada kernel gargalo em ordem de prioridade. program.md é escrito para que o agente rode 10 horas ou mais sem travar.
Precisa configurar o CUDA? Veja O guia completo para corrigir problemas de instalação do CUDA.
Onde está a pesquisa por trás?
RightNow AI é um laboratório de pesquisa em GPU apoiado pela YC. O paper é AutoKernel: Autonomous GPU Kernel Optimization via Iterative Agent-Driven Search, de Jaber Jaber e Osama Jaber, 2026. Está no arXiv como 2603.21331, e seu código é o repositório do AutoKernel.
O paper AutoMegaKernel do laboratório, A Statically-Checked Agent Harness for Self-Retargeting Megakernel Synthesis, está no arXiv como 2606.09682. Veja RightNow Research Lab para todos os papers e projetos de código aberto.
Respostas rápidas
O AutoKernel é código aberto?
Sim. A licença é MIT, e o código está em github.com/RightNow-AI/autokernel.
Quais modelos ele consegue analisar?
Qualquer modelo PyTorch: profile.py o analisa com torch.profiler, ordena os kernels por tempo de GPU e classifica cada um como limitado por computação ou por memória. Definições de modelos autônomas vêm incluídas, sem necessidade da biblioteca transformers.
Quais kernels ele cobre?
Seus kernels suportados incluem matmul, softmax, layernorm, rmsnorm, flash_attention, fused_mlp, cross_entropy, rotary_embedding e reduce.
Ele escreve Triton ou CUDA?
Ambos. Triton é para iteração rápida, e CUDA dá acesso direto aos tensor cores. Os dois backends compartilham a mesma interface kernel_fn().
De qual GPU ele precisa?
Uma GPU NVIDIA, com Python 3.10 ou posterior e uv.