
vLLM vs SGLang vs TensorRT-LLM: um benchmark de serving
, 8 min de leitura, By Jaber Jaber
EngenhariaPontos principais
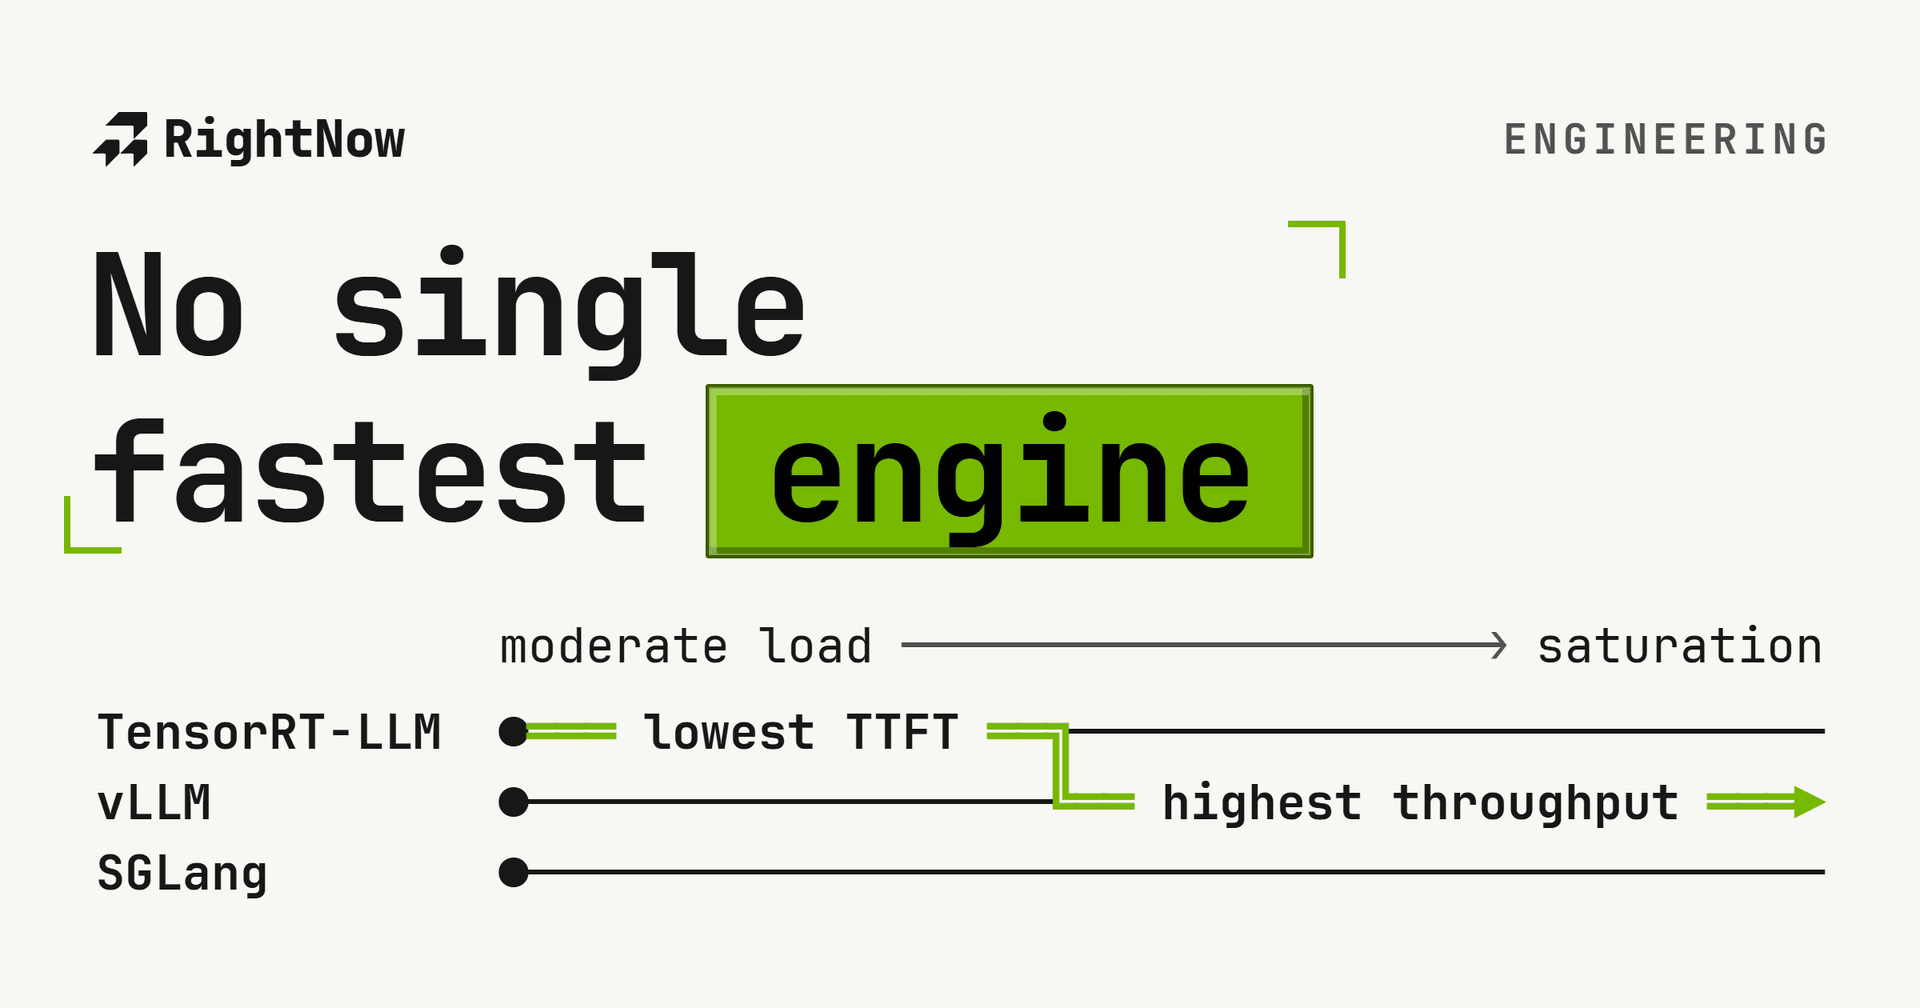
Não existe um único motor mais rápido. O vencedor muda com o ponto de operação.
O TensorRT-LLM teve a menor latência do primeiro token em carga moderada (235 ms contra 514 ms do vLLM em concorrência 32).
O vLLM alcançou o maior throughput em saturação (5,333 tok/s numa H100) e o menor custo.
O menor custo derivado de GPU publicado é o vLLM em fp8 na H100, $0.158 por 1 milhão de tokens de saída.
As linhas de custo bf16 publicadas colocam a L40S em cerca do dobro do custo por token de saída da H100.
Tudo abaixo está limitado ao que testamos: Llama-3.1-8B-Instruct, uma H100 80GB e uma L40S 48GB, bf16 e fp8. Não generalizamos além disso. Versões, em 20 de junho de 2026: vLLM 0.23.0, SGLang 0.5.13, TensorRT-LLM 1.2.1. Estes são resultados auto-reportados; o harness e os dados brutos não estão disponíveis publicamente. As linhas publicadas de throughput e latência com prompts únicos cobrem H100 bf16. FP8 e L40S aparecem apenas em resultados derivados de custo.
A versão curta
Não existe um único motor mais rápido. O vencedor muda conforme você o carrega.
| Se você se importa com | Use | Neste benchmark |
|---|---|---|
| Menor latência do primeiro token em carga moderada | TensorRT-LLM | 235 ms TTFT em c32 contra 514 ms do vLLM |
| Maior throughput em saturação | vLLM | 5,333 tok/s numa H100 |
| Menor custo por token | vLLM em fp8 | $0.158 por 1 milhão de tokens |
| Cache de prefixos compartilhados | uma grande vitória para ambos | throughput com 90% de acertos, cache ligado contra desligado: 3.13x para o vLLM (2,855 contra 910 tok/s), 2.84x para o SGLang (2,488 contra 875 tok/s) |
A regra para essas configurações: TensorRT-LLM para serving limitado por latência abaixo do seu teto de throughput, vLLM para o maior throughput e o menor custo. O vLLM estava à frente do SGLang em toda concorrência: por 1.8 a 9.0 por cento em throughput, e o tempo até o primeiro token do SGLang foi 6.2 a 26.2 por cento maior.
Duas coisas que deixamos explícitas
O TensorRT-LLM 1.2 removeu o backend TensorRT; PyTorch é o único backend de execução na versão 1.2.1 testada. Nosso teste de prefixo único não é o caso de muitos prefixos distintos para o qual o RadixAttention do SGLang é projetado, então também o rodamos separadamente. Estes resultados valem apenas para as configurações testadas.
Rodamos cada motor com os mesmos pesos, a mesma GPU e o mesmo fluxo de solicitações. O harness e os dados brutos não estão disponíveis publicamente, então estes resultados hoje não podem ser reproduzidos de forma independente a partir desta publicação. Nas linhas de custo bf16 publicadas, a L40S custa cerca do dobro por token de saída que a H100.
Por que rodamos isso
A Hugging Face colocou o TGI em modo de manutenção em dezembro de 2025 e arquivou o repositório em 21 de março de 2026, então muitos times estão reescolhendo um motor de serving agora. As comparações que se encontram são instantâneos pontuais na carga de outra pessoa. Então rodamos nós mesmos. Este artigo registra nossos resultados e suas condições divulgadas; ele não fornece um harness público de reprodução.
Como medimos
Um cliente dirige os três motores com fluxos idênticos de solicitações, então as definições de tempo são as mesmas em todo lugar. TTFT é o tempo até o primeiro token transmitido. Throughput é tokens de saída por segundo. Aquecemos, depois cronometramos três repetições por ponto de operação e grafamos a média. As repetições brutas e os intervalos de confiança não estão disponíveis publicamente. O cache de prefixos está desligado nas varreduras de prompts únicos, então ninguém ganha um acerto de cache grátis.
Throughput contra concorrência
Varremos a concorrência de 1 a 256 com 1,024 tokens de entrada e 256 de saída. No lote 1 os três motores ficam a menos de quatro por cento entre si. Conforme a carga sobe, o TensorRT-LLM é competitivo ou o melhor até concorrência 64, depois achata. O vLLM continua escalando e alcança o pico mais alto, 5,333 tok/s.
| concorrência | vLLM | SGLang | TensorRT-LLM |
|---|---|---|---|
| 1 | 158 | 153 | 152 |
| 8 | 1096 | 1005 | 1027 |
| 32 | 2921 | 2730 | 2978 |
| 64 | 4040 | 3898 | 4029 |
| 128 | 4943 | 4816 | 4774 |
| 256 | 5333 | 5235 | 4813 |
A fronteira de latência contra throughput
A tabela de throughput esconde o quadro mais útil. Plote a latência do primeiro token contra o throughput e a troca fica clara. O TensorRT-LLM mantém o menor TTFT em toda a faixa média e guarda essa vantagem até uns 4,000 tok/s, depois bate no teto e o TTFT dispara. O vLLM domina a ponta de throughput alto: alcança 5,333 tok/s com um TTFT menor do que os outros dois chegam perto dessa taxa.
| motor | tok/s de saída | TTFT p50 (ms) |
|---|---|---|
| vLLM | 158 | 35 |
| vLLM | 1096 | 177 |
| vLLM | 2921 | 514 |
| vLLM | 4040 | 790 |
| vLLM | 4943 | 1658 |
| vLLM | 5333 | 2221 |
| SGLang | 153 | 41 |
| SGLang | 1005 | 221 |
| SGLang | 2730 | 597 |
| SGLang | 3898 | 997 |
| SGLang | 4816 | 1761 |
| SGLang | 5235 | 2543 |
| TensorRT-LLM | 152 | 32 |
| TensorRT-LLM | 1027 | 56 |
| TensorRT-LLM | 2978 | 235 |
| TensorRT-LLM | 4029 | 504 |
| TensorRT-LLM | 4774 | 1691 |
| TensorRT-LLM | 4813 | 2848 |
Então a fronteira tem dois donos. TensorRT-LLM para serving sensível a latência abaixo do seu teto, vLLM para throughput máximo. Esse é todo o ponto: o motor certo é uma função do seu ponto de operação, não uma constante.
TensorRT-LLM: o backend na versão 1.2.1
Leia isto antes de pesar os números de throughput. Rodamos o TensorRT-LLM no backend PyTorch, que carrega um checkpoint da Hugging Face e o serve sem uma compilação prévia de motor. PyTorch é o único backend de execução a partir do TensorRT-LLM 1.2.
As notas da versão 1.2 do TensorRT-LLM da NVIDIA documentam a remoção do backend TensorRT e sua CLI de compilação. O resultado de 4,813 tok/s é o maior throughput que reportamos para o TensorRT-LLM 1.2.1 nesta varredura. Ele não estabelece um teto para outras cargas ou configurações. O TensorRT-LLM teve a menor latência do primeiro token dos três na faixa média; entre as configurações que rodamos, o vLLM alcançou o maior throughput.
Custo por token
Convertendo throughput em dólares com uma fórmula: o custo por 1 milhão de tokens é o preço por hora da GPU dividido pelos tokens sustentados por hora. A H100 custa $3.95 por hora e a L40S $1.95, alugadas, observado em 20 de junho de 2026.
| motor | bf16 / H100 | fp8 / H100 | bf16 / L40S |
|---|---|---|---|
| vLLM | 0.206 | 0.158 | 0.425 |
| SGLang | 0.21 | 0.17 | 0.438 |
| TensorRT-LLM | 0.228 | não medido | não medido |
Na H100, o custo derivado reportado do vLLM é $0.158 por 1 milhão de tokens de saída em fp8, contra $0.206 em bf16. Os resultados fp8 publicados não trazem linhas de throughput nem latência. Eles não estabelecem uma aceleração.
As linhas de custo bf16 publicadas do vLLM são $0.425 por 1 milhão de tokens de saída na L40S e $0.206 na H100. O custo da L40S é cerca de duas vezes maior nas tarifas e pontos de saturação registrados. Nenhuma linha de throughput ou latência da L40S é publicada, então estes resultados não sustentam uma comparação de velocidade.
Cargas com prefixos compartilhados
O tráfego de RAG e agentes reutiliza um prompt de sistema longo entre solicitações, então um cache de prefixos deve ajudar. Rodamos isso de dois jeitos, porque a forma da reutilização importa.
Um prefixo compartilhado
Primeiro o caso simples: um prefixo de 2,048 tokens enviado a uma fração das solicitações, com essa fração variando de 0 a 90 por cento, cache ligado e desligado. Com zero acertos, o cache ligado já supera o desligado: 999 contra 910 tok/s para o vLLM (9.7%) e 937 contra 879 para o SGLang (6.5%). Essa lacuna não é explicada pelos dados publicados e não é evidência de reuso de cache. Hardware e precisão desta varredura não são publicados. As razões do guia de decisão comparam cache ligado com desligado a 90% de acertos, para o mesmo motor.
| taxa de acerto do cache de prefixos (%) | vLLM (cache ligado) | vLLM (cache desligado) | SGLang (cache ligado) | SGLang (cache desligado) |
|---|---|---|---|---|
| 0 | 999 | 910 | 937 | 879 |
| 50 | 1559 | 912 | 1528 | 873 |
| 90 | 2855 | 910 | 2488 | 875 |
Com o cache ligado, o vLLM estava à frente do SGLang em toda taxa de acerto: por 6.6 por cento com zero acertos, 2.0 por cento a 50 e 14.7 por cento a 90. Não lemos um vencedor nessa lacuna. Um único prefixo compartilhado é o caso fácil que qualquer cache em nível de blocos maneja bem. Não é a carga para a qual o RadixAttention do SGLang é construído.
Muitos prefixos distintos, o caso RadixAttention
O RadixAttention é projetado para muitos prefixos distintos mantidos numa árvore ao mesmo tempo, a forma que se obtém de conversas ramificadas e um conjunto de prompts de sistema. Então rodamos isso: 256 solicitações espalhadas num número crescente de prefixos distintos de 2,048 tokens, 8 depois 32 depois 128 deles, ambos os motores com cache ligado.
| número de prefixos distintos | vLLM | SGLang |
|---|---|---|
| 8 | 2677 | 2493 |
| 32 | 2277 | 2086 |
| 128 | 1467 | 1376 |
O RadixAttention funcionou. Os logs do SGLang mostram os prefixos servidos direto do seu cache em árvore. Mas o cache de prefixos do vLLM seguiu à frente em throughput por 6.6 a 9.1 por cento em toda contagem de prefixos, com TTFT menor. Então em Llama-3.1-8B numa H100 não reproduzimos uma vitória de throughput do RadixAttention, nem mesmo na carga que ele visa. Ambos os motores guardam bem prefixos compartilhados; o vLLM foi 6.6 a 9.1 por cento mais rápido, em linha com sua vantagem geral neste hardware. O RadixAttention pode ganhar à frente com prefixos mais longos, árvores mais profundas ou pressão de despejo maior que a testada. No nosso teste não ganhou, e não vamos afirmar o contrário.
Disponibilidade da evidência
O harness, os CSVs brutos e os intervalos de confiança não estão disponíveis publicamente. As tabelas preservam nossas medições auto-reportadas e condições divulgadas, mas não são um pacote completo de reprodução. Atualizado em 20 de setembro de 2026: as alegações anteriores de código aberto e reprodução foram retiradas.
Atualizado em 2026-11-13: as frases que resumem as tabelas agora enunciam as cifras que as tabelas dão, e o hardware é descrito como alugado sem nomear o provedor. Nenhuma linha medida, custo derivado, data ou condição mudou.
Perguntas frequentes
vLLM ou SGLang? Em tráfego simples de prompts únicos o vLLM estava à frente em toda concorrência nos nossos testes: por 1.8 a 9.0 por cento em throughput, com o tempo até o primeiro token do SGLang 6.2 a 26.2 por cento maior. O custo derivado do vLLM também foi menor em cada configuração publicada. Use o vLLM como padrão; recorra ao SGLang quando o frontend programável dele couber na sua carga.
Vale a pena o TensorRT-LLM? Para serving sensível a latência abaixo do seu teto de throughput, sim. Ele manteve o menor tempo até o primeiro token em toda a faixa média, 235 ms em concorrência 32 contra os 514 ms do vLLM. Rodamos o backend PyTorch, o único backend de execução no TensorRT-LLM 1.2.1.
Qual GPU devo usar? Para o custo derivado de GPU reportado no Llama-3.1-8B, a H100 é menor nas linhas bf16 publicadas. Com o vLLM, as cifras são $0.206 por 1 milhão de tokens de saída na H100 e $0.425 na L40S. Nenhuma linha de throughput ou latência da L40S é publicada, então estes resultados não sustentam uma comparação de velocidade.
Notas de método e ressalvas
Uma H100 80GB e uma L40S 48GB, alugadas, GPU única, paralelismo de tensor 1.
Os mesmos pesos de Llama-3.1-8B-Instruct e o mesmo fluxo de solicitações entre motores. Três repetições cronometradas. As repetições brutas e os intervalos de confiança não estão disponíveis publicamente.
A latência aqui é TTFT e percentis por solicitação, não goodput com um SLO fixo. Se 514 ms no primeiro token com carga alta é aceitável depende do seu caso de uso; uma varredura de goodput com SLO é trabalho futuro.
Os números são auto-reportados no nosso harness e não são calibrados de forma cruzada contra uma suíte externa como MLPerf. O harness e os dados brutos não estão disponíveis publicamente, então esta publicação não permite reprodução independente.
O TensorRT-LLM 1.2.1 rodou o backend PyTorch, seu único backend de execução. As notas da versão 1.2 do TensorRT-LLM da NVIDIA documentam a remoção do backend TensorRT e da CLI de compilação.
A varredura da L40S parou na concorrência 128 (sua saturação), a da H100 na 256.
Motores mudam toda semana. Estes números são vLLM 0.23.0, SGLang 0.5.13, TensorRT-LLM 1.2.1, em 20 de junho de 2026.