
Inferência sem perdas
, 9 min de leitura, By Jaber Jaber
PesquisaNota editorial: Este artigo foi publicado primeiro no nosso site anterior. O produto de otimização descrito aqui está aposentado. A RightNow serve modelos abertos por sua API.
A quantização virou o jeito padrão de acelerar a inferência porque é o mais fácil. No vLLM é um flag ou um checkpoint trocado (docs.vllm.ai), enquanto fazer o verdadeiro trabalho de otimização, como escrever kernels melhores, leva meses. Então as pessoas trocam o checkpoint e seguem em frente, e as mesmas pessoas que jamais enviariam uma mudança de prompt sem revisão acabam entregando um modelo quantizado sem rodar uma única avaliação, porque o flag faz parecer um ajuste de infraestrutura quando na verdade é uma mudança de modelo
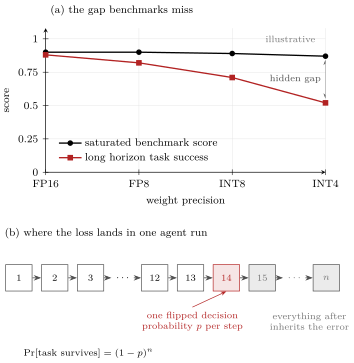
Quantização é uma troca, não uma otimização. Você economiza memória e paga em qualidade, e o custo é difícil de ver porque a quantização pós-treinamento move cada peso um pouco enquanto os benchmarks padrão mal reagem, já que estão saturados e testam um passo por vez. A perda real aparece em cadeias longas de raciocínio e execuções de programação agêntica onde centenas de decisões dependentes se empilham, então o benchmark diz que os dois modelos são iguais enquanto a taxa de sucesso do seu agente diz que não. Este artigo trata da pilha de serving que consegue a velocidade sem pagar esse custo
A matemática da composição
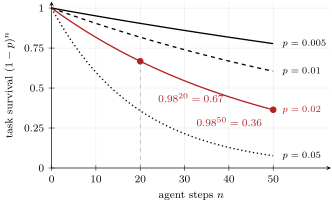
Se o ruído de quantização inverte uma decisão por passo com probabilidade p, então em n passos dependentes a tarefa sobrevive com probabilidade (1-p)^n. Dois por cento por passo parece de graça até você rodar 20 passos, porque 0.98^20 = 0.67 e um terço das suas tarefas agora falha, e a 50 passos você está em 0.36
Se você mantiver p em meio por cento, a sobrevivência em 20 passos fica em 0.90, e essa é a diferença entre um agente em quem você confia e um agente que você babá. O modelo nunca ficou visivelmente mais burro, só ficou 2 por cento mais ruidoso por decisão e a composição fez o resto
O que sem perdas significa
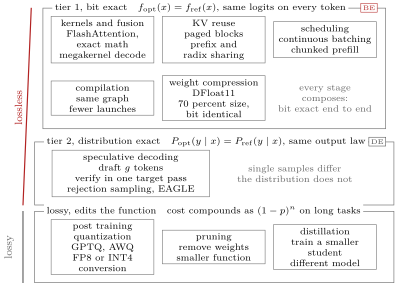
Inferência sem perdas significa que a pilha fica mais rápida enquanto o modelo continua exatamente o mesmo modelo, e eu a divido em dois níveis
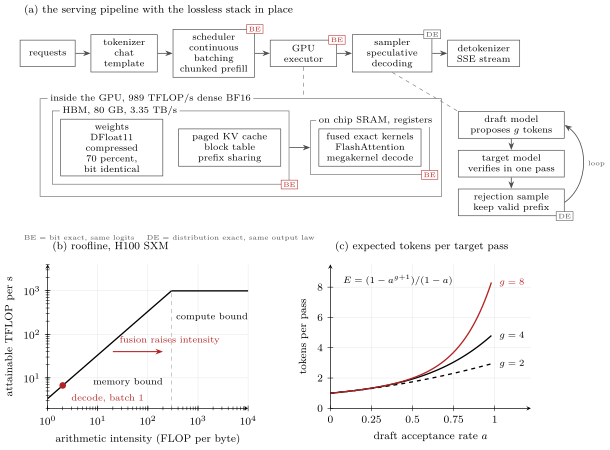
Bit exato significa que a pilha otimizada devolve os mesmos logits que a referência em cada entrada, f_opt(x) = f_ref(x). Kernels e fusão, compilação, reuso de KV, escalonamento e compressão de pesos sem perdas vivem neste nível porque mudam como a matemática roda sem mudar a matemática em si
Exato em distribuição significa que a pilha otimizada amostra da mesma distribuição que a referência, P_opt(y | x) = P_ref(y | x). Decodificação especulativa com amostragem de rejeição vive aqui, onde amostras individuais podem diferir mas a distribuição nunca
Todo o resto, PTQ, poda e destilação, muda a função em si, o que significa que você está servindo um modelo diferente com o mesmo nome. Essa definição importa porque move o ônus da prova, já que uma mudança sem perdas não precisa de avaliação quando as saídas são a evidência, enquanto uma mudança com perdas precisa de uma avaliação completa na sua carga e não só no MMLU. Bit exato também compõe, porque um pipeline de estágios bit exatos continua bit exato, então posso empilhar cinco deles sem rodar cinco ciclos de avaliação
A pilha sem perdas, de baixo para cima
A pilha começa com os kernels. Inferência em tamanhos de lote de serving é limitada por largura de banda de memória, já que uma H100 SXM move cerca de 3.35 TB/s da HBM enquanto faz cerca de 989 TFLOP/s densos em BF16 (nvidia.com/en-us/data-center/h100/), então um kernel ganha sua velocidade movendo menos bytes em vez de fazendo menos matemática. FlashAttention provou o ponto anos atrás ao computar atenção exata reordenando o tráfego de memória e obtendo grandes acelerações com saídas idênticas (arxiv.org/abs/2205.14135), e o reordenamento é válido porque a softmax online computa a mesma normalização a partir de estatísticas corridas, então nada do resultado muda
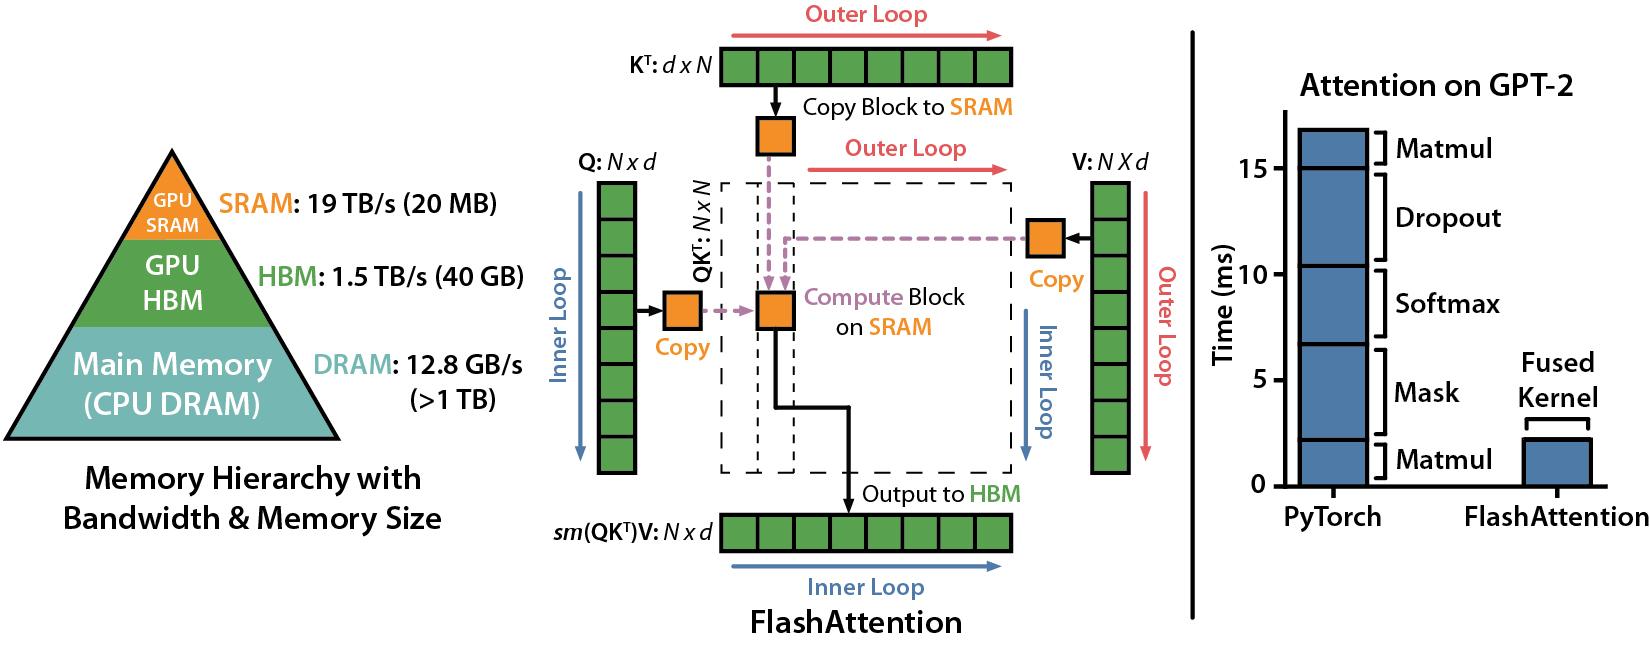
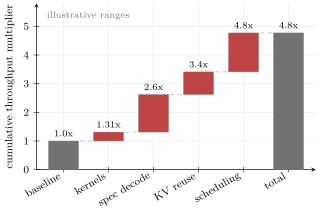
A fusão leva a mesma ideia além mantendo valores intermediários em registradores e memória compartilhada em vez de ir e voltar pela HBM, e um megakernel leva ao limite rodando o passo de decodificação inteiro como um único lançamento. Eu construí isso mesmo. Na mesma H100 meu motor bonsai-turbo roda a 1.76x o fork de llama.cpp do próprio fornecedor, indo de 85.5 a 151.1 tokens por segundo com as mesmas saídas (github.com/RightNow-AI/bonsai-turbo), e meu sistema de busca de kernels AutoKernel alcançou 1.31x sobre a cuBLAS nos seus melhores kernels ao longo de 95 experimentos entre 18 e 187 TFLOPS mantendo o primeiro lugar na tabela de vectorsum da B200 (github.com/RightNow-AI/autokernel)
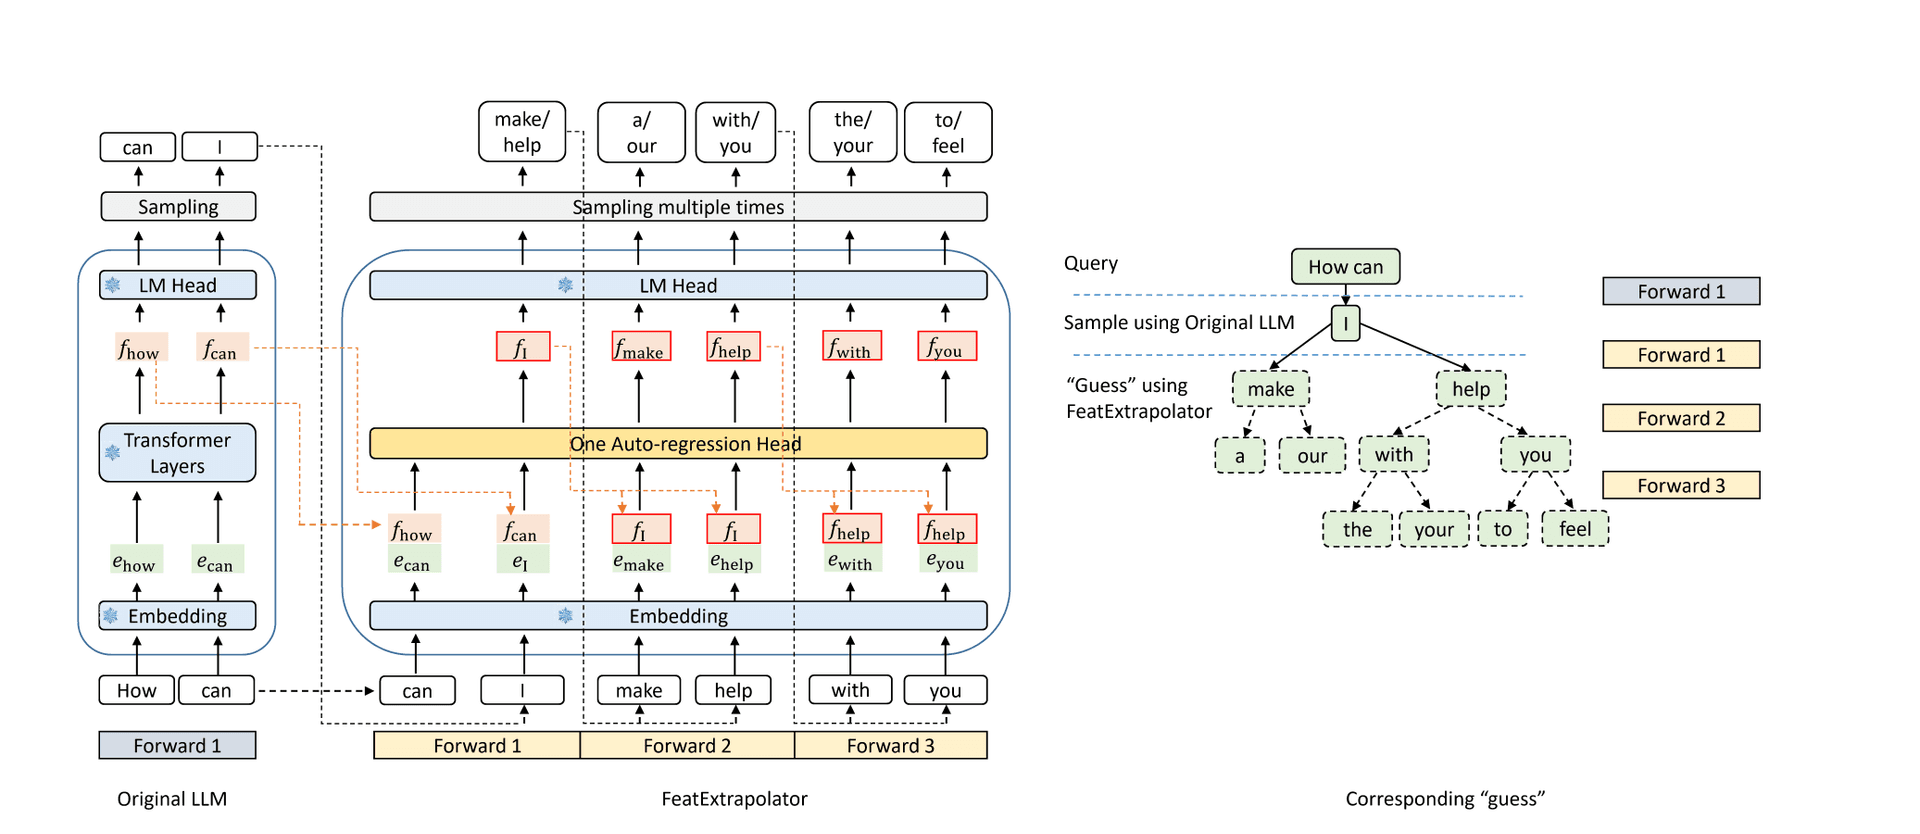
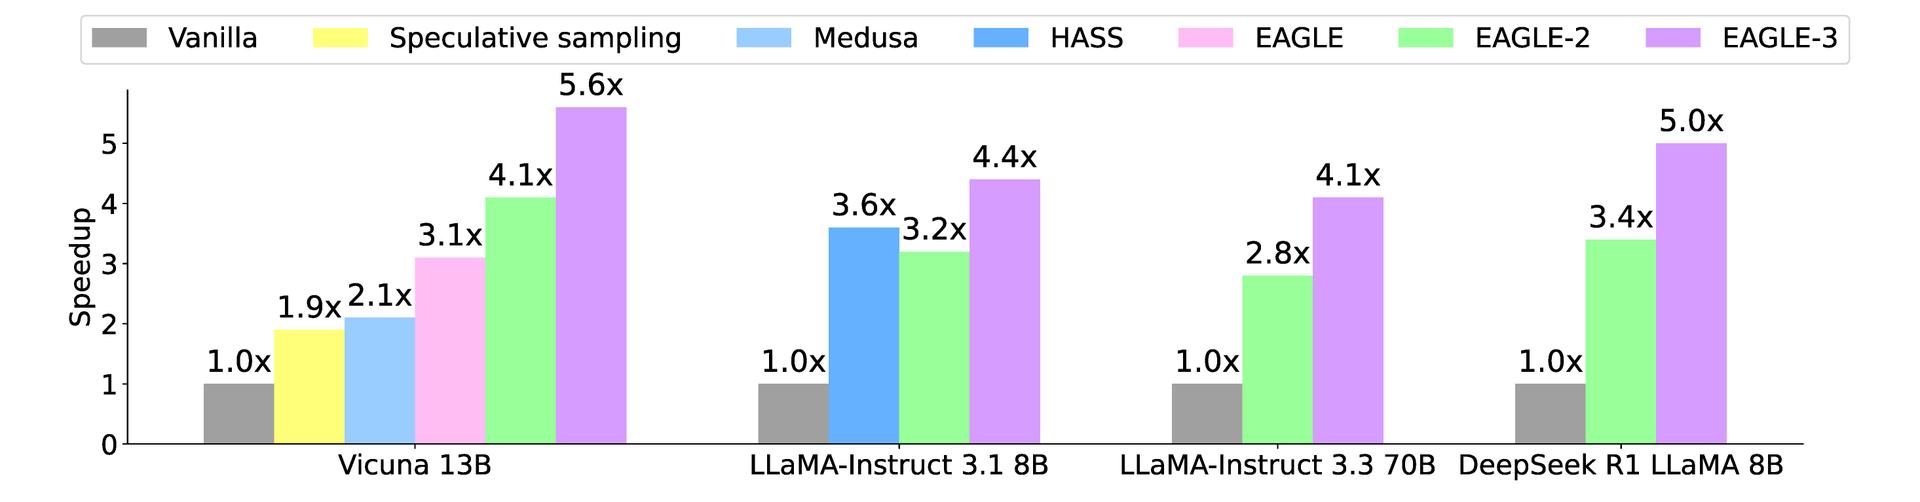
A decodificação especulativa vem depois. Um modelo rascunho pequeno propõe g tokens, o modelo alvo os verifica numa passada, e um passo de amostragem de rejeição modificado mantém a distribuição de saída exatamente a do alvo, o que foi provado de forma independente duas vezes em 2023 (arxiv.org/abs/2211.17192, arxiv.org/abs/2302.01318). O número esperado de tokens por passada do alvo é (1-a^(g+1))/(1-a) com taxa de aceitação a, então a precisão do rascunho é tudo, e a linha EAGLE é o que a elevou (arxiv.org/abs/2401.15077). EAGLE-2 diz sem rodeios ("a distribuição do texto gerado permanece inalterada") e reporta 3.05x a 4.26x (arxiv.org/abs/2406.16858), enquanto EAGLE-3 reporta até 6.5x (arxiv.org/abs/2503.01840)
Depois vem a compressão de pesos sem perdas. Pesos em BF16 carregam menos de 16 bits de informação real por parâmetro, então DFloat11 os codifica por entropia até cerca de 11 bits, o que aterrissa em cerca de 70 por cento do tamanho original com saídas que seguem idênticas bit a bit ao modelo original (arxiv.org/abs/2504.11651). Isso cobre a maior parte da economia de memória que a quantização promete sem a fatura de qualidade
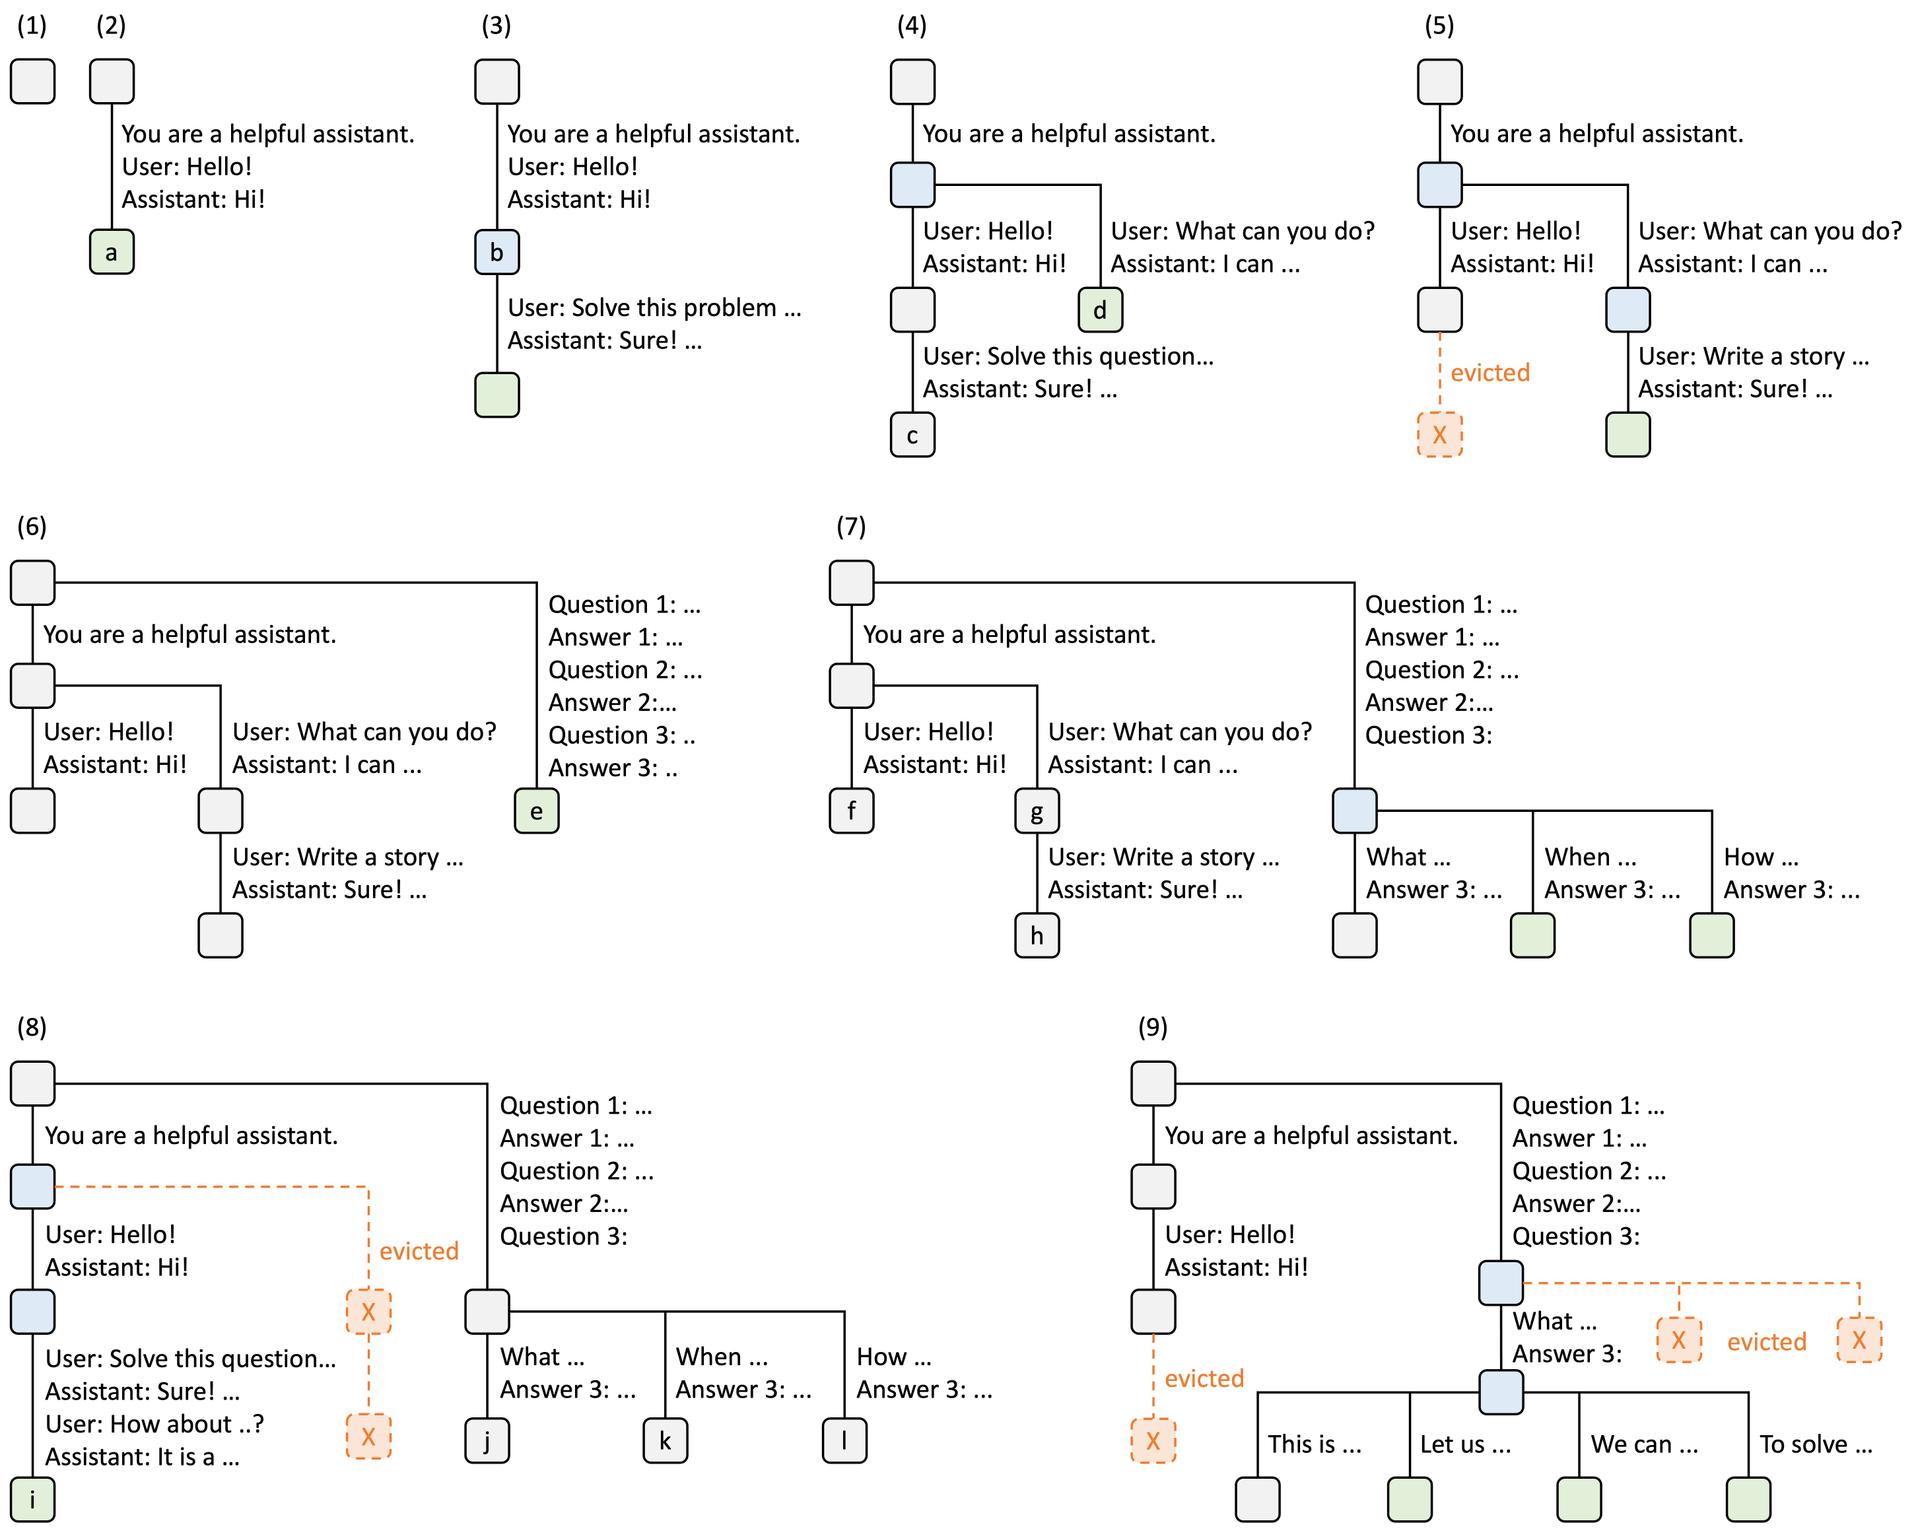
O reuso de KV é a próxima camada. A atenção paginada acabou com a fragmentação do cache KV e elevou os tamanhos reais de lote (arxiv.org/abs/2309.06180), e o cache de prefixos com árvores radix faz a história compartilhada ser computada uma única vez (arxiv.org/abs/2312.07104). Isso é seguro porque as entradas do cache são função pura do prefixo, então reutilizá-las nas mesmas posições não pode mover os logits
O escalonamento fica por cima. O batching contínuo reabastece o lote nas fronteiras de tokens em vez de esperar a solicitação mais longa terminar (usenix.org/conference/osdi22/presentation/yu), o prefill em pedaços impede que um prompt longo trave a decodificação de todos os outros (arxiv.org/abs/2308.16369), e a desagregação de prefill e decodificação coloca a metade limitada por computação e a metade limitada por largura de banda da carga em máquinas diferentes (arxiv.org/abs/2401.09670). Nenhuma dessas toca um único logit
A linha que se move
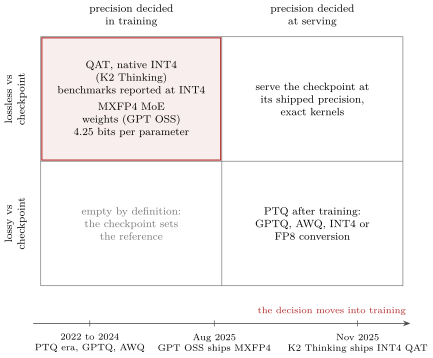
A fronteira do sem perdas é desenhada no checkpoint publicado, e o checkpoint em si está se movendo. Kimi K2 Thinking foi publicado com pesos INT4 nativos porque a Moonshot rodou treinamento consciente da quantização no pós-treinamento, pôs INT4 nos pesos do MoE e reportou todos os benchmarks oficiais em INT4 com geração cerca de 2 vezes mais rápida (huggingface.co/moonshotai/Kimi-K2-Thinking). A OpenAI publicou o gpt-oss com pesos MXFP4 no MoE a 4.25 bits por parâmetro, que cobre mais de 90 por cento dos parâmetros e é o motivo de o gpt-oss-120b caber numa GPU de 80 GB (arxiv.org/abs/2508.10925)
Para esses modelos servir INT4 ou MXFP4 não é quantização com perdas, é o checkpoint. A referência que você não deve degradar já é de baixa precisão, e o fornecedor já pagou o custo de qualidade durante o treinamento onde ele pertence, então a quantização está virando uma decisão de treinamento enquanto espremer um checkpoint BF16 depois dos fatos continua sendo um truque de serving. Meu teste é simples, se os pesos que você serve são os pesos que o fornecedor mediu então você está servindo o modelo, e se você os espremeu depois então está servindo a sua própria edição do modelo
Verificação
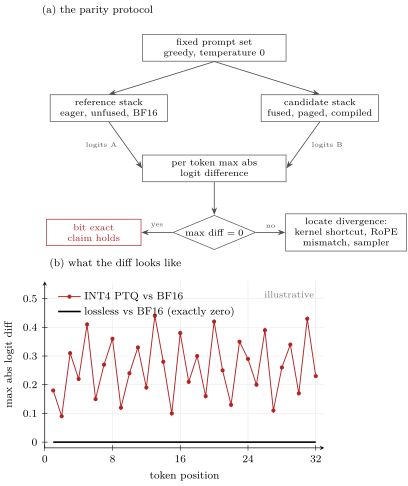
Sem perdas é uma afirmação que você pode testar, e eu a testo com paridade de logits. Você roda os mesmos prompts pela pilha de referência e pela sua com decodificação greedy, depois compara a máxima diferença absoluta de logits por token, onde zero é a barra de aprovação para uma afirmação bit exata e um teste de distribuição é a barra para a decodificação especulativa. Eu publiquei isso para o bonsai-turbo, onde 32 de 32 prompts passam contra o fork do fornecedor em todas as quatro configurações de motor (github.com/RightNow-AI/bonsai-turbo). Quando a paridade falha o diff me mostra onde olhar, e costuma ser um kernel fundido que cortou uma esquina, um RoPE fora de padrão ou um amostrador que renormaliza diferente
A Moonshot agora roda o mesmo tipo de verificação com quem serve o seu modelo. O K2 Vendor Verifier envia 4,000 solicitações idênticas a cada provedor terceiro de K2 e os pontua contra a API oficial em F1 de disparo de tool calls e precisão de esquema (github.com/MoonshotAI/K2-Vendor-Verifier), e a dispersão foi real, com precisão de esquema do 100 por cento nos melhores provedores até uns 73 a 76 por cento em motores de código aberto sem ajustes antes que as correções chegassem. A qualidade do modelo virou uma propriedade da pilha de serving e os fornecedores de modelos começaram a medi-la
A soma em ponto flutuante não é associativa, então a ordem de redução dentro de um kernel muda os bits baixos, e essa ordem muda com o tamanho do lote. A Thinking Machines mediu a consequência quando 1,000 compleções a temperatura zero no vLLM sem ajustes deram 80 saídas distintas, enquanto kernels invariantes a lote devolveram as 1,000 bitwise idênticas a 1.6x a 2x o tempo de execução (thinkingmachines.ai/blog/defeating-nondeterminism-in-llm-inference/), e Chen et al. delimitaram sua prova da decodificação especulativa "dentro da numérica do hardware" pela mesma razão (arxiv.org/abs/2302.01318). Então sem perdas significa que a pilha não adiciona erro além da numérica que você já aceitou, e não significa saídas bitwise idênticas entre tamanhos de lote a menos que você também pague por invariância de lote
Por que o sem perdas vence
A economia encerra a discussão. A quantização economiza um fator fixo uma vez e segue pagando qualidade em cada passo de cada tarefa, enquanto as vitórias sem perdas se multiplicam entre si, kernels por decodificação especulativa por reuso de KV por escalonamento, com cada termo mantendo o modelo exato. Um termo sozinho já mostra o que o sem perdas compra em hardware real:
Lembro de quando comecei a trabalhar nisso, achei que o sem perdas seria o futuro, e agora tenho mais certeza. Na RightNow eu construo exatamente isso, servindo modelos abertos na pilha sem perdas completa e verificando com paridade de logits contra a referência