
무손실 추론
, 9분 소요, By Jaber Jaber
연구편집자 주: 이 글은 처음 우리의 이전 사이트에 실렸습니다. 여기서 설명하는 최적화 제품은 은퇴했습니다. RightNow는 자신의 API로 오픈 모델을 서비스합니다.
양자화가 추론을 빠르게 하는 기본 방법이 된 것은 그것이 가장 쉽기 때문입니다. vLLM에서는 플래그 하나 또는 교체된 체크포인트 하나입니다(docs.vllm.ai). 더 나은 커널을 쓰는 것 같은 진짜 최적화 작업은 몇 달이 걸립니다. 그래서 사람들은 체크포인트를 갈아끼우고 지나갑니다. 검토되지 않은 프롬프트 변경은 절대 배포하지 않을 바로 그 사람들이, 평가 하나 돌리지 않고 양자화된 모델을 배포합니다. 그 플래그가 실제로는 모델 변경인데도 인프라 설정처럼 느끼게 만들기 때문입니다
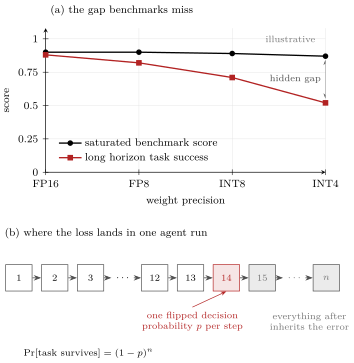
양자화는 최적화가 아니라 거래입니다. 메모리를 절약하고 품질로 대가를 치릅니다. 그 비용은 보기 어렵습니다. 학습 후 양자화는 모든 가중치를 조금씩 움직이지만 표준 벤치마크는 거의 반응하지 않습니다. 벤치마크들이 포화되었고 한 번에 한 단계만 시험하기 때문입니다. 진짜 손실은 수백 개의 의존적 결정이 서로 쌓이는 긴 추론 사슬과 에이전틱 코딩 실행에서 나타납니다. 그래서 벤치마크는 두 모델이 같다고 말하고, 당신의 에이전트 성공률은 같지 않다고 말합니다. 이 글은 그 비용을 지불하지 않고 속도를 얻는 서빙 스택에 관한 것입니다
복리 수학
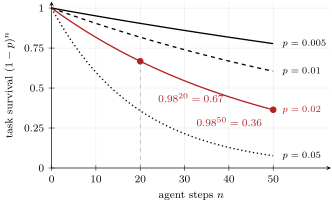
양자화 노이즈가 확률 p로 단계마다 결정 하나를 뒤집는다면, n개의 의존적 단계에서 작업은 확률 (1-p)^n으로 살아남습니다. 단계마다 2퍼센트의 타격은 공짜처럼 들립니다. 20단계를 실행하기 전까지는요. 0.98^20 = 0.67이고 작업의 삼분의 일이 실패하며, 50단계에서는 0.36까지 떨어집니다
p를 대신 반 퍼센트로 유지하면 20단계의 생존은 0.90에 머뭅니다. 이것이 신뢰하는 에이전트와 돌봐주는 에이전트의 차이입니다. 모델은 눈에 띄게 멍해지지 않았습니다. 결정마다 2퍼센트 더 시끄러워졌을 뿐이고 복리가 나머지를 했습니다
무손실이란 무엇을 뜻하는가
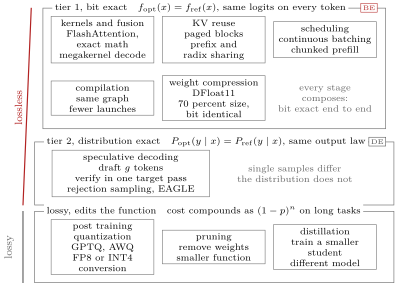
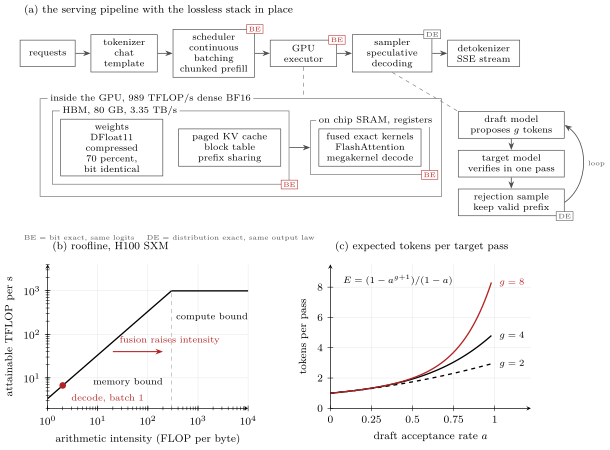
무손실 추론은 모델이 정확히 같은 모델로 머물면서 스택이 빨라지는 것을 뜻합니다. 나는 이것을 두 계층으로 나눕니다
비트 정확은 최적화된 스택이 모든 입력에서 기준과 같은 로짓을 반환함을 뜻합니다. f_opt(x) = f_ref(x). 커널과 융합, 컴파일, KV 재사용, 스케줄링, 무손실 가중치 압축이 모두 이 계층에 있습니다. 수학 자체를 바꾸지 않고 수학이 실행되는 방식만 바꾸기 때문입니다
분포 정확은 최적화된 스택이 기준과 같은 분포에서 샘플링함을 뜻합니다. P_opt(y | x) = P_ref(y | x). 거부 샘플링을 곁들인 추측 디코딩이 여기 있습니다. 개별 샘플은 달라도 분포는 절대 달라지지 않습니다
그 외의 모든 것, PTQ, 가지치기, 증류는 함수 자체를 바꿉니다. 같은 이름 아래 다른 모델을 서빙하고 있다는 뜻입니다. 이 정의는 증명의 부담을 옮기기 때문에 중요합니다. 무손실 변경은 출력이 곧 증거이므로 평가 실행이 필요 없고, 손실 있는 변경은 MMLU만이 아니라 당신의 워크로드에서 온전한 평가가 필요합니다. 비트 정확은 또한 합성됩니다. 비트 정확 단계들의 파이프라인은 여전히 비트 정확이므로, 나는 평가 주기 여섯을 돌리지 않고도 그것들을 다섯 개 쌓을 수 있습니다
무손실 스택, 아래부터
스택은 커널에서 시작합니다. 서빙 배치 크기의 추론은 메모리 대역폭 바운드입니다. H100 SXM이 약 989 밀도 BF16 TFLOP/s를 하는 동안 HBM에서 약 3.35 TB/s를 옮깁니다(nvidia.com/en-us/data-center/h100/). 그러므로 커널은 수학을 덜 하여서가 아니라 바이트를 덜 옮겨 속도를 얻습니다. FlashAttention은 몇 해 전에 그 요점을 증명했습니다. 재배열된 메모리 트래픽으로 정확한 어텐션을 계산하여 같은 출력으로 큰 가속을 얻었습니다(arxiv.org/abs/2205.14135). 재배열이 타당한 것은 온라인 소프트맥스가 실행 통계에서 같은 정규화를 계산하기 때문이고, 결과의 어떤 것도 바뀌지 않습니다
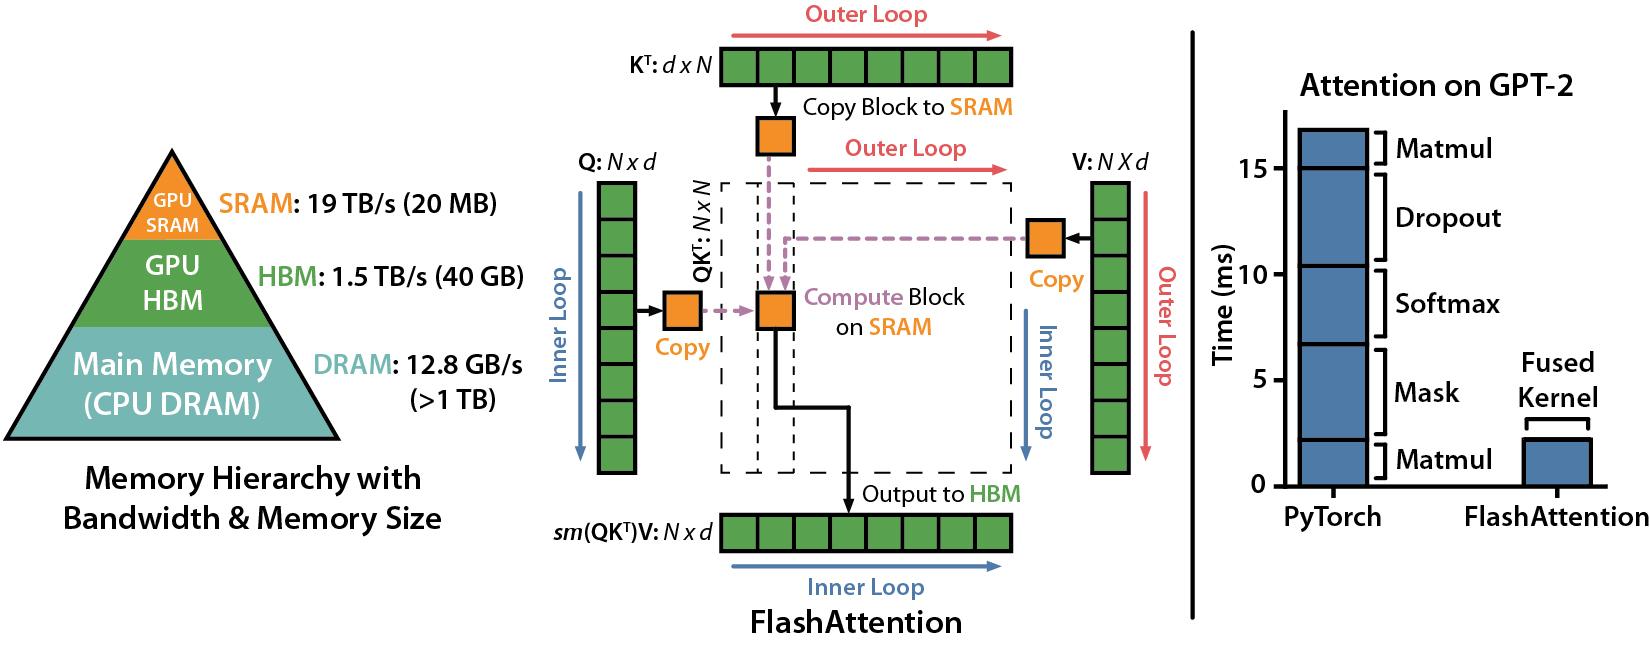
융합은 같은 생각을 더 밀어붙여 중간값을 HBM을 왕복하는 대신 레지스터와 공유 메모리에 유지하고, 메가커널은 그것을 끝까지 몰아 전체 디코드 단계를 하나의 실행으로 돌립니다. 나는 이것을 직접 만들었습니다. 같은 H100에서 내 엔진 bonsai-turbo는 벤더 자신의 llama.cpp 포크의 1.76배를 실행합니다. 85.5에서 초당 151.1 토큰으로, 같은 출력과 함께(github.com/RightNow-AI/bonsai-turbo). 그리고 내 커널 탐색 시스템 AutoKernel은 B200 vectorsum 리더보드 1위를 지키며 가장 좋은 커널에서 18에서 187 TFLOPS에 걸친 95개 실험에서 cuBLAS 대비 1.31배에 도달했습니다(github.com/RightNow-AI/autokernel)
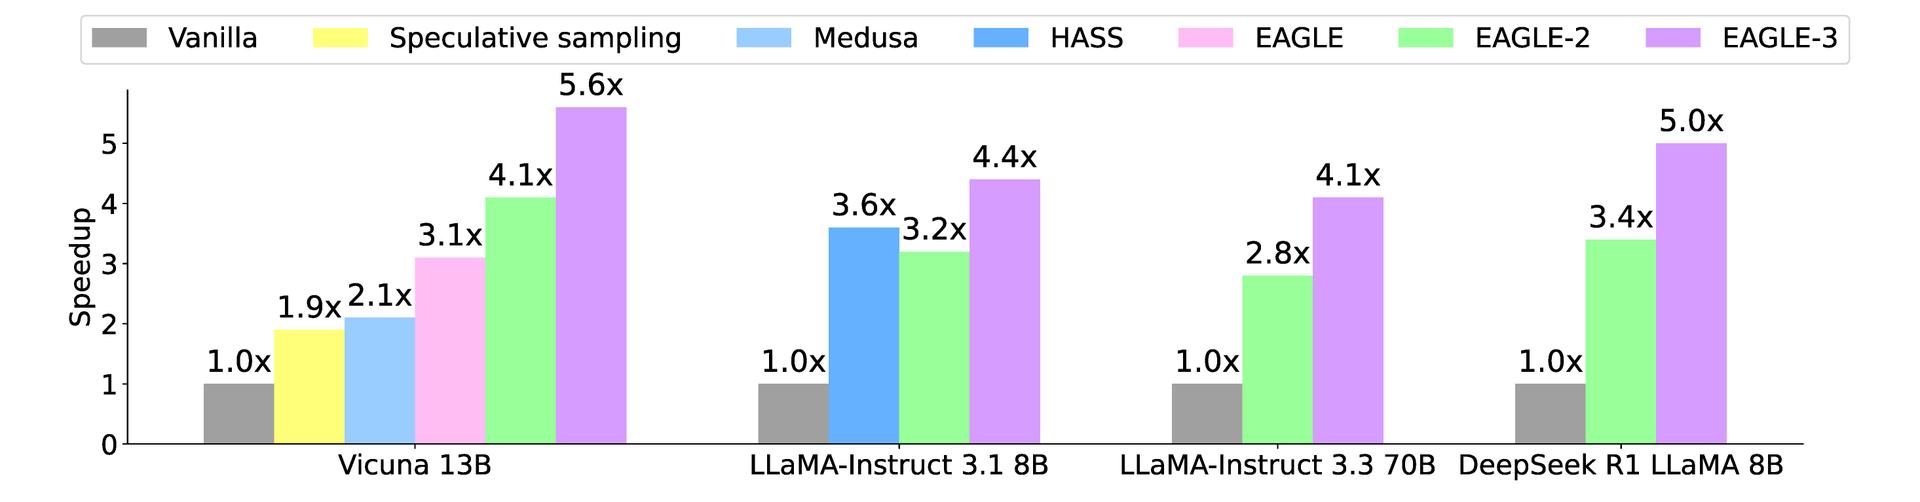
다음은 추측 디코딩입니다. 작은 초안 모델이 g개의 토큰을 제안하고, 대상 모델이 한 번에 검증하고, 수정된 거부 샘플링 단계가 출력 분포를 정확히 대상의 것으로 유지합니다. 이것은 2023년에 두 번 독립적으로 증명되었습니다(arxiv.org/abs/2211.17192, arxiv.org/abs/2302.01318). 대상 통과당 예상 토큰 수는 수용률 a에서 (1-a^(g+1))/(1-a)이므로 초안 정확도가 전부이고, EAGLE 계열이 그것을 끌어올렸습니다(arxiv.org/abs/2401.15077). EAGLE-2는 분명히 말합니다("the distribution of the generated text remains unchanged") 3.05배에서 4.26배를 보고하고(arxiv.org/abs/2406.16858), EAGLE-3는 최대 6.5배를 보고합니다(arxiv.org/abs/2503.01840)
그다음은 무손실 가중치 압축입니다. BF16 가중치는 파라미터당 16비트 미만의 실제 정보를 담으므로, DFloat11이 그것들을 약 11비트로 엔트로피 부호화합니다. 원본 모델과 비트별로 같은 출력을 유지하며 원래 크기의 약 70퍼센트에 도달합니다(arxiv.org/abs/2504.11651). 양자화가 약속하는 메모리 절약의 대부분을 품질 청구서 없이 덮습니다
KV 재사용이 다음 계층입니다. 페이징 어텐션은 KV 캐시 단편화를 끝내고 실제 배치 크기를 올렸습니다(arxiv.org/abs/2309.06180). 라딕스 트리의 접두사 캐싱은 공유된 이력이 한 번만 계산되게 합니다(arxiv.org/abs/2312.07104). 캐시 항목이 접두사의 순수 함수이므로 같은 위치에서 재사용하면 로짓이 움직일 수 없어 안전합니다
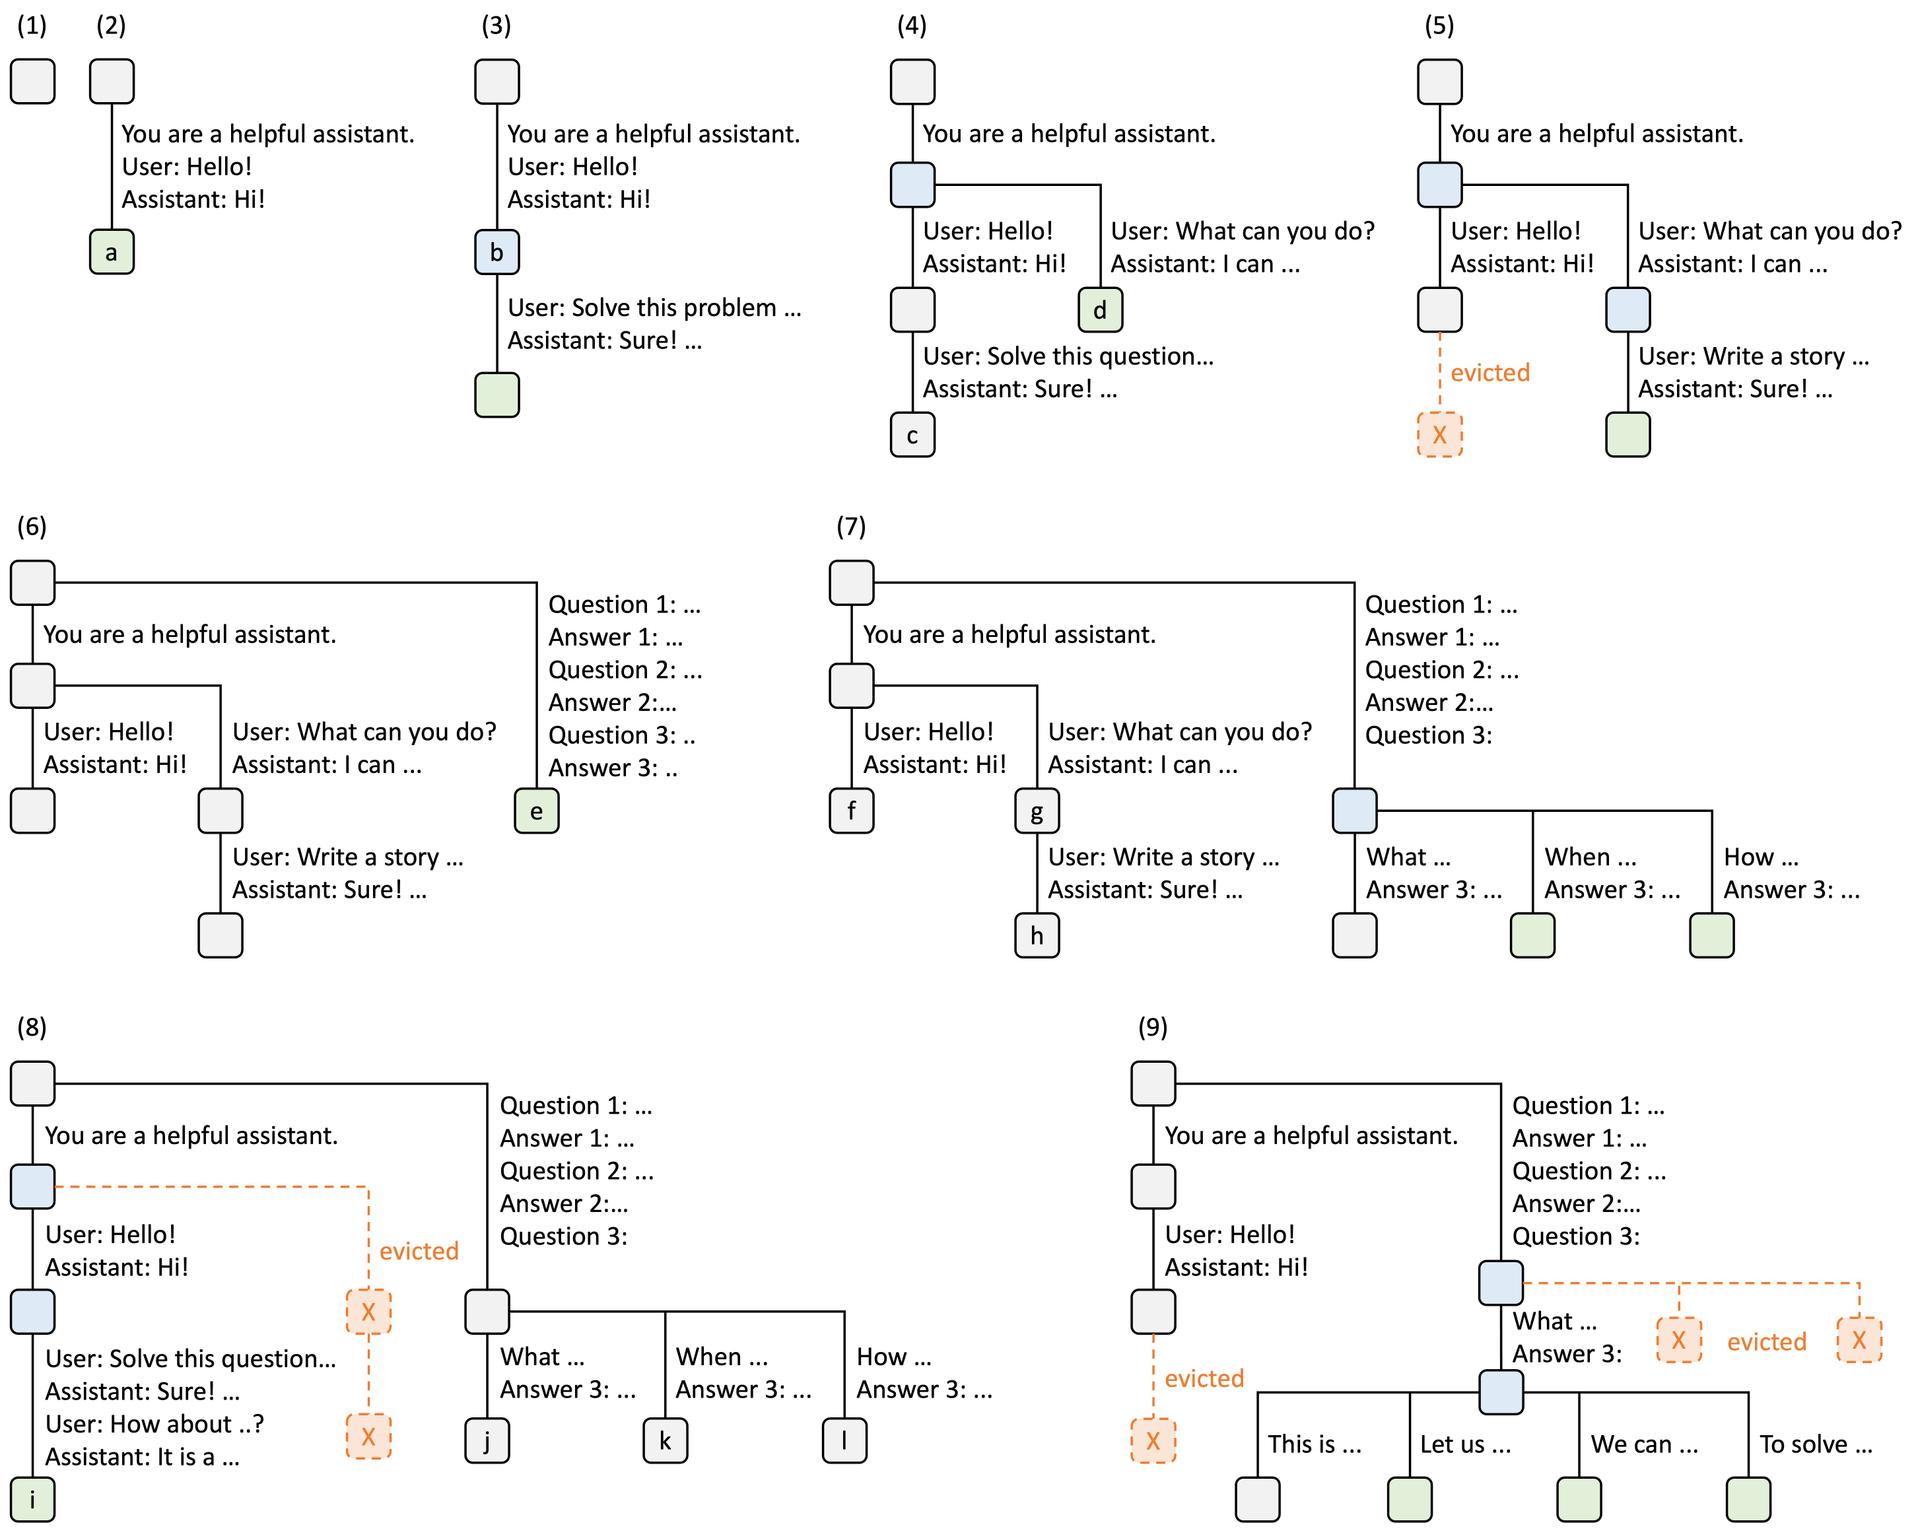
스케줄링이 그 위에 앉습니다. 연속 배치는 가장 긴 요청이 끝나기를 기다리는 대신 토큰 경계에서 배치를 채웁니다(usenix.org/conference/osdi22/presentation/yu). 청크 프리필은 긴 프롬프트가 다른 모두의 디코드를 막는 것을 막습니다(arxiv.org/abs/2308.16369). 프리필 디코드 분리는 워크로드의 컴퓨트 바운드 절반과 대역폭 바운드 절반을 다른 기계에 놓습니다(arxiv.org/abs/2401.09670). 이 어느 것도 로짓 하나 건드리지 않습니다
움직이는 선
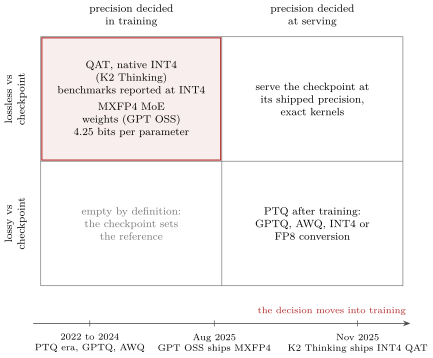
무손실 경계는 배포된 체크포인트에서 그어지고, 그 체크포인트 자체가 움직입니다. Kimi K2 Thinking은 네이티브 INT4 가중치로 배포되었습니다. Moonshot이 학습 후에 양자화 인지 학습을 실행하고 MoE 가중치에 INT4를 얹고 모든 공식 벤치마크를 INT4로 보고했으며 약 2배 더 빠른 생성을 얻었기 때문입니다(huggingface.co/moonshotai/Kimi-K2-Thinking). OpenAI는 gpt-oss를 파라미터당 4.25비트의 MXFP4 MoE 가중치로 배포했습니다. 파라미터의 90퍼센트 이상을 덮으며 gpt-oss-120b가 80 GB GPU 하나에 들어가는 이유입니다(arxiv.org/abs/2508.10925)
이 모델들에게 INT4나 MXFP4 서빙은 손실 있는 양자화가 아니라 체크포인트 그 자체입니다. 열등하게 만들어서는 안 되는 기준이 이미 낮은 정밀도이고, 벤더는 이미 품질 비용을 그 비용이 속할 학습 동안에 치렀습니다. 그래서 양자화는 학습 결정으로 변해가고, 그 사실 이후의 BF16 체크포인트를 짜내는 것은 서빙 핵으로 남습니다. 나의 시험은 간단합니다. 당신이 서빙하는 가중치가 벤더가 벤치마크한 가중치라면 당신은 그 모델을 서빙하는 것이고, 그 뒤에 짜냈다면 당신은 그 모델의 자신의 편집본을 서빙하는 것입니다
검증
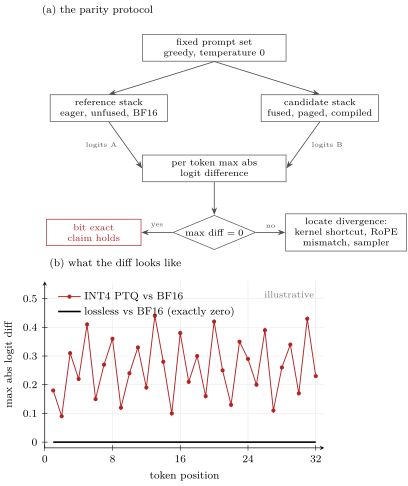
무손실은 시험할 수 있는 주장이고, 나는 로짓 패리티로 시험합니다. 같은 프롬프트를 기준 스택과 당신의 스택에 탐욕 디코딩으로 통과시키고, 토큰마다 최대 절대 로짓 차이를 비교합니다. 영이 비트 정확 주장의 통과 기준이고, 분포 시험이 추측 디코딩의 기준입니다. 나는 이것을 bonsai-turbo에 대해 공개했습니다. 32개 프롬프트 중 32개가 네 엔진 구성 모두에서 벤더 포크를 통과합니다(github.com/RightNow-AI/bonsai-turbo). 패리티가 실패하면 그 차이가 어디를 봐야 하는지 보여주고, 보통 모서리를 자른 융합 커널, RoPE 불일치, 다르게 재정규화하는 샘플러입니다
Moonshot은 이제 자신의 모델을 서빙하는 모두에게 같은 종류의 검사를 돌립니다. K2 Vendor Verifier는 4,000개의 같은 요청을 모든 제3자 K2 제공자에게 보내고 도구 호출 트리거 F1과 스키마 정확도로 공식 API에 대해 점수를 매깁니다(github.com/MoonshotAI/K2-Vendor-Verifier). 격차는 실재했습니다. 스키마 정확도는 가장 좋은 제공자에서 100퍼센트부터 수정이 반영되기 전 스톡 오픈소스 엔진들에서 약 73~76퍼센트까지 달렸습니다. 모델 품질은 서빙 스택의 속성이 되었고 모델 벤더들이 그것을 측정하기 시작했습니다
부동소수점 덧셈은 결합적이지 않으므로 커널 안의 축소 순서가 낮은 비트들을 바꾸고, 그 순서는 배치 크기에 따라 바뀝니다. Thinking Machines은 그 결과를 측정했습니다. 스톡 vLLM의 온도 영 1,000개 완성이 80개의 서로 다른 출력을 낸 반면, 배치 불변 커널은 1.6배에서 2배의 실행 시간으로 1,000개 모두를 비트 단위로 같게 되돌렸습니다(thinkingmachines.ai/blog/defeating-nondeterminism-in-llm-inference/). Chen et al.도 같은 이유로 추측 디코딩 증명의 범위를 "within hardware numerics"로 한정했습니다(arxiv.org/abs/2302.01318). 그러므로 무손실은 스택이 이미 받아들인 수치 이상의 오류를 더하지 않음을 뜻하고, 배치 불변성까지 지불하지 않는 한 배치 크기들을 걸쳐 비트 단위로 같은 출력을 뜻하지 않습니다
무손실이 이기는 이유
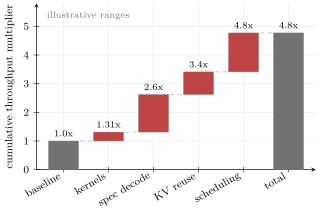
경제학이 논쟁을 끝냅니다. 양자화는 고정된 배수를 한 번 절약하고 모든 작업의 모든 단계에서 품질을 계속 지불하는 반면, 무손실의 이득은 서로 곱해집니다. 커널 곱 추측 디코딩 곱 KV 재사용 곱 스케줄링, 모든 항이 모델을 정확하게 유지합니다. 항 하나만으로도 무손실이 실제 하드웨어에서 무엇을 사는지 보여줍니다:
내가 이 일을 시작할 때가 기억납니다. 무손실이 미래가 되리라 생각했고, 지금은 그것이 더 확실합니다. RightNow에서 나는 정확히 이것을 만듭니다. 오픈 모델을 온전한 무손실 스택 위에 서빙하고, 기준에 대한 로짓 패리티로 그것을 검증합니다