
无损推理
, 阅读时间 9 分钟, By Jaber Jaber
研究编者按: 本文首发于我们更早的网站。这里描述的优化产品已退役。RightNow 通过其 API 提供开放模型。
量化成了加速推理的默认方式,因为它是其中最容易的。在 vLLM 里它是一个标志或一次检查点替换(docs.vllm.ai),而真正的优化工作,比如写出更好的内核,要花几个月。于是人们换掉检查点就继续前进,那些绝不会上线一个未经审查的提示改动的人,却在不跑任何评测的情况下上线了一个量化模型,因为这个标志让它感觉像一项基础设施设置,而它实际上是一次模型改动
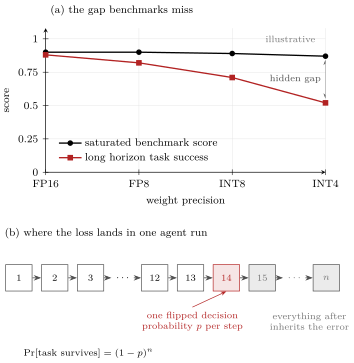
量化是一笔交易,不是优化。你省下内存,用质量来付账,而这代价难以察觉,因为训练后量化把每个权重都移动一点点,而标准基准几乎没反应,因为它们已经饱和,而且一次只测一步。真正的损失出现在长推理链和代理编程运行中,那里有数百个相互叠加的依赖决策,于是基准告诉你两个模型相同,而你的代理成功率告诉你它们不同。本文讲的是不付这笔代价就拿到速度的服务技术栈
复利的数学
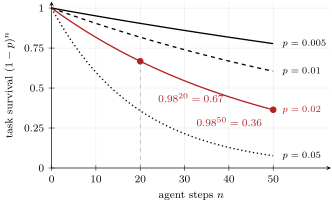
如果量化噪声以概率 p 每步翻转一个决策,那么在 n 个依赖步骤上任务以概率 (1-p)^n 存活。每步 2 个百分点的损失听起来免费,直到你跑 20 步,因为 0.98^20 = 0.67,你的任务有三分之一现在失败,跑到 50 步就只剩 0.36
如果你把 p 控制在半个百分点,20 步的存活率保持在 0.90,这是一个你信任的代理和一个你要盯着的代理之间的差别。模型从未明显变笨,它只是每个决策多了 2 个百分点的噪声,复利完成了其余的一切
无损是什么意思
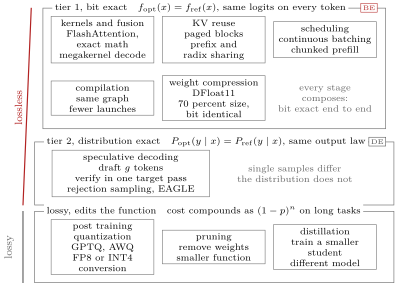
无损推理指技术栈变快而模型保持完全相同的模型,我把它分成两层
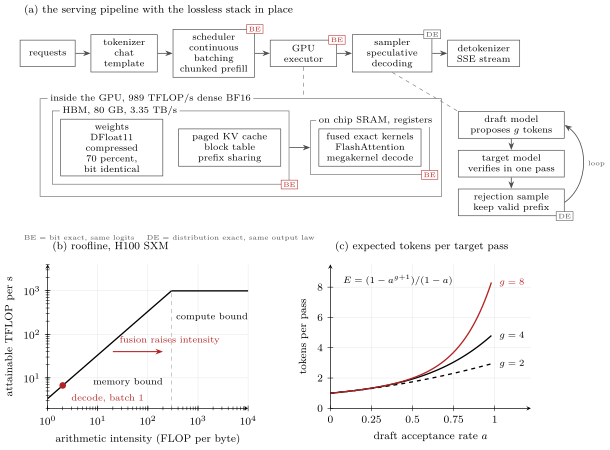
位精确指优化后的栈在每个输入上返回与参考相同的 logits,f_opt(x) = f_ref(x)。内核与融合、编译、KV 复用、调度和无损权重压缩都在这一层,因为它们改变数学如何运行,而不改变数学本身
分布精确指优化后的栈从与参考相同的分布采样,P_opt(y | x) = P_ref(y | x)。带拒绝采样的投机解码属于这里,单个样本可以不同,但分布永远不变
其余一切,PTQ、剪枝和蒸馏,都改变函数本身,这意味着你在用同一个名字服务一个不同的模型。这个定义很重要,因为它移动了举证责任:无损改动不需要跑评测,因为输出本身就是证据,而有损改动需要在你的工作负载上跑完整评测,而不只是在 MMLU 上。位精确还可组合,因为位精确阶段的流水线仍是位精确的,所以我可以叠五个而不跑五轮评测
无损栈,自底向上
栈从内核开始。服务批大小下的推理受内存带宽限制,因为 H100 SXM 从 HBM 每秒移动约 3.35 TB,同时做约 989 稠密 BF16 TFLOP/s(nvidia.com/en-us/data-center/h100/),所以内核靠移动更少的字节赢得速度,而不是靠少做数学。FlashAttention 几年前证明了这一点,它用重排的内存访问计算精确注意力,输出相同而大幅提速(arxiv.org/abs/2205.14135),重排之所以有效,是因为在线 softmax 从运行统计算出相同的归一化,结果的任何方面都不变
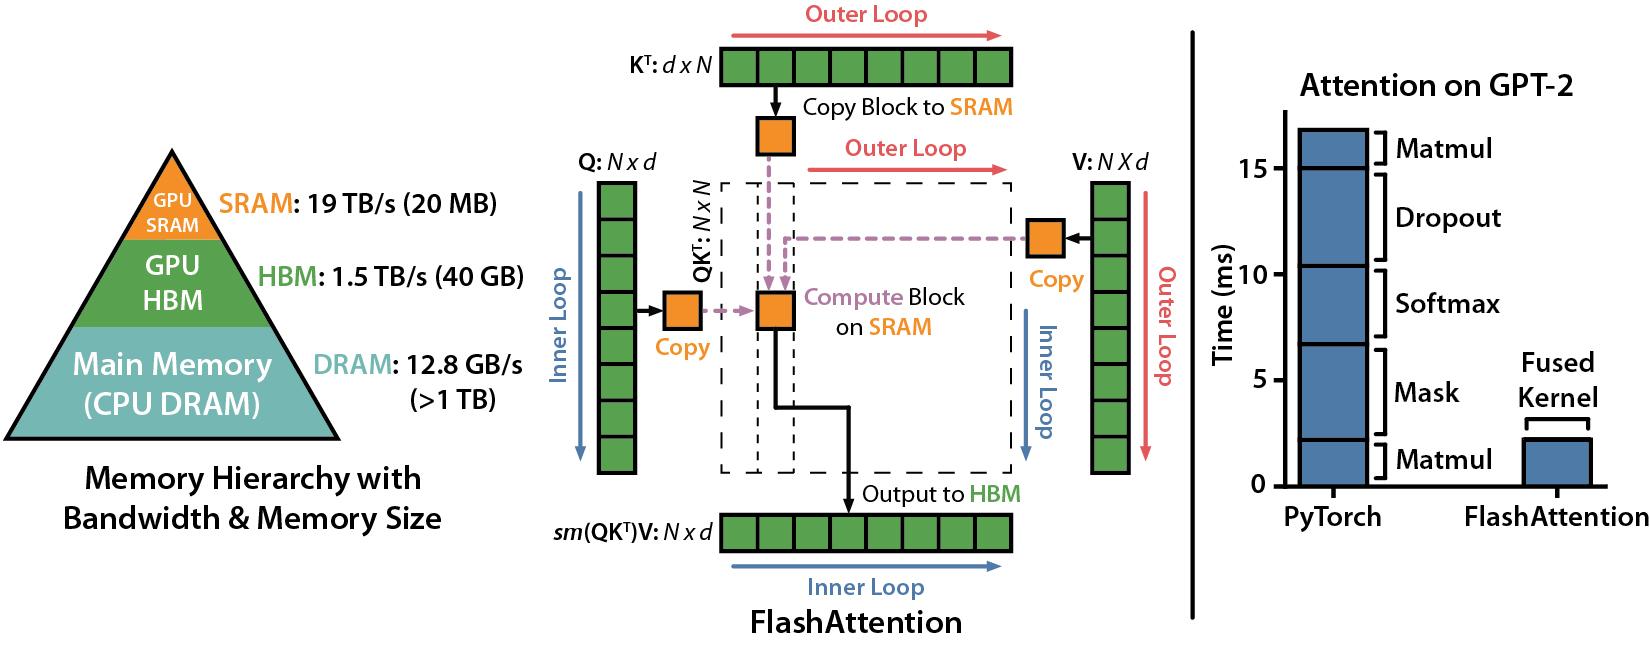
融合把同一思想推得更远,把中间值保存在寄存器和共享内存里,而不是在 HBM 里往返,而兆内核把它推到极限,把整个解码步作为一个启动运行。这是我亲手构建的。在同一张 H100 上,我的引擎 bonsai-turbo 跑到厂商自己的 llama.cpp 分叉的 1.76 倍,从每秒 85.5 到 151.1 个 token,输出相同(github.com/RightNow-AI/bonsai-turbo),我的内核搜索系统 AutoKernel 在最佳内核上达到 cuBLAS 的 1.31 倍,横跨 95 个实验、18 到 187 TFLOPS,同时保持 B200 vectorsum 榜首(github.com/RightNow-AI/autokernel)
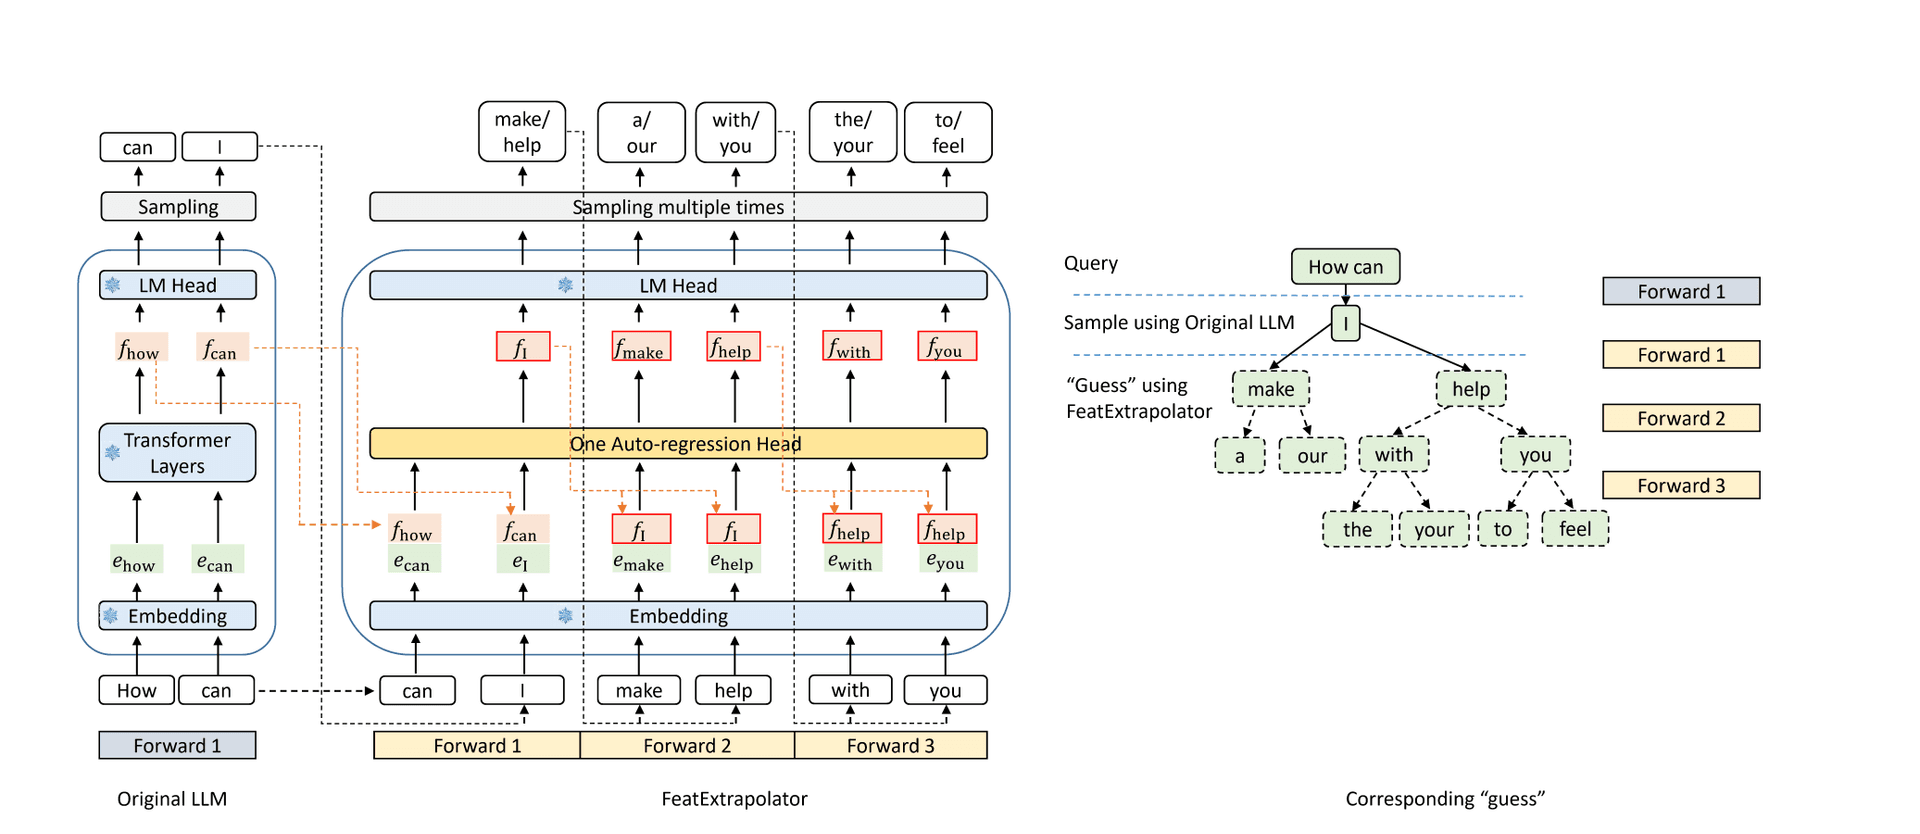
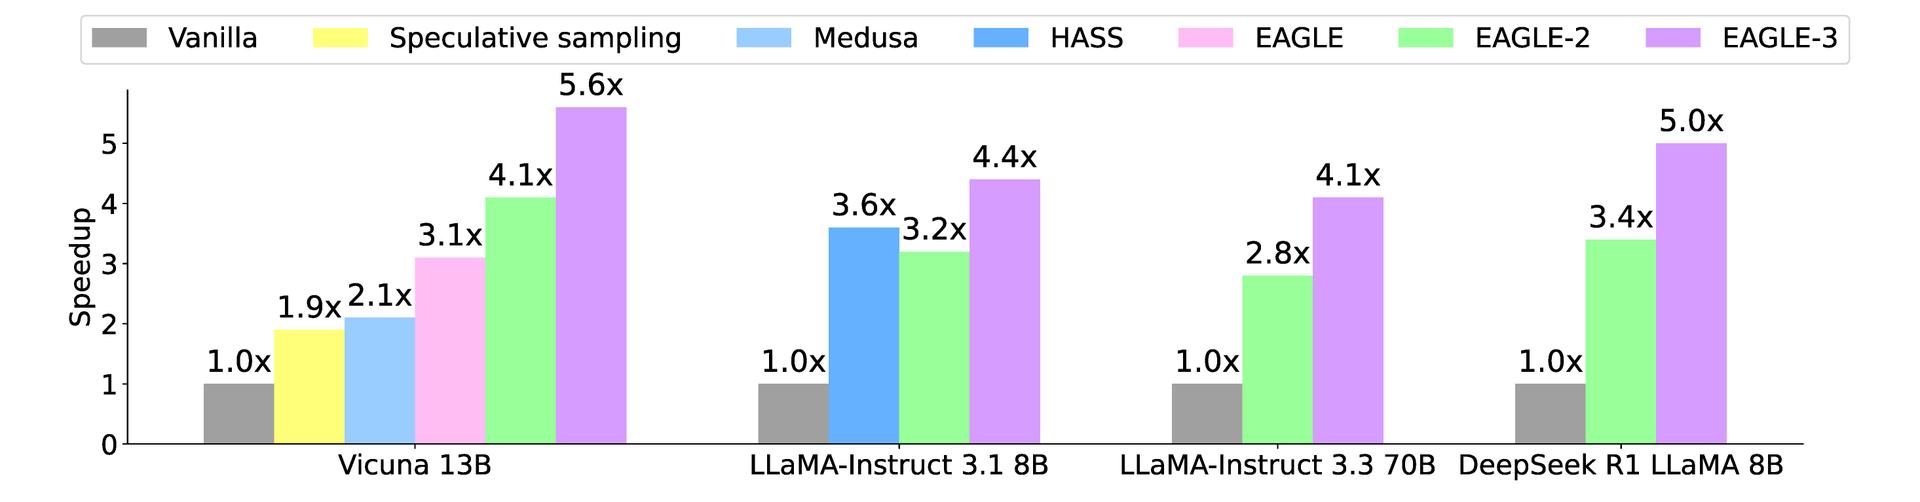
接下来是投机解码。一个小的草稿模型提出 g 个 token,目标模型一遍验证它们,一个修改过的拒绝采样步骤让输出分布严格保持目标模型的,这在 2023 年被独立证明过两次(arxiv.org/abs/2211.17192,arxiv.org/abs/2302.01318)。接受率为 a 时每个目标轮次的期望 token 数是 (1-a^(g+1))/(1-a),所以草稿准确率就是一切,EAGLE 系列把它推了上去(arxiv.org/abs/2401.15077)。EAGLE-2 说得直白("the distribution of the generated text remains unchanged"),报告 3.05 倍到 4.26 倍(arxiv.org/abs/2406.16858),EAGLE-3 报告最高 6.5 倍(arxiv.org/abs/2503.01840)
然后是无损权重压缩。BF16 权重每个参数携带的真实信息不足 16 位,所以 DFloat11 把熵编码到约 11 位,落到原大小的约 70%,输出与原模型逐位相同(arxiv.org/abs/2504.11651)。这覆盖了量化承诺的大部分内存节省,而没有质量账单
KV 复用是下一层。分页注意力终结了 KV 缓存碎片化,提高了真实批大小(arxiv.org/abs/2309.06180),基于基数树的前缀缓存让共享历史只计算一次(arxiv.org/abs/2312.07104)。这是安全的,因为缓存条目是前缀的纯函数,在相同位置复用它们不会移动 logits
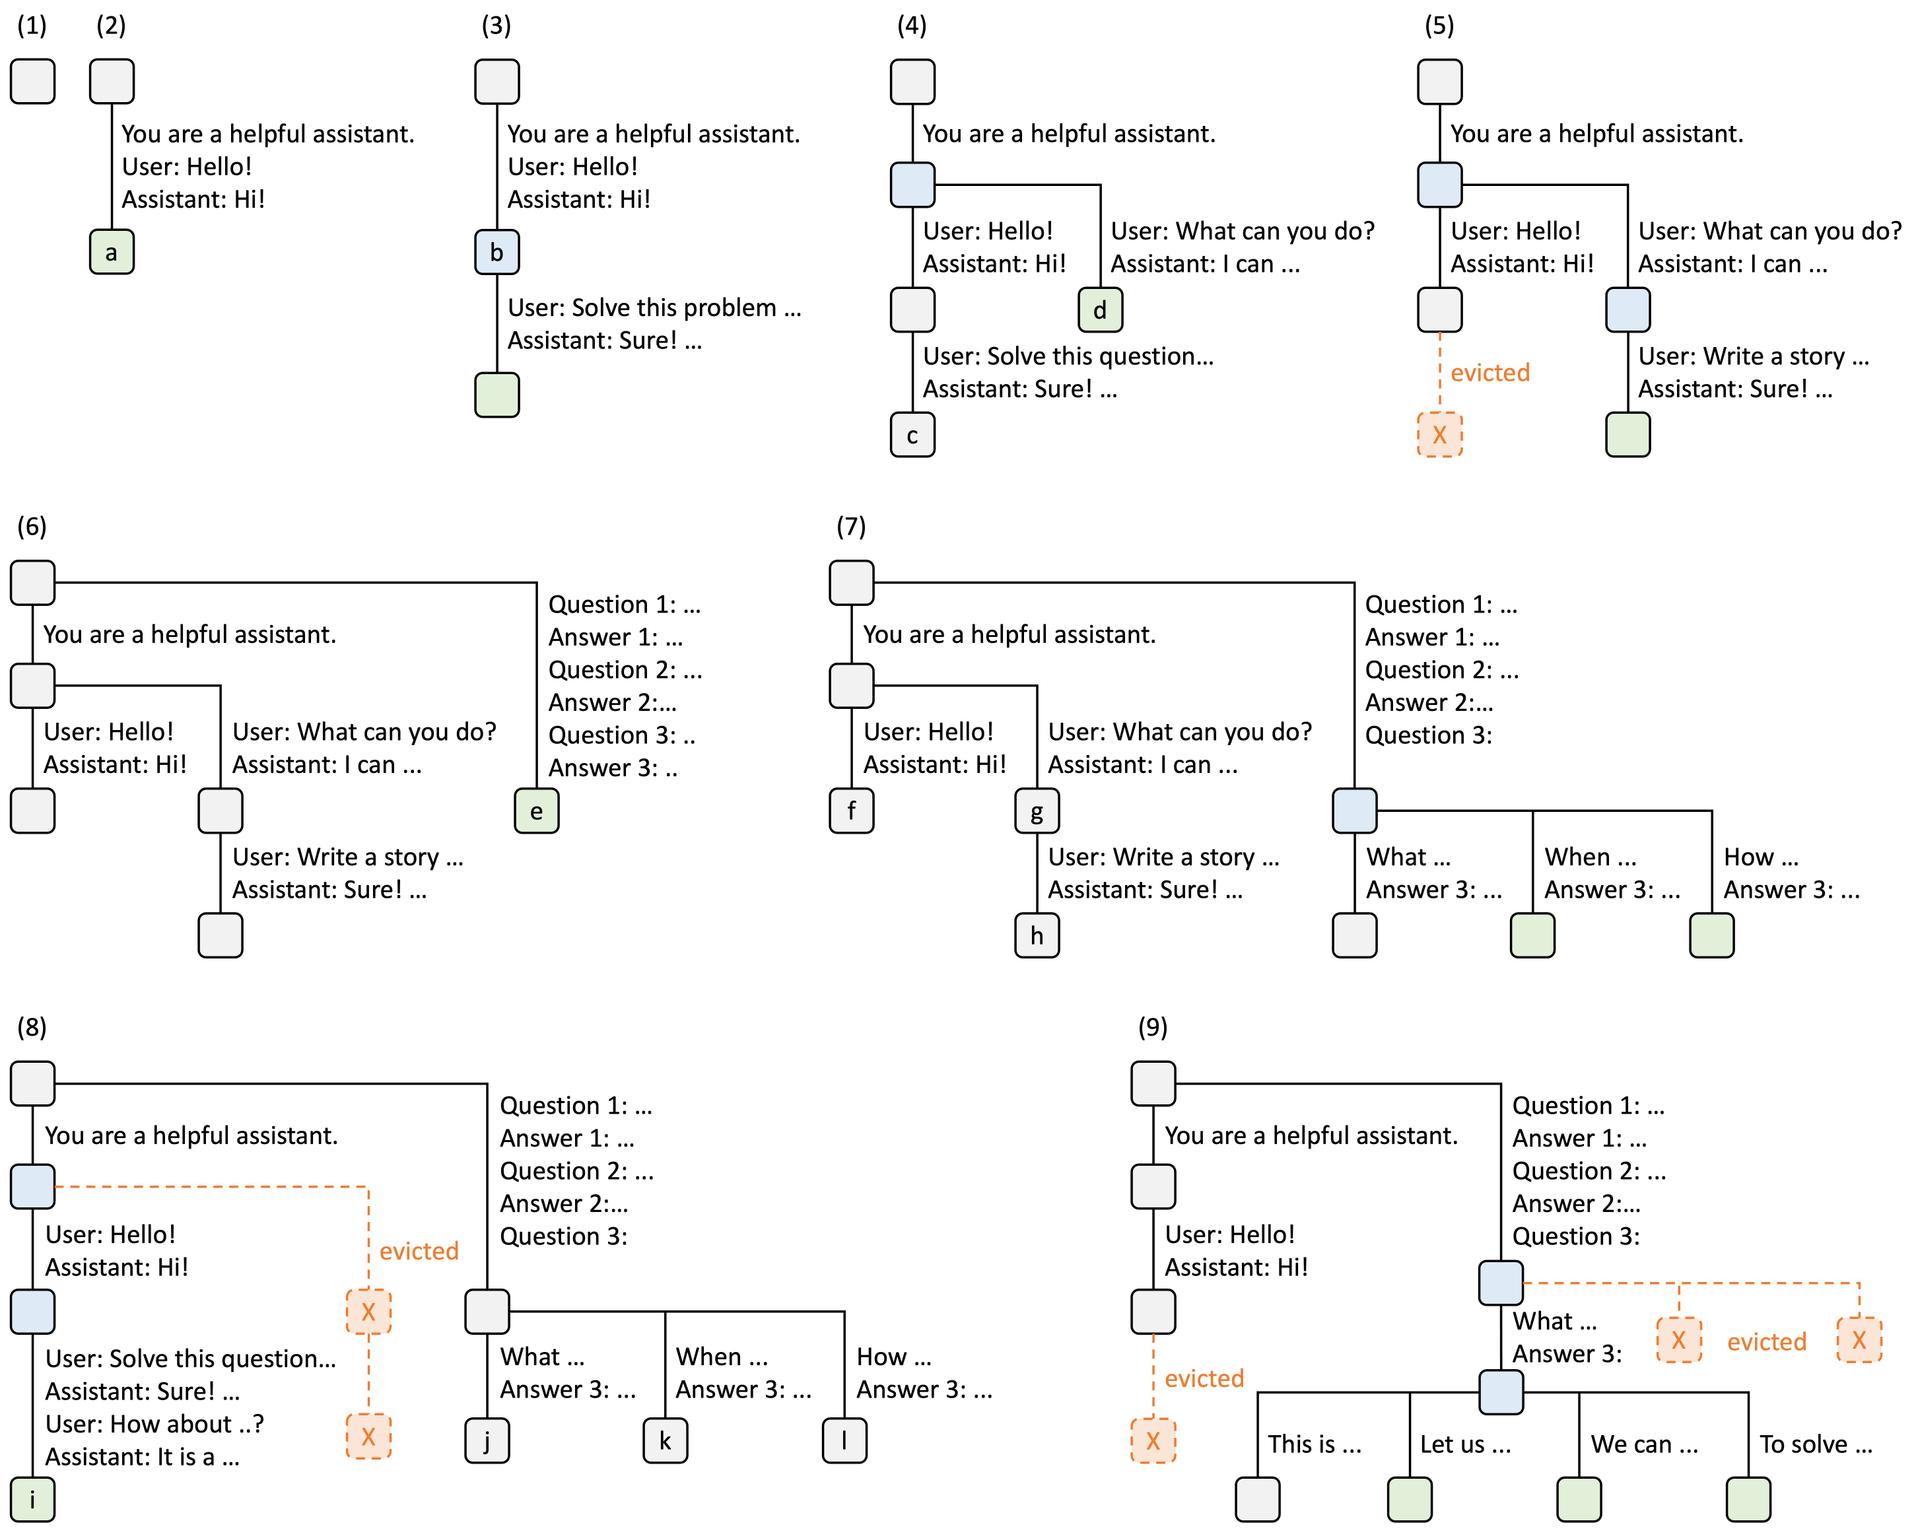
调度在最上面。连续批处理在 token 边界补满批次,而不是等最长的请求结束(usenix.org/conference/osdi22/presentation/yu),分块预填充阻止长提示拖住其他所有人的解码(arxiv.org/abs/2308.16369),预填充解码分离把工作负载的计算受限一半和带宽受限一半放到不同机器上(arxiv.org/abs/2401.09670)。这些都不碰任何一个 logit
移动的界线
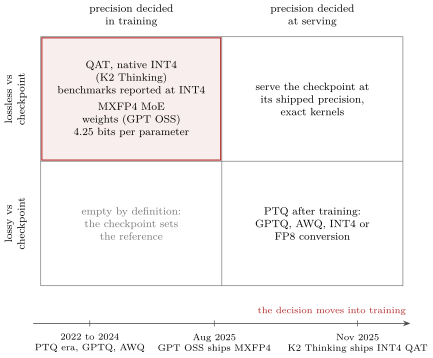
无损的边界画在发布的检查点上,而检查点本身在移动。Kimi K2 Thinking 带着原生 INT4 权重发布,因为 Moonshot 在训练后阶段运行了量化感知训练,把 INT4 放在 MoE 权重上,并以 INT4 报告每一项官方基准,生成大约快 2 倍(huggingface.co/moonshotai/Kimi-K2-Thinking)。OpenAI 发布的 gpt-oss 带 MXFP4 MoE 权重,每参数 4.25 位,覆盖超过 90% 的参数,这就是 gpt-oss-120b 装进一张 80 GB GPU 的原因(arxiv.org/abs/2508.10925)
对这些模型,服务 INT4 或 MXFP4 不是有损量化,它就是检查点。你不能退化的那个参考已经是低精度,厂商已经在训练期间把质量代价付在了该付的地方,所以量化正在变成一个训练决策,而在事后挤压一个 BF16 检查点仍然是一个服务层的 hack。我的测试很简单,如果你服务的权重就是厂商跑基准的权重,你在服务那个模型,如果你事后挤压过它们,你在服务你自己对模型的编辑
验证
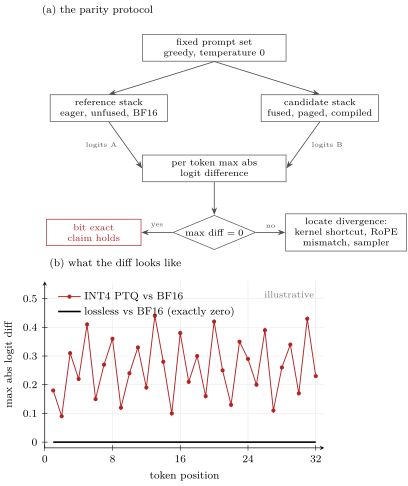
无损是一个可检验的主张,我用 logit 奇偶性检验它。用贪心解码把相同的提示跑过参考栈和你的栈,然后比较每个 token 的最大绝对 logit 差,位精确主张的通过线是零,投机解码的通过线是一次分布测试。我为 bonsai-turbo 发布过这个结果,32 个提示中的 32 个在全部四个引擎配置下对厂商分叉通过(github.com/RightNow-AI/bonsai-turbo)。奇偶性失败时,差值指出我该看哪里,通常是一个抄了近路的融合内核、一个 RoPE 不匹配,或一个用不同方式重归一化的采样器
Moonshot 现在对每个服务其模型的人运行同类检查。K2 Vendor Verifier 向每个第三方 K2 提供商发送 4,000 个相同请求,按工具调用触发 F1 和 schema 准确率对照官方 API 打分(github.com/MoonshotAI/K2-Vendor-Verifier),差距是真实的,schema 准确率从最好提供商的 100% 降到修复落地前原生开源引擎上的约 73 到 76%。模型质量变成了服务栈的一个属性,而模型厂商已经开始测量它
浮点加法不满足结合律,所以内核内的归约顺序改变低位,而这个顺序随批大小变化。Thinking Machines 测量过后果:在原版 vLLM 上 1,000 个温度零补全给出 80 个不同输出,而批不变内核让全部 1,000 个逐位相同,代价是 1.6 到 2 倍运行时间(thinkingmachines.ai/blog/defeating-nondeterminism-in-llm-inference/),Chen et al. 出于同样原因把他们的投机解码证明限定在"within hardware numerics"(arxiv.org/abs/2302.01318)。所以无损指栈不添加你已接受的数值之外的误差,而不是指跨批大小逐位相同的输出,除非你也为批不变性付费
无损为何胜出
经济学了结这场争论。量化一次性省下固定倍数,然后在每个任务的每一步持续支付质量,而无损的收益彼此相乘,内核乘投机解码乘 KV 复用乘调度,每一项都保持模型精确。单看一项就已经显示无损在真实硬件上买到什么:
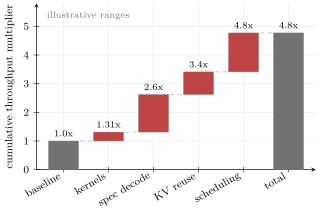
我记得刚开始做这件事时,我想无损会是未来,现在我更确信了。在 RightNow 我构建的正是这个:在完整无损栈上服务开放模型,并用对参考的 logit 奇偶性验证它