
Inferencia sin pérdida
, 9 min de lectura, By Jaber Jaber
InvestigaciónNota editorial: Este artículo se publicó primero en nuestro sitio anterior. El producto de optimización descrito aquí está retirado. RightNow sirve modelos abiertos a través de su API.
La cuantización se volvió la forma predeterminada de acelerar la inferencia porque es la más fácil. En vLLM es un flag o un checkpoint intercambiado (docs.vllm.ai), mientras que hacer el verdadero trabajo de optimización, como escribir mejores kernels, toma meses. Así que la gente cambia el checkpoint y sigue adelante, y las mismas personas que jamás enviarían un cambio de prompt sin revisión terminan entregando un modelo cuantizado sin ejecutar una sola evaluación, porque el flag lo hace sentir como un ajuste de infraestructura cuando en realidad es un cambio de modelo
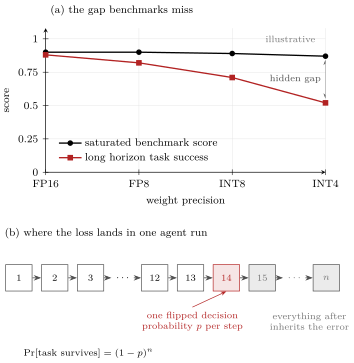
La cuantización es un intercambio, no una optimización. Ahorras memoria y pagas en calidad, y el costo es difícil de ver porque la cuantización post entrenamiento mueve cada peso un poco mientras los benchmarks estándar apenas reaccionan, ya que están saturados y prueban un paso a la vez. La pérdida real aparece en cadenas largas de razonamiento y ejecuciones de programación agéntica donde cientos de decisiones dependientes se apilan, así que el benchmark te dice que los dos modelos son iguales mientras la tasa de éxito de tu agente te dice que no. Este artículo trata sobre la pila de serving que logra la velocidad sin pagar ese costo
Las matemáticas del efecto compuesto
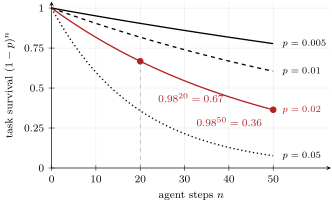
Si el ruido de cuantización invierte una decisión por paso con probabilidad p, entonces en n pasos dependientes la tarea sobrevive con probabilidad (1-p)^n. Un 2 por ciento por paso suena gratis hasta que ejecutas 20 pasos, porque 0.98^20 = 0.67 y un tercio de tus tareas ahora fallan, y a 50 pasos quedas en 0.36
Si mantienes p en medio por ciento, la supervivencia en 20 pasos se queda en 0.90, y esa es la diferencia entre un agente en el que confías y un agente al que cuidas. El modelo nunca se volvió visiblemente más tonto, solo quedó un 2 por ciento más ruidoso por decisión y el efecto compuesto hizo el resto
Qué significa sin pérdida
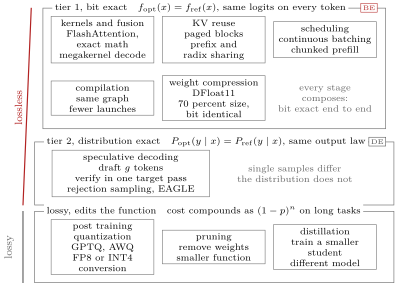
Inferencia sin pérdida significa que la pila se vuelve más rápida mientras el modelo sigue siendo exactamente el mismo modelo, y yo la divido en dos niveles
Bit exacto significa que la pila optimizada devuelve los mismos logits que la referencia en cada entrada, f_opt(x) = f_ref(x). Kernels y fusión, compilación, reutilización de KV, planificación y compresión de pesos sin pérdida viven en este nivel porque cambian cómo se ejecuta la matemática sin cambiar la matemática misma
Exacto en distribución significa que la pila optimizada muestrea de la misma distribución que la referencia, P_opt(y | x) = P_ref(y | x). El decodificador especulativo con muestreo de rechazo vive aquí, donde muestras individuales pueden diferir pero la distribución nunca
Todo lo demás, PTQ, poda y destilación, cambia la función misma, lo que significa que estás sirviendo un modelo distinto con el mismo nombre. Esta definición importa porque mueve la carga de la prueba, ya que un cambio sin pérdida no necesita una evaluación cuando las salidas son la evidencia, mientras que un cambio con pérdida necesita una evaluación completa en tu carga de trabajo y no solo en MMLU. Bit exacto también compone, porque una tubería de etapas bit exactas sigue siendo bit exacta, así que puedo apilar cinco sin ejecutar cinco ciclos de evaluación
La pila sin pérdida, de abajo hacia arriba
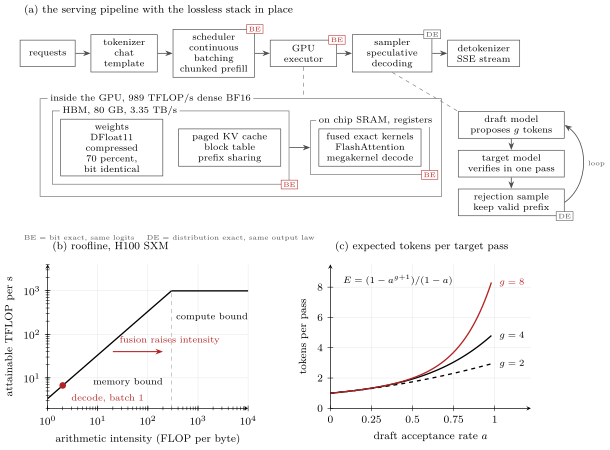
La pila empieza con los kernels. La inferencia en tamaños de lote de serving está limitada por el ancho de banda de memoria, ya que una H100 SXM mueve unos 3.35 TB/s desde HBM mientras hace unos 989 TFLOP/s densos en BF16 (nvidia.com/en-us/data-center/h100/), así que un kernel gana su velocidad moviendo menos bytes en lugar de haciendo menos matemática. FlashAttention demostró el punto hace años al calcular atención exacta reordenando el tráfico de memoria y obteniendo grandes aceleraciones con salidas idénticas (arxiv.org/abs/2205.14135), y el reordenamiento es válido porque la softmax en línea calcula la misma normalización a partir de estadísticas corridas, así que nada del resultado cambia
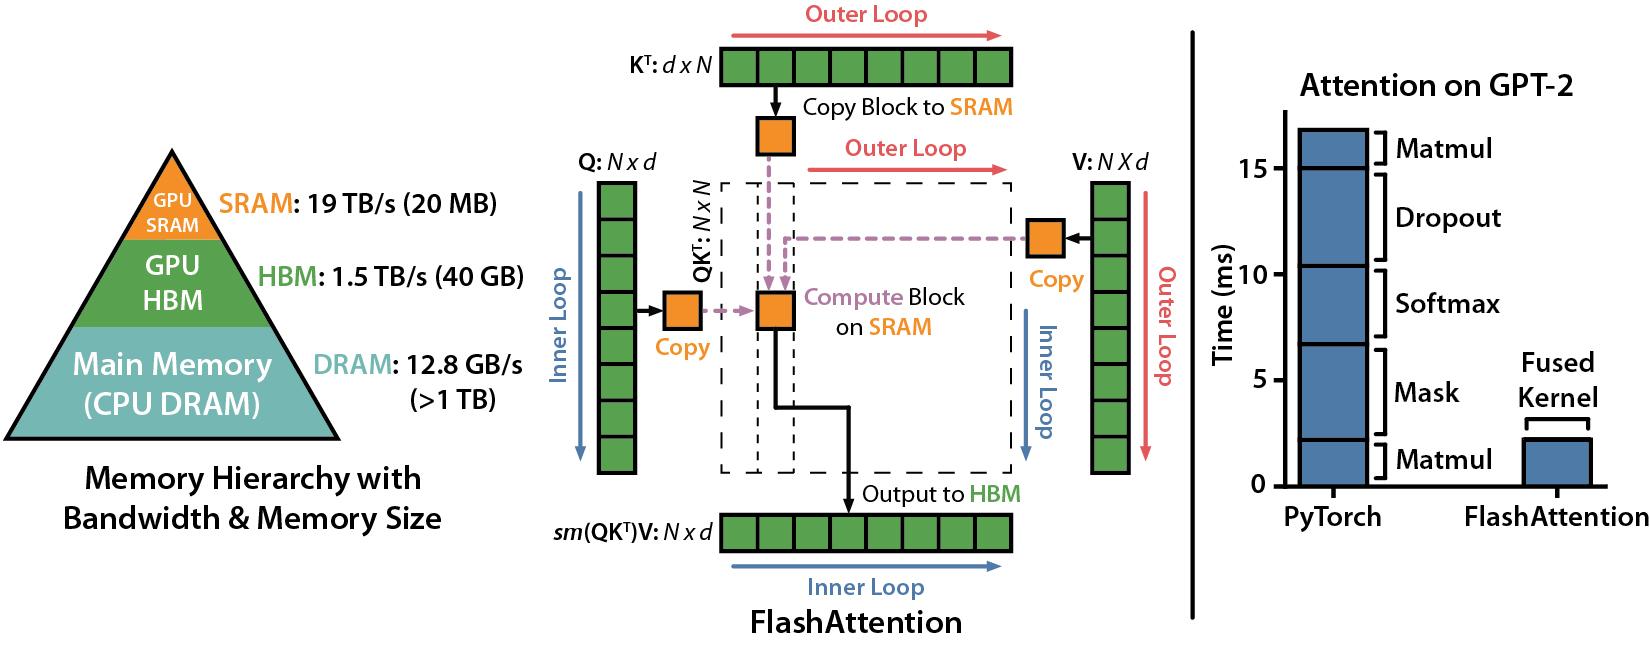
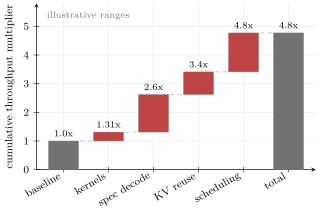
La fusión lleva la misma idea más allá al mantener los valores intermedios en registros y memoria compartida en lugar de ir y volver por HBM, y un megakernel lo lleva al límite ejecutando todo el paso de decodificación como un solo lanzamiento. Yo construí esto mismo. En la misma H100 mi motor bonsai-turbo corre a 1.76x el fork de llama.cpp del propio proveedor, yendo de 85.5 a 151.1 tokens por segundo con las mismas salidas (github.com/RightNow-AI/bonsai-turbo), y mi sistema de búsqueda de kernels AutoKernel alcanzó 1.31x sobre cuBLAS en sus mejores kernels a lo largo de 95 experimentos entre 18 y 187 TFLOPS manteniendo el primer lugar en la tabla de vectorsum de la B200 (github.com/RightNow-AI/autokernel)
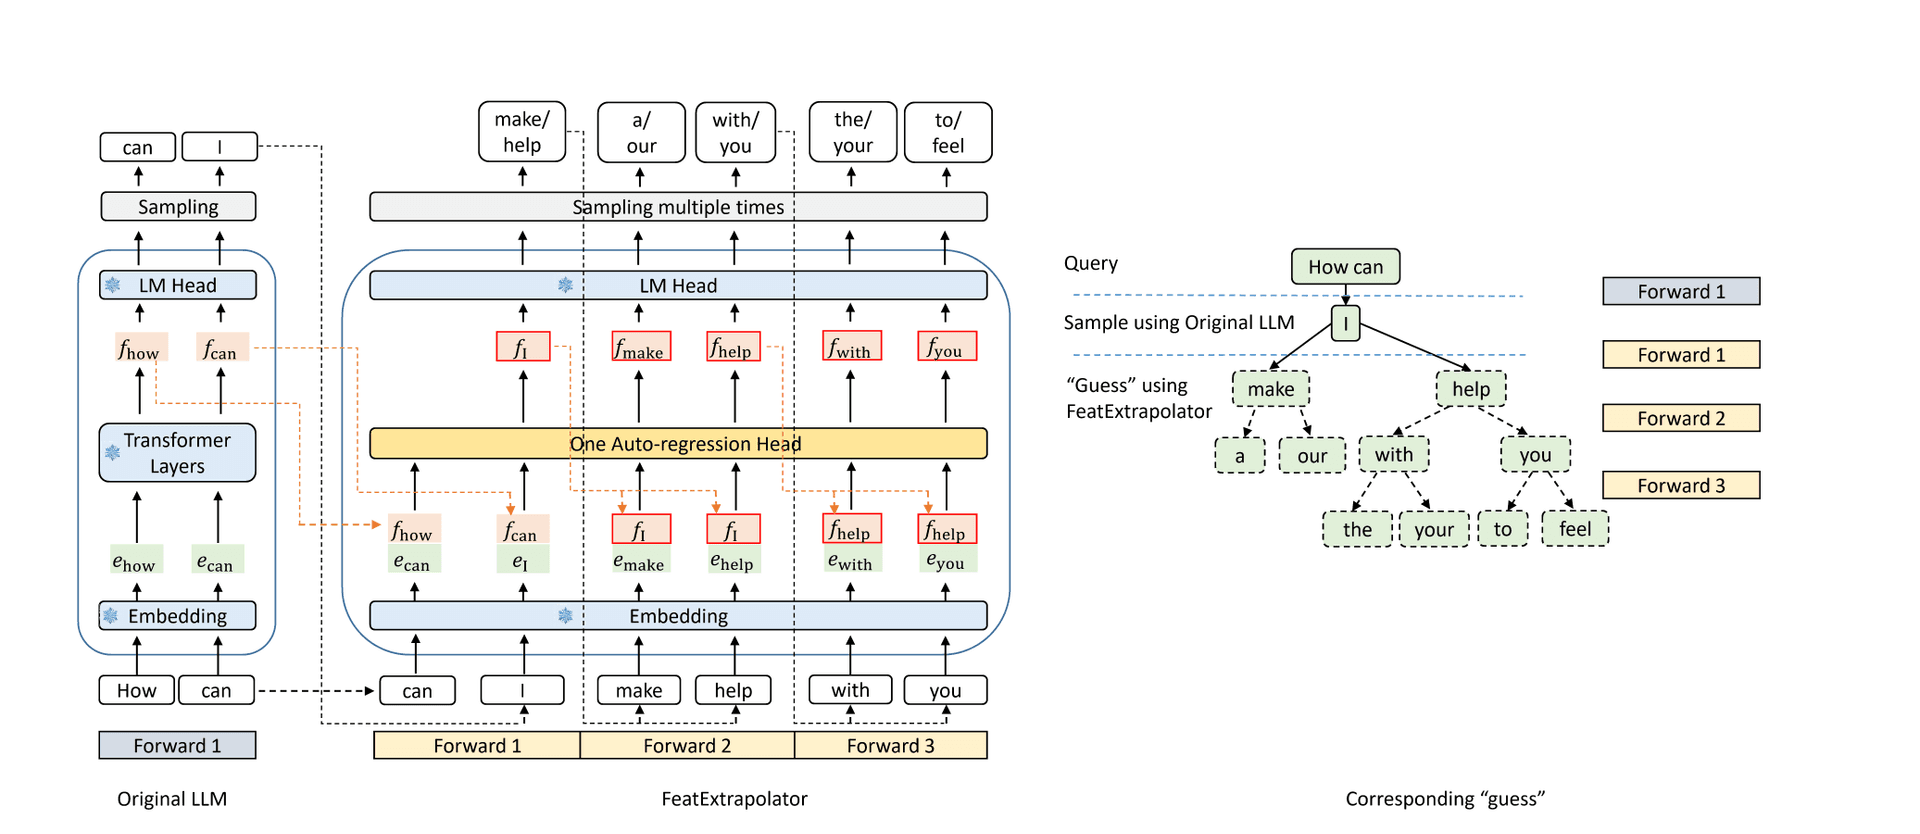
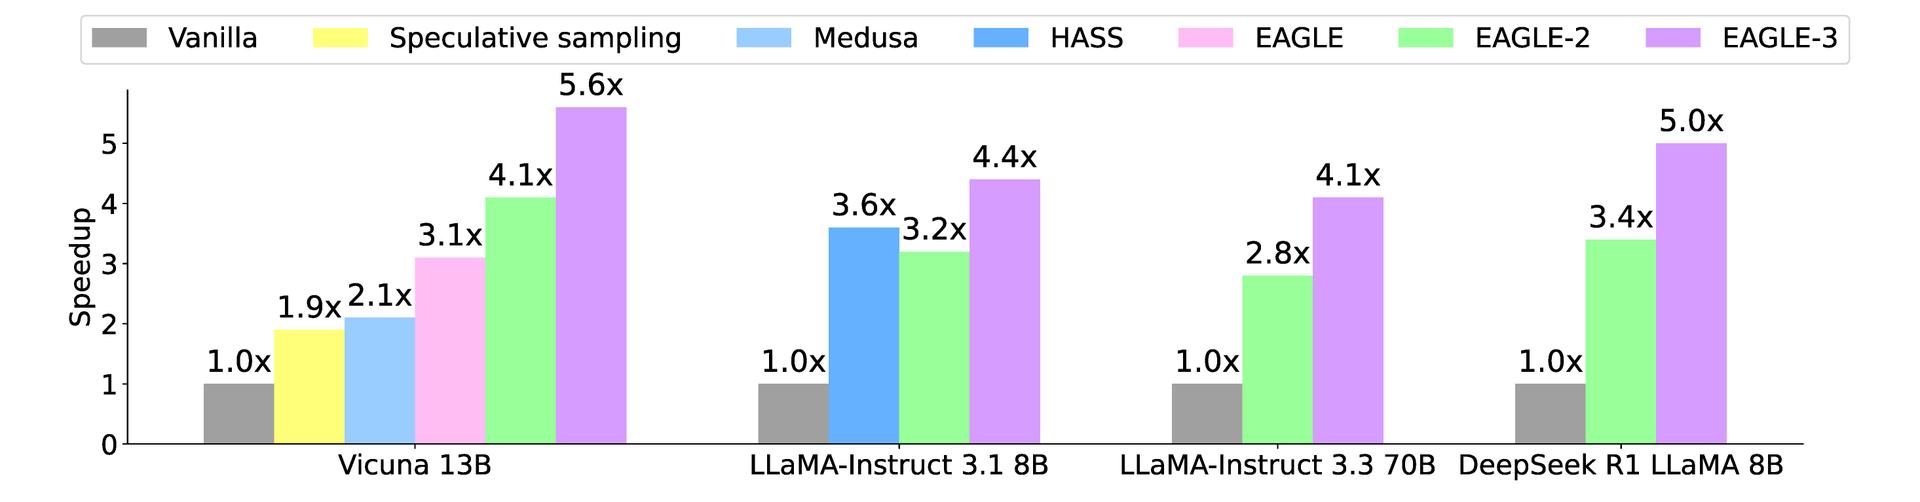
El decodificador especulativo viene después. Un modelo borrador pequeño propone g tokens, el modelo objetivo los verifica en una pasada, y un paso de muestreo de rechazo modificado mantiene la distribución de salida exactamente igual a la del objetivo, lo que se demostró de forma independiente dos veces en 2023 (arxiv.org/abs/2211.17192, arxiv.org/abs/2302.01318). El número esperado de tokens por pasada del objetivo es (1-a^(g+1))/(1-a) con tasa de aceptación a, así que la precisión del borrador lo es todo, y la línea EAGLE es lo que la subió (arxiv.org/abs/2401.15077). EAGLE-2 lo dice sin rodeos ("la distribución del texto generado permanece sin cambios") y reporta 3.05x a 4.26x (arxiv.org/abs/2406.16858), mientras EAGLE-3 reporta hasta 6.5x (arxiv.org/abs/2503.01840)
Luego está la compresión de pesos sin pérdida. Los pesos en BF16 llevan menos de 16 bits de información real por parámetro, así que DFloat11 los codifica por entropía hasta unos 11 bits, lo que aterriza en cerca del 70 por ciento del tamaño original con salidas que siguen idénticas bit a bit al modelo original (arxiv.org/abs/2504.11651). Eso cubre la mayor parte del ahorro de memoria que la cuantización promete sin la factura de calidad
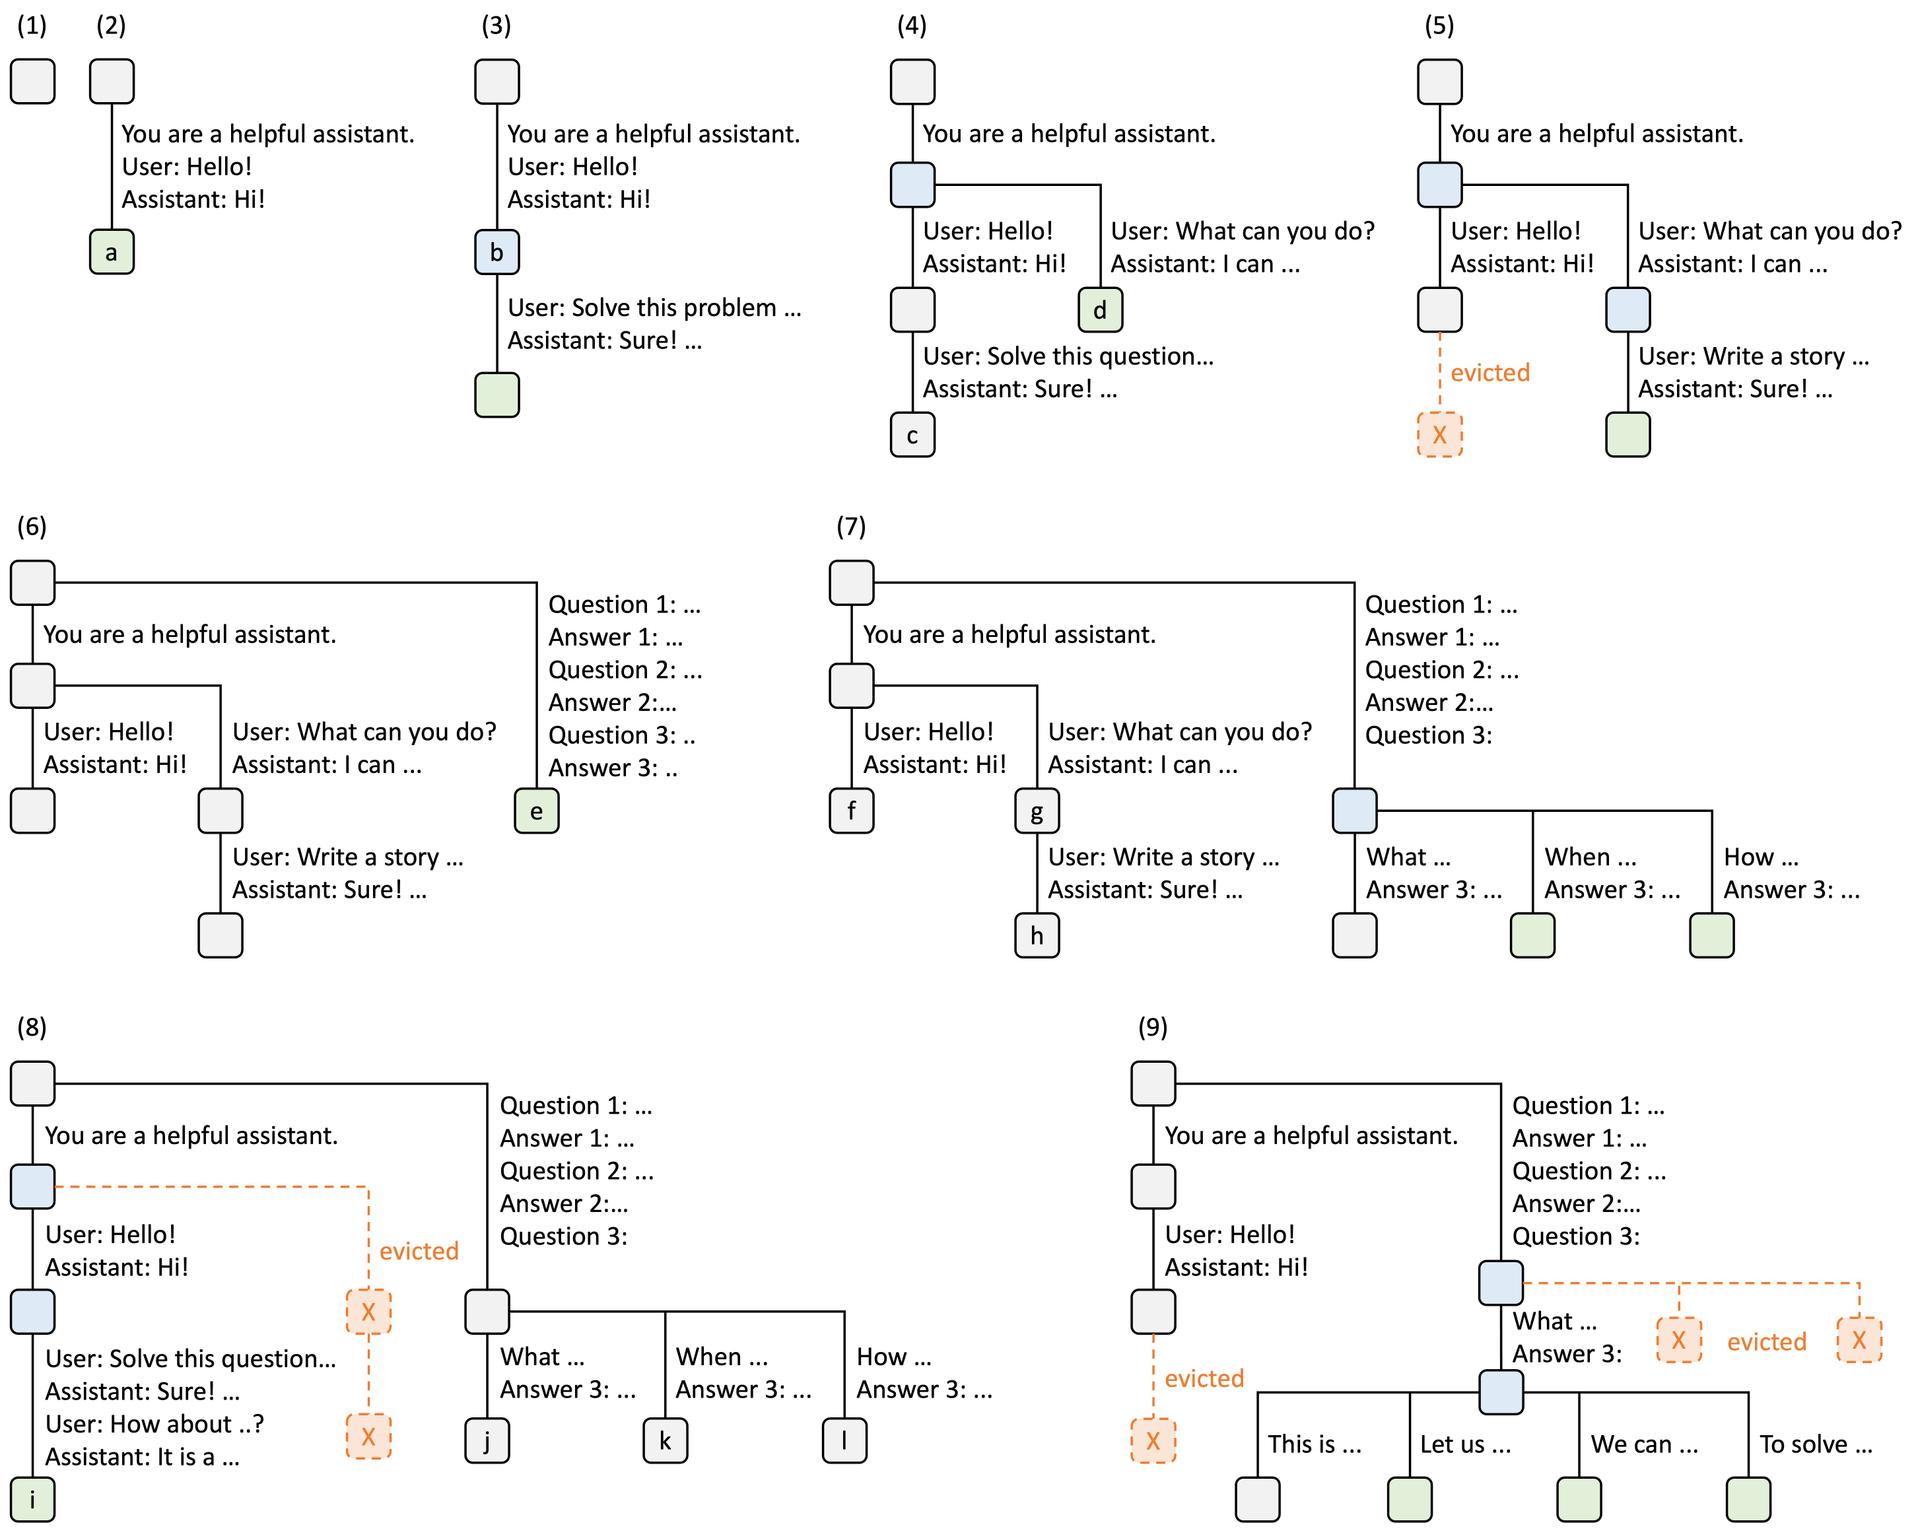
La reutilización de KV es la siguiente capa. La atención paginada terminó con la fragmentación del caché KV y elevó los tamaños reales de lote (arxiv.org/abs/2309.06180), y el caché de prefijos con árboles radix hace que la historia compartida se compute una sola vez (arxiv.org/abs/2312.07104). Esto es seguro porque las entradas del caché son una función pura del prefijo, así que reutilizarlas en las mismas posiciones no puede mover los logits
La planificación está encima. El batcheo continuo rellena el lote en las fronteras de tokens en lugar de esperar a que termine la solicitud más larga (usenix.org/conference/osdi22/presentation/yu), el prefill por trozos evita que un prompt largo detenga la decodificación de todos los demás (arxiv.org/abs/2308.16369), y la desagregación de prefill y decodificación pone la mitad limitada por cómputo y la mitad limitada por ancho de banda de la carga en máquinas distintas (arxiv.org/abs/2401.09670). Ninguna de estas toca un solo logit
La línea que se mueve
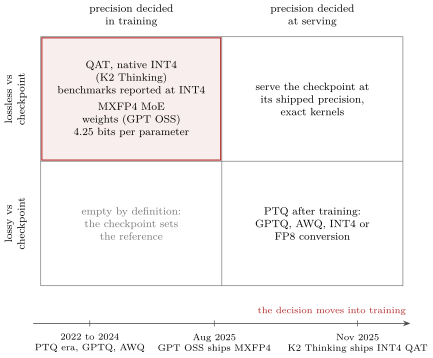
La frontera de lo sin pérdida se dibuja en el checkpoint publicado, y el checkpoint mismo se está moviendo. Kimi K2 Thinking se publicó con pesos INT4 nativos porque Moonshot ejecutó entrenamiento consciente de la cuantización en el post entrenamiento, puso INT4 en los pesos del MoE y reportó todos los benchmarks oficiales en INT4 con una generación unas 2 veces más rápida (huggingface.co/moonshotai/Kimi-K2-Thinking). OpenAI publicó gpt-oss con pesos MXFP4 en el MoE a 4.25 bits por parámetro, que cubre más del 90 por ciento de los parámetros y es la razón de que gpt-oss-120b quepa en una GPU de 80 GB (arxiv.org/abs/2508.10925)
Para estos modelos servir INT4 o MXFP4 no es cuantización con pérdida, es el checkpoint. La referencia que no debes degradar ya es de baja precisión, y el proveedor ya pagó el costo de calidad durante el entrenamiento donde corresponde, así que la cuantización se está convirtiendo en una decisión de entrenamiento mientras exprimir un checkpoint BF16 después de los hechos sigue siendo un truco de serving. Mi prueba es simple, si los pesos que sirves son los pesos que el proveedor evaluó entonces sirves el modelo, y si los exprimiste después entonces sirves tu propia edición del modelo
Verificación
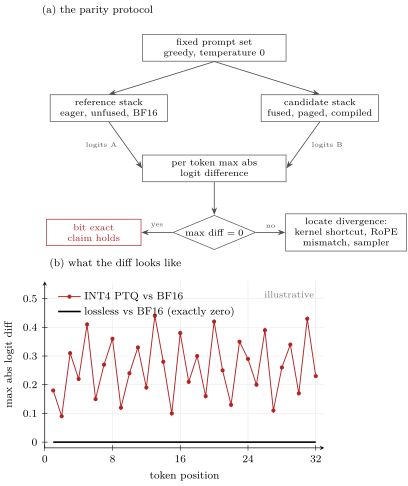
Sin pérdida es una afirmación que puedes probar, y yo la pruebo con paridad de logits. Ejecutas los mismos prompts por la pila de referencia y por la tuya con decodificación greedy, luego comparas la máxima diferencia absoluta de logits por token, donde cero es la barra de aprobación para una afirmación bit exacta y una prueba de distribución es la barra para el decodificador especulativo. Yo publiqué esto para bonsai-turbo, donde 32 de 32 prompts pasan contra el fork del proveedor en las cuatro configuraciones del motor (github.com/RightNow-AI/bonsai-turbo). Cuando la paridad falla el diff me muestra dónde mirar, y suele ser un kernel fusionado que cortó una esquina, un RoPE que no coincide o un muestreador que renormaliza distinto
Moonshot ahora ejecuta el mismo tipo de verificación con quien sirva su modelo. El K2 Vendor Verifier envía 4,000 solicitudes idénticas a cada proveedor externo de K2 y los puntúa contra la API oficial en F1 de disparo de tool calls y exactitud de esquema (github.com/MoonshotAI/K2-Vendor-Verifier), y la brecha fue real, con exactitud de esquema desde el 100 por ciento en los mejores proveedores hasta unos 73 a 76 por ciento en motores de código abierto sin ajustes antes de que llegaran las correcciones. La calidad del modelo se volvió una propiedad de la pila de serving y los proveedores de modelos empezaron a medirla
La suma en punto flotante no es asociativa, así que el orden de reducción dentro de un kernel cambia los bits bajos, y ese orden cambia con el tamaño del lote. Thinking Machines midió la consecuencia cuando 1,000 completiones a temperatura cero en vLLM sin ajustes dieron 80 salidas distintas, mientras que kernels invariantes al lote devolvieron las 1,000 idénticas bit a bit a 1.6x a 2x el tiempo de ejecución (thinkingmachines.ai/blog/defeating-nondeterminism-in-llm-inference/), y Chen et al. acotaron su prueba del decodificador especulativo "dentro de la numérica del hardware" por la misma razón (arxiv.org/abs/2302.01318). Así que sin pérdida significa que la pila no añade error más allá de la numérica que ya aceptaste, y no significa salidas idénticas bit a bit entre tamaños de lote a menos que también pagues por invariancia de lote
Por qué gana lo sin pérdida
La economía zanja la discusión. La cuantización ahorra un factor fijo una vez y sigue pagando calidad en cada paso de cada tarea, mientras que las victorias sin pérdida se multiplican entre sí, kernels por decodificación especulativa por reutilización de KV por planificación, con cada término manteniendo el modelo exacto. Un solo término ya muestra lo que compra lo sin pérdida en hardware real:
Recuerdo cuando empecé a trabajar en esto, pensé que lo sin pérdida sería el futuro, y ahora estoy más seguro. En RightNow construyo exactamente esto, sirviendo modelos abiertos sobre la pila sin pérdida completa y verificándolo con paridad de logits contra la referencia