
ロスレス推論
, 9分で読めます, By Jaber Jaber
研究編集注: この投稿は、まず私たちの以前のサイトで公開されました。ここで説明する最適化製品は提供を終了しています。RightNow は API でオープンモデルを提供しています。
量子化が推論高速化のデフォルトの方法になったのは、それが最も簡単だからです。vLLM ではフラグ 1 つかチェックポイントの交換 (docs.vllm.ai) で済みますが、より優れたカーネルを書くような本物の最適化には何か月もかかります。だから人はチェックポイントを交換して先に進み、レビューしていないプロンプトの変更は絶対にリリースしない同じ人々が、評価を 1 回も実行せずに量子化モデルを出荷します。フラグのせいで、実際にはモデルの変更なのにインフラ設定のように感じられるのです
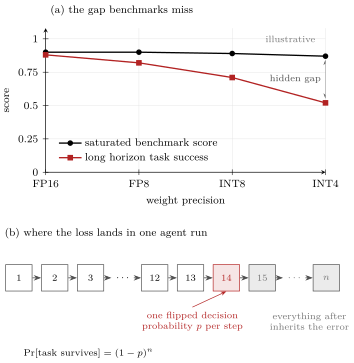
量子化は最適化ではなく、トレードです。メモリを節約し、その代償を品質で支払い、コストは見えにくいものになります。学習後量子化はすべてのウェイトを少しずつ動かすのに、標準的なベンチマークはほとんど反応しないからです。それらは飽和しており、一度に 1 ステップずつテストします。本当の損失は、何百もの依存する決定が積み重なる長い推論連鎖やエージェントのコーディング実行に現れます。ベンチマークは 2 つのモデルが同じだと言い、エージェントの成功率は同じではないと言うのです。この投稿は、その代償を払わずに速度を得るサービングスタックについてです
複利の数理
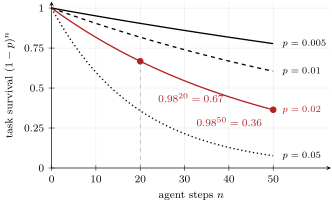
量子化ノイズが 1 ステップに確率 p で 1 つの決定を反転させるなら、n 個の依存ステップの後、タスクが生き残る確率は (1-p)^n です。1 ステップ 2 パーセントの低下は無料に聞こえますが、20 ステップ実行するまでそう思いません。0.98^20 = 0.67 で、タスクの 3 分の 1 が失敗し、50 ステップでは 0.36 まで下がります
代わりに p を 0.5 パーセントに保てば、20 ステップの生存率は 0.90 のままです。これが、信頼できるエージェントと、見守りが必要なエージェントの違いです。モデルは目に見えるほど馬鹿になったのではなく、決定ごとに 2 パーセントだけノイジーになり、複利が残りをやってのけたのです
ロスレスとは何を意味するか
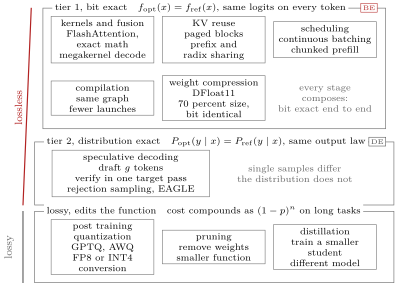
ロスレス推論とは、スタックが速くなりながらモデルはまったく同じモデルであり続けることです。私はそれを 2 つの階層に分けます
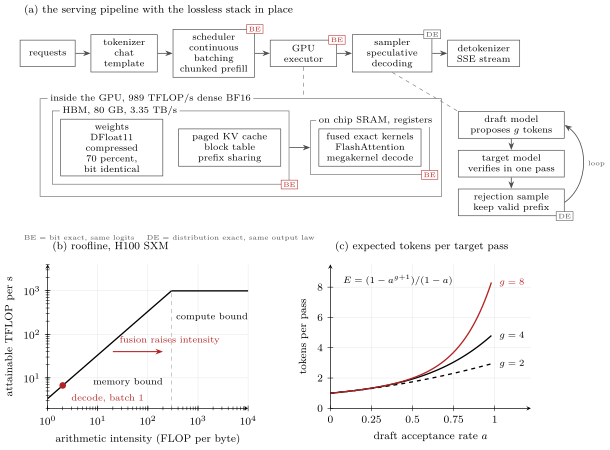
ビット正確とは、最適化されたスタックがすべての入力に対してリファレンスと同じロジットを返すこと、f_opt(x) = f_ref(x) です。カーネルと融合、コンパイル、KV 再利用、スケジューリング、ロスレスのウェイト圧縮はすべてこの階層に属します。数学の実行方法を変えるだけで、数学そのものは変えないからです
分布正確とは、最適化されたスタックがリファレンスと同じ分布からサンプルすること、P_opt(y | x) = P_ref(y | x) です。棄却サンプリング付きの投機的デコーディングはここに属します。単一のサンプルは異なりえても、分布は決して異なりません
それ以外のすべて、PTQ、枝刈り、蒸留は関数そのものを変えます。つまり同じ名前で別のモデルを提供しているのです。この定義が重要なのは、証明の負担を動かすからです。ロスレスな変更は、出力が証拠である以上、評価実行を必要としません。劣化する変更は、MMLU だけでなくあなたのワークロードでの完全な評価を必要とします。ビット正確は合成もできます。ビット正確な段階のパイプラインはまだビット正確なので、5 つの評価サイクルを回さずに 5 つを積み重ねられます
ロスレススタック、ボトムアップ
スタックはカーネルから始まります。サービングのバッチサイズでの推論はメモリ帯域が律速です。H100 SXM は約 989 dense BF16 TFLOP/s を計算しながら HBM から約 3.35 TB/s しか動かせない (nvidia.com/en-us/data-center/h100/) ので、カーネルは計算を減らすのではなくバイトを減らすことで速度を稼ぎます。FlashAttention は何年も前に、メモリトラフィックを並べ替えて正確な attention を計算し、同一の出力で大きなスピードアップを得てその点を証明しました (arxiv.org/abs/2205.14135)。この並べ替えが有効なのは、オンライン softmax が実行統計から同じ正規化を計算するからで、結果の何も変わりません
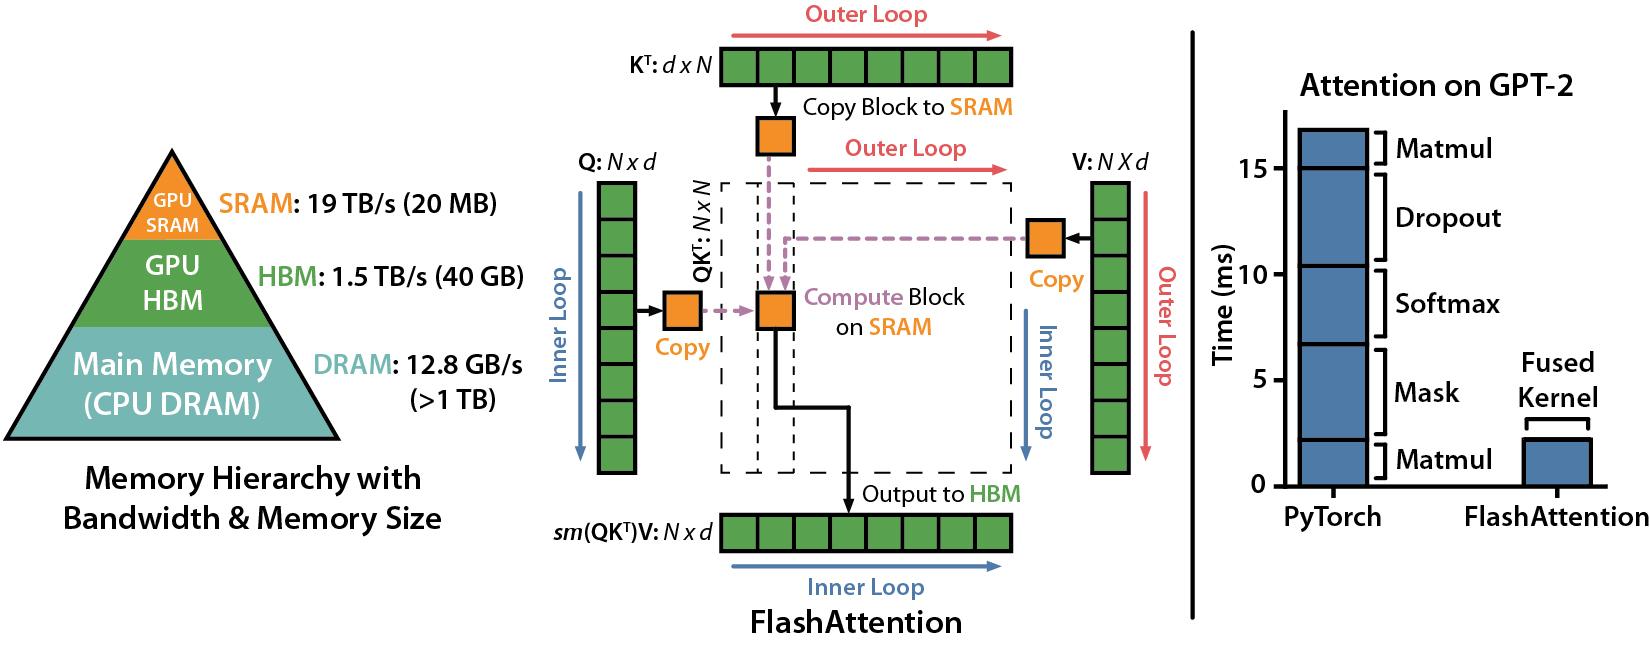
融合は同じアイデアをさらに進め、中間値を HBM への往復ではなくレジスタと共有メモリに保持します。メガカーネルはそれを極限まで押し、デコードステップ全体を 1 回のローンチとして実行します。これは私自身が作りました。同じ H100 で、私のエンジン bonsai-turbo はベンダー自身の llama.cpp フォークの 1.76 倍を走り、毎秒トークン数は 85.5 から 151.1 に伸び、出力は同じです (github.com/RightNow-AI/bonsai-turbo)。私のカーネル探索システム AutoKernel は 95 実験を通じて 18 から 187 TFLOPS の範囲で最良のカーネルにおいて cuBLAS の 1.31 倍に達し、B200 vectorsum リーダーボードの首位を保っています (github.com/RightNow-AI/autokernel)
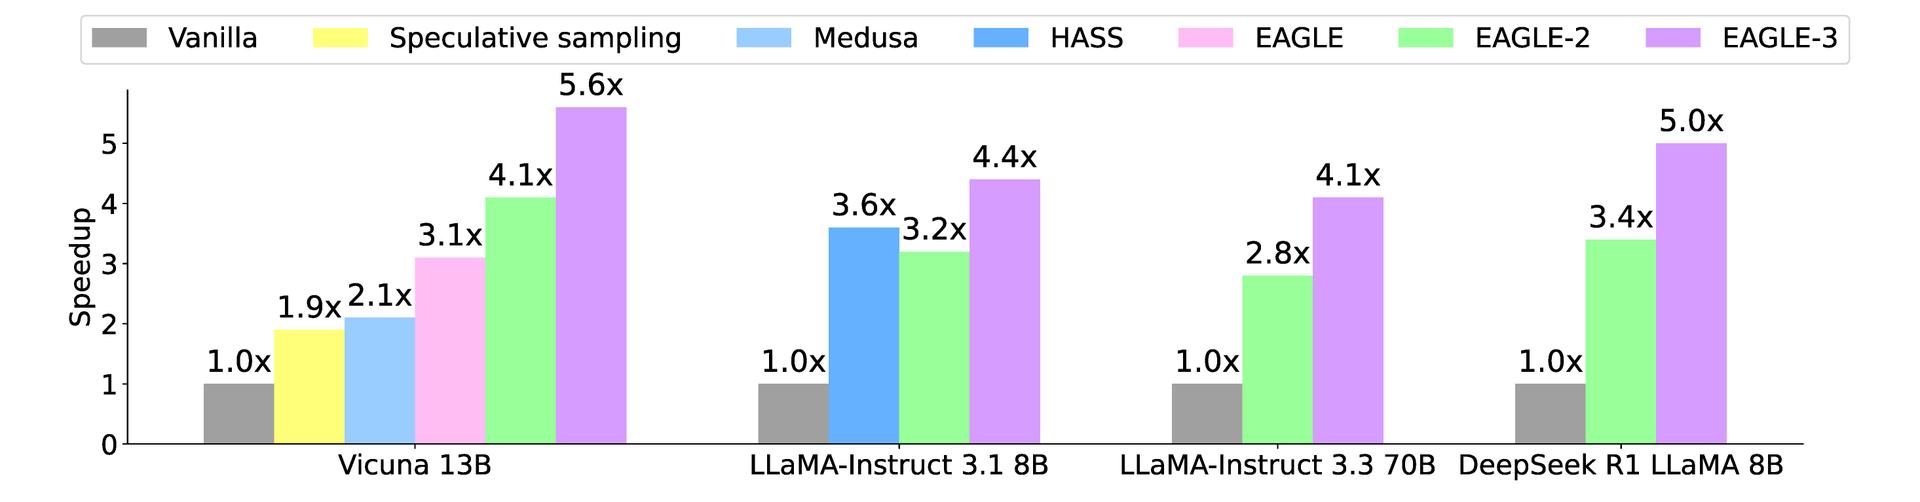
次は投機的デコーディングです。小さなドラフトモデルが g トークンを提案し、ターゲットモデルが 1 パスで検証し、修正された棄却サンプリングが出力分布を厳密にターゲットのものに保ちます。これは 2023 年に独立に 2 回証明されました (arxiv.org/abs/2211.17192, arxiv.org/abs/2302.01318)。ターゲット 1 パスあたりの期待トークン数は受容率 a で (1-a^(g+1))/(1-a) なので、ドラフトの精度がすべてであり、EAGLE の系統がそれを押し上げました (arxiv.org/abs/2401.15077)。EAGLE-2 はそれを明快に述べ ("the distribution of the generated text remains unchanged")、3.05 倍から 4.26 倍を報告しています (arxiv.org/abs/2406.16858)。EAGLE-3 は最大 6.5 倍を報告します (arxiv.org/abs/2503.01840)
次はロスレスのウェイト圧縮です。BF16 のウェイトはパラメータあたり 16 ビット未満の本当の情報しか持たないので、DFloat11 はエントロピー符号化で約 11 ビットまで圧縮します。これは元のサイズの約 70 パーセントに収まり、出力は元のモデルとビットごとに同一です (arxiv.org/abs/2504.11651)。量子化が約束するメモリ節約の大部分を、品質の請求書なしに賄います
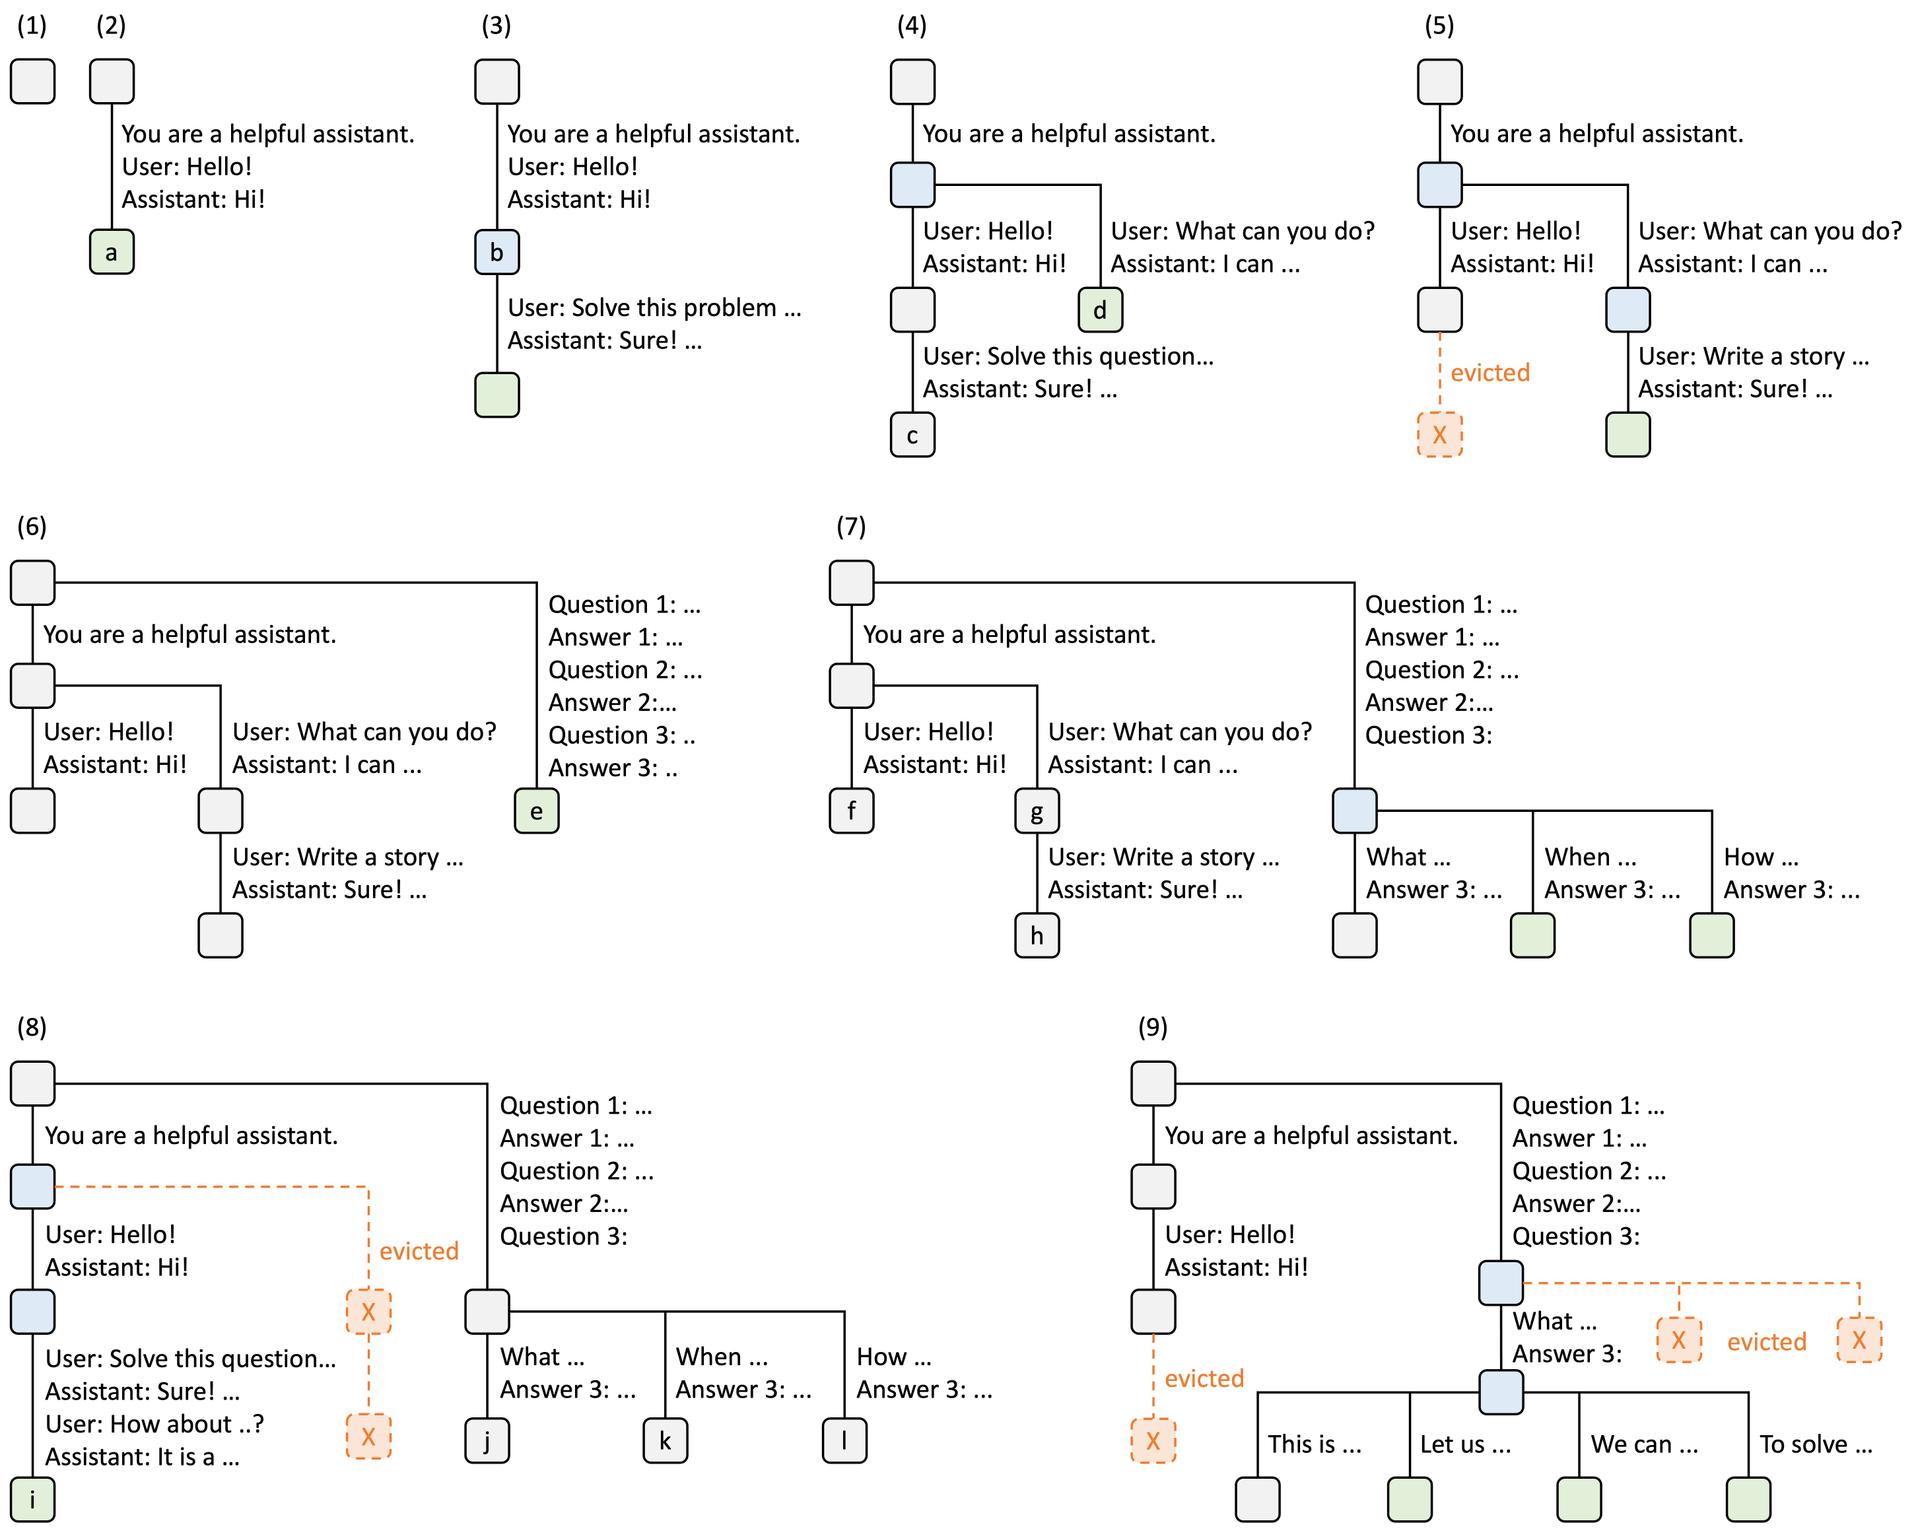
KV 再利用が次の階層です。Paged attention は KV キャッシュの断片化をなくし、実際のバッチサイズを引き上げ (arxiv.org/abs/2309.06180)、基数木によるプレフィックスキャッシングは、共有される履歴を 1 回だけ計算させます (arxiv.org/abs/2312.07104)。キャッシュのエントリはプレフィックスの純関数なので、同じ位置で再利用してもロジットを動かせないため、これは安全です
スケジューリングがその上に乗ります。連続バッチ化は最長のリクエストの完了を待たずトークン境界でバッチを補充し (usenix.org/conference/osdi22/presentation/yu)、チャンク化プリフィルは長いプロンプトが他の全員のデコードを止めるのをやめさせ (arxiv.org/abs/2308.16369)、プリフィル デコード分離は、ワークロードの計算律速の半分と帯域律速の半分を別々のマシンに置きます (arxiv.org/abs/2401.09670)。どれも 1 つのロジットにも触れません
動く境界線
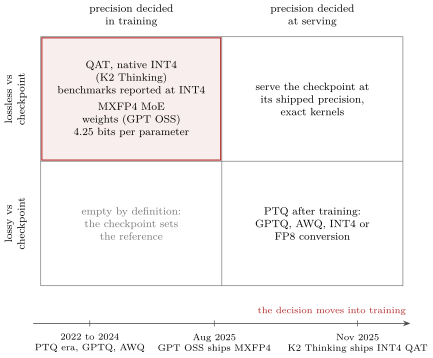
ロスレスの境界は出荷されたチェックポイントで引かれ、そのチェックポイント自体が動いています。Kimi K2 Thinking はネイティブの INT4 ウェイトで出荷されました。Moonshot が学習後に量子化対応学習を実行し、MoE ウェイトを INT4 に置き、すべての公式ベンチマークを INT4 で報告し、約 2 倍の高速な生成を得たからです (huggingface.co/moonshotai/Kimi-K2-Thinking)。OpenAI は gpt-oss をパラメータあたり 4.25 ビットの MXFP4 MoE ウェイトで出荷しました。これはパラメータの 90 パーセント超を覆い、gpt-oss-120b が 80 GB GPU 1 枚に収まる理由です (arxiv.org/abs/2508.10925)
これらのモデルにとって、INT4 や MXFP4 のサービングは劣化する量子化ではなく、それがチェックポイントです。劣化させてはならないリファレンスはすでに低精度で、ベンダーはすでに品質コストを然るべき学習時に支払っています。だから量子化は学習の意思決定へと変わりつつあり、事後的に BF16 チェックポイントを絞ることはサービングハックのままです。私のテストは単純です。提供しているウェイトがベンダーがベンチマークしたウェイトなら、あなたはモデルを提供している。後から絞ったのなら、あなたは自分の編集版を提供している
検証
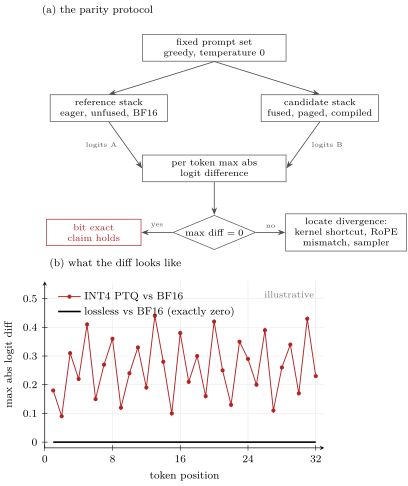
ロスレスはテストできる主張で、私はロジットパリティでテストします。同じプロンプトを貪欲デコーディングでリファレンスのスタックとあなたのスタックの両方に通し、トークンごとの最大絶対ロジット差を比較します。ビット正確の主張にはゼロが合格ラインで、投機デコーディングには分布テストがラインです。これを bonsai-turbo について公開しました。32 個のプロンプトすべてが、4 つのエンジン構成すべてにわたってベンダーフォークに対して合格です (github.com/RightNow-AI/bonsai-turbo)。パリティが失敗するとき、差分はどこを見るべきかを教えてくれます。たいていは、 corners を削った融合カーネル、RoPE の不一致、異なる再正規化をするサンプラーです
Moonshot は今、自社モデルを提供する全員に同じ種類のチェックを実行しています。K2 Vendor Verifier は 4,000 個の同一リクエストをすべてのサードパーティ K2 プロバイダに送り、ツール呼び出しトリガーの F1 とスキーマ精度について公式 API と照合します (github.com/MoonshotAI/K2-Vendor-Verifier)。 spread は本物でした。スキーマ精度は、最良のプロバイダでは 100 パーセントから、修正が届く前の在庫のオープンソースエンジンでは約 73 から 76 パーセントまで幅がありました。モデル品質はサービングスタックの性質になり、モデルベンダーがそれを測り始めました
浮動小数点の加法は結合的でないため、カーネル内のリダクション順序は下位ビットを変え、その順序はバッチサイズとともに変わります。Thinking Machines はその帰結を測定しました。在庫の vLLM での温度ゼロの 1,000 完了は 80 個の異なる出力を与え、バッチ不変カーネルは 1,000 すべてを実行時間の 1.6 倍から 2 倍でビットごとに同一に戻しました (thinkingmachines.ai/blog/defeating-nondeterminism-in-llm-inference/)。Chen et al. も同じ理由で投機デコーディングの証明を "within hardware numerics" と範囲を限定しました (arxiv.org/abs/2302.01318)。つまりロスレスとは、スタックがすでに受け入れた数値の誤差の上に誤差を加えないことであり、バッチ不変性も支払わない限り、バッチサイズをまたいだビットごとの同一出力を意味しません
なぜロスレスが勝つのか
経済学が議論に決着をつけます。量子化は一度だけ固定の係数を節約し、すべてのタスクのすべてのステップで品質を払い続けます。一方ロスレスの勝ちは互いに掛け算で効きます。カーネル × 投機デコーディング × KV 再利用 × スケジューリングで、すべての項がモデルを正確に保ちます。単独の 1 項でも、ロスレスが実際のハードウェアで何をもたらすかを示しています:
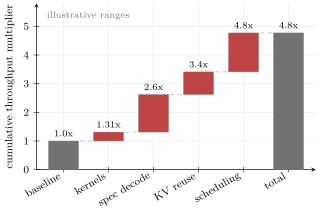
これに取り組み始めた頃、ロスレスが未来になると思っていましたが、今はもっと確信しています。RightNow ではまさにこれを作っています。完全なロスレススタックでオープンモデルを提供し、リファレンスに対するロジットパリティで検証しています