تحسين أنوية GPU لمطوري CUDA: AutoKernel
, 3 دقائق قراءة, By Jaber Jaber
هندسةAutoKernel هي أداة RightNow AI مفتوحة المصدر لتحسين أنوية GPU. يحلل AutoKernel نماذج PyTorch، ويختبر متغيرات Triton، ويتبع الاختناقات المقاسة. يحرر وكيل برمجة نواة واحدة في كل مرة، ويشغل معيار قياس ثابتا، ويبقي كل تغيير أو يتراجع عنه.
ماذا يفعل AutoKernel؟
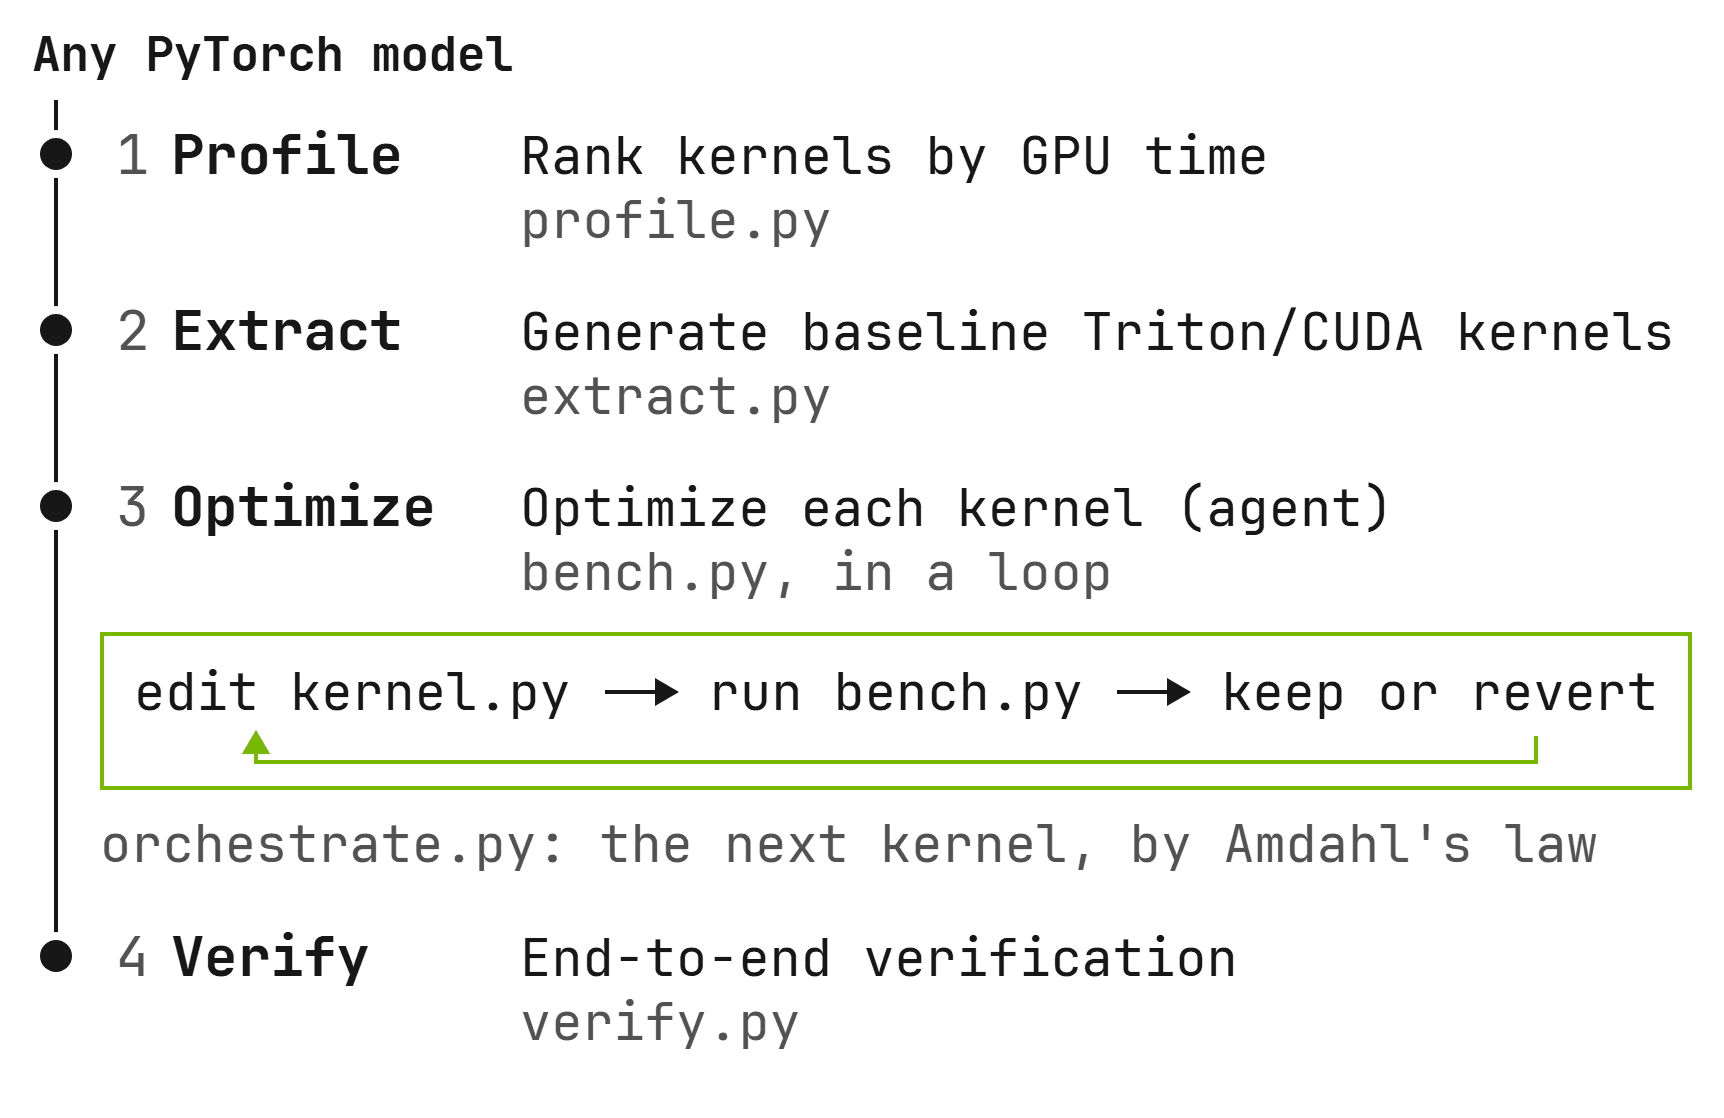
أعط AutoKernel أي نموذج PyTorch. يحلل النموذج ليجد أي أنوية GPU هي الاختناقات. يستخرج كل اختناق نواة مستقلة عبر Triton أو CUDA. يحسّن كل نواة باستقلالية: تحرير، ثم قياس، ثم إبقاء أو تراجع، ثم تكرار. يتحقق من الصحة من الطرف إلى الطرف ويعرض مجمل التسريع.
كيف تعمل الحلقة؟
يقرأ الوكيل program.md، الذي يحمل تعليمات شاملة للعمل المستقل. يتضمن دليل تحسين من ست طبقات، وإطار قرار، ومعالجة للانهيارات، وتفكيرا بقانون Amdahl.
يحرر الوكيل kernel.py نواة واحدة في كل مرة. يشغل bench.py، وهو معيار قياس ثابت بفحوص صحة من خمس مراحل وتحليل roofline، ثم يبقي التغيير أو يتراجع عنه.
يقرر المنسق متى ينتقل إلى النواة التالية بقانون Amdahl. يرتب حسب الأثر وينتقل عند حلول العوائد المتناقصة. لا يلمس الوكيل سوى kernel.py، فيبقى النطاق محكوما، والفروق قابلة للمراجعة، والتراجع نظيفا.
تسجل كل تجربة في ملف results.tsv عادي. يسجل كل صف النواة ونتاجها وزمن استجابتها ونتيجة نجاحها: PASS أو FAIL أو TIMEOUT أو CRASH.
كيف يحافظ على صحة النواة؟
يفحص معيار القياس ناتج النواة مقابل PyTorch قبل قياس الأداء. النواة السريعة الخاطئة يتراجع عنها فورا. مراحل الصحة الخمس هي الدخان، ومسح الأشكال، والاستقرار العددي، والحتمية، والحالات الحدية.
لكل نوع نواة مرجع PyTorch في reference.py. وفي النهاية يعيد verify.py إدخال الأنوية المحسّنة إلى النموذج، ويتحقق من الصحة من الطرف إلى الطرف، ويعرض مجمل التسريع.
كيف تبدأ؟
انسخ المستودع وشغّل uv sync. شغّل uv run prepare.py مرة واحدة لإعداد بيانات الاختبار والخطوط الأساسية. حلل نموذجا عبر profile.py، واستخرج أنوية الاختناق الأعلى عبر extract.py، وتأكد من عمل معيار القياس عبر bench.py.
ثم ابدأ وكيل برمجة داخل الدليل واطلب منه قراءة program.md والبدء بالإعداد. يعرض الوكيل خطة التحسين، وأنشئ فرعا، ويحسّن كل نواة اختناق بترتيب الأولوية. كتب program.md بحيث يستطيع الوكيل العمل 10 ساعات أو أكثر دون أن يعلق.
تحتاج إعداد CUDA؟ طالع الدليل الكامل لإصلاح مشكلات تثبيت CUDA.
أين البحث الذي خلفه؟
RightNow AI مختبر أبحاث GPU مدعوم من YC. الورقة هي AutoKernel: Autonomous GPU Kernel Optimization via Iterative Agent-Driven Search، بقلم Jaber Jaber و Osama Jaber، 2026. هي على arXiv برقم 2603.21331، وشفرة الورقة هي مستودع AutoKernel.
ورقة المختبر AutoMegaKernel، بعنوان A Statically-Checked Agent Harness for Self-Retargeting Megakernel Synthesis، على arXiv برقم 2606.09682. طالع مختبر أبحاث RightNow لكل ورقة ومشروع مفتوح المصدر.
أجوبة قصيرة
هل AutoKernel مفتوح المصدر؟
نعم. ترخيصه MIT، والشفرة في github.com/RightNow-AI/autokernel.
أي النماذج يمكنه تحليلها؟
أي نموذج PyTorch: يحلله profile.py عبر torch.profiler، ويرتب الأنوية بزمن GPU ويصنف كل نواة مقيدة بالحساب أو مقيدة بالذاكرة. تأتي معه تعريفات نماذج مكتفية بذاتها، بلا حاجة إلى مكتبة transformers.
أي الأنوية يغطيها؟
تشمل أنويته المدعومة matmul و softmax و layernorm و rmsnorm و flash_attention و fused_mlp و cross_entropy و rotary_embedding و reduce.
أكتب في Triton أم في CUDA؟
كلاهما. Triton للتكرار السريع، و CUDA يمنح الوصول المباشر إلى أنوية tensors. يشترك الواجهان الخلفيان في الواجهة kernel_fn() نفسها.
أي GPU يحتاج؟
GPU من NVIDIA، مع Python 3.10 أو أحدث و uv.