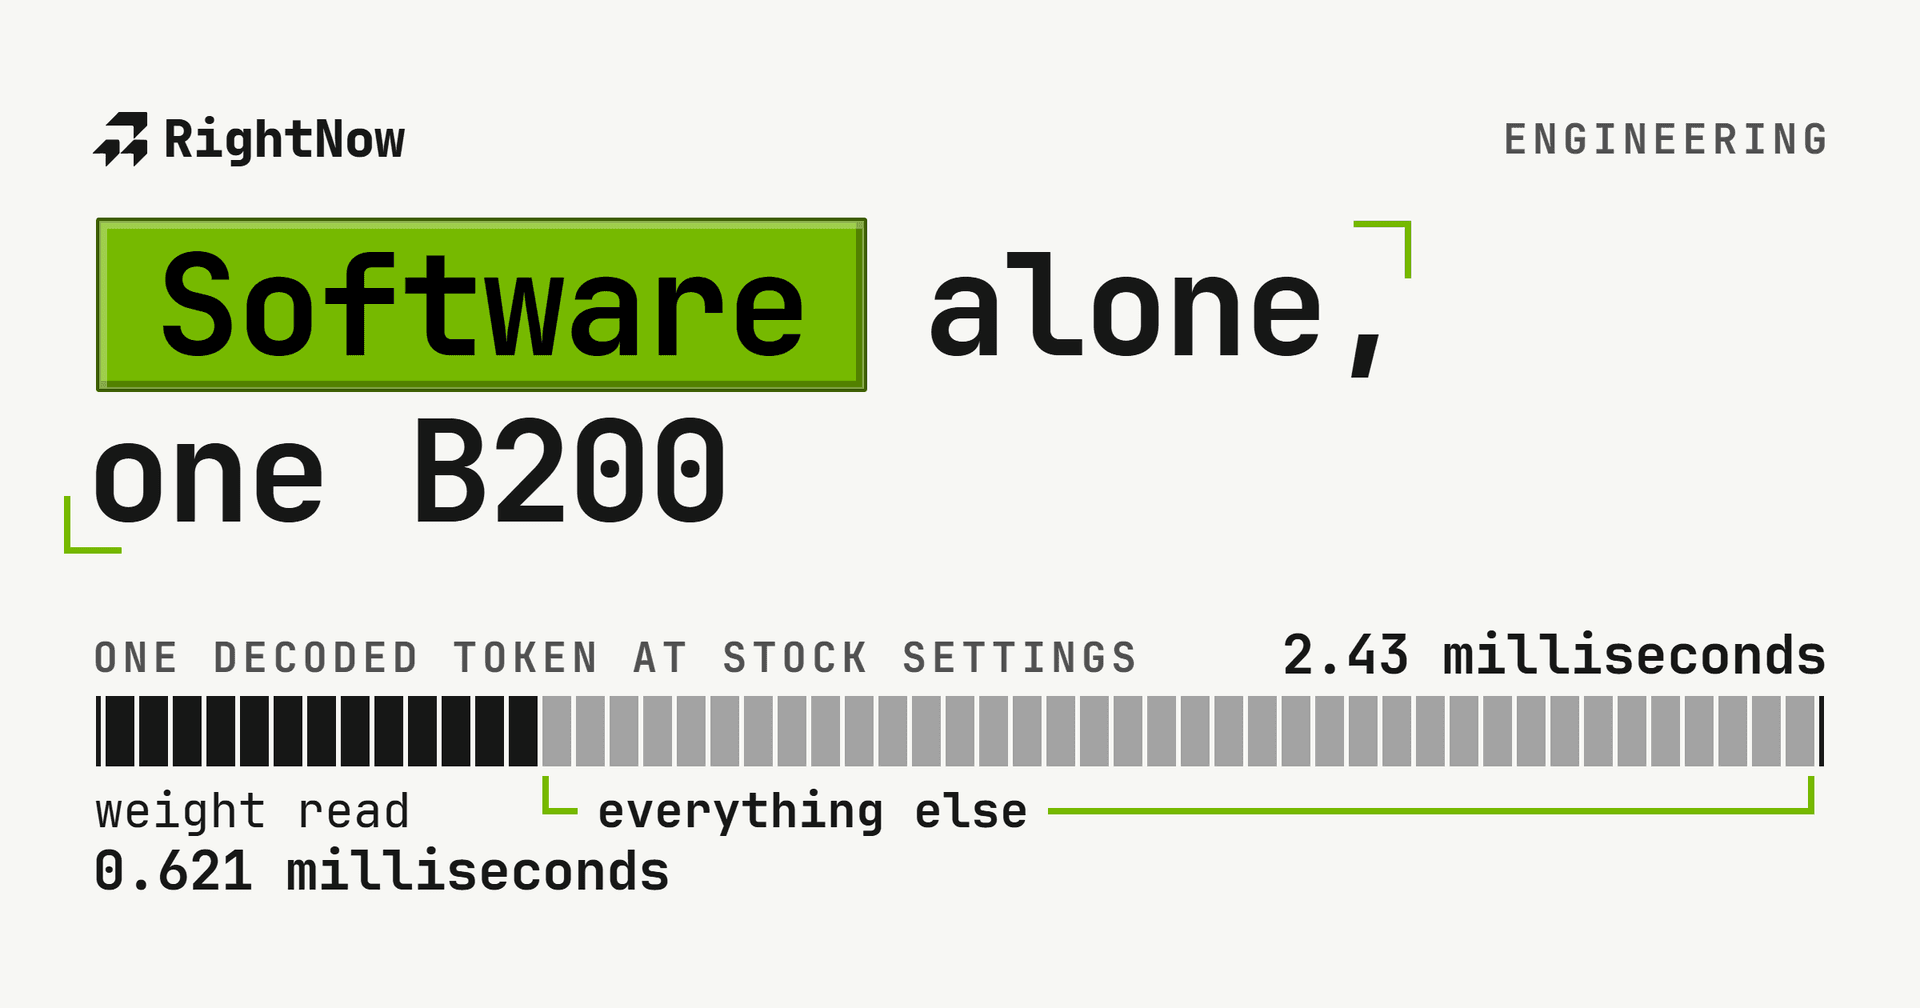
بالبرمجيات وحدها، B200 واحدة تتفوق على LPU وتقترب من Cerebras
, 16 دقيقة قراءة, By Jaber Jaber
هندسةملاحظة تحريرية: نشر هذا المقال أولا على موقعنا السابق. منتج التحسين الموصوف هنا تقاعد. يقدم RightNow النماذج المفتوحة عبر API الخاص به.
تصحيح، 9 أغسطس 2026
غيرت Artificial Analysis وسيطات المزودين بعد نشر هذا المقال في 6 أغسطس. في 6 أغسطس كانت نقاط المقارنة المستخدمة هنا تقرأ Cerebras 1,991 tok/s، و SambaNova 708، و Groq 476، و Google Vertex 423، و Databricks 324، و Azure 300، و Amazon 101، و CoreWeave 33. وفي 9 أغسطس يقرأ المصدر Cerebras 1,891، و SambaNova 706، و Groq 477، و Google Vertex 391، و Azure 312، و Baseten 195، و Amazon 86، و CoreWeave 36؛ ولا سرعة مبلغة ل Databricks في الرسم الحالي. النص والجداول أدناه تستخدم قيم 9 أغسطس. وتبقى صور الرسم الأصلية ل 6 أغسطس ظاهرة كلقطات منشورة مؤرخة.
في كل سنة الآن يشحن شخص سيليكون جديدا مبنيا للاستدلال. وضعت Cerebras الأوزان على رقاقة كاملة، وبنت Groq ال LPU، وبنت SambaNova ال RDU، وجميعها آلات حقيقية تحرك الرموز بسرعة. يعجبني أن هذا يحدث. الاستدلال يستحق أن تصمم له عتادا.
أمضيت السنتين الأخيرتين في دراسة معمارية GPUs من NVIDIA و AMD لبناء محرر أكواد لأنوية GPU. قراءة تلك الأدلة طوال النهار تعلمك ما تستطيع البطاقة فعله، ثم تنظر إلى ما يحصل عليه الناس من البطاقة نفسها فلا يتطابق الرقمان. فتوقفت عن محاولة كتابة كل نواة بيدي وبدأت ببناء وكلاء يكتبونها. جعلت AutoKernel مفتوح المصدر، وهو يولد أنوية GPU ويضبطها، صغيرة ومقروءة فتستطيع فعلا متابعة ما يفعل. ثم AutoMegaKernel، الذي يدمج خطوة فك تشفير كاملة في أنوية ثابتة كي لا تغادر الوسطيات الرقاقة أبدا. كل ذلك لأجل شيء واحد: أن تعمل النماذج كما ينبغي على البطاقات التي يملكها الناس أصلا.
لهذا تزعجني لوحات المتصدرين. حين قرأت اللوحة 423 رمز GPU في الثانية في 6 أغسطس لنموذج يمكنني حساب ميزانية بايتاته على الورق، لم تكن فكرتي الأولى أن ال GPU بطيء. كانت فكرتي الأولى أن أحدا لم يكتب البرمجيات. فقررت أن أختبر إن كنت أستطيع ردم تلك الفجوة على B200 واحدة من دون لمس شيء سوى البرمجيات.
حتى 9 أغسطس، تسرد Artificial Analysis ل Cerebras 1,891 رمزا في الثانية. أسرع مزود GPU مدرج هو Google Vertex عند 391، ثم Azure عند 312 و Baseten عند 195. وهذا يضع Cerebras متقدما ب 4.8x على أسرع GPU مدرج، قريبا من تقدم ال 5x في مقارنة Cerebras المنشورة (cerebras.ai/blog/blackwell-vs-cerebras).
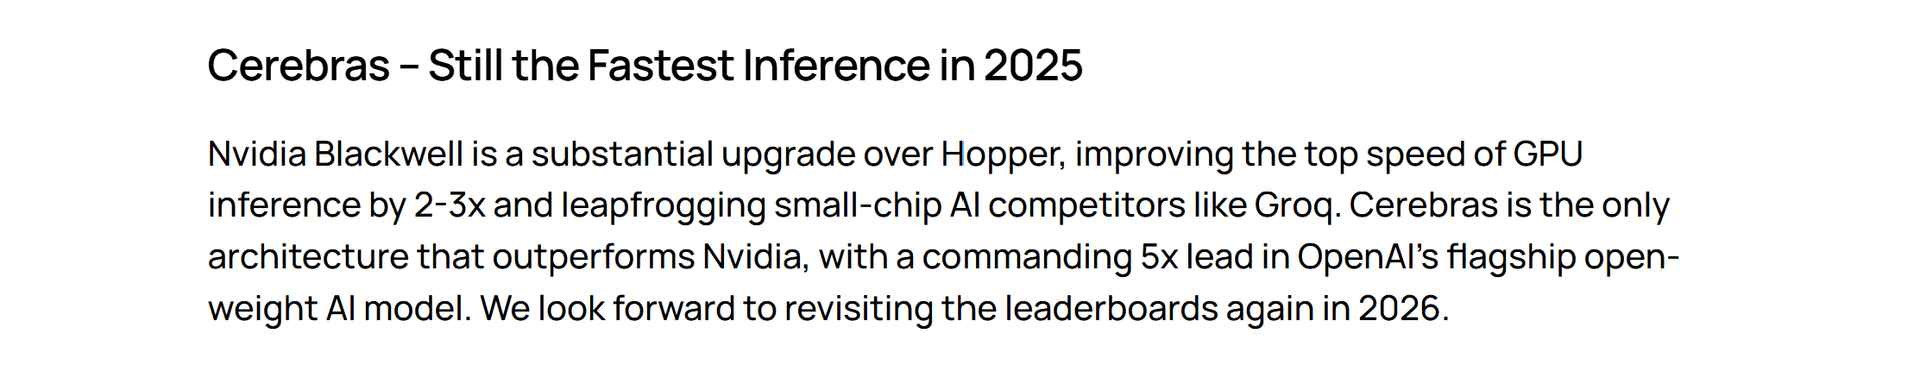
ال 1,891 جواب عتادي وجواب جيد. يبقون الأوزان في SRAM بدلا من HBM، فالاختناق الذي نحاربه نحن الباقين غير موجود على آلتهم. لن أجادل في ذلك ولم أهزمه.
قرأت اللوحة 423 حين أجريت المقارنة وتقرأ 391 حتى 9 أغسطس. نقطة الإحالة ال GPU تلك هي الرقم الذي طاردته. استأجرت B200 واحدة على Modal، وهو ما ألجأ إليه حين أريد GPU من دون تفكير، وبدأت القياس. من الصندوق حصلت على 411 رمزا في الثانية. غيرت أربعة إعدادات فأعطتني البطاقة نفسها بالأوزان نفسها 1,366، وبلغت المطالبات المفردة 2,215. لم أكتب نواة ولم أعيد تجميع أي شيء.
| Metric | Value | Detail |
|---|---|---|
| Stock SGLang | 411 tok/s | 26 في المئة من عرض نطاق ذاكرة هذه البطاقة |
| After four settings | 1,366 tok/s | 72 في المئة، و 3.5x أسرع مزود GPU |
| Best single prompt | 2,215 tok/s | فوق Cerebras، على بطاقة واحدة قابلة للاستئجار |
هذا يخطي أسرع مزود GPU على اللوحة الحالية ب 3.5x. يتجاوز Groq عند 477 و SambaNova عند 706، ويضع بطاقة مستأجرة واحدة عند 72 في المئة من الرقاقة الكاملة.
التجريد يكذب عليك، وهو لا يكذب على العتاد
كل طبقة بينك وبين الرقاقة موجودة لكي تمنعك من التفكير في الرقاقة، وهي تنجح. تنادي generate فتخرج الرموز بنسبة ما، وتشبه تلك النسبة سرعة الآلة. وليست كذلك. إنها سرعة الافتراضات التي صادفت نداءك.
لهذا يلوم الناس العتاد حين يكون شيء ما بطيئا، ولهذا يكونون مخطئين دائما تقريبا. لا يستطيع إطار العمل أن يخبرك أنه هو الشيء الذي يعطلك. لا يرمي أي خطأ، وكل شيء يبدو سليما، والرقم الذي يعطيك ثابت قابل للتكرار، فيشبه الفيزياء بينما هو ملف تهيئة.
المخرج الوحيد هو أن تحسب بنفسك ما تستطيع البطاقة فعله، من البايتات وعرض النطاق، ثم تقارن. ذلك الرقم لا يبالي بإطار العمل الذي تستخدمه.
ل gpt-oss-120b على B200 الحساب قصير. فك تشفير رمز واحد يقرأ كل وزن نشط مرة واحدة بالضبط، أي 1.91 GB من الانتباه ب bf16، و 1.90 GB من خبراء top-4 الموجهة ب mxfp4، و 1.16 GB من lm_head ب bf16، فتكون 4.97 GB لكل رمز. لدى B200 عرض نطاق 8 TB/s من HBM3e (nvidia.com/en-us/data-center/dgx-b200)، فالحضيض 0.621 ألف ثانية لكل رمز والسقف نحو 1,610 رموزا في الثانية.
أخذ SGLang الاعتيادي 2.43 ألف ثانية لكل رمز. أربعة وسبعون في المئة من كل رمز لم تكن قراءة أوزان.
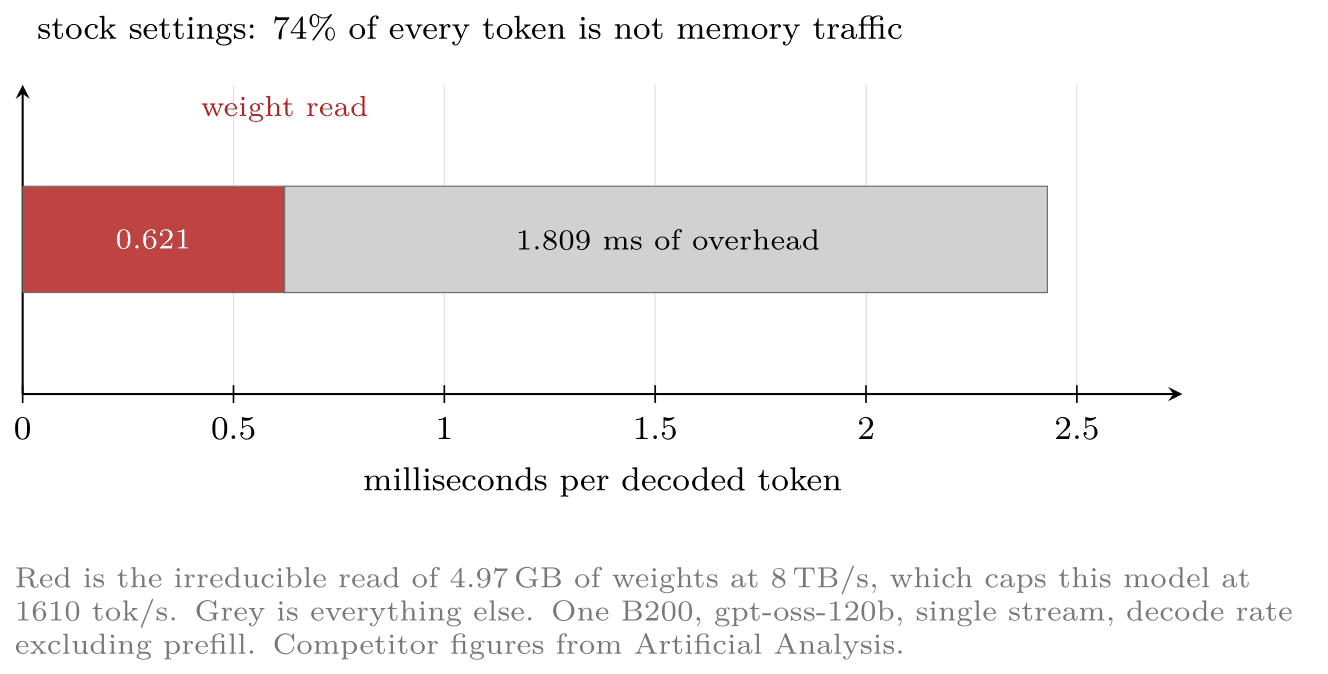
جلست الرقاقة خاملة ثلاثة أرباع الوقت. وكل غريزة تقول اشتر البطاقة الأسرع موجهة إلى ال 26 في المئة التي كانت تعمل أصلا.
ما قسته، وكيف
أجريت كل شيء على B200 واحدة على Modal بذاكرة HBM3e سعة 178.4 GiB و 148 SMs. النموذج openai/gpt-oss-120b، الذي يشحن أصلا ب MXFP4 وينشط نحو 5.1B من معامله البالغة 120B لكل رمز. الخدمة عبر SGLang 0.5.16، جشع عند درجة حرارة صفر، تيار مفرد، مطالبة واحدة في كل مرة، أربع مطالبات ثابتة، ثلاث تكرارات، الوسيط.
الرقم المبلغ هو معدل فك التشفير باستثناء prefill، وهو كيف تعرف Artificial Analysis سرعة الناتج، أي متوسط عدد الرموز المستلمة في الثانية بعد استلام الرمز الأول (artificialanalysis.ai/methodology). اخترت هذا النموذج لأن مزودي ASIC الثلاثة ينشرون عليه، فتكون المقارنة بالأوزان نفسها والمقياس نفسه.
| Provider | tok/s | Silicon |
|---|---|---|
| Cerebras | 1,891 | wafer |
| SambaNova | 706 | RDU |
| Groq | 477 | LPU |
| Google Vertex | 391 | GPU |
| Azure | 312 | GPU |
| Baseten | 195 | GPU |
| Amazon | 86 | GPU |
| CoreWeave | 36 | GPU |
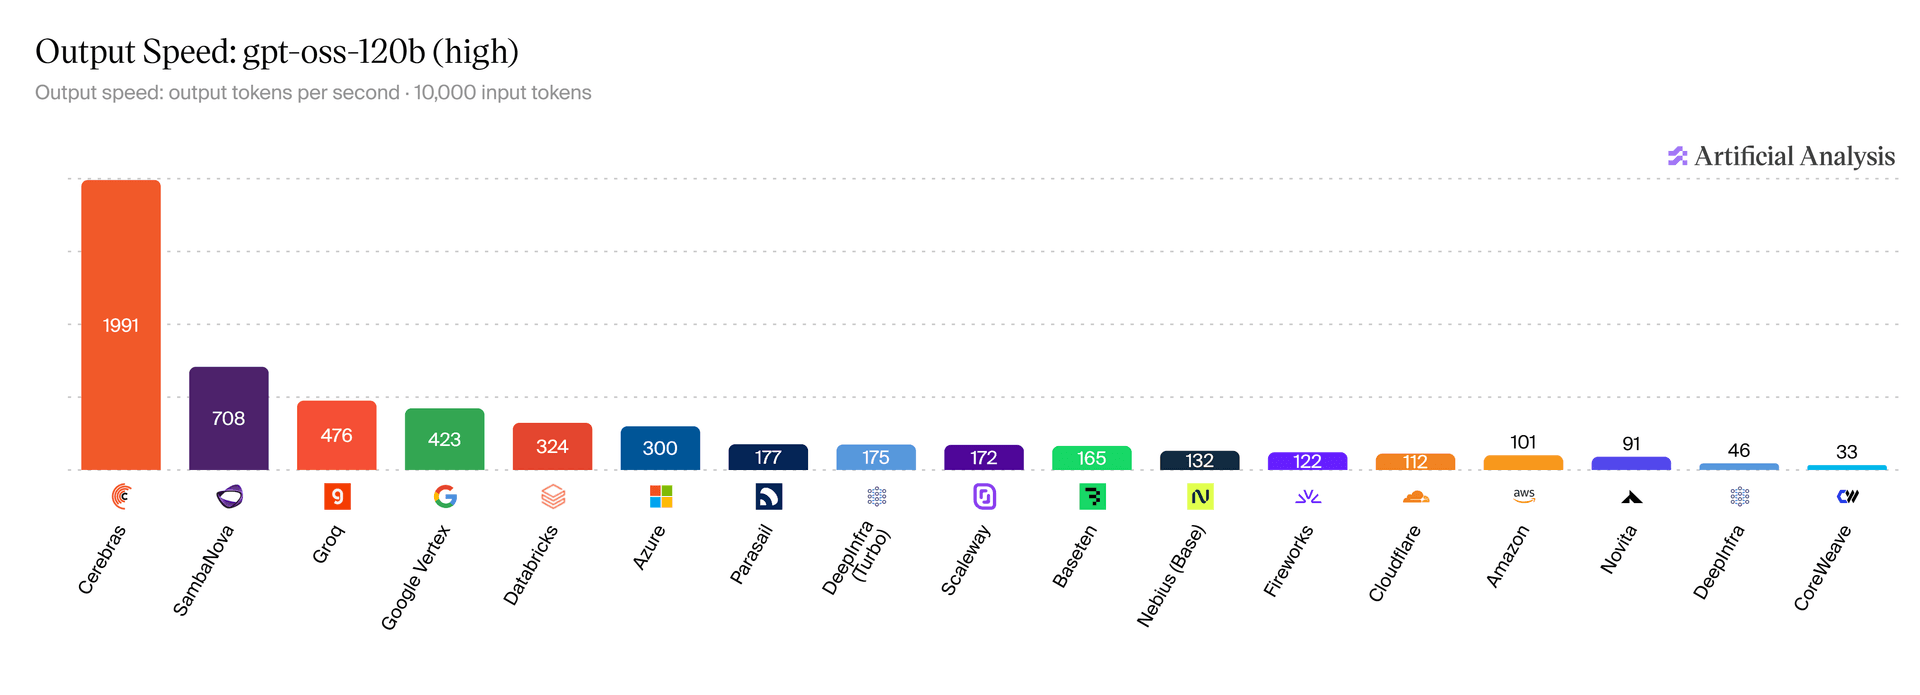
انظر إلى إدراجات GPU المقاسة على اللوحة الحالية. تتباعد ب 10.8x، من Google Vertex عند 391 نزولا إلى CoreWeave عند 36، على الأوزان المفتوحة والمقياس نفسيهما. لا يعزل الرسم العام جيل GPU عن الإعدادات أو الأنوية أو شفرة serving، فهذا دليل على أن المنصة المسلمة تهم، لا تقدير نظم بمقدار 10.8x للبرمجيات وحدها.
السلم
| Step | tok/s |
|---|---|
| stock defaults | 411.2 |
| latency knobs | 429.9 |
| n-gram speculative decoding | 628.5 |
| speculative_attention_mode=decode | 697.1 |
| wide n-gram search | 1,165.1 and 1,366.2 |
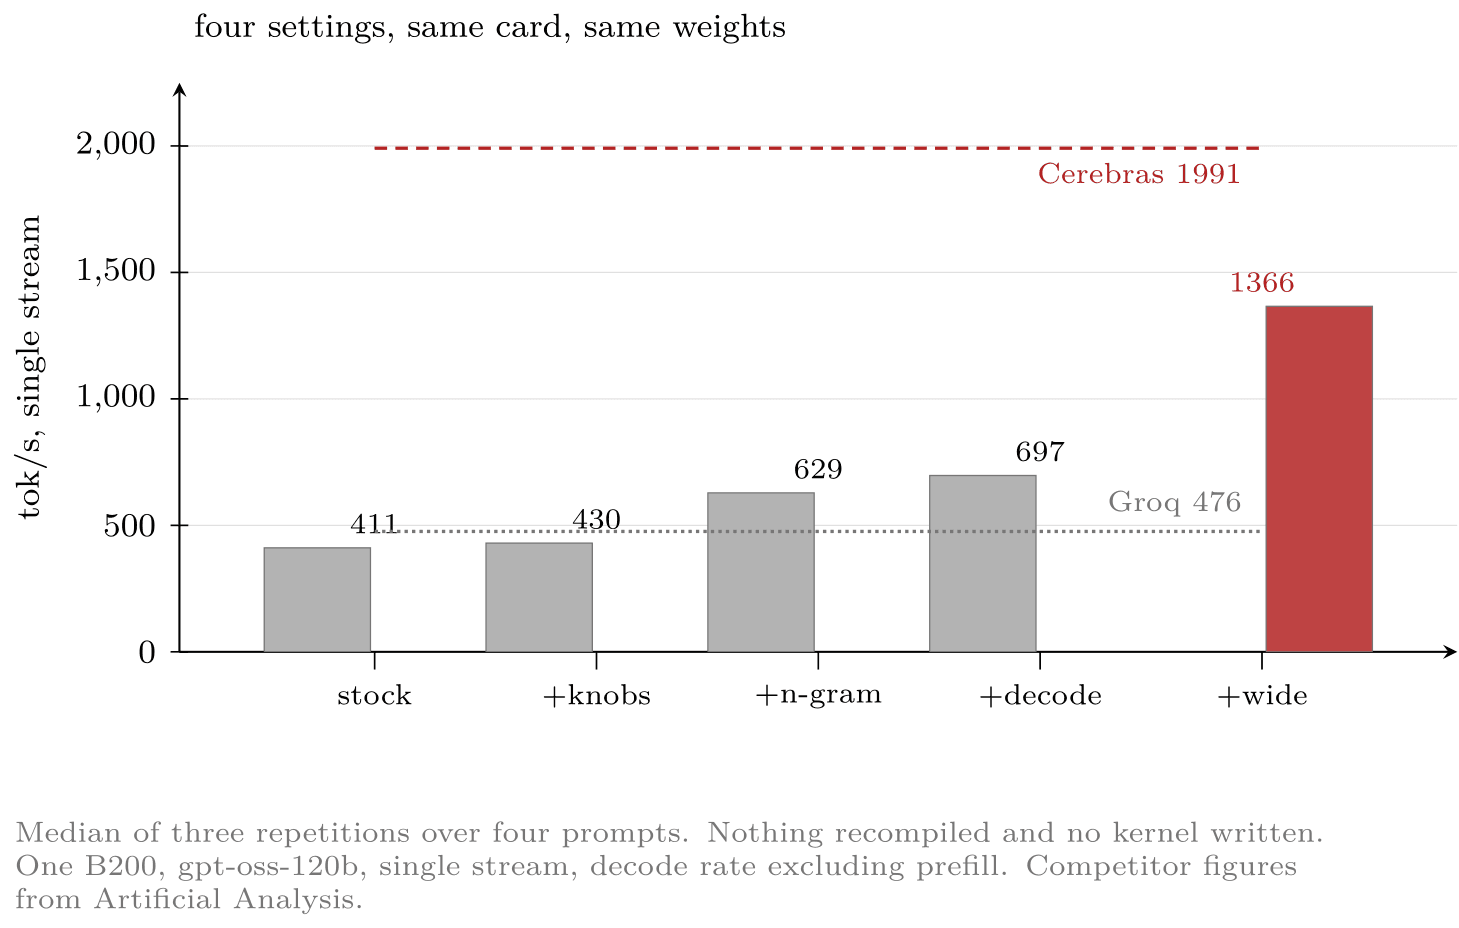
الدرجة الأولى صغيرة. يضع SGLang افتراضيا stream_interval عند 1، فيفك الرموز ويرسلها عند كل رمز مفرد، و scheduler_recv_interval عند 1، فيستطلع في كل تكرار. على ميزانية 0.621 ألف ثانية هذا مال حقيقي، وإصلاحه اشترى 4.5 في المئة.
الدرجة الثانية هي فك التشفير التخميني، الحيلة نفسها التي أعطت Groq ست ضعوفها. مسودة تقترح عدة رموز، والهدف يتحقق منها في تمريرة أمامية واحدة، وكل رمز مقبول هو رمز أنتج من دون قراءة أوزان منفصلة ب 4.97 GB. لم أستطع استخدام رأس مسودة مدرّب، لأسباب في قسم الإخفاقات، فهذا تخمين n-gram، الذي يصوغ المسودات بمطابقة الأنماط في النص المولد حتى الآن.
الدرجة الثالثة كانت علما لم ألمسه قط. افتراضي speculative_attention_mode هو prefill، وضبطه على decode أعطى 9.7 في المئة.
الصف الأخير رقمان لأنني شغلت تلك التهيئة مرتين وحصلت عليهما معا، تباعد 17 في المئة على إعدادات متطابقة. قبول n-gram يعتمد على ما بناه ال trie، فتضع التهيئة نفسها في مكان مختلف في كل تشغيلة. لو نقلت الرقم الأفضل لكنت أختار رقما لا أقيسه.
الدرجة التي كانت الأهم وُجدت بكسرها
قيل لي، على وجه معقول، أن مقترح n-gram على ال CPU يتسلسل مع ال GPU وأن كلفة بحثه هي الاختناق. فقلصته، max_bfs_breadth من 10 إلى 2 و max_trie_depth من 18 إلى 8، متوقعا هبوط الحمل الزائد.
انهارت الإنتاجية إلى 433.0.
كان الإخفاق أثمن من مكسب صغير
يقول إن البحث ليس حملا زائدا، بل هو الشيء الذي يكسب الرموز. كل مرشح إضافي يستكشفه المقترح فرصة لقبول رمز آخر، وكل رمز مقبول يتجاوز قراءة كاملة ب 4.97 GB. إنفاق بضع مئات من ميكروثواني CPU لتفادي 0.621 ألف ثانية من حركة HBM مقايضة تريد إجراءها باستمرار.
فشغلت الزر في الاتجاه الآخر، وللمنحنى قمة حادة.
| max_bfs_breadth | tok/s |
|---|---|
| 2 | 433.0 |
| 10, the default | 697.1 |
| 24 | 1,165.1 |
| 32 | 1,110.4 |
| 48 | 341.1 |
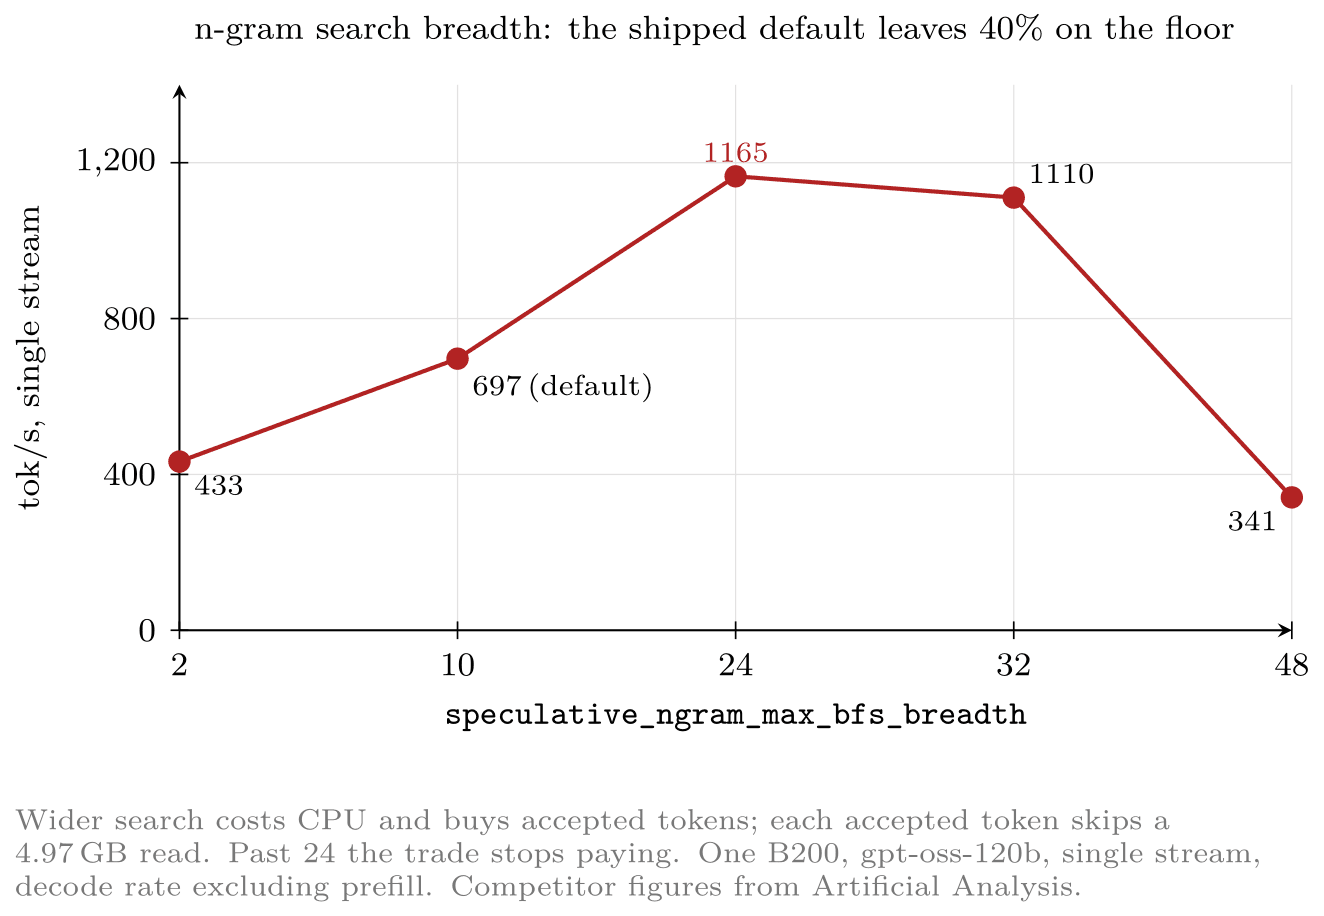
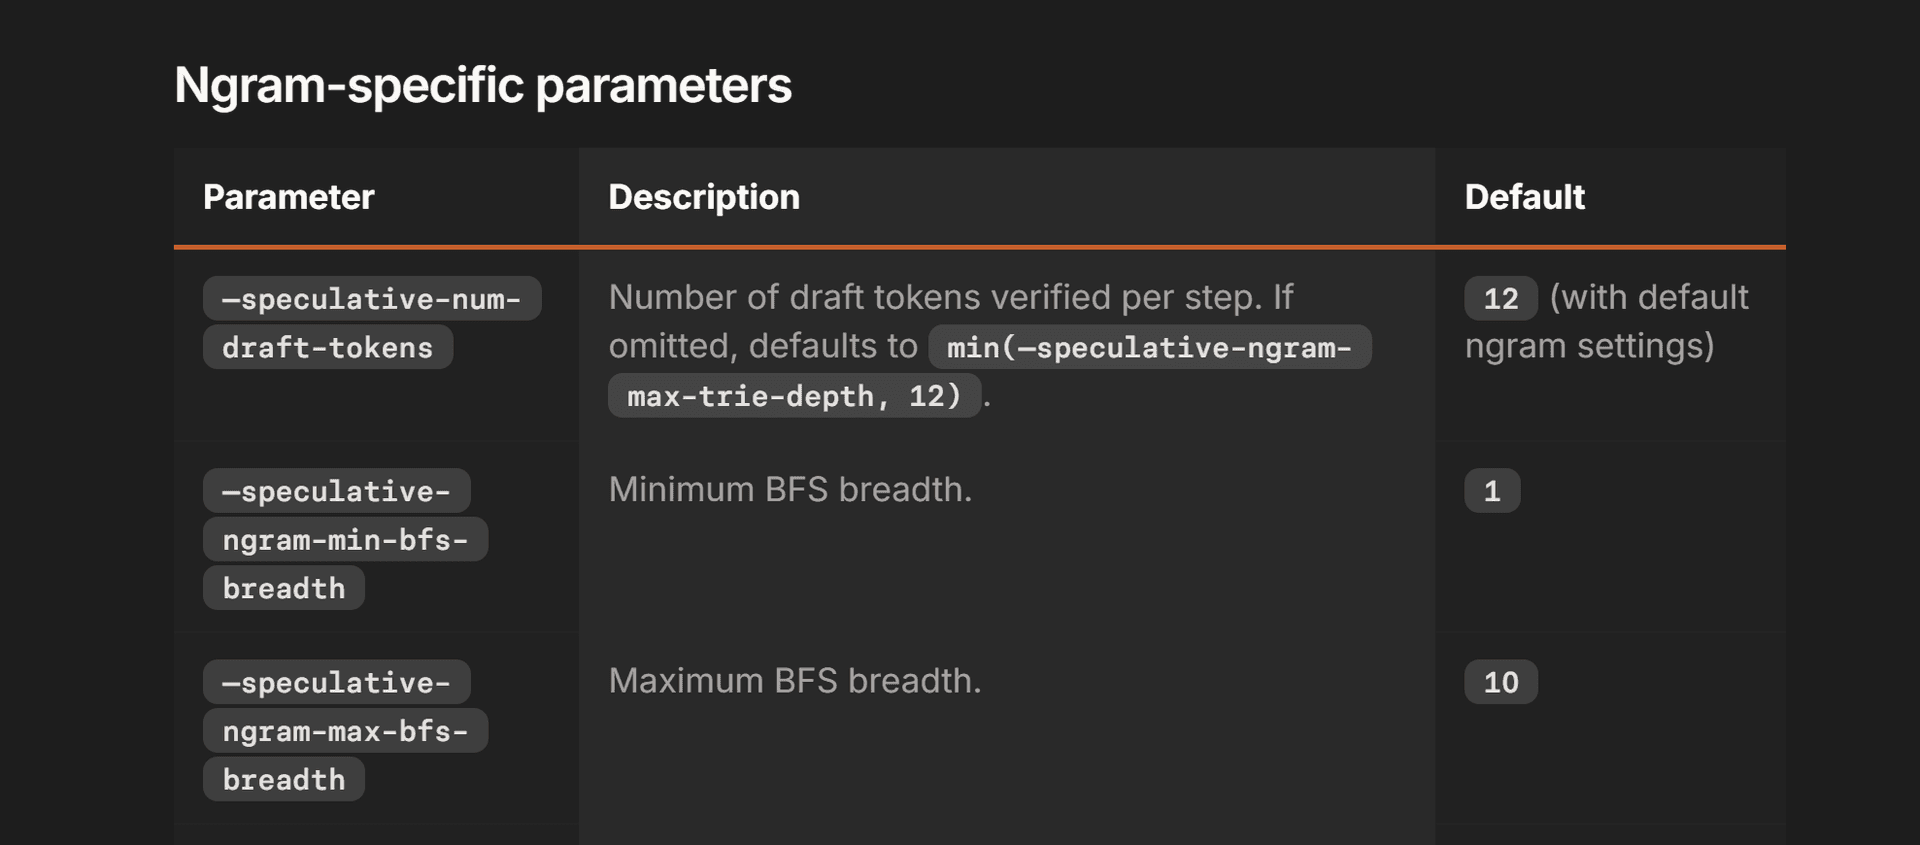
الافتراضي المشحون هو 10، وتستطيع قراءته مباشرة من الوثائق.
لفك تشفير التيار المفرد يترك ذلك نحو 40 في المئة على الأرض، وبعد 24 يتوقف بحث CPU عن تمويل نفسه ويسقط من حافة. الافتراضي ليس خطأ. إنه موضوع ل serving عبر الإنتاجية، حيث تشارك طلبات كثيرة ال GPU ويكون وقت CPU ضيقا. إنه الافتراضي الخاطئ لمستخدم واحد ينتظر تيارا واحدا، ولا شيء في المنصة يخبرك أي الاثنين أنت فيه.
أين يهبط ذلك
| Provider | tok/s | Ratio |
|---|---|---|
| one B200, two runs | 1,165.1 to 1,366.2 | |
| Groq | 477 | أسرع ب 2.44x إلى 2.87x |
| SambaNova | 706 | أسرع ب 1.65x إلى 1.94x |
| Cerebras | 1,891 | 0.62x إلى 0.72x |
لكل مطالبة، قاست التشغيلتان 447.8 و 1930.8 و 1882.5 و 219.1 ثم 525.3 و 2207.0 و 2215.6 و 291.9 رمزا في الثانية. ثلاث من قراءاتها الثماني فوق وسيط Cerebras الحالي عند 1,891، على GPU واحدة قابلة للاستئجار.
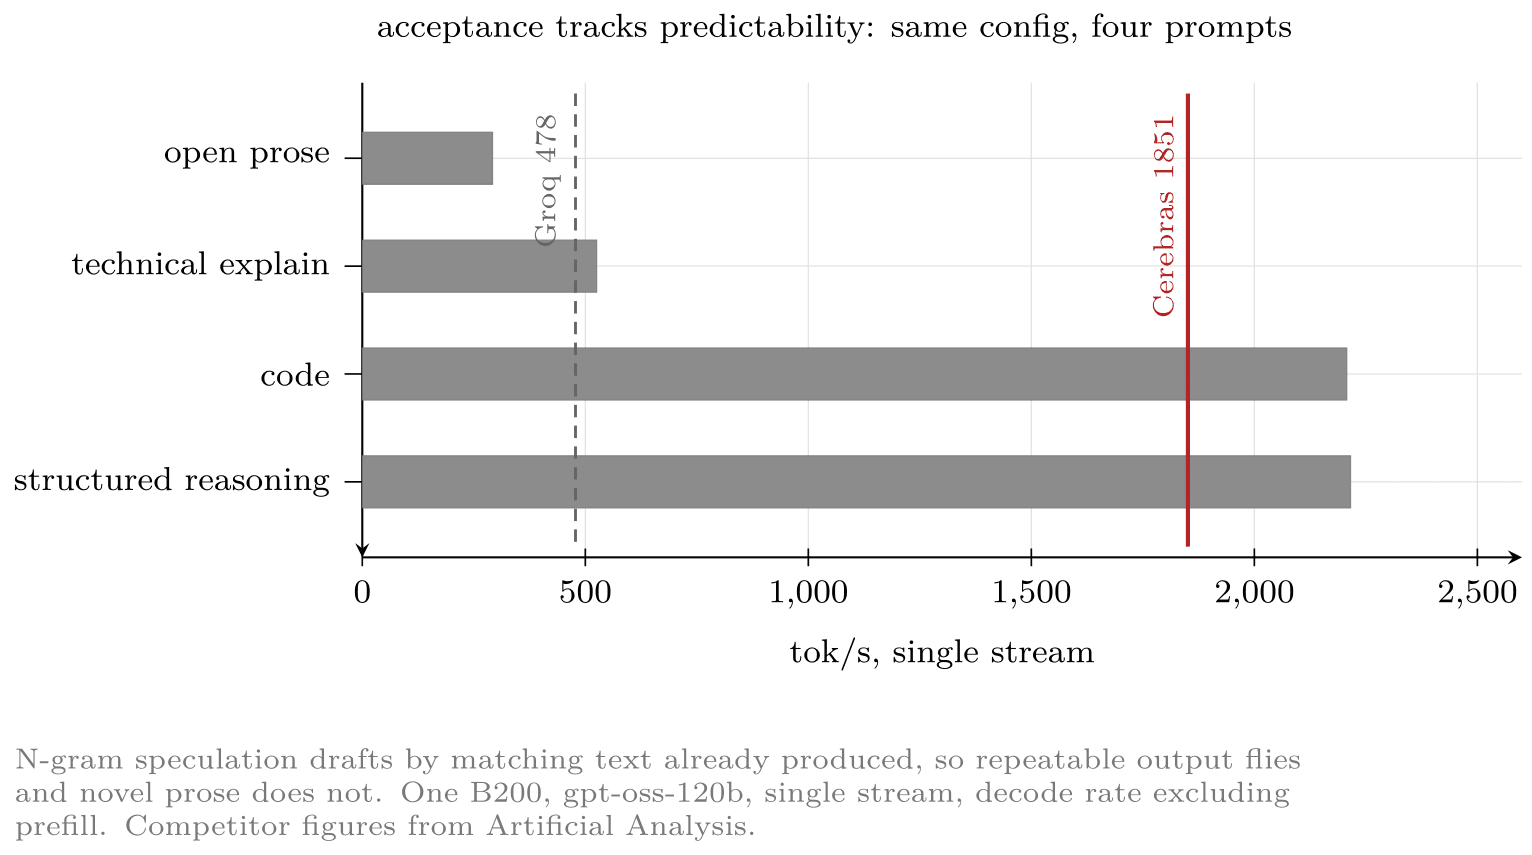
ذلك التباعد هو أنفع شيء في المقال، فأعرضه بدلا من الاختباء خلف وسيط. تخمين n-gram يصوغ مسوداته بمطابقة نص أنتجه أصلا، فالاستدلال المنظم حيث تتكرر الصياغة يركض فوق 2,200 بينما النثر المفتوح الذي لا يتكرر يركض عند 219. الحيلة تربح بقدر قابلية تنبؤ الناتج بالضبط. المورد الذي يبلغ رقما واحدا يعاير على خليط مطالباته هو، ولا ترى هذا الشكل إطلاقا.
ما يغيره التخمين وما لا يغيره
التحقق الجشع هو ما يبقي هذا أمينا. لا يقبل رمز مسودة إلا حيث يطابق الرمز الذي كان سينتجه النموذج الهدف بنفسه، وعند أول عدم تطابق يرمى بقية المسودة ويؤخذ رمز الهدف بدلا منها. فالتخمين تحت تحقق جشع تام لا تقريبي. يغير كم تمريرة أمامية تنفق، لا أي رموز تخرج.
إن ذهبت لتتحقق من هذا بنفسك
مقارنة تشغيلة تخمينية بتشغيلة غير تخمينية مهيأة بشكل مختلف لا تختبر التخمين، بل تختبر الأنوية. تغيير خلفية الانتباه يغير ترتيب اختزالات الفاصلة العائمة، وحيثما يكاد logits يتساويان يقلب ذلك الترتيب ال argmax. يجب أن يثبّت ضابطك كل إعداد آخر ويقلب التخمين وحده. وقارن معرفات الرموز لا النصوص أبدا، مع فحص طول صريح لا zip، الذي يقتطع إلى الجانب الأقصر وسيبلغ عن تشغيلة ماتت في منتصفها أنها متطابقة تماما. أعرف لأنني كتبت ذلك الخطأ في وقت سابق من هذا المشروع ونجح نواة كانت قد انهارت.
ما لم يعمل، وهو معظمه
خمس عشرة تهيئة، والإخفاقات تخبرك أكثر من الانتصارات.
سجل رأسا EAGLE-3 المنشوران كلاهما أقل من التشغيل بلا تخمين إطلاقا، 417.6 لرأس NVIDIA و 325.0 لرأس فريق SGLang، لأن القبول كان قرب الصفر. دربت NVIDIA رأسها على checkpoint ال NVFP4 عندها وهذا هو checkpoint ال MXFP4، والمسودة التي لا تصيب أبدا تكلفك تمريرة المسودة بلا مقابل.
إنجاح تحميل رأس NVIDIA أصلا يستحق التسجيل. فشل بعدم توافق tensor، 8640 مقابل 5760، وهي ثلاثة أمثال الحجم الخفي ضد اثنين. تخطط SGLang v0.5.16 طبقات الالتقاط المطلوبة للمسودة بخطأ إزاحة واحد، فتقع آخر ثلاث طبقات مطلوبة خارج الحلقة، والنسخة نفسها تسقط صامتة وزن input_norm من ال checkpoint لأنها لا تبني تلك الوحدة أصلا. أصلح الأمران أعلى الشجرة في ال commit 5df193b4ac، المدموج بعد ستة أيام من وسم v0.5.16. نسخة ليلية بالإصلاح حمّلته، وما زالت خسرت.
كل خلفيات الانتباه عدا triton غير متاحة هنا. يتطلب FlashAttention 3 من SM 80 إلى 90 و B200 هي SM100. وتفرض FA4 حجم صفحة 128 وتفرض trtllm_mha 64، ثم يرفض SGLang تشغيل شجرة تخمينية أعرض من رمز واحد على خلفية مصلبة لأنها تنتج نتائج خاطئة. سعدت بضرب ذلك الحاجز بدلا من الحصول على أجوبة خاطئة بهدوء. مشغل MoE بال triton يفيض الذاكرة عند 156 GiB لأنه يفك تكيم MXFP4 عائدا إلى bf16. ويفشل torch.compile ب assert ثم يفيض على المسار نفسه. و DFLASH بمسودة حقيقية بلغ 493.5، أفضل من لا شيء وأسوأ من n-gram.
التحفظات الأمينة
هم يخدمون حركة حقيقية على نقاط نهاية إنتاجية وأنا شغلت أربع مطالبات ثابتة على صندوق مستأجر واحد، فليست هذه مواجهة نظيفة ولن أدعي أنها كذلك. كما تغذي Artificial Analysis 10,000 رمز مدخل ومطالباتي نحو ثلاثين، والمطالبة الأطول تعني مخزن KV أكثر يقرأ في كل خطوة، فهم يقومون بالعمل الأصعب. ذلك يساعد رقمي، فأنقص منه قليلا حين تقارن.
رقاقة كاملة تحفظ الأوزان في SRAM ميزة معمارية حقيقية في هذه المشكلة وليست تسويقا. Cerebras سريعة لأن الذاكرة داخل الرقاقة تزيل الاختناق الذي كنت أصفه، ولا كمية من عمل الأنوية تحول HBM إلى SRAM. ولا يزال وسيطها يتفوق على رقمي.
بطاقة تستأجرها بالساعة تشغل أوزانا تستطيع تنزيلها تبلغ 1,165 إلى 1,366 رمزا في الثانية بعد أربعة إعدادات، وهذا يتفوق على اثنين من الرقاقات الثلاث المخصصة. السكربتات في المستودع وكذلك JSON الخام لكل مطالبة، فاذهب وانظر التباعد بنفسك بدلا من تصديقي.
لماذا أبني ما أبنيه
بلغت التهيئة الاعتيادية 26 في المئة من عرض نطاق ذاكرة هذه الآلة. ورفعتها أربعة إعدادات إلى 72 في المئة. لم يستبدل أحد العتاد، وكان ال 2.8x جالسا داخل تجريد لم يبلغ عن أي خطأ طوال الوقت.
أنا صغير وجديد على الأنوية ولست أفضل شخص في العالم في كتابتها. ما أجيده هو بناء وكلاء يكتبونها، وأظنها المهارة الأنفع. القادرون على ضبط نواة بأيديهم نادرون ولا يتوسعون، وكل نموذج جديد على كل بطاقة جديدة يحتاج العمل من جديد. عمل الأنوية هو حيث يأتي أداء العقد القادم، لا المصنع التالي. خرج محرر الأكواد من سنتيّ قراءة أدلة المعمارية، وقد توقفت عن دعمه. ثم جاء AutoKernel و AutoMegaKernel، وكلاهما موجود ليفعل بالآلة ما فعلته بيدي في هذا المقال. كل ذلك عن جعل النماذج تعمل على البطاقات التي يملكها الناس، لا التي في البيانات الصحفية.
بنيت محسنا كي لا تضطر لفعل أي من هذا بيدك. تصوبه على أي نموذج على Hugging Face وعلى أي بطاقات تملكها أصلا. يحسب سقفك، ويكتب الأنوية التي تردم الفجوة ويضبطها، ويتحقق من تطابق الناتج تماما قبل أن يشحن أي شيء. العمل الذي فعلته هنا بيدي يفعله هو وحده.
ترتيب العمليات مهم والصناعة تظل تعكسه. قبل تصميم معمارية مختلفة يجب أن نعصر ما هو في الرفوف أصلا، لأن معظم ذلك السيليكون يعمل عند جزء مما يستطيع فعله والجزء الناقص شفرة لم يكتبها أحد. تصنيع رقاقة لحل مشكلة لم تحلها أولا في البرمجيات يعني دفع ثمانية عشر شهرا وجولة تصنيع مقابل شيء قد يناولك إياه علم تهيئة في الأسبوع نفسه، والأعلام التي غيرتها هنا كانت تساوي 3.3x.
لا أنزع من Cerebras شيئا. حفظ الأوزان في SRAM يقتل الاختناق نفسه الذي كنت أصفه بالضبط، وهذا إصلاح حقيقي لمشكلة حقيقية، وما زالوا متقدمين علي. لكن كثيرا مما يشبه فجوة عتاد على لوحة متصدرين هو برمجيات لم يكتبها أحد بعد، ولا تكتشف ذلك إلا بحساب السقف بنفسك وملاحظة أنك عند 26 في المئة منه.
ما يسميه الناس تصميم العتاد هو في معظمه ترجمة أصلا. النموذج رسم للعمليات والرقاقة مجموعة وحدات تنفيذ ومستويات ذاكرة. والانتقال من أحدهما إلى الآخر مسألة مصرّف وأنوية من طرف إلى طرف. أنت تقرر ما يندمج، وما يبقى في المسجلات، وما ينسكب إلى HBM، وأي ترتيب حلقات تريد أنوية tensors. طبقة الترجمة تلك هي حيث تسكن الأداء، وهي برمجيات، وهي الطبقة نفسها سواء أكان السيليكون تحتها من NVIDIA أو AMD أو شيئا صُنع العام الماضي.
لهذا لا أظن شيئا من هذا دائما، وأوضح حالة هي AMD. السيليكون جيد وعرض النطاق موجود. الفجوة إلى NVIDIA على العمل الحقيقي هي المنصة لا الترانزستورات. إن كانت البرمجيات هي الحصة الأكبر فالفجوة قابلة للردم بكتابة برمجيات، وهو موقع أفضل كثيرا من الاحتياج إلى مصنع جديد. نوسع وكلاءنا إلى AMD تاليا، لأن الاختبار المثير ليس جعل رقاقة سريعة أسرع، بل بلوغ أرقام فئة NVIDIA على عتاد حكم الناس عليه بالكتابة عليه.
وليس شركات الرقاقات وحدها. وضعت OpenAI و Broadcom في يونيو رقاقة استدلال تدعى Jalapeno، وأكدت Anthropic فريق سيليكون داخليا في أغسطس، وكلاهما يتحدث عن خفض تكلفة الرمز إلى النصف تقريبا (openai.com/index/openai-broadcom-jalapeno-inference-chip). من أفضل شركتي برمجيات في العالم قررتا أن الموضع التالي للإنفاق هو طبقة العتاد.
أقرأ ذلك على غير ما يقرؤه معظم الناس. إن كنت تسترد نصف تكلفة استدلالك بتصنيع رقاقة، فجزء مما تشتريه حقا هو الكفاءة التي لم تنلها أصلا من ال GPUs التي تملكها أصلا. لا أظن ذلك نقدا لهما، إنه ال 26 في المئة نفسها التي قستها في هذا المقال، جالسة عند مقياس يستحق عنده إصلاحها جولة تصنيع.
ما أنا أقل تأكدا منه هو ما يحدث تاليا. CUDA هي سبب سهولة بلوغ 72 في المئة على B200، و CUDA هي ثمانية عشر عاما من المصرّفات والمكتبات والأنوية ومحللات الأداء وناس يعرفون أين دفنت الأجسام. تلك هي الخندق، لا الترانزستورات. الرقاقة الجديدة تبدأ من الصفر في كل ذلك. قد تكون تصميما أفضل وتخسر رغم ذلك، لأن ما يقرر كم من رقاقة تستطيع فعلا استخدامه هو البرمجيات حولها، وبناؤها يستغرق سنوات.
فالسؤال الذي كنت سأسأله عن أي رقاقة مخصصة ليس كم هو سريع السيليكون. بل هل تواكب البرمجيات. هل سيبقى سريعا على النموذج الذي تتحول إليه الربع القادم، وعلى حيلة لم يخترعها أحد بعد، وعلى شكل لم يكتب المصرّف لها أصلا. ال GPU يجيب عن كل ذلك بإعادة تجميع.
الرقاقات المخصصة للاستدلال رهان على أن حمل عمل واحد يبقى ساكنا طويلا بما يكفي لخبزه في السيليكون. لم يكن فك التشفير التخميني بصورته الحالية موجودا قبل ثلاث سنوات والحيلة التالية غير موجودة بعد أيضا. وحين تصل، سيشحنها من هم على عتاد قابل للبرمجة بمصرّف ناضج في أسابيع. ومن خبزوها في رقاقة لن يفعلوا.
أذكر حين انتقلت من نداء دوال PyTorch إلى كتابة الأنوية تحتها، ظننت أنني أنزل مستوى واحدا للأداء، وأنا أكثر يقينا الآن أنني كنت أنزل مستوى واحدا للسيطرة، لأن الأداء هو ما تناله حين تكف عن قبول ما قررته الافتراضات نيابة عنك.
فحين يسألني الناس لماذا أواصل العمل على هذا بدلا من شيء عرضه أجمل، فهذا هو الجواب. العتاد سيبقى جيدا. الجزء الذي يقرر إن كنت سترى شيئا منه هو البرمجيات، والآن بالكاد يكتبها أحد. ذلك هو القطعة التي تهم، وهي القطعة التي أريد أن يستطيع أي أحد الوصول إليها.