تحسين أنوية Inkling 2 Small على NVIDIA B300
, 11 دقيقة قراءة, By Jaber Jaber
بحثRightNow AI مختبر أبحاث GPU مدعوم من YC. حسّنا أنوية Inkling 2 Small، نموذج مزيج الخبراء البالغ 594B معامل من Thinking Machines، على 8 GPUs من NVIDIA B300. جميع الأنوية والاختبارات والإعدادات والنتائج مفتوحة المصدر في github.com/RightNow-AI/inkling-b300-kernels.
درّبت Thinking Machines هذا النموذج في NVFP4 عبر التدريب المسبق والتدريب الأوسط والتدريب اللاحق، وتصفه بطاقة النموذج لديها بأنه "الدقة الأصلية للنموذج". نشغّل تلك الأرقام كما دُرّبت: خبراء NVFP4 في الطبقات 0 إلى 39 على أنوية tensors ذات المقياس الكتلي في FP4 على Blackwell، وخبراء MXFP8 في الطبقات 40 إلى 47 على أنوية FP8 ذات المقياس الكتلي في Blackwell.
| مقيسة على GPUs من B300، 2026-11-21 | النتيجة |
|---|---|
| ال logits نفسها، 64 صفا في كل خطوة مقابل صف واحد في كل خطوة، النموذج الكامل على 8 GPUs | لا يختلف أي صف من 599، بتاً ببت |
| فرق لوغاريتم احتمال الرمز التالي عن vLLM، النموذج نفسه و GPUs نفسها | 0.025 nats في المتوسط، و 0.13 عند p95 |
| GEMM خبراء w13، GPU واحد، رمز واحد، أعيد بناؤه مقابل نواتنا الأولى | أسرع 5.1x على NVFP4، و 7.5x على MXFP8، بالبتات نفسها |
| مجموعات اختبار الأنوية على B300 واحدة، بمحاكاة 8 ranks | تنجح 10 من 10 |
كل نواة هنا كتبها محرك أنوية الذكاء الاصطناعي لدينا: وكلاء برمجة يكتبون CUDA، ويشغّلون أداة الاختبار لدينا، ويُبقون كل تغيير أو يتراجعون عنه. ولم تُبقَ نواة إلا بعد اجتيازها بواباتها.
لماذا يحتاج هذا إلى CUDA
يخزّن NVFP4 قيم E2M1 من 4 بتات مع مقياس E4M3 لكل كتلة من 16 قيمة. وتقرأ أنوية tensors في Blackwell تلك المقاييس مباشرة: تعليمة tcgen05.mma واحدة، kind::mxf4nvf4.block_scale.block16، تضرب بايتات النموذج نفسه.
ولا تفعل ذلك MI350X و MI355X من AMD. وبكلام AMD نفسها، دعمها لحساب FP4 محصور في MXFP4، وكتله بعرض 32 ومقاييسه من قوى الاثنين، لذا يجب أولا تحويل checkpoint NVFP4 إلى MXFP4 لاستخدام ذلك المسار. أما على Blackwell فيعمل النموذج بالأرقام التي دُرّب بها.
البتات نفسها عند صف واحد أو 64 صفا
معظم محركات الاستدلال قريبة لا مطابقة. تعتمد نتيجة الرمز على ما يشاركه خطوته، لأن الدفعة تغير طريقة تقسيم المجاميع، وجمع الفاصلة العائمة غير تجميعي.
سمّت Thinking Machines الإصلاح ثبات الدفعة: ألا تعتمد نتيجة الصف على الدفعة إطلاقا. ونحافظ على هذا الثبات عبر أنوية tensors ذات المقياس الكتلي في NVFP4 و MXFP8، وخبراء موزعين على 8 GPUs، وكل تبادل بينها.
لكل اختزال شكل ثابت. تجري المجاميع في أجزاء ثابتة وأشجار متوازنة، وتُطوى المجاميع عبر GPUs بترتيب ال rank في FP32، ويوقف البناء الدمج التلقائي، فكل ضرب وجمع مدمج هو عملية كتبناها عن قصد.
لكل خاصية توأم مكسور. تقترن كل خاصية لتطابق البتات بنسخة مكسورة عمدا يجب أن تُلتقط. وحيث لا يستطيع الكسر تحريك البتات، كإعادة ترتيب مجاميع دقيقة، يقول السجل ذلك بدلا من احتسابه.
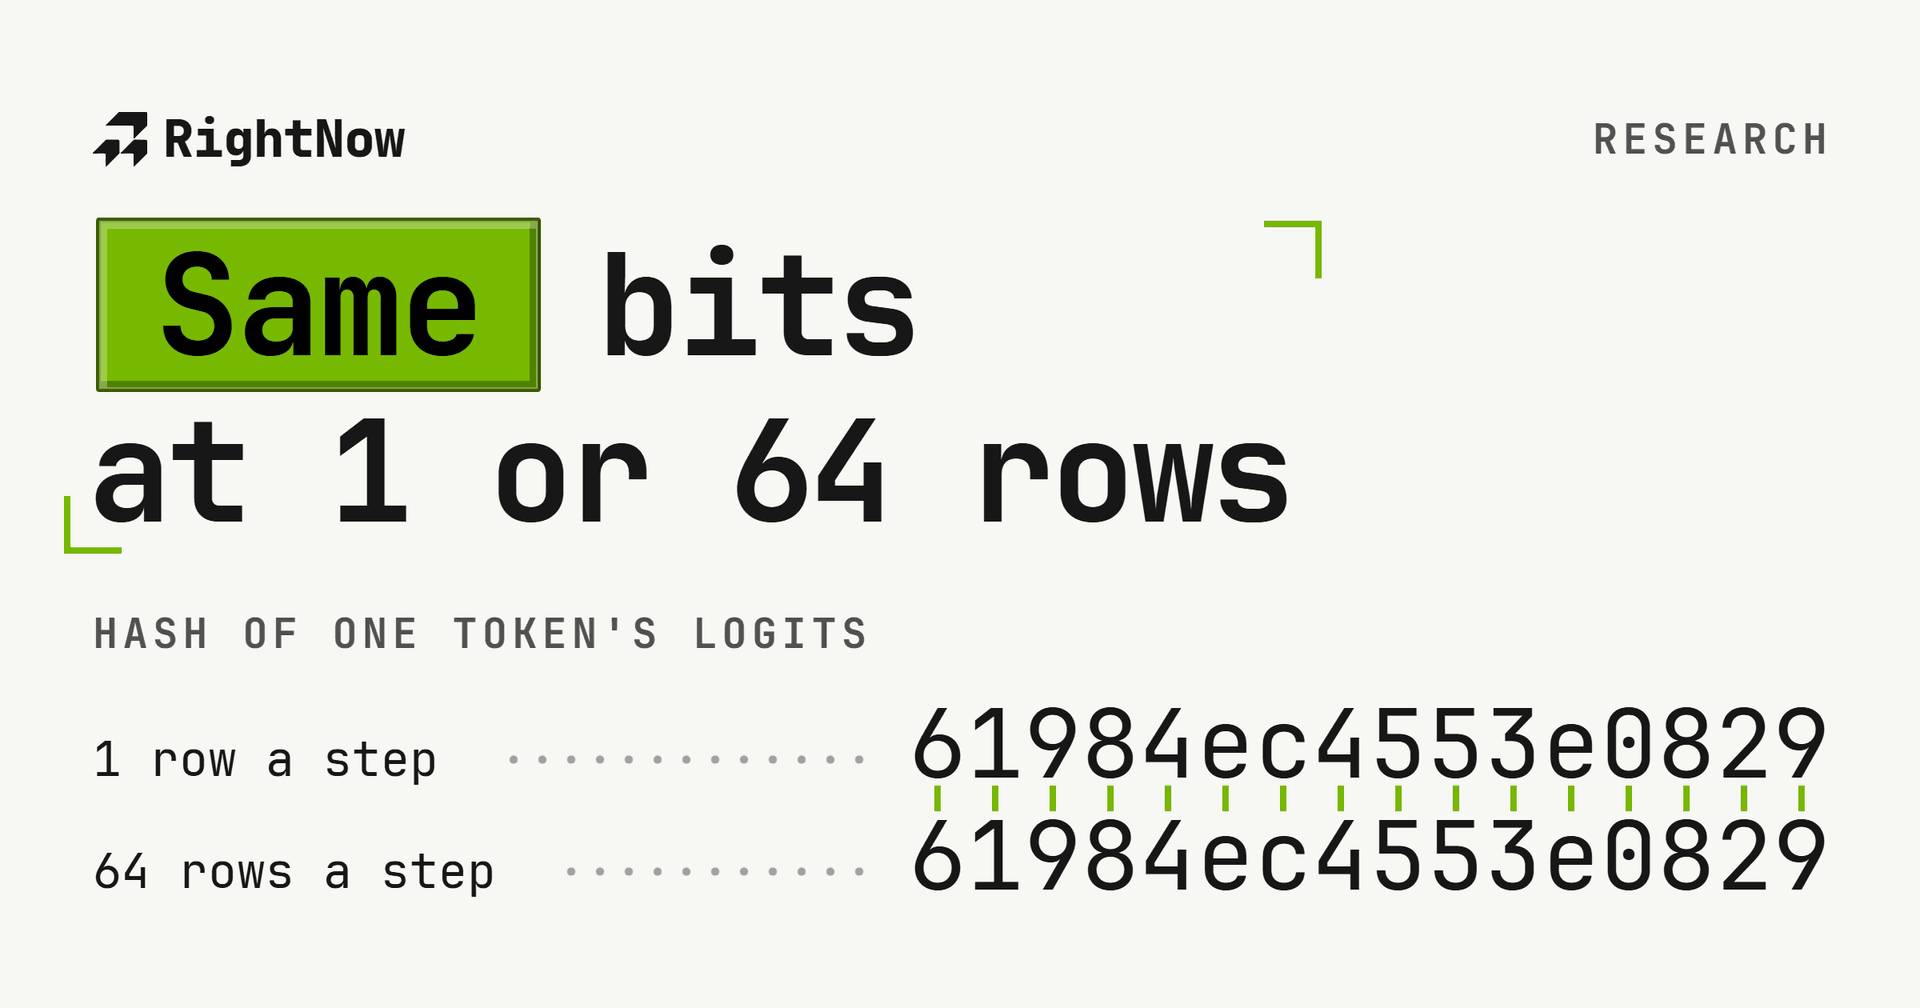
الإثبات يجري على النموذج الحقيقي. إطعام كل مطالبة 64 موضعا في كل خطوة ثم موضعا واحدا في كل خطوة يعطي logits متطابقة على كل الصفوف ال 599 التي قارناها. كل خلية أدناه صف واحد: مرّر المؤشر فوقها أو تنقل بينها بمفتاح Tab لترى بصمتي التجزئة.
Logit hash per row, 64 rows against 1 row per step
599 of 599same bits
essay143 of 143 same
code152 of 152 same
math157 of 157 same
explain147 of 147 same
essay, row 0same bits
- 64 rows a step
- 61984ec4553e0829
- 1 row a step
- 61984ec4553e0829
كل مجموع مجزأ في GEMMs الخبراء لدينا ينتهي في هذه الشجرة المتوازنة؛ كل جمع صريح بالتقريب إلى الأقرب لا يدمجه المترجم أبدا في ضرب وجمع، والتبديل في الأعلى هو التوأم المكسور الذي يجب أن تلتقطه اختباراتنا.
النواة 1: خبراء NVFP4 موزعون على GPUs، بتطابق تام
تُكمَّم تنشيطات خبراء NVFP4 وقت التشغيل بمقياس FP32 لكل رمز، محسوبا من القيمة العظمى على الصف كله. وتقول وصفة SGLang لهذا النموذج إن خبراء NVFP4 لا يمكن تجزئتهم على TP، "لأن مقاييس تنشيطهم يجب أن تغطي عرض الإدخال الكامل لكل خبير"، فتشغلهم المحركات بتوازي الخبراء، خبراء كاملون لكل GPU.
جزّأناهم رغم ذلك: ثُمن أعمدة كل خبير لكل GPU، وتبادل للقيمة العظمى للصف. ولا تعتمد القيمة العظمى على ترتيب أخذها، فالتبادل تام، ويطابق المكمّم قاعدة four over six في المرجع بتاً ببت.
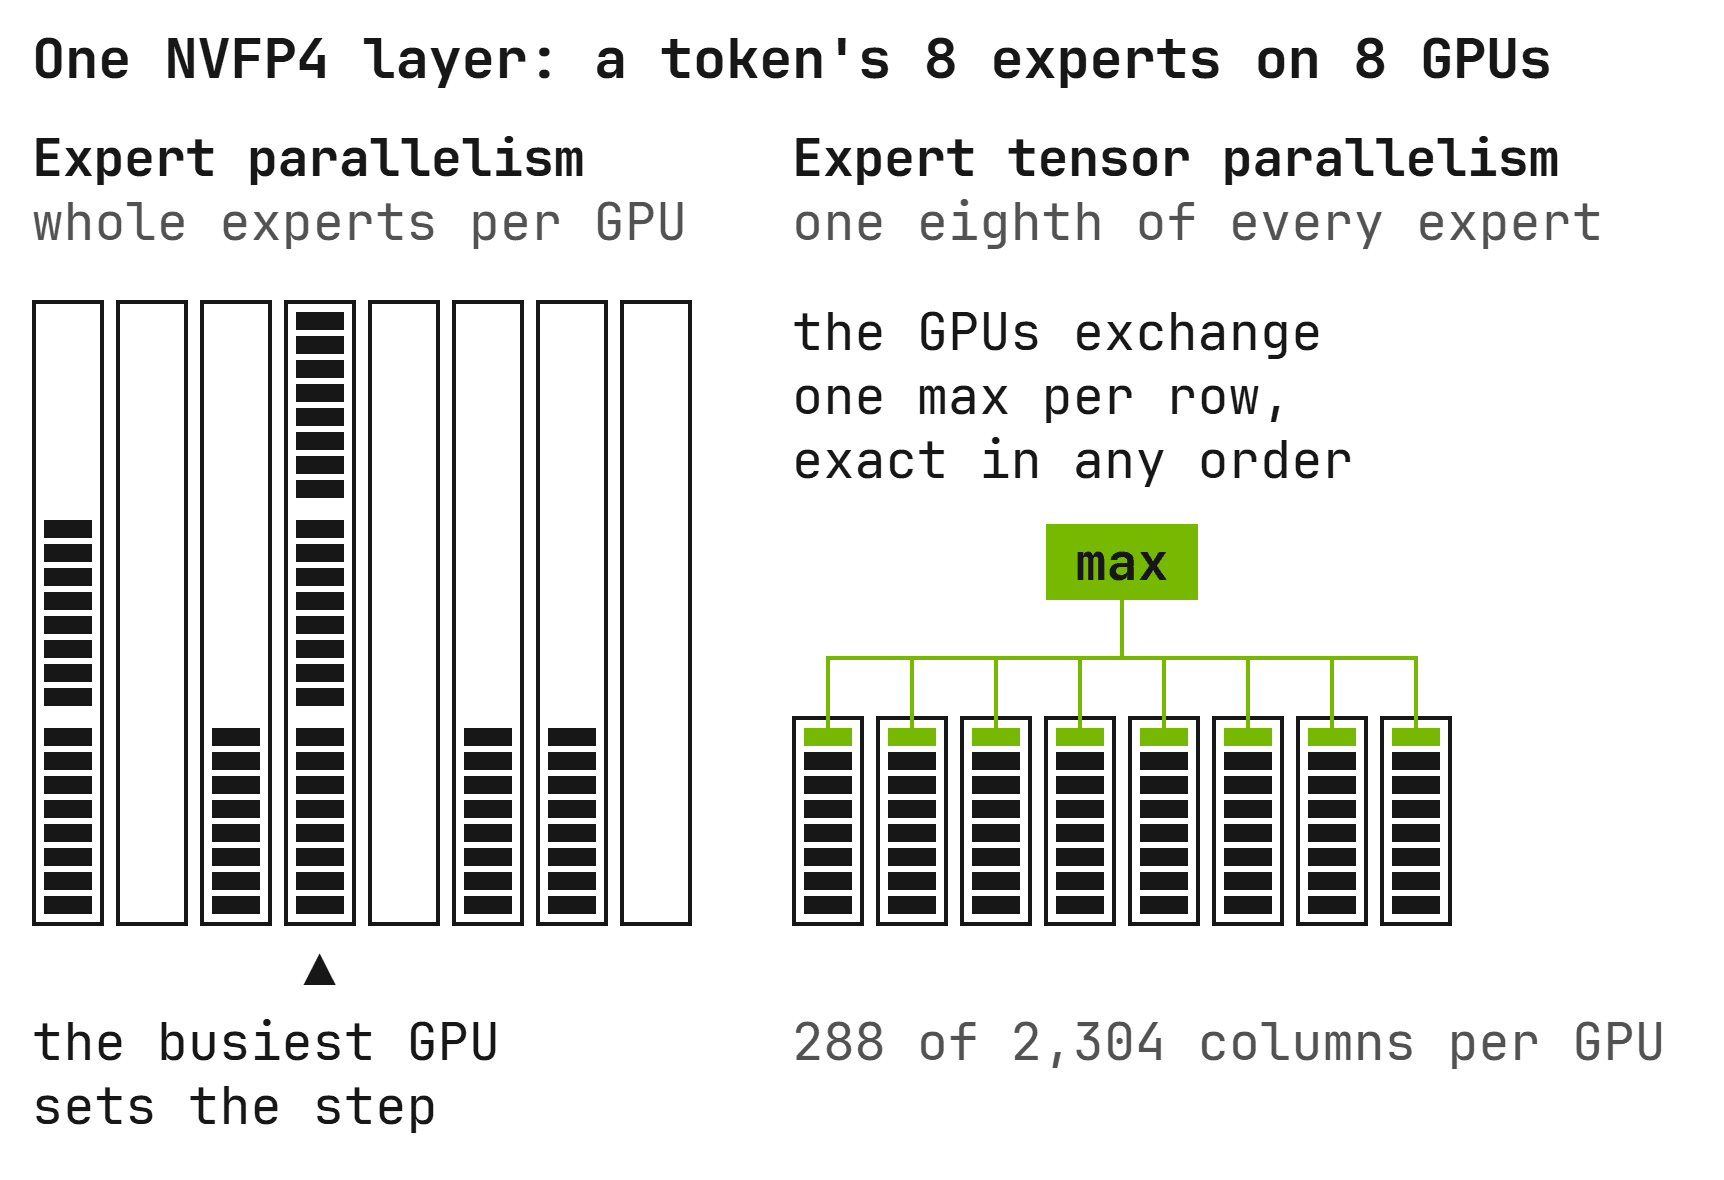
يأخذ كل GPU أكبر مقدار في أعمدته ال 288 من الصف، ثم يطوي كل GPU القيم العظمى الثماني التي يتلقاها ب fmaxf، ما يعطي البتات نفسها في أي ترتيب؛ وسطر fma هو التوأم المعتمد على الترتيب الذي يجب أن يلتقطه اختبار التقليب لدينا.
يعطي التبادل البتات نفسها في كل ترتيبات ال rank الثمانية التي اختبرناها، بمحاكاة 8 ranks على B300 واحدة، ويُلتقط الدمج المعتمد على الترتيب.
يقرأ كل GPU شريحة متساوية من كل خبير نشط، فلا يقرأ أي GPU بايتات خبير أكثر من غيره. والثمن تبادل إضافي واحد لكل طبقة FP4.
وصيغة ثانية تتبادل التنشيط نفسه بدلا من قيمته العظمى، وتقسم w2 بحسب صفوف الناتج بدلا من K.
ثم يكمّم كل GPU الصف كاملا بنفسه، فيصبح ال all-reduce الختامي للمجاميع الجزئية في FP32 عملية all-gather لشرائح BF16، ويرسل كل GPU بايتات أقل ب 3.2 مرة في كل طبقة FP4: 40 KB مقابل 129 KB عند صف واحد، و 0.32 MB مقابل 1.03 MB عند خطوة تحقق من 8 صفوف.
يقرّب حيث يقرّب SGLang، فيقرّب ناتج كل خبير إلى BF16 قبل الجمع، ويعرض خطأ صفريا مقابل نموذج FP64 لنقاط التقريب تلك، على طبقة FP4 التي اختبرناها.
النواة 2: GEMM ذو المقياس الكتلي، معاد بناؤه لرمز واحد
تشغّل النواتان tcgen05.mma مع الأوزان ك M، و 128 صفا لكل بلاطة، والرموز مبدلة في N، بمراكمات FP32 والمقاييس الكتلية في ذاكرة tensors.
في النواة المعاد بناؤها يغذي خيط واحد نواة tensors: في كل خطوة K ينسخ مقاييس كتل الأوزان والرموز إلى TMEM ب tcgen05.cp، ثم يصدر tcgen05.mma واحدة ذات مقياس كتلي شرط التراكم فيها مطفأ في خطوة K الأولى للجزء، فيبدأ كل جزء من مركم FP32 مصفّر.
عند رمز واحد، يقرأ GEMM ال w13 على كل GPU مقدار 11.9 MB من أوزان FP4 ومقاييسها في كل طبقة. أعطت نواتنا الأولى كل بلاطة خبير CTA واحدة، ومشت في K على مراحل لم تتداخل قط: 40 CTA على 148 SM، بسرعة 114 GB/s.
تقسم النواة المعاد بناؤها أجزاء K الثابتة على CTAs، وتُداخل تحميلات كل مرحلة مع عمليات MMA. وكل جزء ما زال السلسلة نفسها من عمليات MMA ذات المقياس الكتلي بالترتيب نفسه في K من مركم مصفّر، وتدمج آخر CTA تصل الأجزاء في الشجرة الثابتة نفسها، فيحتفظ كل ناتج ببتاته.
تكتب كل CTA مجاميعها الجزئية في FP32، وتنفذ حاجز ذاكرة، وتأخذ رقم دور؛ وآخر من يصل يعيد ضبط العداد لإعادة تشغيل CUDA graph التالي، ثم يقرأ كل جزء عبر L2 بترتيب الأجزاء، ويجمعها في الشجرة الثابتة نفسها.
Microseconds per launch
- w13 · NVFP45.1xFirst kernel 104.4 microseconds, rebuilt 20.5.
- w13 · MXFP87.5xFirst kernel 184.3 microseconds, rebuilt 24.6.
- w2, first form · NVFP41.0xFirst kernel 14.3 microseconds, rebuilt 14.3.
- w2, first form · MXFP81.3xFirst kernel 20.5 microseconds, rebuilt 16.3.
- w2, second form · NVFP43.3xFirst kernel 55.8 microseconds, rebuilt 16.9.
- w2, second form · MXFP84.6xFirst kernel 88.0 microseconds, rebuilt 19.1.
w13, NVFP4, layer 0
- first kernel
- 104.4
- 114 GB/s
- rebuilt
- 20.5
- 583 GB/s
- weights
- 11.94 MB
- 8 experts
عند 8 رموز في كل خطوة، مع 40 خبيرا متمايزا في كل طبقة، يقرأ w13 المعاد بناؤه 1.39 TB/s على NVFP4 و 1.84 TB/s على MXFP8، مقابل 6.85 TB/s قسناها لذاكرة B300، فما زال أمام هذه النواة هامش.
ومقابل النواة الأولى، على الطبقتين 0 و 40 عند 1 وحتى 64 صفا وعلى ثلاث إعادات ل CUDA graph، كل قيمة وسطية متساوية بتاً ببت: لا يختلف أي صف من 512.
النواة 3: مزج العمق في جولة واحدة
يمزج Inkling نواتج الطبقات الأسبق قبل كل انتباه وكل كتلة خبراء: softmax على ما يصل إلى تسعة نواتج سابقة، ثم تطبيع. وبالطريقة المباشرة يحتاج كل مزج إلى اختزالين عبر GPU.
نحتفظ بمصفوفة Gram للنواتج السابقة، محسوبة مرة واحدة عند إغلاق كل كتلة، فيأتي معيار المزج من تلك المصفوفة وعمود جديد واحد: اختزال واحد بدلا من اثنين، وجولتان لكل طبقة بدلا من 4، وهي محسوبة.
ويقع المعيار في حدود 1.6e-7 نسبيا من المباشر في اختباراتنا، بجمع معوّض وتراجع إلى الجولة الثانية المباشرة لأي صف قد يتجاوز فيه الإلغاء البوابة.
وطي موجّه الخبراء في الاختزال نفسه غيّر أفضل 8 خبراء في 1.1 في المئة و 1.6 في المئة من الرموز على الموجّهات الحقيقية للطبقتين 0 و 40، فيبقى خارجا: فأي تغيير يحرك التوجيه ليس بلا فقدان.
ما مدى القرب من vLLM
النموذج الكامل على 8 GPUs، بتغذية قسرية بتكملات vLLM نفسها لأربع مطالبات، مقابل لوغاريتمات احتمالات vLLM عند 595 موضعا. و vLLM إذا شغّل مرتين يتفق مع نفسه تماما، فكل فرق أدناه هو بين حساب المحركين، لا ضجيج.
Distance from vLLM, nats
- mean
- 0.0249
- median
- 0.0016
- p95
- 0.1285
- max
- 0.7269
- vLLM run twice
- 0.0000
إلى أين يذهب وقت الخطوة اليوم
لا يزال محركنا يشغل خطوة فك التشفير كعمليات إطلاق منفصلة تحت CUDA graphs: نحو 16 ms في كل خطوة عند صف واحد بلا مسودة، على 8 GPUs من B300. وأكبر كلفة هي GEMM الخبراء في نواتنا الأولى، ويقلصه المعاد بناؤه نحو خمسة أضعاف عند قياسه وحده، لكنه ليس في المحرك بعد.
Kernel time per step, one GPU, ms
16.76 in all
- Expert GEMMs5.94
- Exchanges and waits4.93
- Depth mix and conv2.45
- Attention1.39
- Router and work list0.88
- Dense BF16 GEMMs0.63
- Quantize and combine0.48
- Embed and sample0.03
Expert GEMMs35.4%
- 4.03w13 GEMM, NVFP4expert_gemm_tc05_kernel<0,1,4,0>
- 1.42w13 GEMM, MXFP8expert_gemm_tc05_kernel<1,1,4,0>
- 0.36w2 GEMM, NVFP4expert_gemm_tc05_kernel<0,1,1,1>
- 0.12w2 GEMM, MXFP8expert_gemm_tc05_kernel<1,1,1,1>
القطعة التالية هي برنامج فك تشفير مقيم واحد لكل GPU: كل طبقة في نواة مقيمة واحدة، والتبادلات داخلها.
وتقرأ ميزانيتنا للبايتات والزمن لخطوة تحقق واحدة نحو 7.8 GB لكل GPU عبر 154 تبادلا، مع المسودة التخمينية الخاصة ب Inkling عند 3.35 رمزا في كل خطوة، وافتراض 45 خبيرا متمايزا في كل طبقة، وهو ما لم نقسه بعد.
وعلى هذه الميزانية يستهدف البرنامج نحو 1,900 رمز في الثانية لكل مستخدم، وهو توقع بمدى من نحو 1,630 إلى 2,160. ولإعطاء فكرة عن الحجم، يشغل vLLM بالمسودة نفسها هذا النموذج عند 666 رمزا في الثانية لكل مستخدم على عقدتنا الخاصة من 8 B300. ويعرض المقال التالي رقمنا المقيس، بتاً ببت.
الإعدادات
المصدر الكامل ومجموعات الاختبار ومشغل السحابة الذي أنتج كل نتيجة في github.com/RightNow-AI/inkling-b300-kernels، تحت ترخيص Apache 2.0.
تُبنى كل نواة لهدف B300 الخاص بالمعمارية، مع إيقاف الدمج:
والنموذج الكامل على 8 GPUs، بتغذية قسرية عند 64 صفا في كل خطوة وعند صف واحد، وسطر السرعة:
ومرجع vLLM:
الظروف
شُغّل محركنا ومرجع vLLM على عقدة سحابية واحدة من 8 GPUs من NVIDIA B300 SXM6، بالمشغل 620.70.06، مع وصول ندّ لندّ بين GPUs الثماني كلها؛ وشُغّلت مجموعات الأنوية وتوقيتات GEMM على GPU واحدة منها.
ال checkpoint هو thinkingmachines/Inkling-2-Small عند المراجعة 885d78bf. والمرجع: صورة vLLM nightly sha256:c17e9d88. وقد قيست سرعة vLLM بالمسودة (2026-11-21) وعرض نطاق الذاكرة 6.85 TB/s (2026-11-20) على عقدتنا الخاصة من 8 B300؛ وكل ما عدا ذلك قيس في 2026-11-21.