استدلال بلا فقدان
, 9 دقائق قراءة, By Jaber Jaber
بحثملاحظة تحريرية: نشر هذا المقال أولا على موقعنا السابق. منتج التحسين الموصوف هنا تقاعد. يقدم RightNow النماذج المفتوحة عبر API الخاص به.
صار التكميم الطريقة الافتراضية لتسريع الاستدلال لأنه الأسهل. في vLLM هو علم واحد أو checkpoint مبدل واحد (docs.vllm.ai)، بينما يستغرق عمل التحسين الحقيقي، ككتابة أنوية أفضل، شهورا. فالناس يبدلون ال checkpoint ويمضون، والناس أنفسهم الذين لن يشحنوا تغيير مطالبة بلا مراجعة يشحنون نموذجا مكمما من دون تشغيل تقييم واحد، لأن العلم يجعله يشبه إعداد بنية تحتية بينما هو في الحقيقة تغيير للنموذج
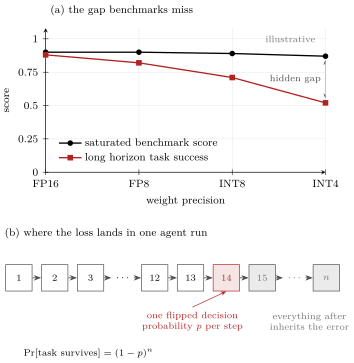
التكميم مقايضة لا تحسين. توفر الذاكرة وتدفع الثمن جودة، والتكلفة يصعب رؤيتها لأن تكميم ما بعد التدريب يحرك كل وزن قليلا بينما بالكاد تتفاعل المعايير القياسية، لأنها مشبعة ولأنها تختبر خطوة واحدة في كل مرة. تظهر الخسارة الحقيقية في سلاسل الاستدلال الطويلة وتشغيلات البرمجة الوكيلة حيث تتراكم مئات القرارات المعتمدة بعضها على بعض، فيقول لك المعيار إن النموذجين متطابقان بينما يقول لك معدل نجاح وكيلك إنهما ليسا كذلك. هذا المقال عن منصة serving التي تنال السرعة من دون دفع تلك التكلفة
رياضيات التراكم
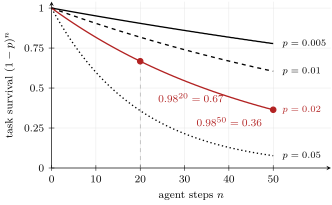
إذا قلب ضجيج التكميم قرارا واحدا في كل خطوة باحتمال p، فعلى n خطوة معتمدة تنجو المهمة باحتمال (1-p)^n. إصابة 2 في المئة في كل خطوة تبدو مجانية حتى تشغل 20 خطوة، لأن 0.98^20 تساوي 0.67 فيفشل ثلث مهامك، وعند 50 خطوة تهبط إلى 0.36
إن أبقيت p عند نصف في المئة بدلا من ذلك، يبقى النجاح على 20 خطوة عند 0.90، وهذا هو الفرق بين وكيل تثق به ووكيل تراقبه. النموذج لم يغب أصلا، صار فقط أكثر ضجيجا ب 2 في المئة في كل قرار وقام التراكم بالباقي
ما معنى بلا فقدان
يعني الاستدلال بلا فقدان أن المنصة تصبح أسرع بينما يبقى النموذج النموذج نفسه تماما، وأقسمه طبقتين
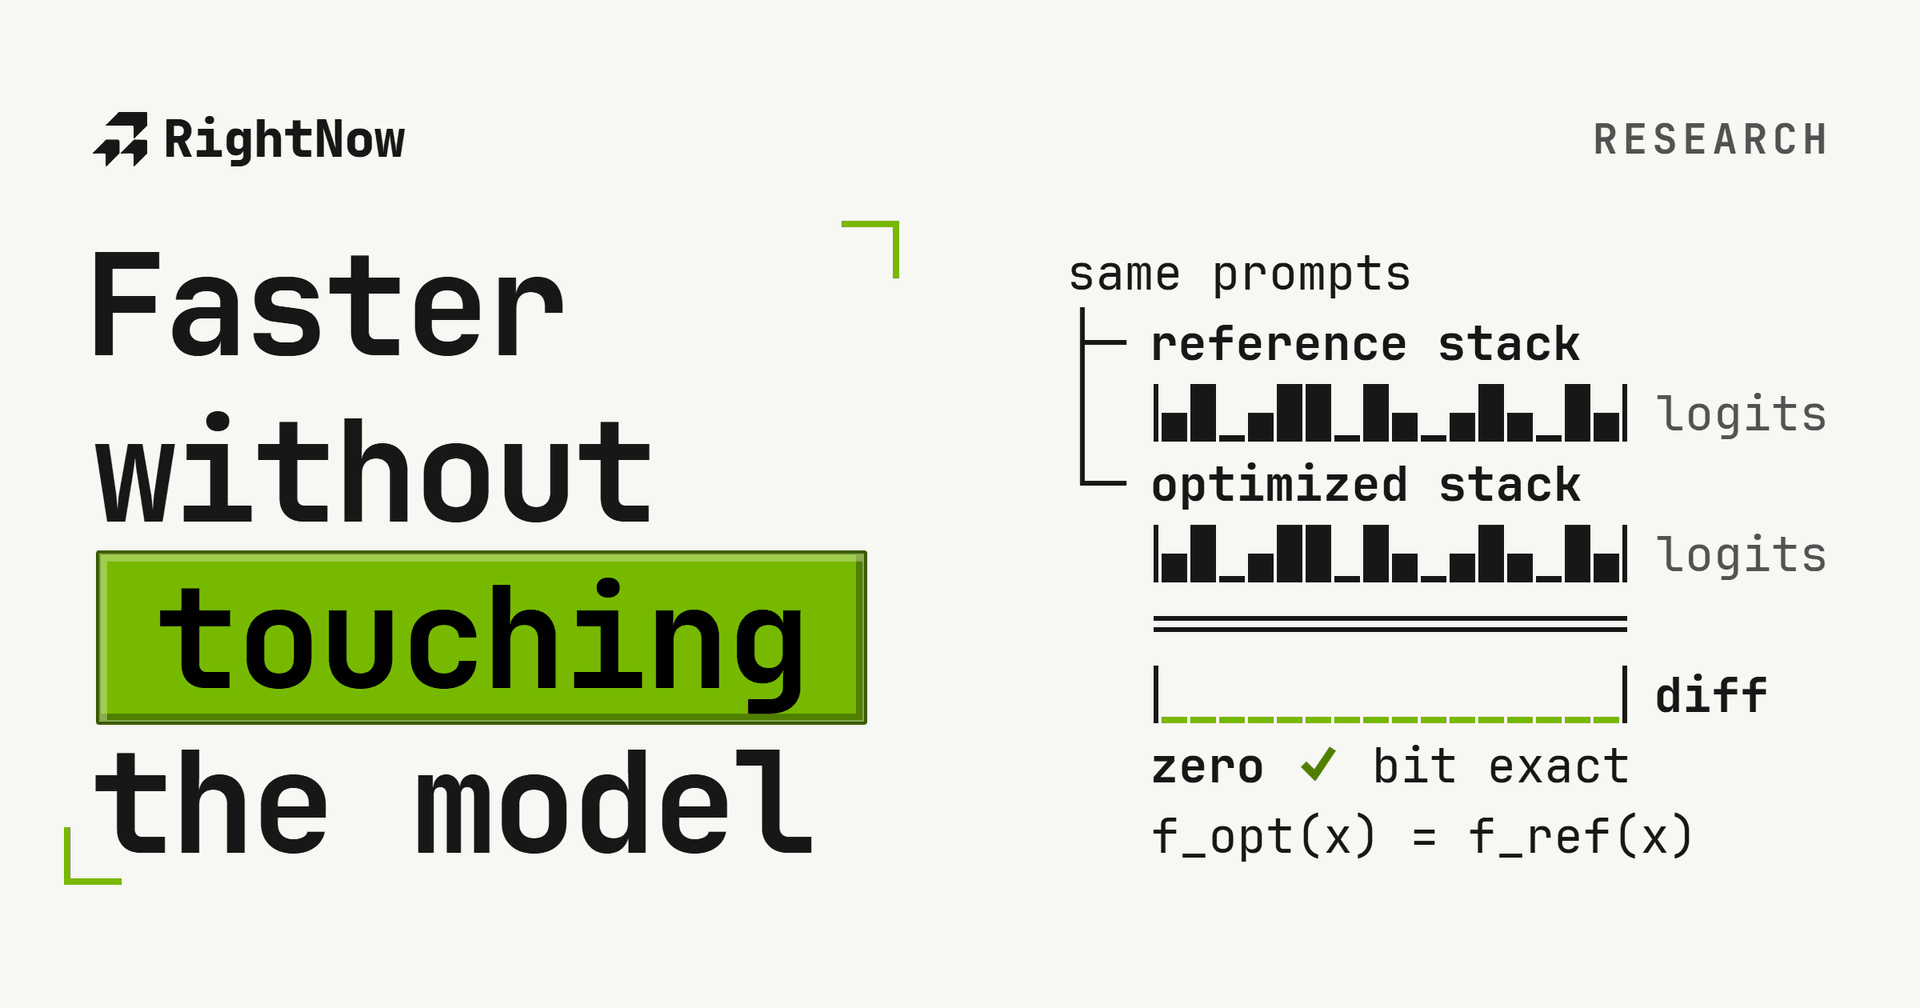
التطابق التمامي يعني أن المنصة المحسّنة تعيد ال logits نفسها التي يعيدها المرجع على كل مدخل، أي f_opt(x) تساوي f_ref(x). الأنوية والدمج والتجميع وإعادة استخدام KV والجدولة وضغط الأوزان بلا فقدان كلها تسكن هذه الطبقة لأنها تغير كيفية إجراء الحساب من دون تغيير الحساب نفسه
التطابق التوزيعي يعني أن المنصة المحسّنة تعاين من التوزيع نفسه الذي يعاين منه المرجع، أي P_opt(y | x) تساوي P_ref(y | x). هنا يسكن فك التشفير التخميني مع أخذ العينات بالرفض، حيث قد تختلف العينات المفردة لكن التوزيع لا يتغير أبدا
كل ما عدا ذلك، التكميم بعد التدريب والتقليم والتقطير، يغير الدالة نفسها، أي أنك تخدم نموذجا مختلفا بالاسم نفسه. هذا التعريف مهم لأنه يحرك عبء الإثبات: فالتغيير بلا فقدان لا يحتاج تشغيل تقييم حين تكون المخرجات نفسها هي الدليل، بينما يحتاج التغيير الفاقد تقييما كاملا على حملك وليس على MMLU وحده. والتطابق التمامي يتالف أيضا، لأن خط أنابيب من مراحل متطابقة تماما يبقى متطابقا تماما، فأستطيع تكديس خمس مراحل من دون تشغيل خمس دورات تقييم
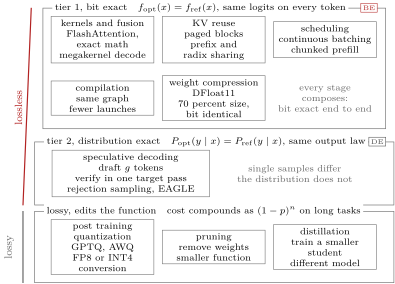
منصة بلا فقدان، من الأسفل إلى الأعلى
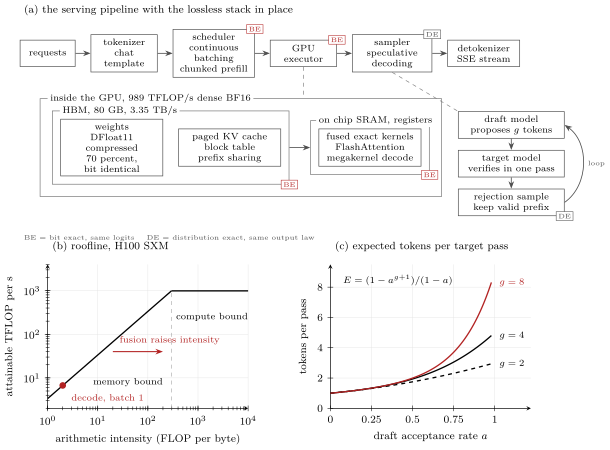
تبدأ المنصة بالأنوية. الاستدلال عند أحجام دفعات serving مقيد بعرض نطاق الذاكرة، لأن H100 SXM تنقل نحو 3.35 TB/s من HBM بينما تنجز نحو 989 BF16 TFLOP/s كثيفة الحساب (nvidia.com/en-us/data-center/h100/)، فتنال النواة سرعتها بنقل بايتات أقل لا بإجراء حساب أقل. أثبت FlashAttention هذه النقطة قبل سنوات بحساب انتباه تام بإعادة ترتيب حركة الذاكرة وتحقيق تسريعات كبيرة بمخرجات متطابقة (arxiv.org/abs/2205.14135)، وإعادة الترتيب صحيحة لأن softmax المتصل يحسب التطبيع نفسه من إحصاءات جارية، فلا يتغير في النتيجة شيء
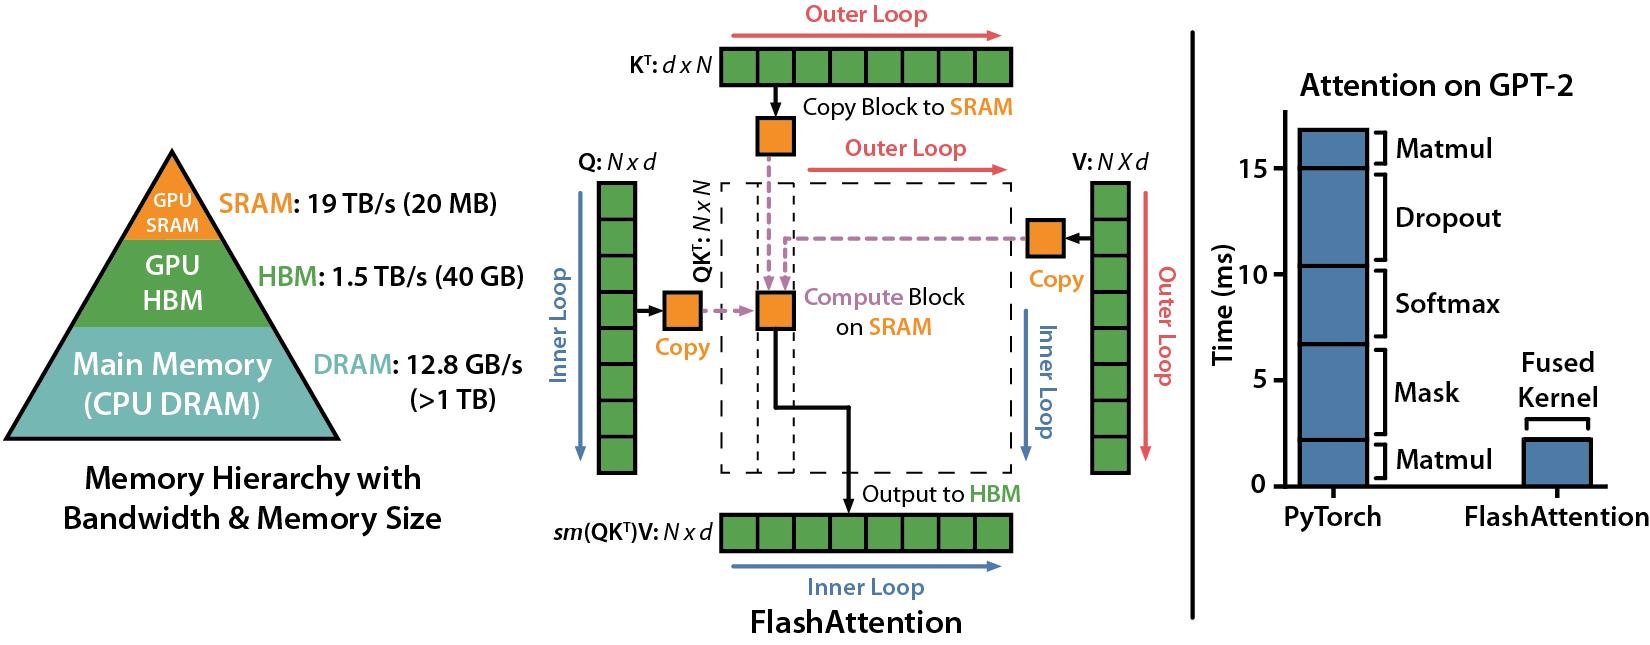
يدفع الدمج الفكرة نفسها أبعد بإبقاء القيم الوسطية في المسجلات والذاكرة المشتركة بدلا من الذهاب والعودة عبر HBM، وتأخذها النواة العظيمة إلى حدها بتشغيل خطوة فك التشفير كلها إطلاقا واحدا. بنيت هذا بنفسي. على H100 نفسها يشغل محركي bonsai-turbo 1.76x ضعف نسخة llama.cpp الخاصة بمورد البطاقة نفسه، صعودا من 85.5 إلى 151.1 رمزا في الثانية بالمخرجات نفسها (github.com/RightNow-AI/bonsai-turbo)، وبلغ نظام بحث الأنوية عندي AutoKernel 1.31x على cuBLAS على أفضل أنويته عبر 95 تجربة تمتد من 18 إلى 187 TFLOPS مع احتلاله المركز الأول في لوحة متصدرين vectorsum على B200 (github.com/RightNow-AI/autokernel)
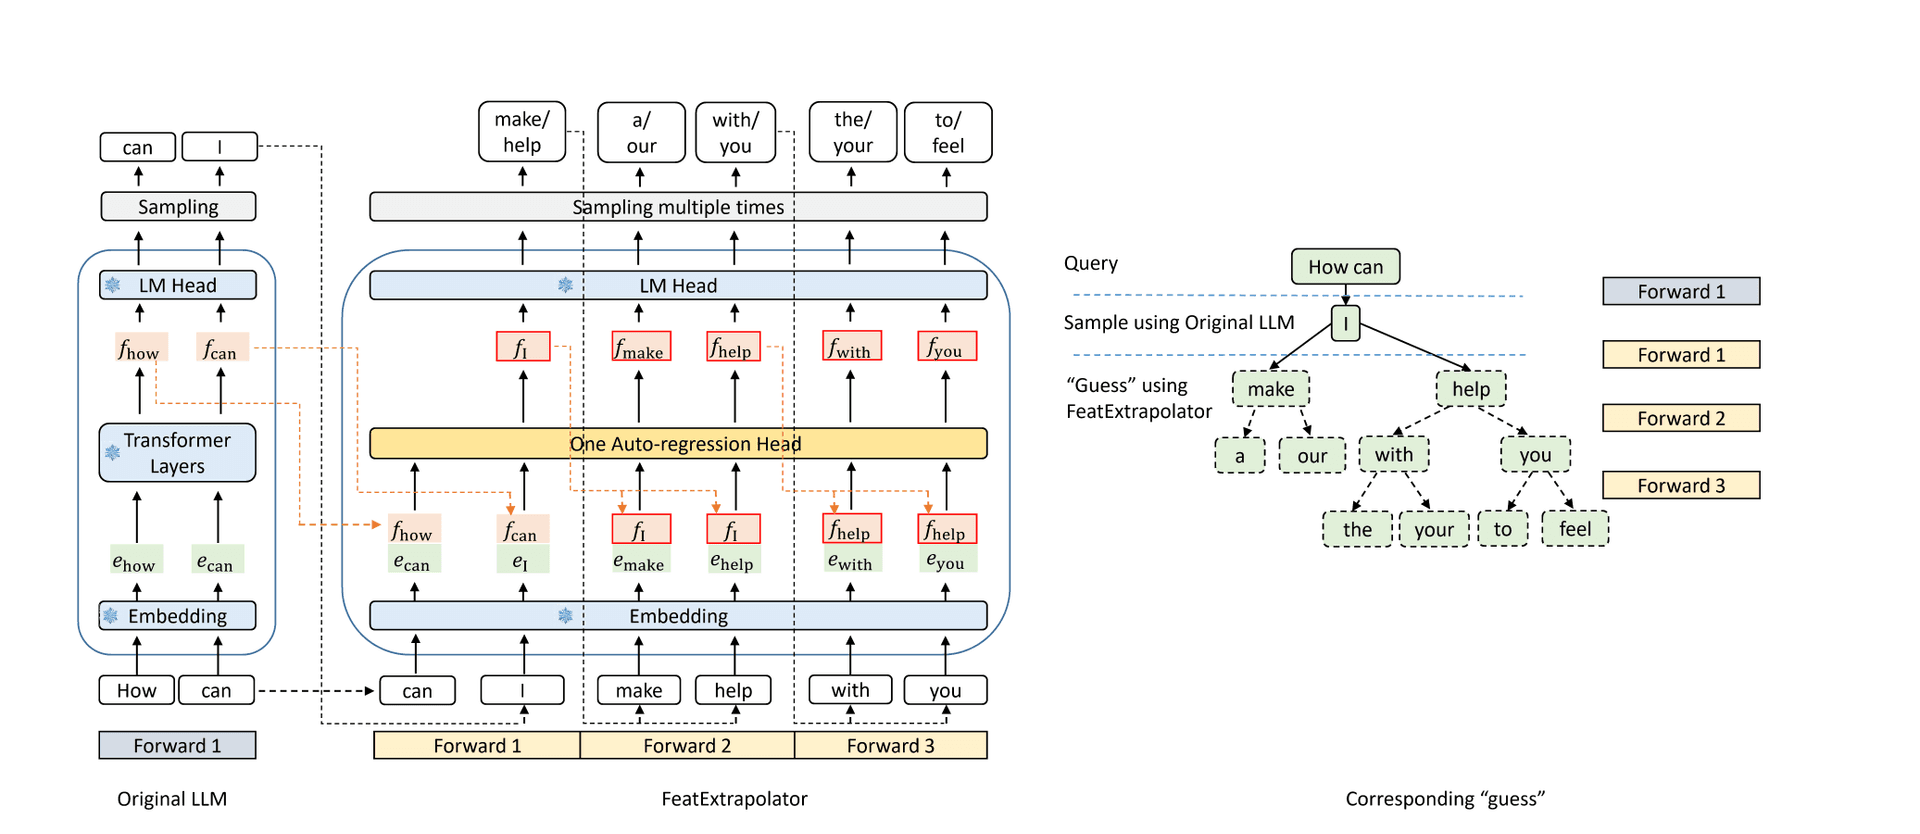
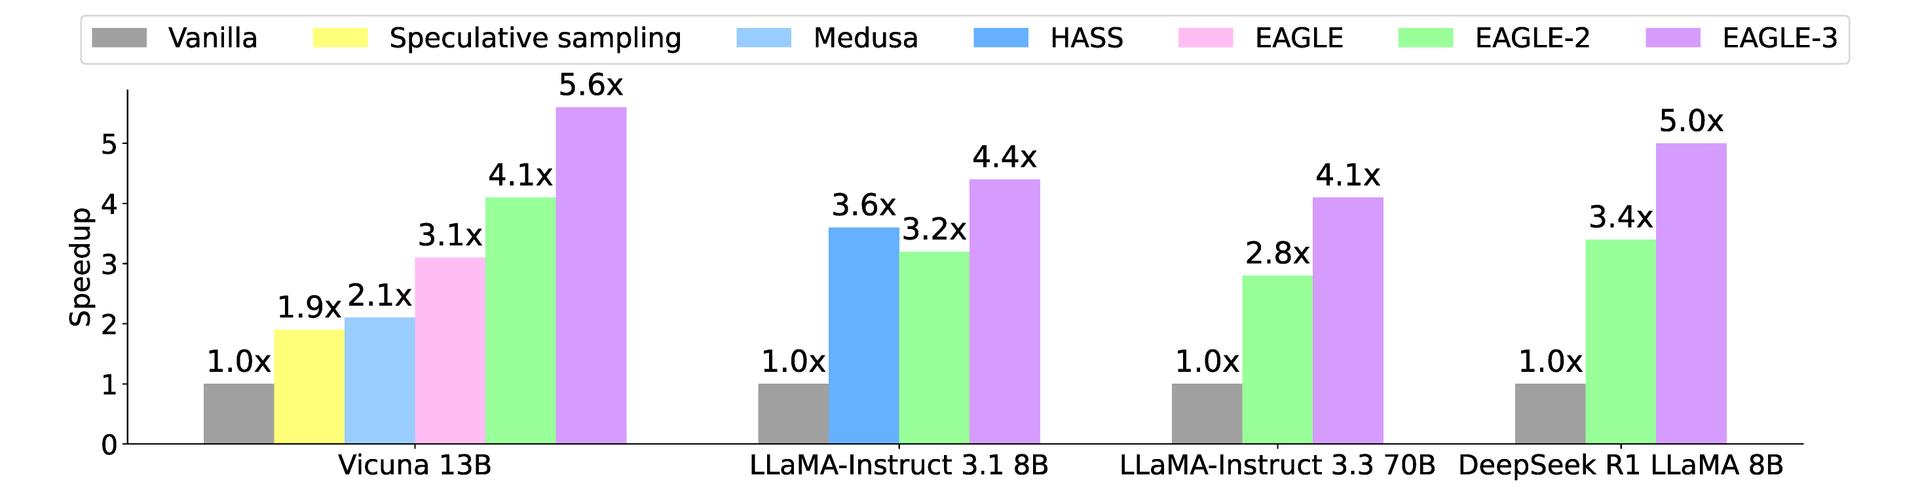
يأتي فك التشفير التخميني بعدها. نموذج مسودة صغير يقترح g رموزا، والنموذج الهدف يتحقق منها في تمريرة واحدة، وخطوة أخذ عينات بالرفض معدلة تبقي توزيع الناتج توزيع الهدف تماما، وهو ما أثبت مرتين باستقلال في 2023 (arxiv.org/abs/2211.17192، arxiv.org/abs/2302.01318). العدد المتوقع للرموز لكل تمريرة هدف هو (1-a^(g+1))/(1-a) عند نسبة قبول a، فدقة المسودة هي كل شيء، وخط EAGLE هو ما رفعها (arxiv.org/abs/2401.15077). يقول EAGLE-2 بوضوح ("توزيع النص المولد يبقى دون تغيير") ويبلغ عن 3.05x إلى 4.26x (arxiv.org/abs/2406.16858)، بينما يبلغ EAGLE-3 حتى 6.5x (arxiv.org/abs/2503.01840)
ثم يأتي ضغط الأوزان بلا فقدان. تحمل أوزان BF16 أقل من 16 بت معلومة حقيقية لكل معامل، فيرمزها DFloat11 انتروبيا إلى نحو 11 بت، فتهبط إلى نحو 70 في المئة من الحجم الأصلي بمخرجات تبقى متطابقة تماما مع النموذج الأصلي (arxiv.org/abs/2504.11651). هذا يغطي معظم توفير الذاكرة الذي يعهده التكميم من دون فاتورة الجودة
إعادة استخدام KV هي الطبقة التالية. أنهى الانتباه المصلب تفتت مخزن KV ورفع أحجام الدفعات الحقيقية (arxiv.org/abs/2309.06180)، وجعل تخزين البادئات بأشجار radix التاريخ المشترك يحسب مرة واحدة (arxiv.org/abs/2312.07104). وهذا آمن لأن مدخلات المخزن دالة خالصة في البادئة، فإعادة استخدامها في المواضع نفسها لا تستطيع تحريك ال logits
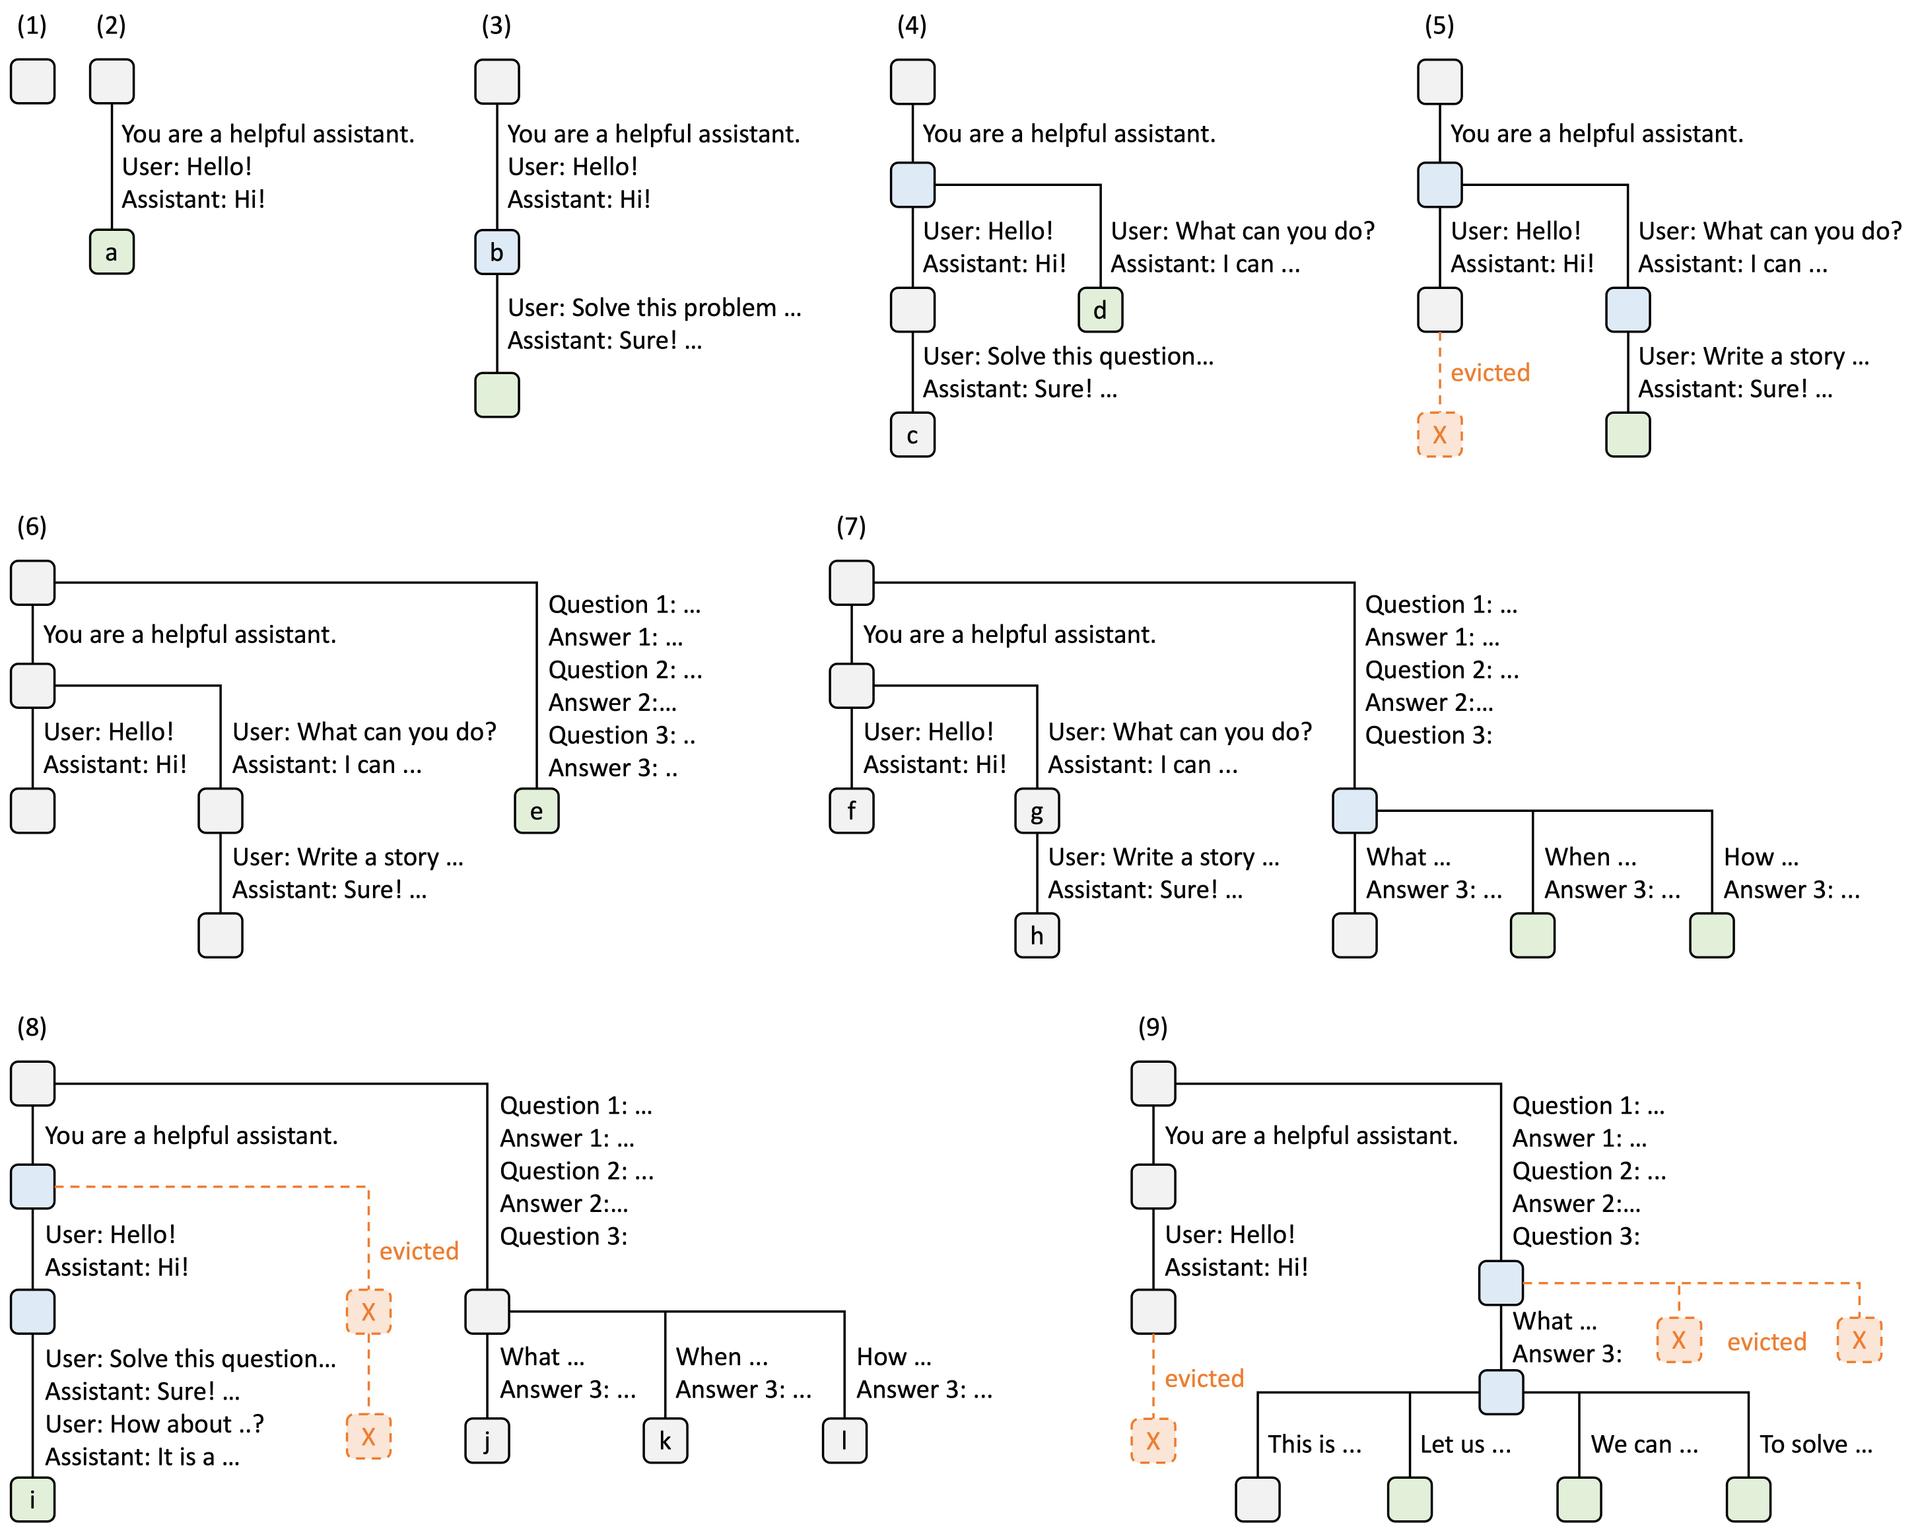
تتوضع الجدولة فوق ذلك. الدفعات المستمرة تعبئ الدفعة عند حدود الرموز بدلا من انتظار أطول طلب (usenix.org/conference/osdi22/presentation/yu)، و prefill المجزأ يمنع مطالبة طويلة عن تعطيل فك تشفير الآخرين (arxiv.org/abs/2308.16369)، وفصل prefill عن فك التشفير يضع النصف المقيد بالحساب والنصف المقيد بعرض النطاق من الحمل على آلات مختلفة (arxiv.org/abs/2401.09670). ولا تلمس هذه واحدا من ال logits
الخط المتحرك
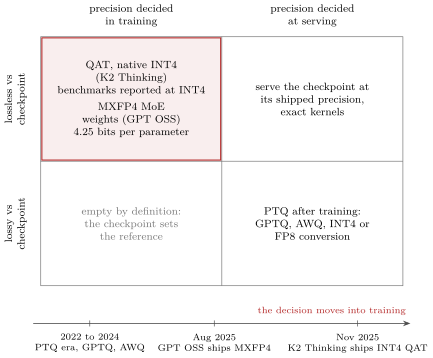
يُرسم حد بلا فقدان عند ال checkpoint المشحون، وال checkpoint نفسه يتحرك. شحن Kimi K2 Thinking بأوزان INT4 أصلية لأن Moonshot أجرت تدريبا واعيا بالتكميم في ما بعد التدريب، ووضعت INT4 على أوزان MoE وأبلغت عن كل معيار رسمي عند INT4 بتوليد أسرع بنحو 2x (huggingface.co/moonshotai/Kimi-K2-Thinking). وشحنت OpenAI نموذج gpt-oss بأوزان MXFP4 على MoE عند 4.25 بت لكل معامل، وهو ما يغطي أكثر من 90 في المئة من المعاملات وسبب احتمال gpt-oss-120b على GPU واحدة بسعة 80 GB (arxiv.org/abs/2508.10925)
لهذين النموذجين، serving ب INT4 أو MXFP4 ليس تكميما فاقدا، بل هو ال checkpoint. المرجع الذي يجب ألا تدهره منخفض الدقة أصلا، والمورد دفع تكلفة الجودة أثناء التدريب حيث مكانها، فيتحول التكميم إلى قرار تدريب بينما يبقى عصر checkpoint من BF16 بعد الحقيقة حيلة serving. اختباري بسيط: إن كانت الأوزان التي تخدمها هي الأوزان التي قاس عليها المورد فأنت تخدم النموذج، وإن عصرتها بعدها فأنت تخدم تعديلك أنت للنموذج
التحقق
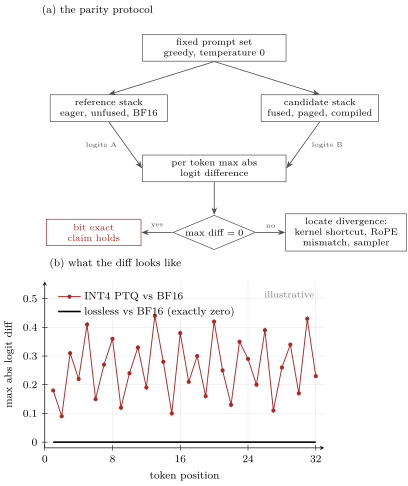
بلا فقدان ادعاء يمكنك اختباره، وأختبره بتطابق ال logits. تشغل المطالبات نفسها عبر منصة المرجع وعبر منصتك بفك تشفير جشع، ثم تقارن أقصى فرق مطلق في ال logits لكل رمز، حيث الصفر هو حد النجاح لادعاء التطابق التمامي واختبار توزيع هو حد فك التشفير التخميني. نشرت هذا ل bonsai-turbo، حيث تنجح 32 من 32 مطالبة مقابل نسخة المورد عبر تهيئات المحرك الأربع كلها (github.com/RightNow-AI/bonsai-turbo). وحين يفشل التطابق يريني الفرق أين أنظر، وعادة ما تكون نواة مدمجة قصت زاوية، أو عدم توافق RoPE، أو معاين يعيد التطبيع بطريقة مختلفة
تشغل Moonshot الآن الفحص نفسه على كل من يخدم نموذجها. يرسل K2 Vendor Verifier 4,000 طلب متطابقة إلى كل مزود K2 من طرف ثالث وقيّمها مقابل API الرسمي على F1 لإطلاق نداء الأدوات ودقة المخطط (github.com/MoonshotAI/K2-Vendor-Verifier)، وكان الانتشار حقيقيا، إذ تراوحت دقة المخطط من 100 في المئة عند أفضل المزودين إلى نحو 73 إلى 76 في المئة على محركات المصدر المفتوح الاعتيادية قبل نزول الإصلاحات. صارت جودة النموذج خاصية لمنصة serving وبدأ موردو النماذج في قياسها
جمع الأعداد العشرية غير تجميعي، فترتيب الاختزال داخل نواة يغير البتات الدنيا، وذلك الترتيب يتغير مع حجم الدفعة. قاست Thinking Machines النتيجة حين أعطى 1,000 إكمال عند درجة حرارة صفر على vLLM اعتيادي 80 ناتجا مختلفا، بينما أعادت الأنوية الثابتة عبر الدفعات ال 1,000 كلها متطابقة تماما مع 1.6x إلى 2x من زمن التشغيل (thinkingmachines.ai/blog/defeating-nondeterminism-in-llm-inference/)، وقصر Chen et al. برهان فك التشفير التخميني "ضمن حسابات العتاد" للسبب نفسه (arxiv.org/abs/2302.01318). فبلا فقدان يعني أن المنصة لا تضيف خطأ بعد حسابات العتاد التي قبلتها أصلا، ولا يعني مخرجات متطابقة تماما عبر أحجام الدفعات إلا إن دفعت أيضا ثمن الثبات عبر الدفعات
لماذا يفوز بلا فقدان
تسوّي الاقتصاد الجدل. يوفر التكميم عاملا ثابتا مرة واحدة ويواصل دفع الجودة في كل خطوة من كل مهمة، بينما تتراكم مكاسب بلا فقدان مع بعضها: الأنوية في فك التشفير التخميني في إعادة استخدام KV في الجدولة، وكل حد يبقي النموذج تاما. حد واحد وحده يري أصلا ما يشتريه بلا فقدان على عتاد حقيقي:
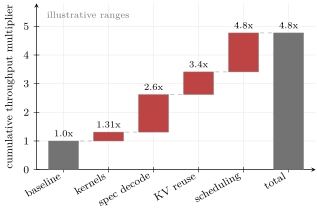
أذكر حين بدأت العمل على هذا، ظننت أن بلا فقدان سيكون المستقبل، وأنا أكثر يقينا بذلك الآن. في RightNow أبني هذا بالضبط: serving النماذج المفتوحة على منصة بلا فقدان الكاملة والتحقق منها بتطابق ال logits مقابل المرجع