كيف تكسر جدار التوسع
, 3 دقائق قراءة, By Jaber Jaber
Researchعندما يرسم الباحثون خسارة الإنتروبيا المتقاطعة للنموذج مقابل الحوسبة على مقياس log-log، تكون النتيجة خطا شبه مستقيم: تنخفض الخسارة بشكل متوقع مع زيادة الحوسبة أو حجم النموذج أو رموز التدريب. هذا الانتظام التجريبي (قانون التوسع) يتيح للفرق التنبؤ بالعوائد، لكنه يظهر الحد أيضا: شراء GPUs أكثر يعطي عوائد حدية متناقصة.
أظهر عمل DeepMind اللاحق على الحوسبة المثلى أنه، لميزانية حوسبة ثابتة، يمكن لتدريب رموز أكثر بحجم النموذج الصحيح أن يتفوق على مجرد زيادة عدد المعاملات. لهذا تهم الرموز وجودة البيانات بقدر حجم النموذج الخام.
هاتان الحقيقتان تحددان المشكلة التي تهمنا. السؤال الهندسي ليس هل قانون التوسع موجود. السؤال هو كيف نرفع تقاطع ذلك الخط على مقياس log-log بحيث تشتري FLOPs نفسها خسارة أقل.
أطرح أدناه الآليات التي تحرك التقاطع بشكل موثوق، مع خطة عمل لأسبوع واحد يمكنك تشغيلها على أي منصة.
ما الذي يحرك التقاطع فعلا
1) اجعل كل رمز أكثر إفادة: نظافة البيانات والاستهداف. أزل التكرارات والنصوص قليلة القيمة. قيّم أمثلة الإشارة العالية وأعطها أوزانا. أنشئ مجموعات بيانات اصطناعية صغيرة ومستهدفة تستهدف أنماط الفشل الحقيقية بدلا من سكب نص اصطناعي عشوائي في التدريب. هذه الخطوات ترفع كفاءة العينة وتزيد القيمة الفعلية لكل خطوة تدريب.
2) ارفع السعة الفعلية بلا FLOPs خطية: حيل خوارزمية. الحساب الشرطي (التفرقة، MoE) ينشط المعاملات التي تحتاجها لكل رمز فقط. المحولات المنخفضة الرتبة (LoRA) تتيح لك الضبط الدقيق للقدرات بعدد معاملات قابلة للتدريب أقل بكثير. التكميم العملي (مثل مسارات العمل ب 4 بت) يخفض تكاليف الذاكرة وعرض النطاق مع الحفاظ على الدقة.
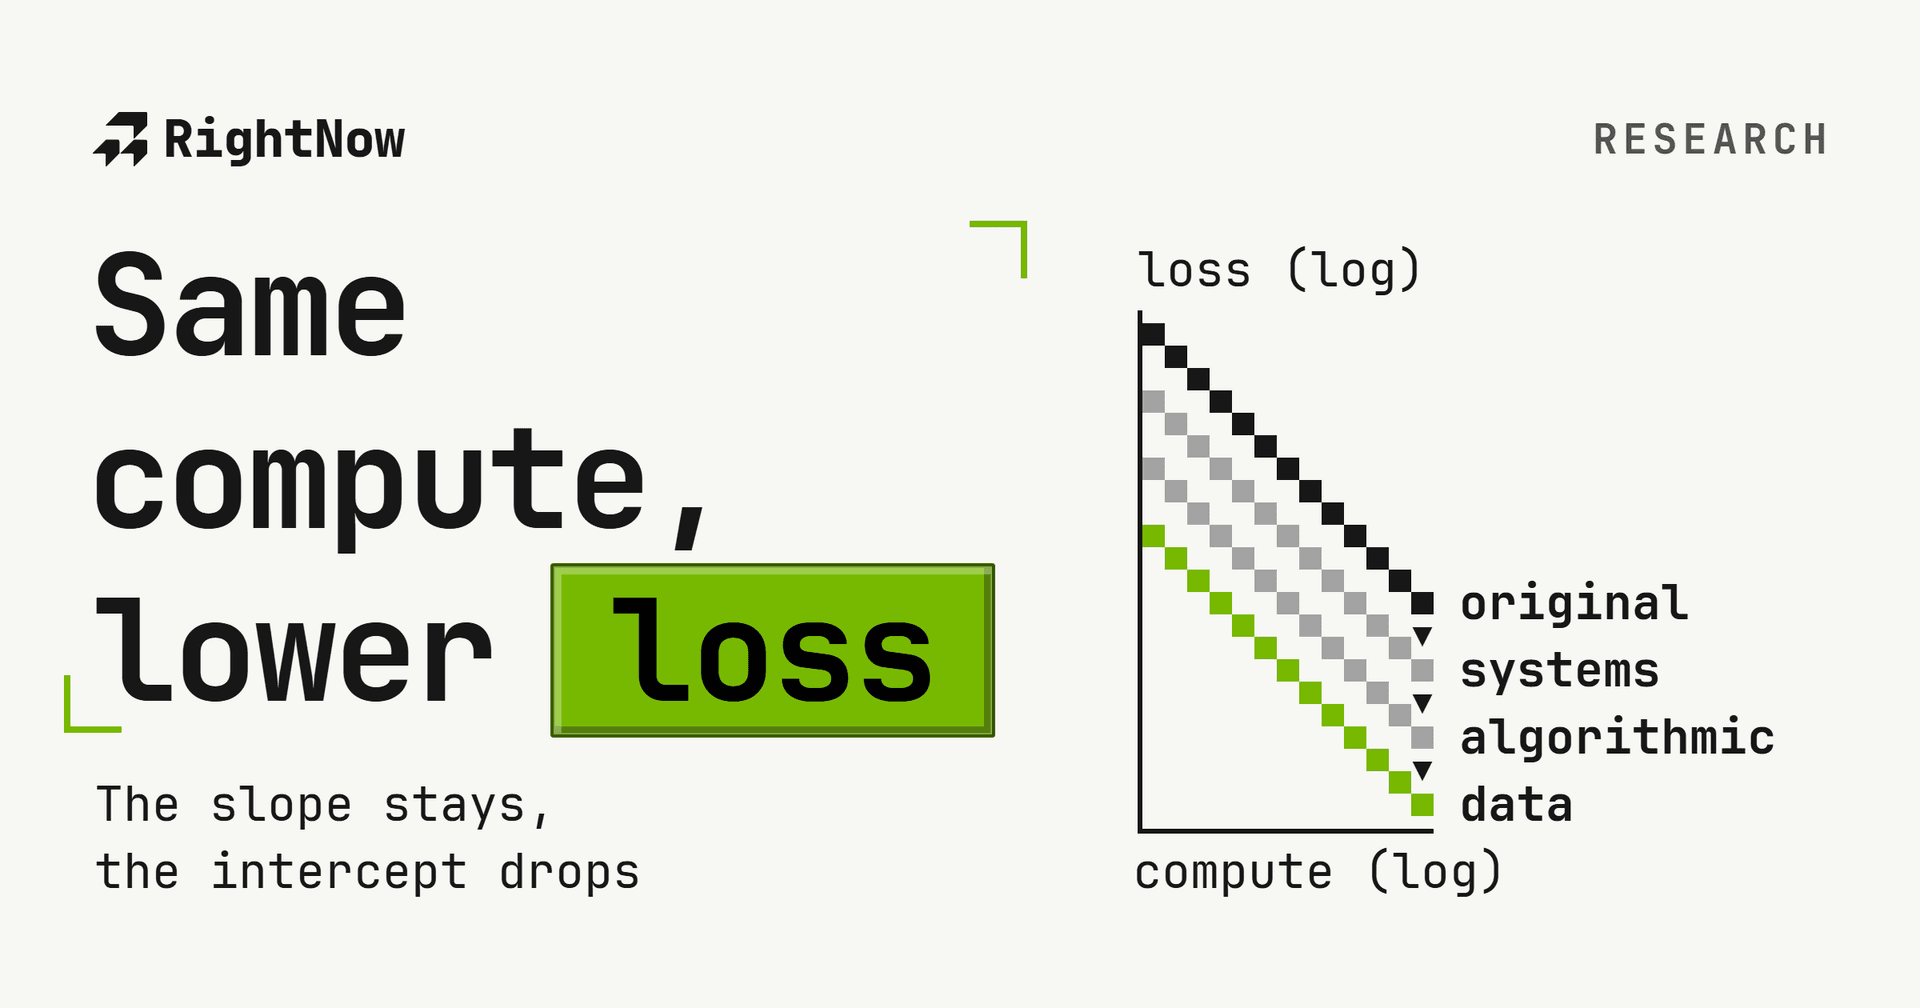
هذه التقنيات تغير الثوابت في قانون التوسع: يبقى الميل وينخفض التقاطع.
3) اعصر العتاد: هندسة أنظمة تحول الدورات المدفوعة إلى تقدم مفيد. حلل تشغيلات حقيقية وأصلح المسارات الساخنة. استبدل الانتباه الثقيل بالمدخلات والمخرجات بأنوية واعية بالمدخلات والمخرجات (FlashAttention)، وامزج الأنوية لإلغاء النسخ الزائدة، وحسّن تخطيطات الذاكرة، واضبط مزيج التوازي الأنبوبي و tensor وبيانات البيانات. تجزئة الذاكرة (ZeRO) تخفض ضغط الذاكرة على كل GPU وتوقف الاتصال.
هذه الإصلاحات تحول الدورات الخاملة أو المحجوبة إلى FLOPs تخفض الخسارة فعلا.
بتكديس هذه المجموعات الثلاث معا تخفض الخسارة لميزانية FLOP نفسها: أي إزاحة الخط كله نحو الأسفل على رسم log-log.
تصور التوسع
Loss (log)
  │
  │\
  │ \\
  │  \\\    original scaling (Kaplan-style power law)
  │   \\\
  │    \\\     ← after systems optim (FlashAttention, ZeRO)
  │     \\\
  │      \\\   ← after algorithmic optim (MoE, LoRA, quant)
  │       \\\  ← after data optim (dedupe, targeted synth)
  └──────────────────────────────────── Compute (log)
     C0     C1     C2     C3
التفسير: يبقى الميل (أس التوسع). تدخلات البيانات والخوارزميات والنظام تخفض التقاطع: الحوسبة نفسها، خسارة أقل.
أين تضيع الحوسبة المدفوعة عادة (قس أولا)
Typical waste breakdown (illustrative)
┌─────────────────────────────────────┐
│ Duplicates / low-value tokens : 30% │
│ Kernel inefficiencies         : 25% │
│ Communication / imbalance     : 20% │
│ Checkpoint / IO overhead      : 15% │
│ Suboptimal hyperconfig        : 10% │
└─────────────────────────────────────┘
استرداد جزء من هذه الخسائر وحده يمكن أن ينتج الناتج الفعلي لعنقود أكبر بكثير.
خطة عمل لأسبوع (عملية: شغلها الآن)
اليوم 1: حلل تشغيلة كاملة. التقط آثار الأنوية والاتصال؛ اعثر على أهم ثلاث نقاط ساخنة بزمن الساعة الحائطية.
اليوم 2: نظافة البيانات. شغّل إزالة التكرار وتقييم الجودة على شريحة ممثلة. أعد تدريب حقبة واحدة وقارن خسارة التحقق.
اليوم 3: ضبط دقيق رخيص. استبدل إعادة تدريب كاملة عبر LoRA/QLoRA على أنماط الفشل المستهدفة وقس الربح لكل ساعة GPU.
اليوم 4: إصلاحات الأنوية. بدّل عاملا حرجا إلى تنفيذ واع بالمدخلات والمخرجات (مثل FlashAttention)، أو امزج الأنوية، أو غير تخطيط tensors. قس تغير زمن الساعة الحائطية.
اليوم 5: ضبط موزع. طبق التجزئة و ZeRO حيث يلزم؛ أعد التحليل وأزل عدم الاتزان.
اليوم 6: تجربة حساب شرطي صغيرة. أنشئ نموذج MoE صغيرا أو كتلة شرطية على مجموعة فرعية للتحقق من مكاسب السعة.
اليوم 7: توليد واعادة تكرار. أنشئ أمثلة اصطناعية مستهدفة للأخطاء المتبقية، وكيّف، وقس.
حول التحسينات دائما إلى دولارات أو عدد تجارب: ثوان موفرة تعني ساعات GPUs موفرة تعني تجارب أكثر كل شهر.
مسوغات علمية سريعة
قوانين التوسع: العلاقة التجريبية بقانون القوى عبر الحوسبة والرموز وحجم النموذج تعطي الميل للتخطيط. (Kaplan et al., 2020)
المقايضة المثلى للحوسبة: يظهر Chinchilla أن الرموز تهم؛ فالتدريب عند نقطة الحوسبة المثلى يفضل غالبا رموزا أكثر بحجم النموذج الصحيح. (Hoffmann et al., 2022)
مكاسب الأنظمة: الانتباه الواعي بالمدخلات والمخرجات والأنوية الممزوجة تخفض زمن الساعة الحائطية بشدة في التشغيلات الثقيلة بالانتباه (FlashAttention).
الكفاءة الخوارزمية: LoRA والمحولات المنخفضة الرتبة تتيح ضبطا دقيقا رخيصا؛ و MoE والحساب الشرطي ينتجان نماذج فعلية كبيرة بعدد FLOPs نشطة أقل.
تجزئة الذاكرة: ZeRO وتقنيات التجزئة المشابهة تتيح توسيع النماذج عبر العقد بلا انفجار خطي في الذاكرة.